De Huurkandidaatscreeningsaudit Werd Rood. Mijn Bouw Was Nog Niet Af.

Het rode resultaat dat niet genoeg beantwoordde
Ik kon $2.275 miljoen schikking in Louis et al. v. SafeRent Solutions niet negeren toen ik begon te werken aan de technische vraag achter woningmarkt-AI-audits. Een federale rechtbank keurde de schikking definitief goed in november 2024, zonder schulderkenning. De zaak maakte één risico inzichtelijk, maar de bouw dwong me naar een moeilijkere operationele vraag: zodra een modelaudit een dispariteit aantoont, wat moet het team dan precies als volgende stap ondernemen?
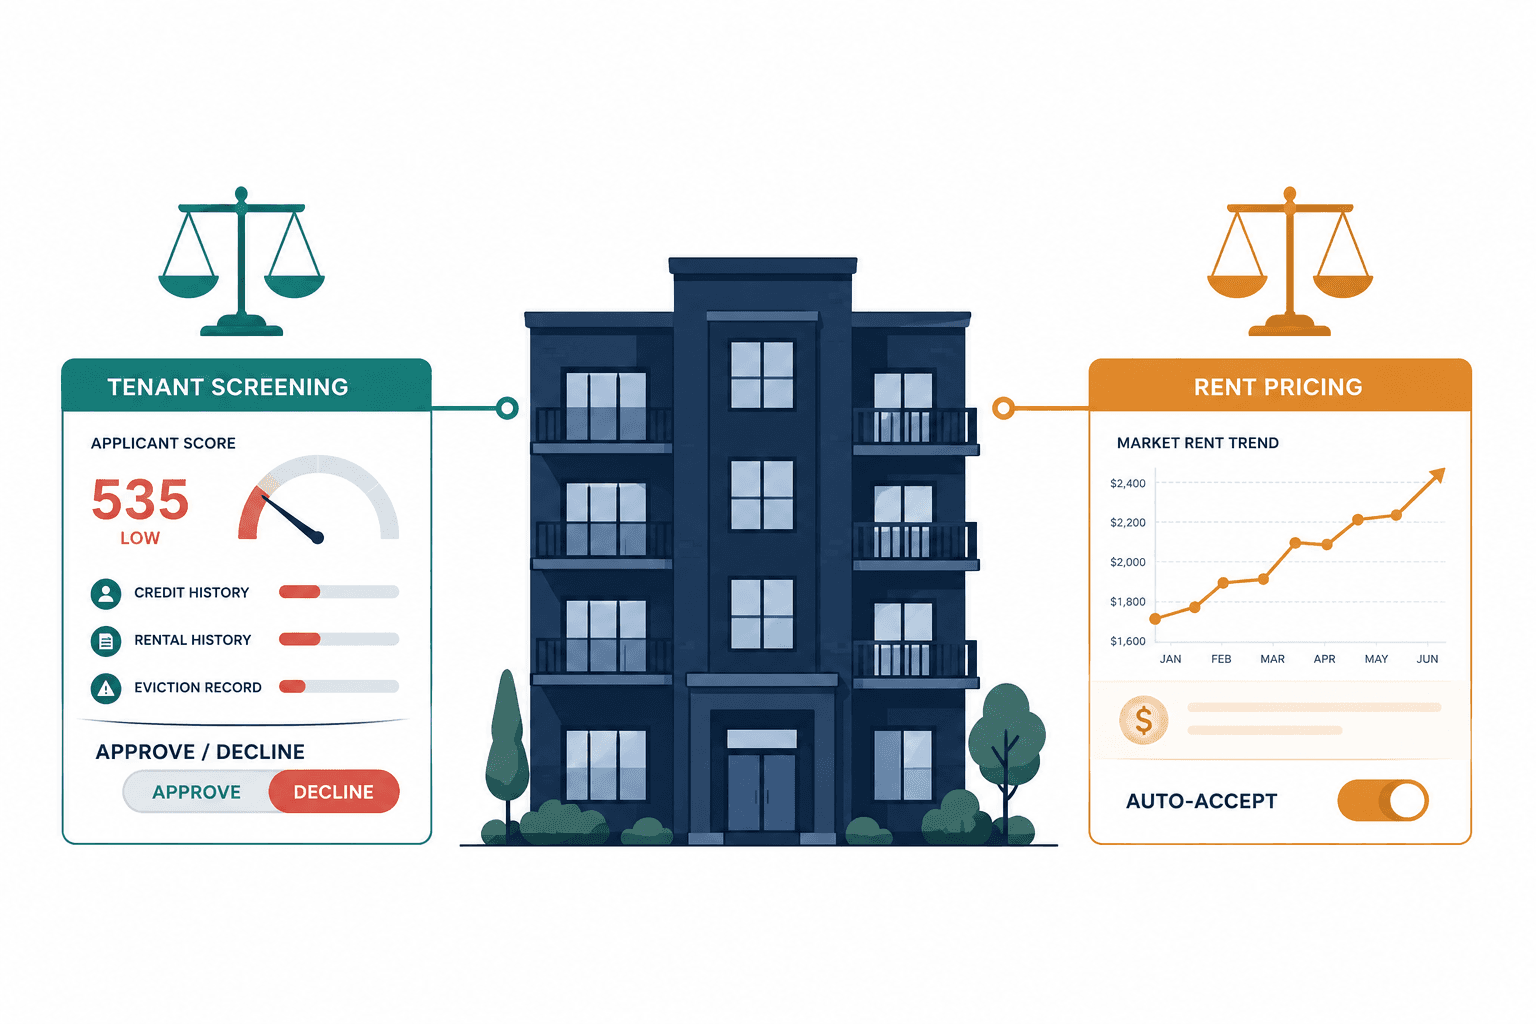
Ik heb Equora uitgevoerd tegen een vaste synthetische huurkandidatenpool voor bewonersscreening van 9.000 records. ScreenScore v3, de kredietgeoriënteerde basislijn in de demonstratie, produceerde een AUC van 0,7823. De minimale disparate-impact-ratio, of DIR, kwam uit op 0,694 voor zwarte aanvragers. De geconfigureerde vier-vijfde-beleidsgrens van de demo is 0,80. Die drempelwaarde is een ontwerpkeuze voor de demonstratie, niet een juridische conclusie en niet een automatische Fair Housing Act-test.
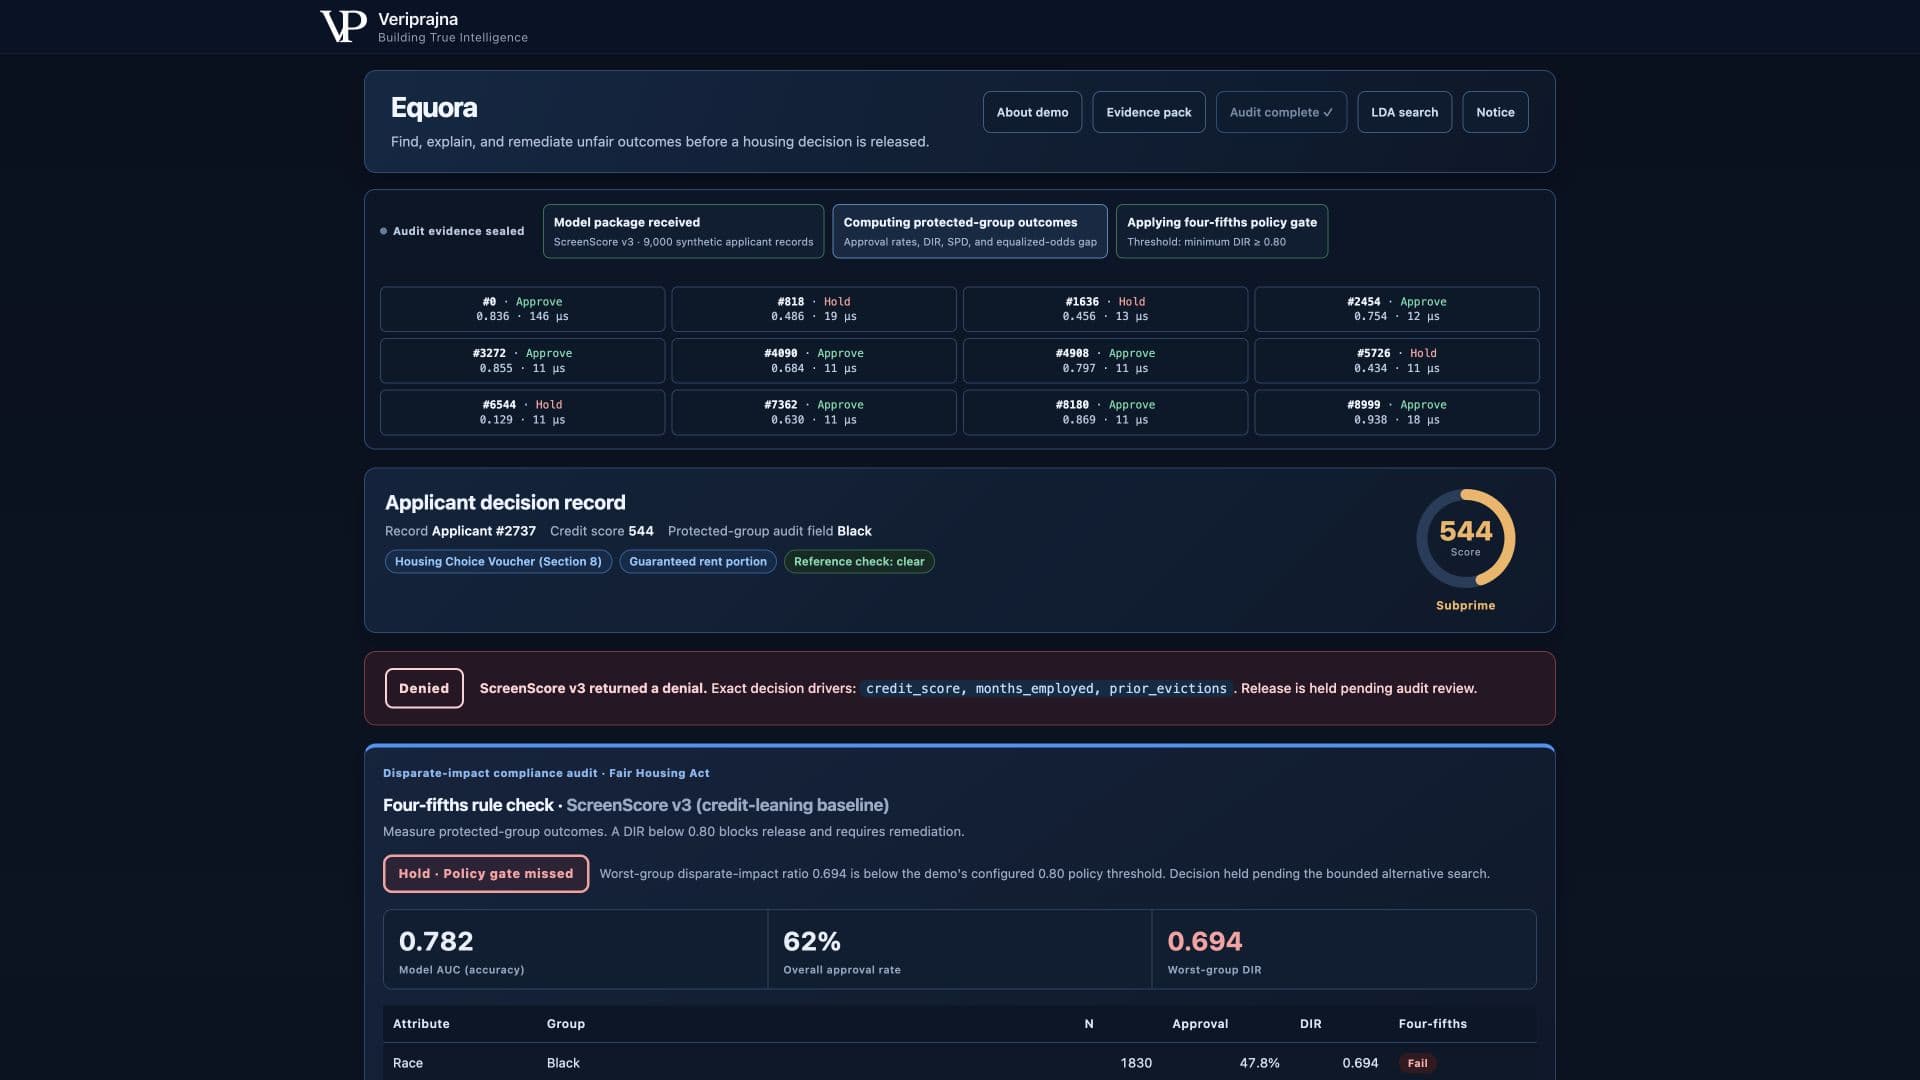
Mijn eerste versie had daar kunnen stoppen. Ze had het resultaat rood kunnen kleuren, een rapport kunnen genereren en compleet kunnen lijken in een beoordelingsvergadering. In plaats daarvan had ik het gevoel dat ik een beter alarm zonder responsplan had gebouwd. De metriek kon het team laten zien waar de basislijn zijn geconfigureerde grens niet haalde. Ze kon niet laten zien of er een alternatief met minder dispariteit bestond, welk nut dat alternatief zou opofferen, of hoe iemand de keuze later zou kunnen herhalen.
De vroege walkthrough is nog steeds nuttig bij de Equora-naleving voor woningmarkt-AI, maar de bouw werd pas interessant toen de rode audit de startlijn werd.
Wat de metriek onbeantwoord liet
Ik bleef terugkeren naar dezelfde lege ruimte onder de audittabel: welke wijziging zou ik verdedigen, en op welk bewijs? Er zijn gemakkelijke manieren om een fairness-getal te laten bewegen. Verander de goedkeuringsdrempel. Verwijder een kenmerk. Voeg een kenmerk toe. Pas regularisatie aan. Het cijfer beweegt, maar een beweging zonder een gedefinieerde zoekruimte en een stabiele selectieregel is moeilijk te besturen.
Ik probeerde het probleem te benaderen als één enkele modelaanpassing. Dat mislukte snel. Als ik de invloed van de kredietscore afkapte en het resultaat verbeterde, had ik nog steeds geen reden om aan te nemen dat die afkap de voorkeur verdiende boven een andere. Als ik gegarandeerd voucherinkomen meewoog, moest ik nog steeds de nutskosten ervan zien bij hetzelfde selectiepercentage. Elke geïsoleerde wijziging creëerde een nieuwe vraag over de alternatieven die ik niet had geëvalueerd.
Ik schreef die vragen naast het resultaat en realiseerde me dat mijn prototype geen stabiel antwoord had op geen van hen. Een tweede run kon een andere intuïtie weerspiegelen. Een derde kon de vergelijkingsset wijzigen zonder de wijziging te documenteren. Zelfs als elke keuze op zichzelf zinvol was, zou de volgorde moeilijk te reconstrueren zijn. Dat was het mislukte experiment: Ik had remediëring behandeld als een reeks modelafstemkeuzes terwijl het een gedeclareerde zoekprocedure had moeten zijn. Het onderscheid klinkt subtiel totdat iemand vraagt waarom één aanvaardbare kandidaat boven een andere werd geselecteerd.
De oplossing was om de zoekopdracht zelf een artefact te maken. Equora evalueert 480 expliciete, neutraal geformuleerde configuraties bij gelijke selectiviteit. Het raster varieert subsets van vier optionele hoog-risicokenmerken, kredietscoreafkappen van geen afkap, 720, 680 of 640, of gegarandeerd voucherinkomen wordt meegerekend, en zes L2-waarden van 0,1 tot en met 30,0. De schuld-inkomensratio, maanden in dienst en gerapporteerd inkomen blijven opgenomen.
Die grens is belangrijk omdat ik haar kan beschrijven. Ik kan haar opnieuw uitvoeren. Ik kan ook zeggen wat ze niet dekt. De zoekopdracht claimt niet elk mogelijk model, beleid of kenmerktransformatie te bestrijken. Het is een begrensde technische demonstratie met een bekend raster en een gedeclareerd nauwkeurigheidsbudget.
Een rode metriek registreert het probleem. Een beheerde zoekopdracht registreert de beschikbare respons.
Ik moest de zoekopdracht inspecteerbaarheid geven
Ik herinner me dat ik de fase bereikte waarop de zoekopdracht correct liep maar nog steeds ondoorzichtig aanvoelde. Aan het einde verscheen een aanbeveling, maar het pad ernaartoe was grotendeels verborgen in code. Die uitvoer was wiskundig verdedigbaar en operationeel zwak. Juridisch adviseurs of modelrisicoreviewers zouden mijn geheugen van welke combinaties zijn getest niet mogen hoeven vertrouwen.
Ik bracht de zoekruimte naar de interface en maakte de voortgang zichtbaar. Het systeem test elke configuratie op hetzelfde vaste synthetische referentiebestand en dezelfde selectiviteitsbeperking. Het registreert de AUC en minimale DIR van de kandidaat en plot vervolgens de nauwkeurigheid/eerlijkheid Pareto-grens. Als geen enkele kandidaat de geconfigureerde grens haalt binnen het 0,03 AUC-budget, geeft de engine geen veilig alternatief terug in plaats van een aanbeveling te fabriceren.
Ik wilde dat een reviewer concrete vragen kon stellen. Zijn de kredietafkappen geëvalueerd? Is gegarandeerd inkomen meegerekend? Heeft elke kandidaat de selectiviteit constant gehouden? Hoeveel kandidaten kwamen in aanmerking onder de geconfigureerde regel? Die zijn beantwoordbaar vanuit de registratie. De beslisprocedure blijft buiten het taalmodel: deterministische code berekent de statistieken, past de grens toe en selecteert de geschikte kandidaat met het kleinste gemeten AUC-verlies.
Ik moest ook weerstand bieden aan het wegpolijsten van de mislukte kandidaten. Een productscherm wil van nature één antwoord op de voorgrond plaatsen, maar de andere geteste punten geven de aanbeveling context. De grens laat een reviewer toe om AUC en minimale DIR te vergelijken over de geëvalueerde configuraties in plaats van alleen de geselecteerde coördinaat te zien. De verliezende kandidaten maken deel uit van het bewijs, omdat ze laten zien waarmee de selectieregel vergeleek voordat ze uitkwam op het gekwalificeerde resultaat.
Dit was het moment waarop mijn eigen framing veranderde. Ik was begonnen met een fairness-dashboard voor ogen. Wat ik eigenlijk aan het bouwen was, was een herhaalbaar besluitvormingsproces. De grafiek was nuttig omdat elk punt een geteste configuratie vertegenwoordigde, niet omdat een grens visueel overtuigend is.
De afruil die ik eindelijk kon zien
Ik zag de voltooide run alle 480 configuraties evalueren en 240 teruggeven die de 0,80-grens van de demo haalden binnen het geconfigureerde nauwkeurigheidsbudget. De aanbevolen configuratie behield de basiskenmerken, voegde gegarandeerde-inkomstenverrekening toe, beperkte de invloed van de kredietscore tot 640 en gebruikte L2-regularisatie van 10,0.
Ik kon het resultaat vervolgens lezen als een afruil in plaats van een bewijs van perfectie. Op dit vaste synthetische referentiebestand steeg de minimale DIR van 0,694 naar 0,875. De AUC bewoog van 0,7823 naar 0,7788, een gemeten verlies van 0,0036 dat de interface weergeeft als 0,36%. Voor de intersectie van zwarte voucherhouders in het referentiebestand bewoog de DIR van 0,701 naar 1,029.
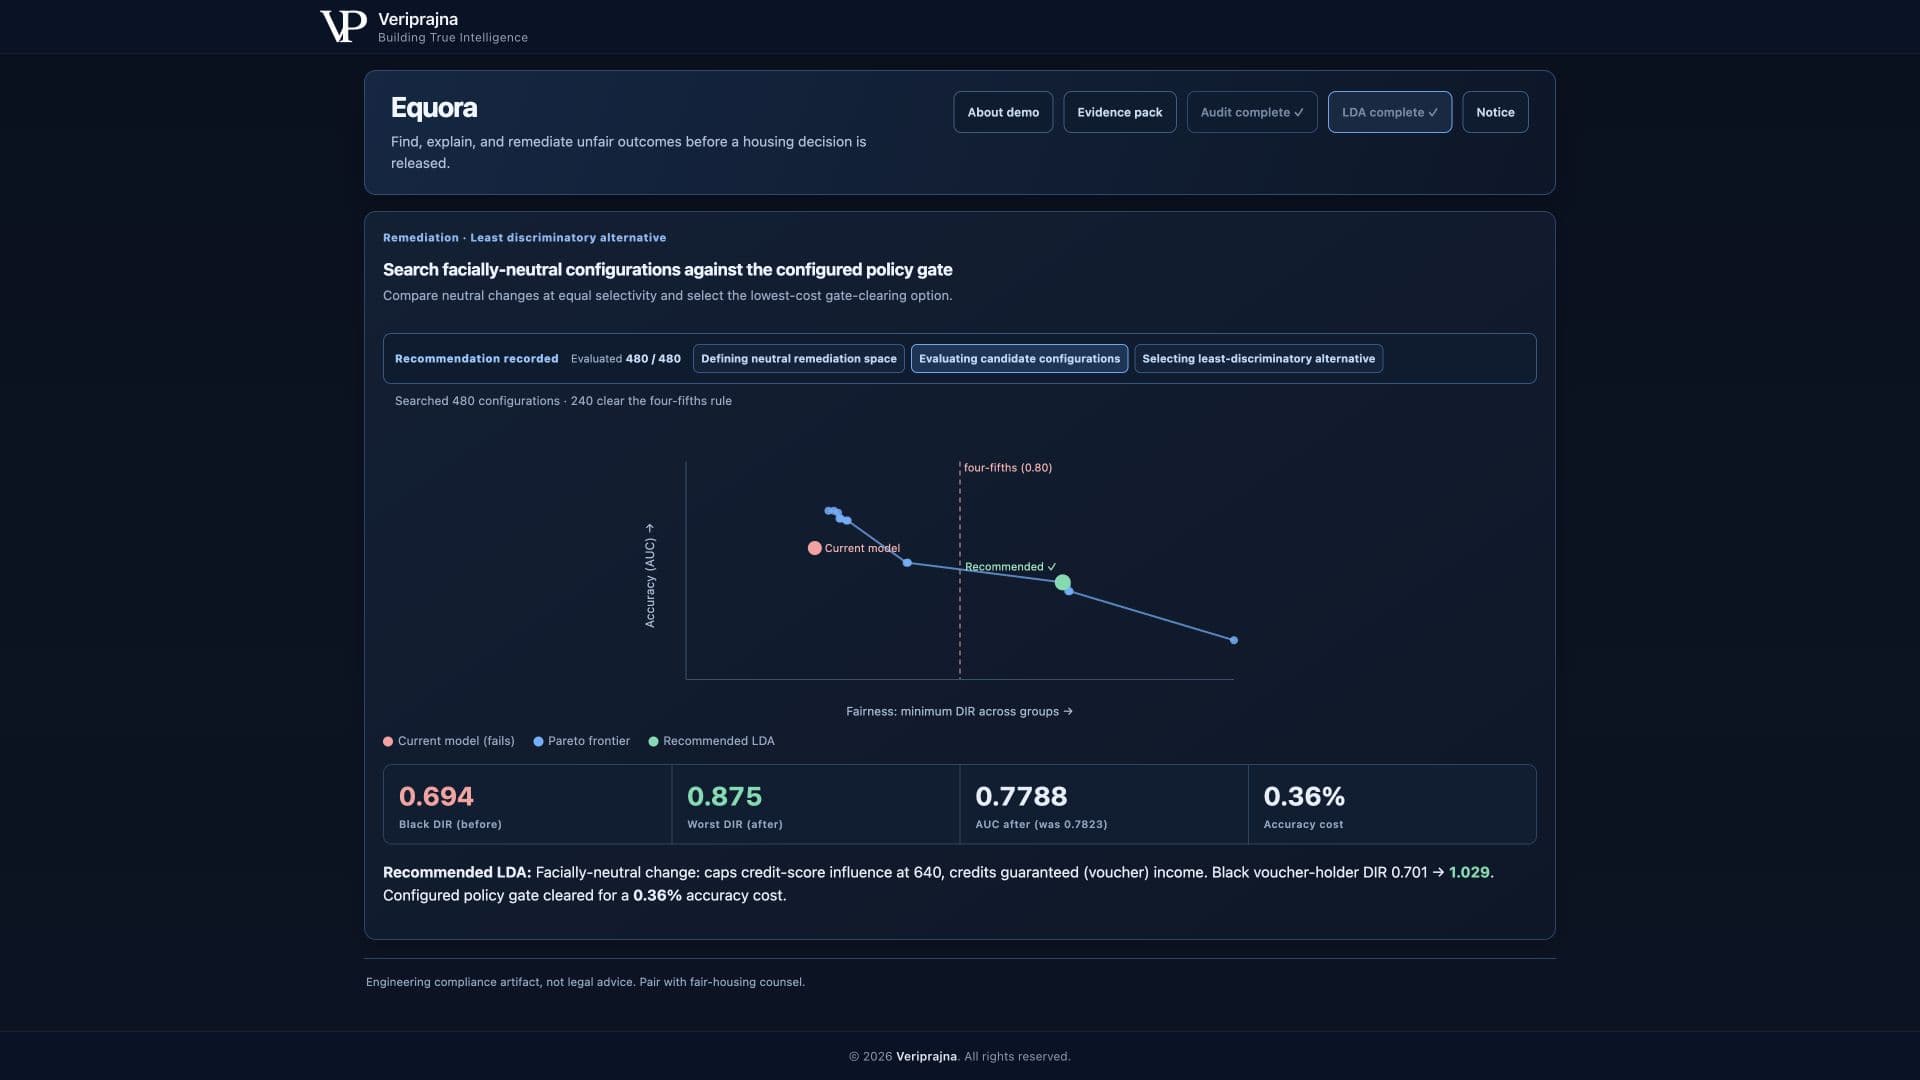
Ik ben voorzichtig met het woord aanbevolen. Deze kandidaat is de optie met de laagst gemeten AUC-kosten die in aanmerking komt binnen dit specifieke raster. Het is geen universeel optimum, juridische certificering of bewijs van een bias-vrij model. De cijfers beschrijven één gefitte basislijn en één begrensde zoekopdracht op synthetische gegevens. Ze beschrijven geen echte verhuurder, screeningsleverancier, aanvragerspool of woningmarkt.
Ik vond die zin moeilijker te schrijven dan het verbeteringsgetal. Producttaal beloont zekerheid, terwijl governance-werk afhankelijk is van het bewaren van reikwijdte. De begrensde bewering is juist sterker omdat een andere reviewer kan zien waar ze stopt. Als de organisatie het raster uitbreidt, het budget wijzigt of een andere beleidsgrens hanteert, moet ze een andere registratie en misschien een andere aanbeveling verwachten. De methode blijft herhaalbaar, zelfs wanneer de aannames veranderen.
Die beperking verzwakt de demonstratie niet. Ze maakt de reviewgrens expliciet. Een reviewer kan het 0,03-budget, de vier-vijfde-beleidsgrens, de beschikbare kenmerken, de selectiviteitsbeperking of het raster zelf in twijfel trekken. Die meningsverschillen worden inputs voor een proces dat opnieuw kan worden uitgevoerd, in plaats van opmerkingen gekoppeld aan een statische rode score.
Waarom ik het bewijs buiten de proza hield
Ik was verleid om gegenereerde tekst meer van de uitleg te laten dragen, omdat proza een interface voltooid laat aanvoelen. Ik trok me daarvan terug. Een vloeiende alinea kan niet vaststellen welke configuraties zijn getest, DIR berekenen of beslissen of een kandidaat een drempel haalt. Dat zijn computationele beweringen, en ik wilde dat de registratie zou overleven zelfs als elke gegenereerde zin werd verwijderd.
Ik scheidde de rollen. Deterministische code berekent de audit, zoekt de alternatieven, past de geconfigureerde grens toe en bewaart het resultaat. Een taalmodel, wanneer ingeschakeld, is beperkt tot het opstellen van tekst. Offline modus gebruikt een deterministisch sjabloon. Het bewijs is niet afhankelijk van de formulering.
Ik paste dezelfde grens toe op een aanvragergerichte motivering. Voor een geweigerd synthetisch record identificeert exacte lineaire-modelkenmerktoewijzing de drie grootste negatieve bijdragers. De opsteller van de kennisgeving moet die kenmerken vermelden. Een gefundeerde terugvalkennisgeving doorstaat die smalle controle, terwijl een generieke redencode die geen kenmerk noemt, mislukt en naar menselijke beoordeling wordt doorgestuurd. De criticus verifieert alleen kenmerkverankering. Ze stelt geen volledige FCRA-naleving of juridische voldoendheid vast.
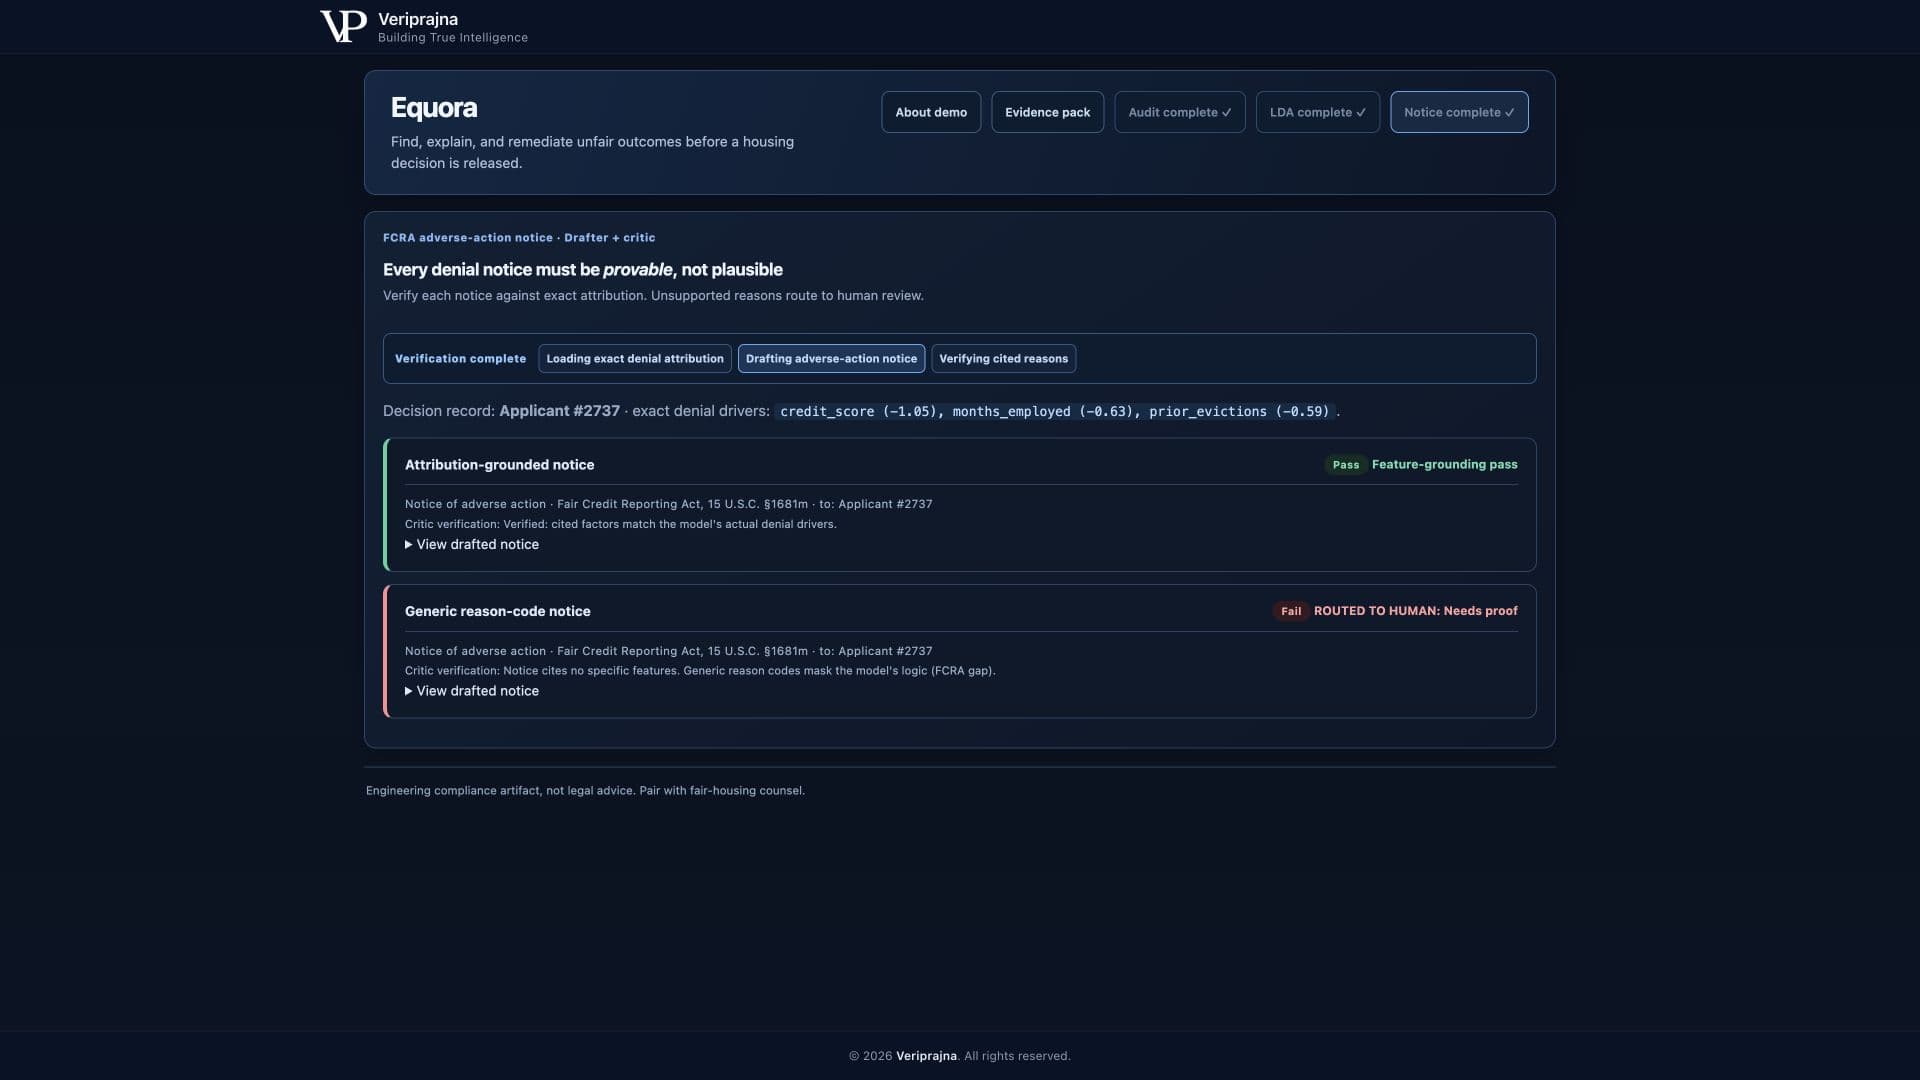
Dit grenst aan de zoekopdracht en is geen tweede stelling. Zodra een team een alternatief kiest, moet het bewijs nog steeds worden opgenomen in de beslissingsregistratie en eventuele toelichting die eruit wordt vrijgegeven. Een herhaalbare zoekopdracht verliest zijn bestuurswaarde als de laatste stap een reden kan verzinnen.
Het artefact dat ik in de vergadering zou willen hebben
Ik stel me de beoordelingsvergadering nu anders voor. Ik stel me niet iemand voor die een rode score presenteert en de zaal vraagt een brede belofte te accepteren om het model te verbeteren. Ik stel me een reviewer voor die het begrensde raster opent, elke kandidaat bij gelijke selectiviteit bekijkt, de Pareto-grens controleert en het geselecteerde resultaat terugtraceert naar de geconfigureerde regel.
Ik zou willen dat de registratie zowel de winst als de kosten toont. Hier betekent dat minimale DIR van 0,875 en AUC van 0,7788 na de zoekopdracht, met de basiswaarden ernaast. Ik zou ook willen dat het systeem de alternatieven behoudt die het heeft verworpen en geen veilig alternatief teruggeeft wanneer geen enkel in aanmerking komt. Een gedwongen aanbeveling zou de belangrijkste mogelijke uitkomst wissen.
De volledige walkthrough is beschikbaar in de Equora-naleving voor woningmarkt-AI. Het toont de audit, de begrensde Minst Discriminerende Alternatief-zoekopdracht, de afruil-weergave en de bewijsoverdracht. Het blijft een technische demonstratie gebouwd op synthetische gegevens, geen productief beslissingssysteem of juridisch advies.
En als u liever de workflow ziet dan mij hem hoort beschrijven, hier is de oprichterwalkthrough die van begin tot eind loopt.
Ik begon met een rode metriek omdat dat het voor de hand liggende was om te tonen. Ik eindigde ervan overtuigd dat het waardevolste artefact het herhaalbare pad is van het rode resultaat naar een begrensde keuze, inclusief de mogelijkheid dat het pad eindigt zonder enige in aanmerking komende keuze. Een audit kan een team vertellen te stoppen. Een zoekregistratie kan laten zien wat ze hebben onderzocht voordat ze beslisten hoe verder te gaan.