Een Medicare Advantage-model scoorde een afwijzing bij 0.985. De poort hield deze vast voor artsbeoordeling.

Ik opende een synthetisch Medicare Advantage-dossier voor voorafgaande goedkeuring in CertaRoute en vond een initiële afwijzing bij 0.985 modelbetrouwbaarheid. De patiëntspecifieke indicatoren zijn aanwezig, maar zijn slechts goed voor 22.06% van de absolute attributie van het model. De beslissingsgovernance-laag houdt het dossier aan voor beoordeling door een arts in plaats van betrouwbaarheid te behandelen als toestemming om een afwijzing af te ronden.
Dat is de ontwerpbeslissing die ik zichtbaar wilde maken. Het model is niet defect louter omdat het een hoge score produceert. De vraag is of de score voldoende omstandigheden van deze concrete persoon bevat om de beslissing te dragen. De volledige walkthrough toont de route, factoren en het lokale dossier van de app. Het is een toelichting met video en screenshots, geen interactief betalersysteem.
De afwijzing leek beslist totdat ik het dossier opende
Ik blijf terugkeren naar A-4471, een gescripte verlenging van post-acute gespecialiseerde verpleging in onze synthetische startgegevens. In de werklijst luidt de initiële modelbeoordeling DENY. Dat is precies het soort heldere uitvoer dat een overhaast beoordelingsproces kan verwarren met een afgeronde vaststelling. In het casusdossier staan individuele klinische factoren naast populatiegewogen factoren. Hetzelfde scherm meldt artsbeoordeling in behandeling, en de technische dossierstatus is NEEDS_PROOF.
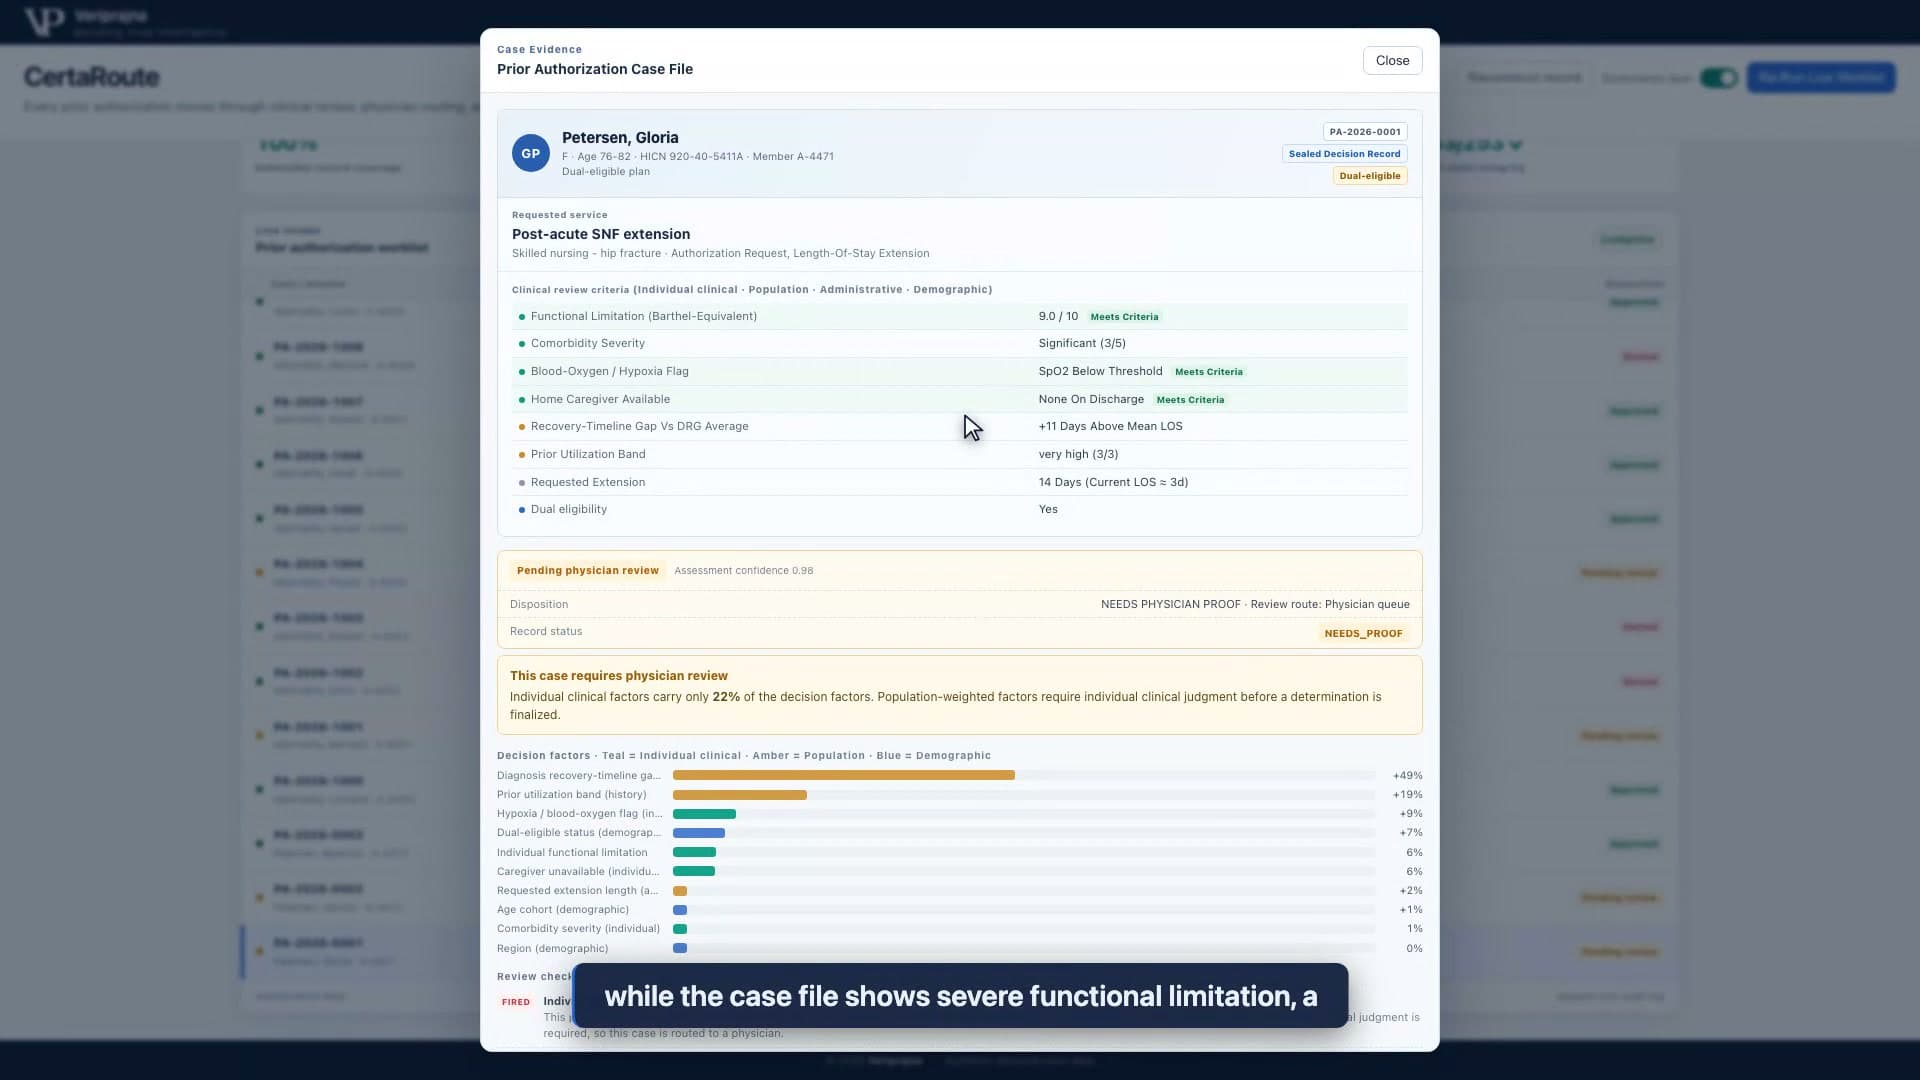
Ik wil niet dat een lezer deze klinische observaties aanziet voor het dossier van een echte verzekerde. De naam, het polisnummer en de casus zijn fictief. Het QNXT-bronlabel is louter een plaatsaanduiding. Achter deze weergave schuilt geen echte claim, dekkingsbeslissing of wachtrij met artsen. Ik heb een synthetische casus gebruikt zodat de mechanismen kunnen worden geïnspecteerd zonder geloofwaardigheid te ontlenen aan het verhaal van een echte patiënt dat we niet hebben.
Het eerste spanningsveld is helder: het casusdossier bevat geïndividualiseerde feiten, maar een afwijzing met hoge betrouwbaarheid kan nog steeds hoofdzakelijk gevormd worden door geaggregeerde historiek. Een patiëntveld in de invoer zien is niet hetzelfde als zien dat het meetelt in het resultaat. Dat onderscheid raakt snel verloren wanneer de interface de uitvoer van een model reduceert tot een enkele groene of rode badge. Ik wilde het tegenovergestelde: een casusweergave waarin het eerste antwoord en het gebruikte bewijs samen gelezen kunnen worden.
De CMS verduidelijkte de onderliggende verantwoordelijkheid in haar FAQ over dekkingscriteria en gebruiksbeheer van februari 2024. Dekkingsbeslissingen van Medicare Advantage moeten rekening houden met de omstandigheden van de individuele patiënt; een algoritme gebaseerd op een grotere dataset kan die beoordeling niet vervangen. Ik beschouw dat als een ontwerprandvoorwaarde, niet als een claim dat deze demonstratie voldoet aan de eisen van Medicare Advantage. Werkelijke dekkingscriteria, klinisch oordeel en planoperaties zouden in een reële implementatie moeten worden geëvalueerd.
De 22.06% achter een 0.985-afwijzing
Aanvankelijk wil ik 0.985 lezen als geruststelling. Vervolgens kijk ik naar de attributiebalken. In A-4471 draagt de kloof in de herstelijdlijn voor ongeveer 49% bij aan de absolute attributie en eerder zorggebruik voor ongeveer 19%. Individuele klinische factoren dragen samen slechts 22.06% bij. Het casusdossier geeft die factoren ruimte op de pagina, maar het model kent ze veel minder gewicht toe bij zijn afwijzing.
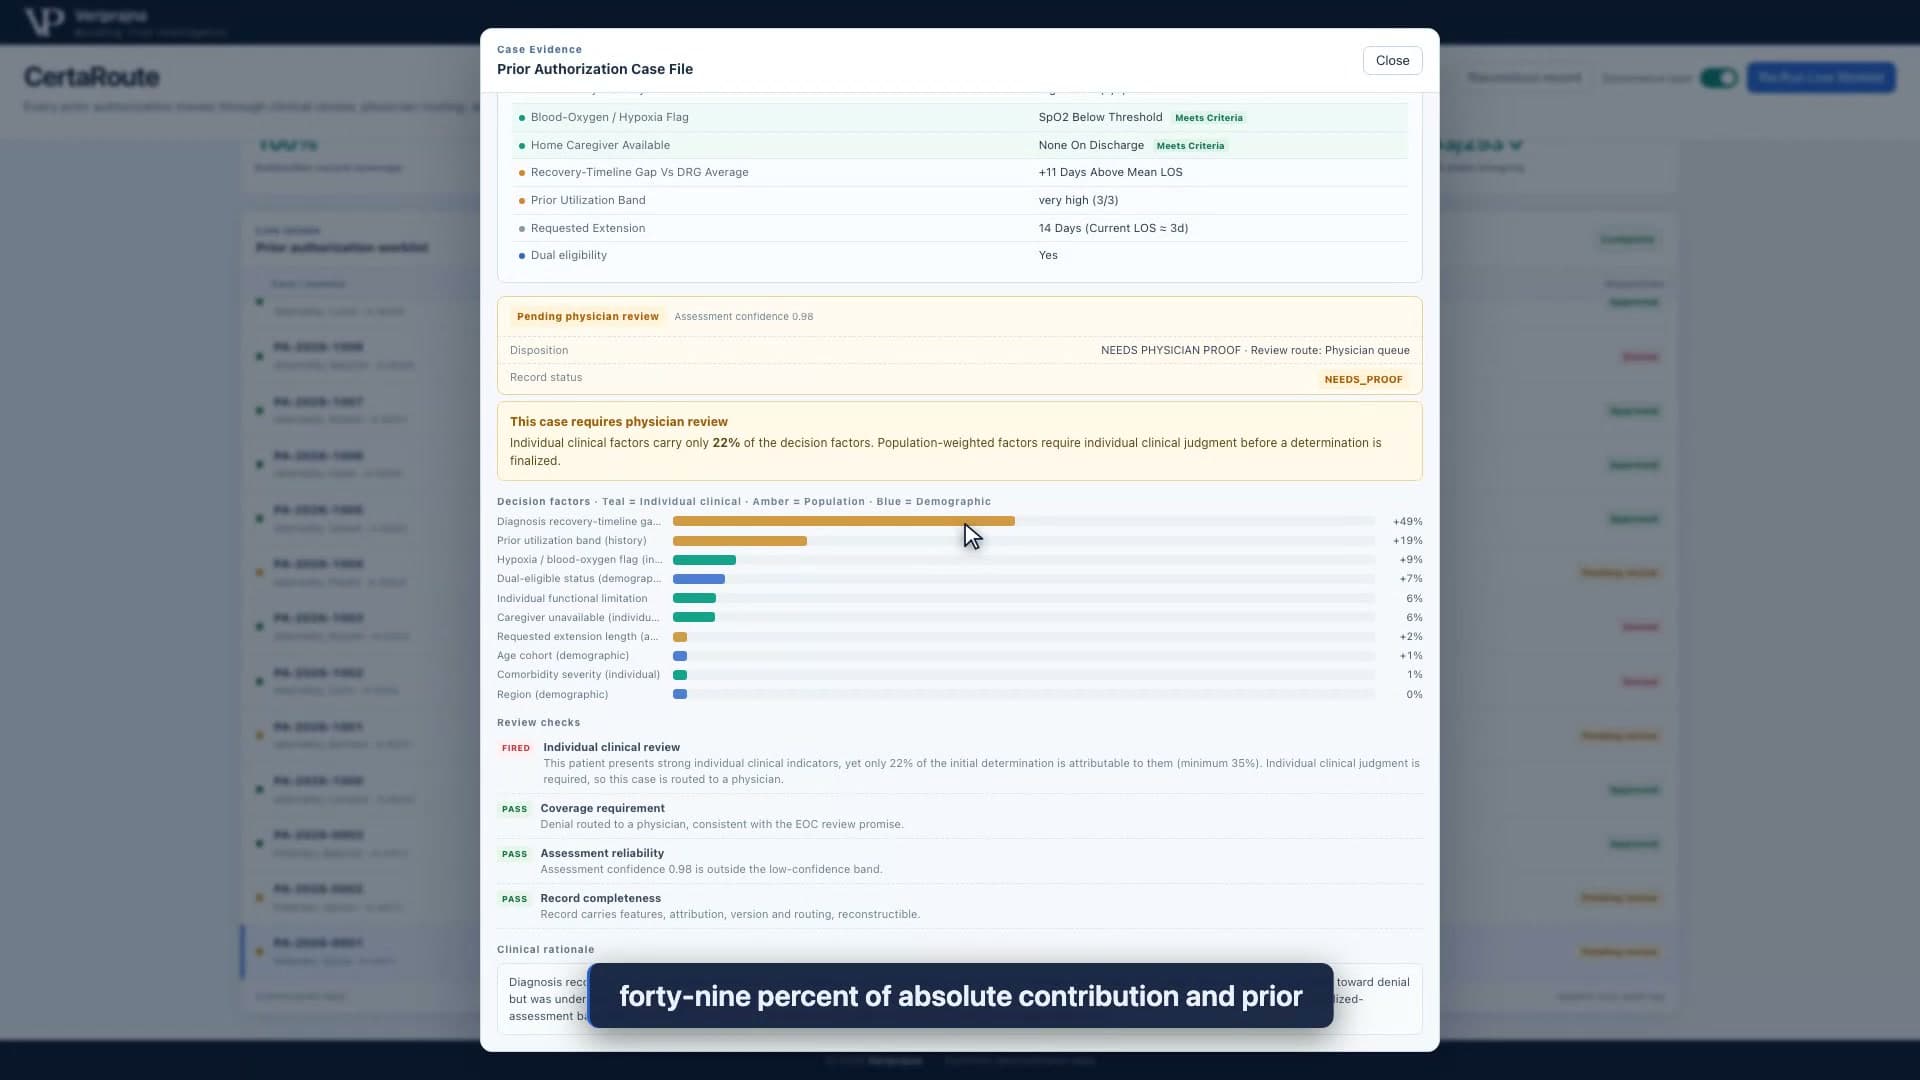
Ik moest weerstand bieden aan een al te eenvoudige, misleidende interpretatie van die grafiek. Shapley-attributie legt uit hoe dit specifieke getrainde vervangende model de bijdrage verdeelde over zijn tien kenmerken. Het bewijst niet dat een individuele factor medisch doorslaggevend is of dat de juiste dekkingsuitkomst een goedkeuring is. Een patiënt kan belangrijke klinische feiten hebben die het model gebrekkig weergeeft; een grafiek alleen kan daarover niet oordelen. De bruikbare gevolgtrekking is nauwer en krachtiger: de betrouwbaarheid van het model vertelde me niet of individueel bewijs voldoende gewicht droeg.
Daarom is de ondergrens in deze demo een routeringsdrempel, geen drempel voor medische noodzaak. Bij een configureerbaar aandeel van 35% wordt een prominente afwijzing met te weinig attributie aan individuele factoren vastgehouden. Deze wordt naar een artsbeoordelingsroute gestuurd met het label NEEDS_PHYSICIAN_PROOF. Er is geen sprake van automatische herroeping. Er is ook geen geruisloze omzetting van de initiële modelafwijzing in een definitieve planafwijzing. Het doel van de controle is te voorkomen dat die twee gebeurtenissen als één en dezelfde worden behandeld.
Ik vind dat onderscheid nuttiger dan een algemene discussie over de vraag of AI thuishoort in gebruiksbeheer. Een model kan helpen informatie te ordenen en te beoordelen. Maar als het operationele systeem een beoordelaar niet kan vertellen waarom een specifieke afwijzing overging van modeluitvoer naar een geautoriseerde beslissing, dan heeft een hoog betrouwbaarheidsgetal meer autoriteit verworven dan het verdient. In A-4471 zegt het model het ene en zegt de governanceroute in wezen dat het bewijs nog steeds een arts nodig heeft.
De trigger moet binnen zijn reikwijdte worden gelezen. Dezelfde demo bevat een goedkeuring waarvan de attributie aan individuele factoren onder de ingestelde ondergrens ligt. Deze wordt niet door deze controle omgeleid omdat de ondergrens geldt voor prominente afwijzingen. Die asymmetrie is doelbewust in de code aangebracht. De ondergrens beschrijven als een universele klinische kwaliteitstest zou onjuist zijn en zou de specifieke operationele vraag verhullen die dit voorbeeld daadwerkelijk stelt.
Ik heb de autoriteit uit de toelichting gehaald
Ik kan een adviserende alinea overtuigend laten klinken. Maar ik kan proza niet tot een veilige routeringsautoriteit maken louter door een taalmodel te vragen het te schrijven. In CertaRoute berekent een deterministische governance-gate de route op basis van de casus en de modeluitvoer. De toelichtende tekst volgt daarna. In het standaardtraject zonder API-sleutel is het een deterministische sjabloon; een optionele koppeling kan door modellen gegenereerde bewoordingen leveren. Geen van beide versies heeft de bevoegdheid de uitkomst te autoriseren.
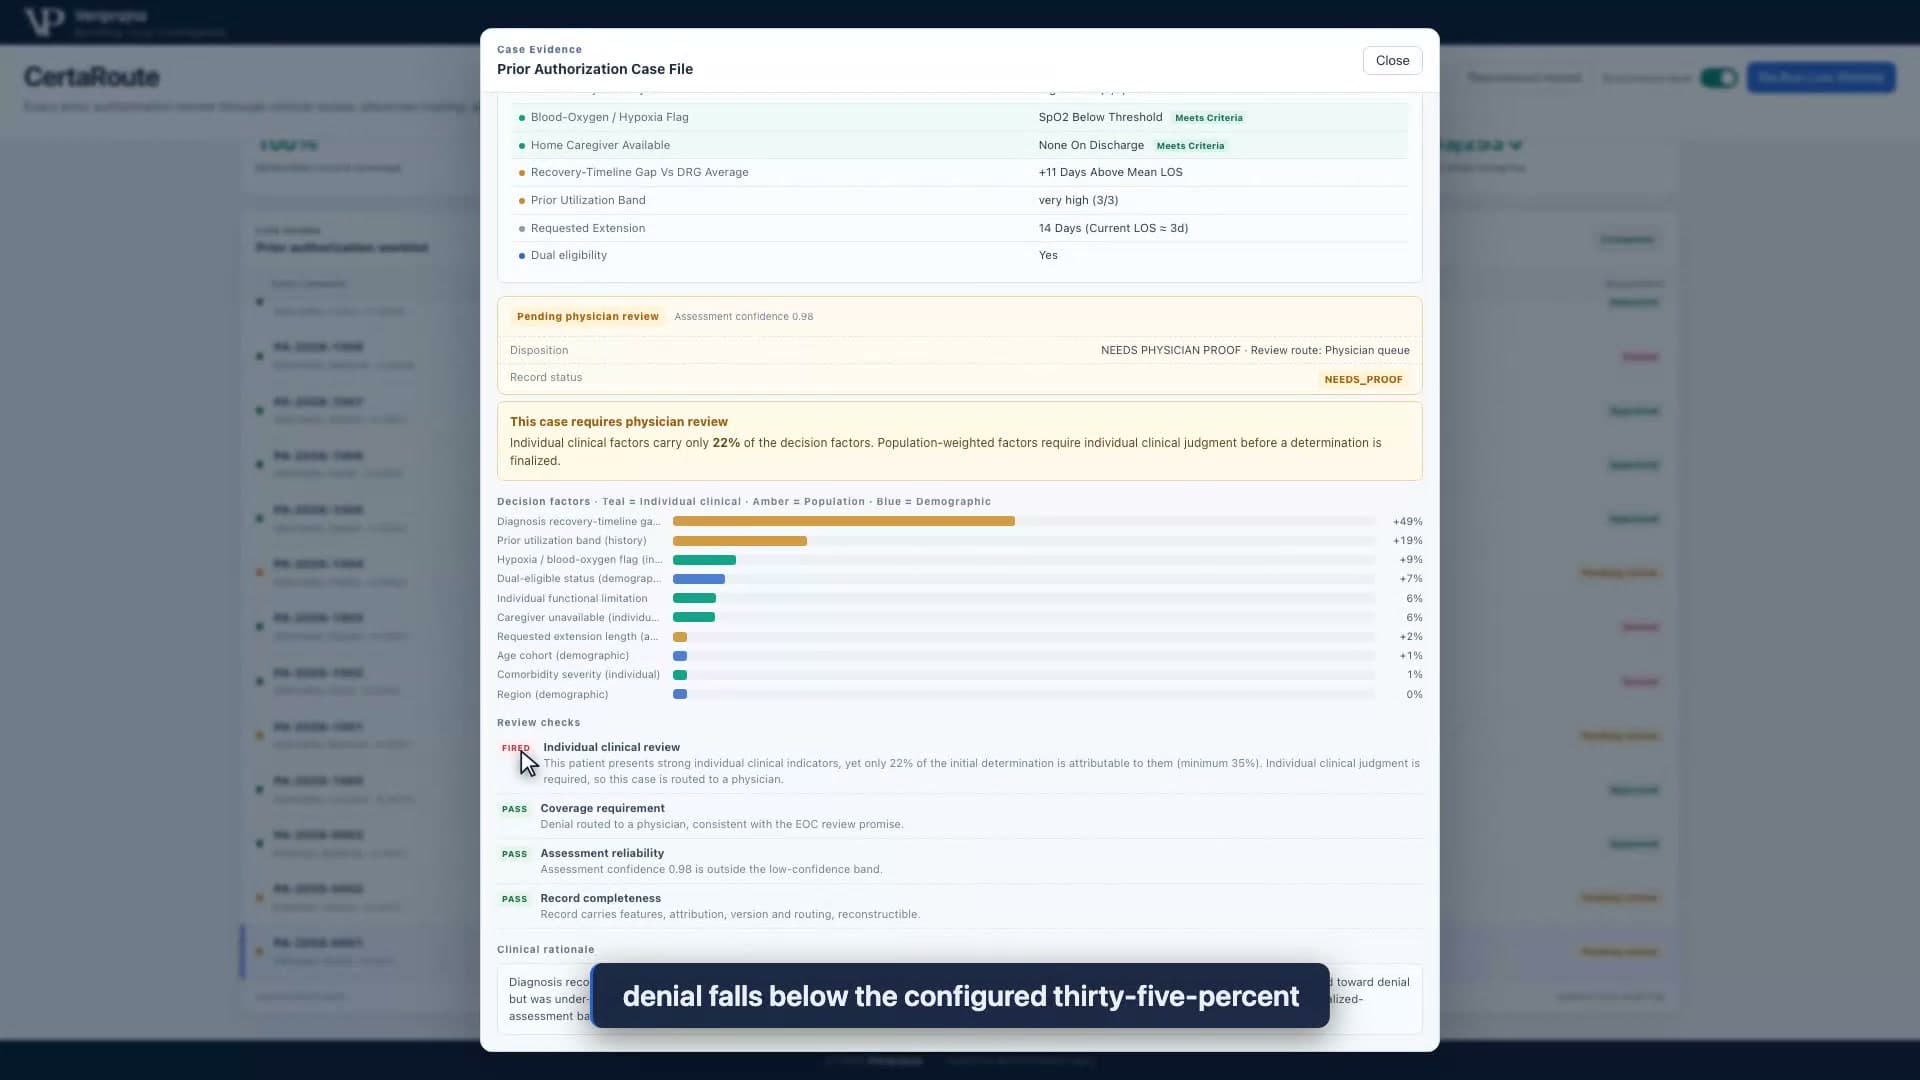
Ik zie dit als het moment waarop de interface ophoudt een conventionele modeldemo te zijn. De schriftelijke motivering kan het resultaat begrijpelijk maken, maar de regel is afzonderlijk inspecteerbaar. Ik kan wijzen op invoer, attributie, ingestelde ondergrens en route zonder van iemand te vragen te vertrouwen op de stijl van een gegenereerde alinea. Als een toekomstige toelichting overdrijft wat het bewijs aantoont, leidt de poort nog steeds tot hetzelfde resultaat. Die scheiding stelt een beoordelaar een betere vraag: heeft de code deze casus om de juiste reden gerouteerd, volgens het juiste beleid, met behoud van de juiste klinische context?
Het antwoord in deze demo is begrensd. De controle op dekkingsvereisten is een verklaring gebaseerd op routering; het vergelijkt de casus niet met een echt Evidence of Coverage-document. De controle op volledigheid heeft een vlag voor aanwezigheid van velden, maar deze pijplijn geeft die vlag momenteel door als True in plaats van elk veld onafhankelijk te inspecteren. Ik wil niet dat het vriendelijke PASS-label van die controles in de marketing belandt als bewijs van complete dossiers of naleving van het plan. Een zichtbare controle is alleen nuttig als de reikwijdte ervan evenzeer zichtbaar is.
Het lage-betrouwbaarheidsbereik en een geprogrammeerde zeldzame comorbiditeitscombinatie bieden in de vaste testuitvoering andere toetsingswegen, maar zij zijn niet de reden waarom A-4471 mij bezighoudt. Deze casus beproeft de lastigere verleiding: een model kan zeer zeker zijn en toch te veel omstandigheden van een specifieke persoon naar de achtergrond verdringen. De ontwerpvraag is wie het gezag heeft op die grens. In deze demonstratie houdt de code de afwijzing tegen en zou een arts in een echte workflow nog steeds een geïndividualiseerde beoordeling moeten maken. De getoonde wachtrij zelf is louter demostatus.
Ik heb de uitdrukking "mens in de lus" horen gebruiken voor uiteenlopende constructies. Het kan betekenen dat een echte arts de volledige context inziet voorafgaand aan een beslissing. Het kan ook slechts een wachtrijlabel betekenen dat wordt toegekend nadat een beslissing feitelijk al is genomen. In onze app is het wachtrijlabel het zichtbare einde van de simulatie. Het zwaardere werk daarbuiten zou proceseigenaarschap, kwalificaties, toegangscontroles, daadwerkelijke plancriteria en bewijs dat een beoordeling heeft plaatsgevonden omvatten. Ik toon de grens liever helder dan te suggereren dat een label bewijst dat die stappen zijn gezet.
Het dossier maakte het moeilijker om mijn grenzen te negeren
Vervolgens onderzoek ik de casusreconstructie. De app schrijft een lokaal SQLite-record waarvan de hash die van het vorige record meeneemt, en herberekent de keten tijdens de verificatie. In de vaste synthetische testrun werden 253 van de 253 records geverifieerd vóór enige manipulatie. Een demobediening wijzigt een opgeslagen record zonder de hash ervan opnieuw te berekenen; de verificateur meldt daarop een verbroken keten. Het record voor A-4471 kan worden gereconstrueerd en als HTML worden afgedrukt.
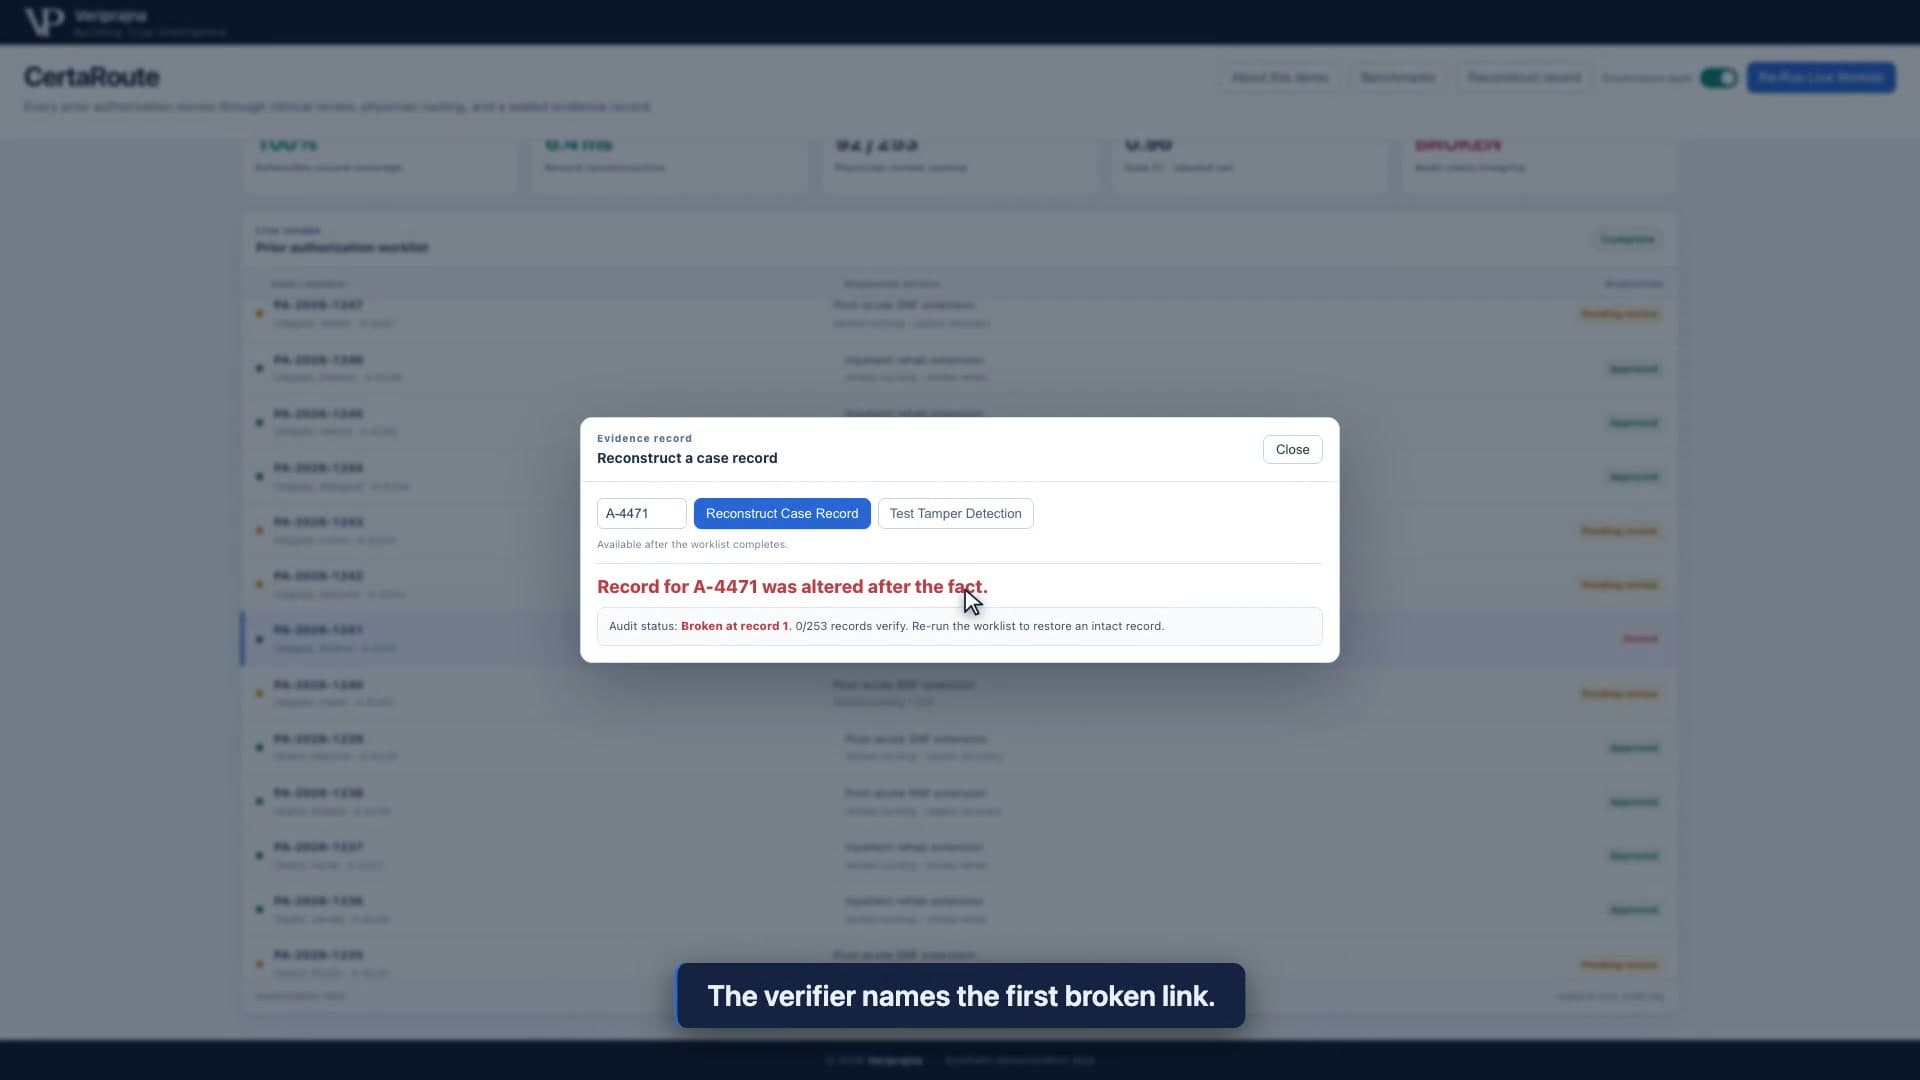
Ik vind het prettig dat het dossier me iets concreters biedt dan een belofte om "bewijs te bewaren". Het bevat de casusinvoer, de attributie en de routeringsstatus waarmee een ander zou kunnen navragen wat het systeem heeft gedaan. Maar wanneer ik de gereconstrueerde uitvoer lees, zie ik ook wat het niet kan bieden: het voltooide oordeel van een gekwalificeerde arts, gevalideerde klinische context en een onafhankelijk gecontroleerde bewakingsketen. Een technisch intacte keten certificeert geen van die ontbrekende elementen. Het kan een wijziging in dit lokale record aan het licht brengen; het kan op zichzelf niet bewijzen dat de onderliggende gegevens juist waren of dat de uiteindelijke dekkingsbeslissing wettig was.
De app noemt sommige records DEFENSIBLE. Ik beschouw dat als een demostatuslabel, niet als een juridische conclusie. In de vaste run volgden 92 van de 253 casussen een artsbeoordelingstraject en kregen NEEDS_PROOF; dat zijn openstaande afwijzingen, geen voltooide verdedigbare afwijzingen. De overige 161 zijn gemarkeerd als DEFENSIBLE door de demologica, die veldinhouden niet onafhankelijk valideert. Zelfs de 100% dossierdekking in de laagvergelijking betekent louter reconstrueerbare technische dossiers in deze vaste testrun. Het beschrijft geen geïmplementeerd plan en vestigt evenmin juridische verdedigbaarheid.
Dit is een veeleisendere manier om over een audittrail te spreken. Ik kan een mechanisme demonstreren om technische feiten vast te leggen en te controleren, terwijl ik tegelijkertijd de klinische en operationele feiten benoem die het niet bevat. Als een gewijzigde lokale rij kan worden opgemerkt, is dat waardevol. Als het ontbreken van een medisch oordeel in dezelfde adem kan worden genoemd, wordt het dossier minder snel een rekwisiet dat valse geruststelling wekt.
Wat ik wil dat een beoordelaar ziet
Ik keer terug naar de initiële afwijzing omdat deze gemakkelijk uit het oog raakt onder een opeenstapeling van geaggregeerde resultaten. Het benchmarkpaneel bevat een ingebouwde kloof in het afwijzingspercentage voor dubbel in aanmerking komende personen in de brongegevens en een synthetische routeringsscore. Zulke weergaven kunnen vragen oproepen over een populatie. Ze kunnen me niet vertellen of A-4471 een geïndividualiseerde beoordeling heeft gekregen. Een cohortsignaal en een route op casusniveau dienen verschillende doelen; dit essay blijft bij de individuele casus.
Ik wil dat een leider op het gebied van compliance of medisch management die naar deze demonstratie kijkt, een heldere volgorde kan volgen. Er is een synthetisch verzoek om verlenging van post-acute verpleegkundige zorg. Het getrainde vervangende model wijst dit aanvankelijk met grote stelligheid af. Exacte Shapley-attributie toont welke kenmerken die beoordeling hebben bepaald. Het individuele klinische aandeel daalt onder een ingestelde drempel voor een prominente afwijzing. Een codepoort houdt de casus vast voor artsbeoordeling. Een lokaal dossier bewaart wat de app deed, terwijl het echte werk van de arts en de daadwerkelijke planintegratie buiten de demo blijven.
Hier is de oprichters-walkthrough van de synthetische casus en de beoordelingspoort.
Die volgorde is zichtbaar in de volledige CertaRoute-analyse. Het vormt geen aanspraak op klinische validatie, een reële aansluiting op een verzekeraar of een conformiteitscertificering. Voor mij ligt de praktische waarde in de ongemakkelijke pauze tussen een zelfverzekerde modeluitvoer en de bevoegdheid om daarnaar te handelen. Als de omstandigheden van een patiënt die routering niet zichtbaar veranderen, heeft de betrouwbaarheidsscore de verkeerde vraag beantwoord.