当AI导购回答仅部分正确时

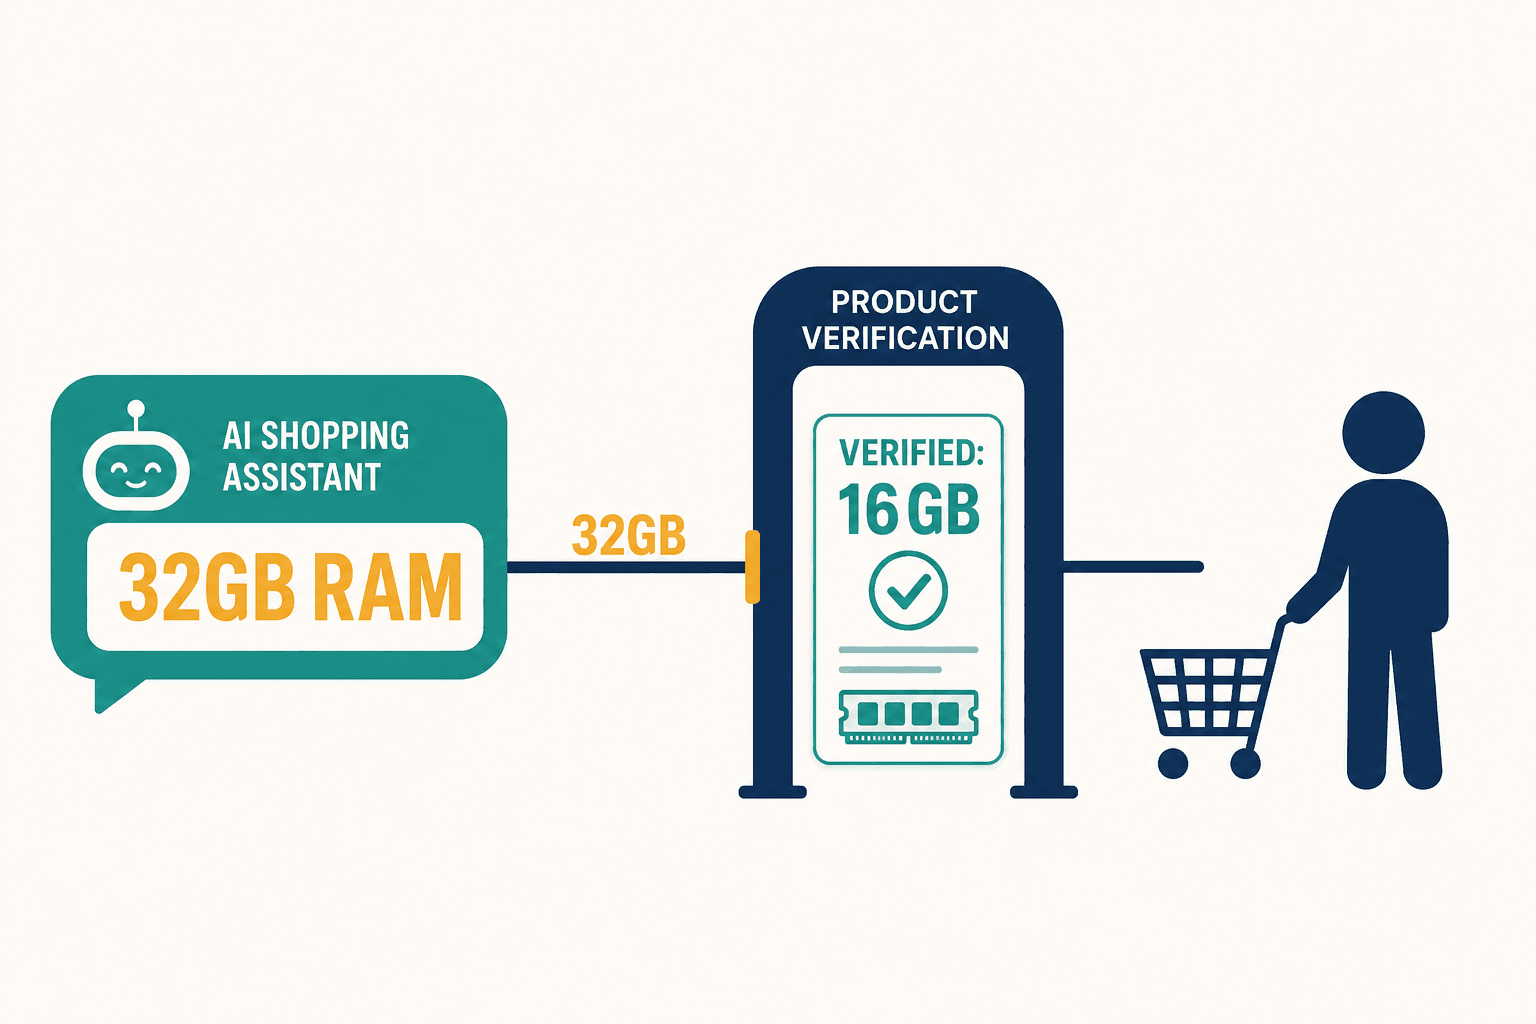
AI导购回答可能准确指出某款产品的刷新率,同时却承诺该产品根本不支持的某项标准。接受完整回答会保留错误;全盘否定回答又会丢弃有价值的细节。我更倾向于设立一个能够独立做出这些决定并对每项决定予以合理解释的验证边界。
这种倾向对电商团队具有切实的指导意义:回答应当在可核验主张的层面上赢得信任。流畅的语句固然是一种便捷的沟通方式,但它将与商品目录具有不同对应关系的主张捆绑在了一起。审核的核心任务就是在组织呈现给消费者的回答之前,理清并拆解这些关系。
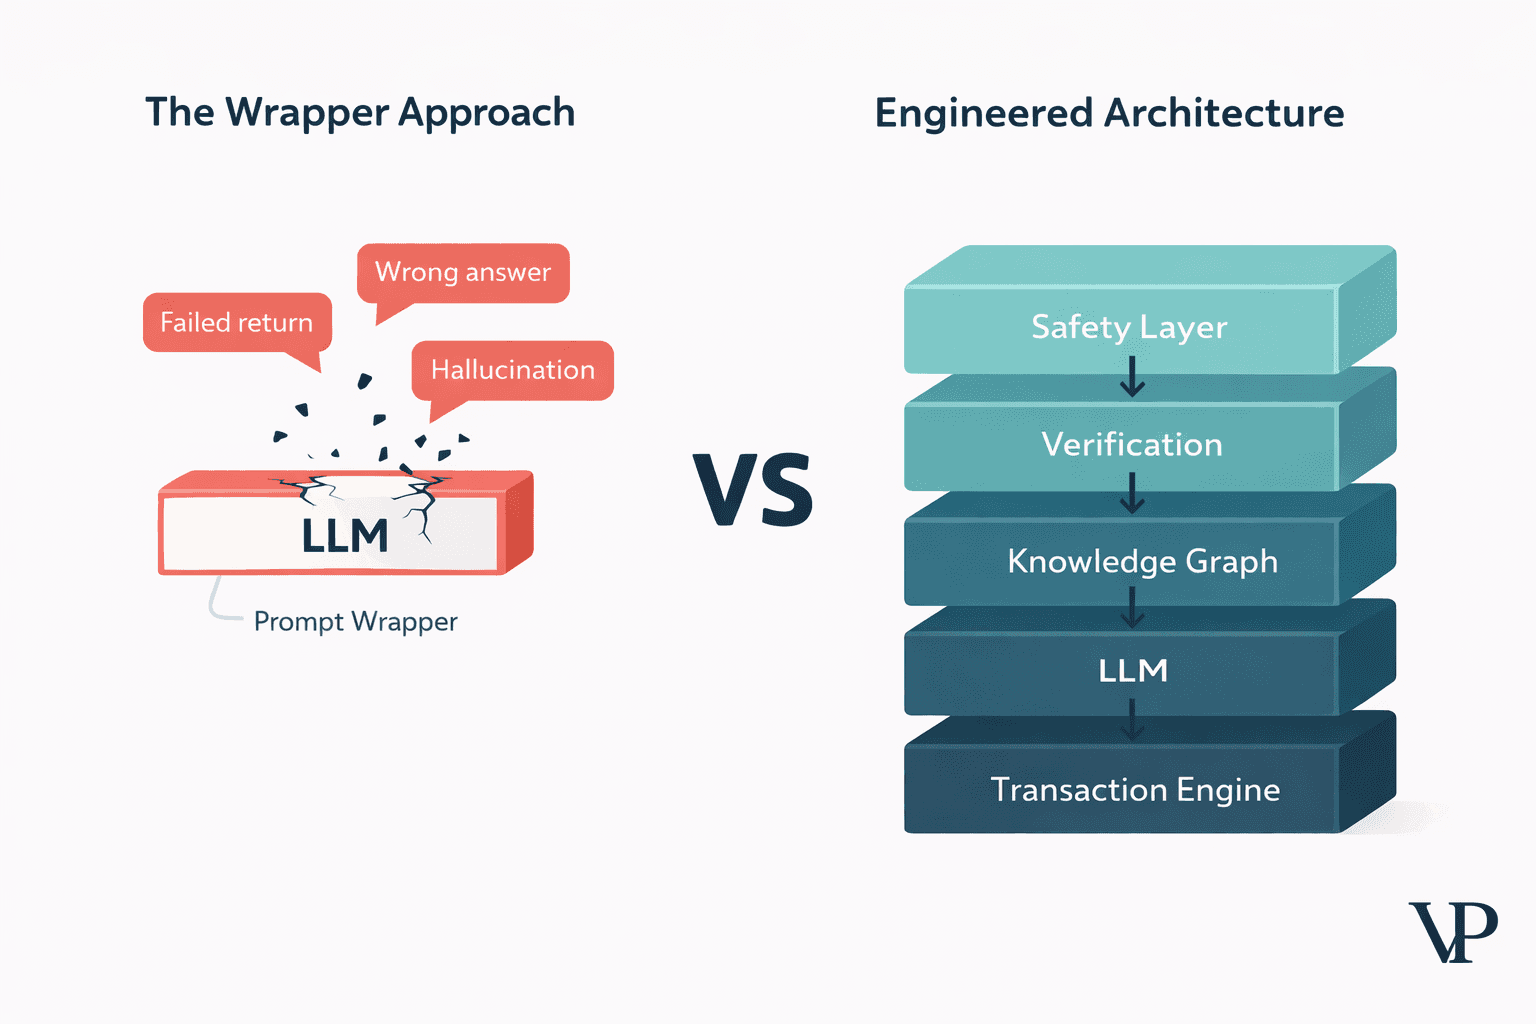
我们的Vouchmark演示通过合成产品、预设回答以及本地目录记录,使这一边界变得清晰可检。它封装给定的草稿,而不是直接运行导购助手或电商系统。其中最有价值的示例是一个需要微调的电视回答,以及紧随其后的一个做出修正并不合理的夹克回答。
保留商品目录所支持的内容
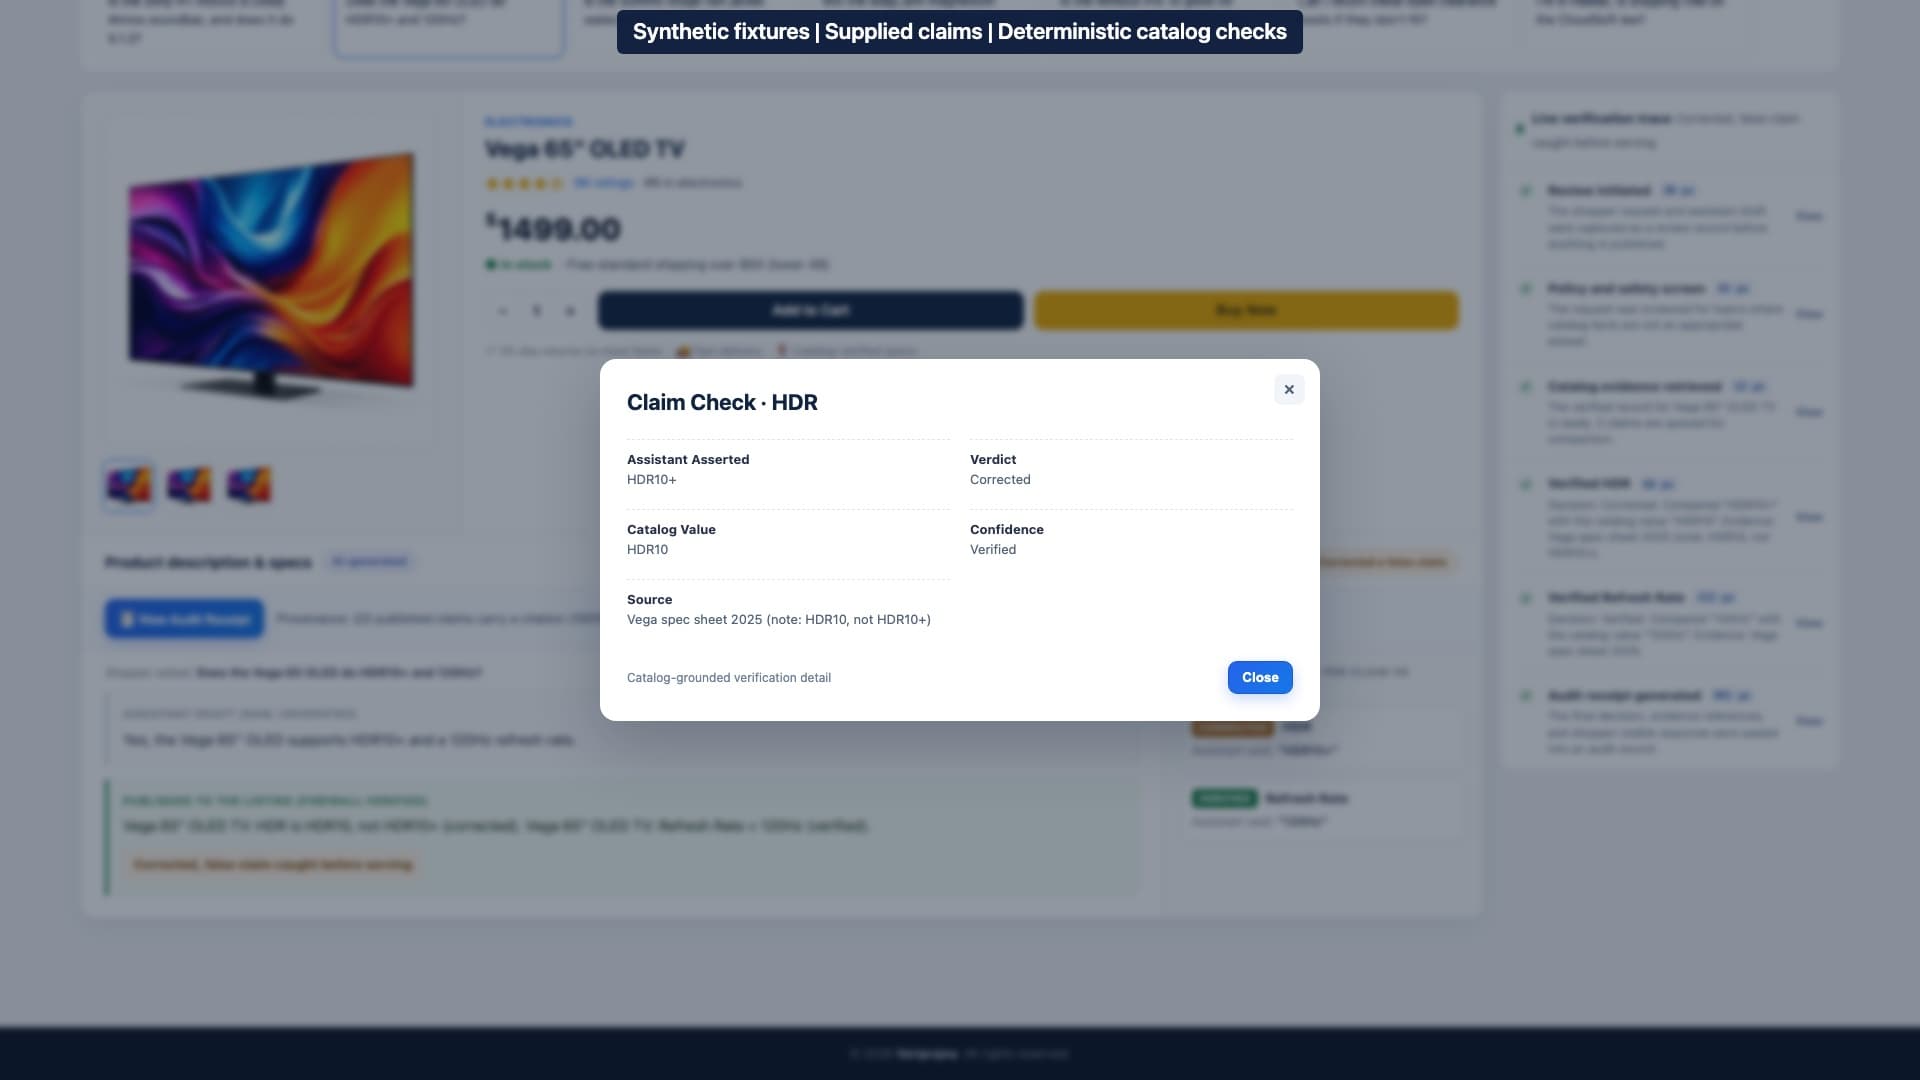
在合成电视案例中,草稿声称Vega OLED支持HDR10+和120Hz刷新率。这是两项截然不同的规格参数。HDR10与HDR10+是不同的标准,因此在本次比对中,多出的字符绝不能被当作无害的措辞变体来对待。
测试目录中包含HDR10和120Hz。Python校验门修正了第一项断言,并通过了第二项断言。因此,最终展示的回答保留了刷新率,同时明确标示了关于显示标准的修正。
相比用笼统的拒答来取代草稿,这显然是更有价值的处理结果。目录完全可以回答该问题,只是无法同时支持提议回答的两个部分。相较于在不保留失败主张记录的情况下盲目要求模型给出一个听起来更顺耳的重写,这种做法也更加负责。这一修正具有具体事实依据:所声称的标准与目录数值不符。
对于评估此类架构的团队而言,信息保留本身就值得单独设立测试。一个压制所有回答的系统固然可以避免输出大量无依据的细节,但几乎无法提供任何有效的产品信息。真正关键的问题在于:系统能否在剔除无依据断言的同时,不丢弃现有记录所支持的邻近主张?
Vouchmark的预设场景直接提供了分解后的各项主张。它们并不旨在证明模型能从原始文本中自行找出所有断言。电视示例确立的是在已提供分解的前提下,该目录决策机制的具体表现。
未知属性无法作为修正的依据
合成Summit Ridge夹克揭示了另一个不同层面的问题。其草稿承诺该夹克具备完全防水性能。然而,目录中的防水等级字段处于未知状态,测试数据中也没有存档任何制造商的评级。
校验门选择了弃权。它声明现有记录无法支持防水主张,但并没有将草稿篡改为夹克不防水的断言。
这种区分至关重要,因为目录对争议属性保持沉默。评级的缺失不能成为支持该主张任何一方的理由。如果系统将每个无依据的断言都直接反转为其对立面,那么它实际上是在以修正之名捏造全新的回答。
存在一种颇具诱惑力的替代方案:利用相近属性来维持回答的实用性。夹克记录中包含一条与涂层相关的推断防泼水描述。但是防泼水与经过确认的防水评级属于完全不同的主张。本预设场景绝不会将推断描述作为缺失评级的替代品输出。
我希望这种分离能够抵挡住给出圆滑回答的诱惑。在这些条件下,给出一句带有保留说明的陈述更为可取,因为它明确指出了尚未解决的属性,而没有悄然偷换消费者的原问题。代价是显而易见的:消费者依然没有得到他们所询问的评级。在生产级设计中,弥合这一鸿沟需要合适的权威来源或独立的审核流程,而演示原型两者均未提供。
因此,富有成效的目录审核应当区分两类修复工作。矛盾要求团队调和相互冲突的数值;未知则要求团队去查明缺失的事实。将这两者一概归入标有“错误回答”的队列中,会掩盖剩余的工作内容,也会掩盖助手在此期间可以安全陈述的信息。
目录匹配具有权威边界
主张层面的决定让回答更容易被审查,但这并不意味着目录本身是万无一失的。
电视对话框中可见的来源标签标明了一个编写好的测试基准引用。它有助于追踪所演示的决策流程,但绝不能作为Vouchmark已检索并认证制造商文档的凭据。此外,演示原型还允许被标记为推断的属性与被标记为已验证的属性走相同的比对路径。其输出文本可以将这种匹配称为“已验证”,而凭证记录中仍保留“推断”标签。
这揭示了一个电商团队必须明确制定的策略选择。如果推断属性对于特定回答是可接受的,那么展示的限定语应当保留该状态。如果业务要求该属性必须具备直接确认,那么仅匹配推断出的目录值就不应被视作确认并予以输出。Vouchmark演示了比对机制,但并未敲定生产环境的证据策略。
我主张在使用该主张的具体位置始终保持证据状态可见。否则,某个推断仅仅因为流经了另一个组件,就可能获取表面上的权威性。准确的比对与可靠的来源是密切相关但不可相互替代的两个要求。
同样的逻辑也限制了审计凭证所能确立的范围。Vouchmark的可读记录将草稿、展示回答、主张决策及引用文献整合在一起,便于审查回答为何发生改变。然而,其时间戳和哈希衍生标识符并不会由此构建出一个经过签名、不可篡改或独立保管的记录。需要这些特性的生产团队在导出解释之外还有很多后续工作要做。
分别检验校验门与覆盖范围
演示原型中带有固定标签的合成评测对全部60个已分解主张案例均给出了预期判定。该结果是对有限规则对照所给标签的检验,它既没有衡量导购助手的自由回答能被多么完整地分解,也没有确立在真实消费者流量下的实际表现。
一个普通的假设案例就能说明两者的区别。假设一份草稿称某笔记本电脑具备所列内存且非常适合全天剪辑视频。验证器可能会接收到内存主张并准确通过它,而关于适用性与续航的承诺可能会被遗漏在提取集合之外。即使对提交的主张做出了无懈可击的决定,回答中最具决定性的部分依然未受审查。
Vouchmark拥有一条精细的确定性完备规则,展示了揭示遗漏的一种途径。在其合成游戏笔记本电脑场景中,提供的初始主张仅包含内存。配置规则追加了一条独立显卡断言,目录随后对其予以否定。这种映射是演示对措辞的主观选择性解读,既非游戏适用性的通用定义,亦非对隐含承诺的穷尽检测。
这对评测的启示是具体的。团队既需要关于对所提供主张做出决策的证据,也需要关于究竟有哪些断言到达了该决策层的独立证据。针对独立准备的主张集合测试完整草稿有助于审查后者,同时也能揭示表面上热情的表述是否附加了比对规则无法体现的承诺。
这里存在着权衡。将输出文本限制在基于目录的模板内,可以缩小系统需要检查的范围,代价则是牺牲了表达的丰富性。允许更自由的行文能够改善解释说明,但需要覆盖的显式与隐式承诺集合也随之增加。单纯依靠干净的校验门基准测试本身无法在这两种架构间做出抉择。
这份Vouchmark说明文档展示了合成示例与决策记录。对于电商团队而言,更重要的审查产物是围绕提议回答所划定的边界:识别了哪些断言、每项断言依赖于何种证据,以及哪些问题仍未解决。
这里是创始人对Vouchmark中这些目录决策的深度讲解。
我评判一个验证层,取决于它能否在保留回答有用细节的同时,让未解决的部分清晰可见。对完整回答的批准,不仅需要有理由确信其实质性断言已到达校验门,还需要对这些断言背后的证据质量制定明确策略。在此之前,准确的判定仅仅是针对已提交主张的结果,其余回答依然需要合理的交代。