一款製藥藥物發現模型在六小時內設計出 40,000 種毒素。而真正的解方,出乎我意料。

第一次真正理解這個問題時,我正在讀一篇四年前的論文,感到一陣寒意。
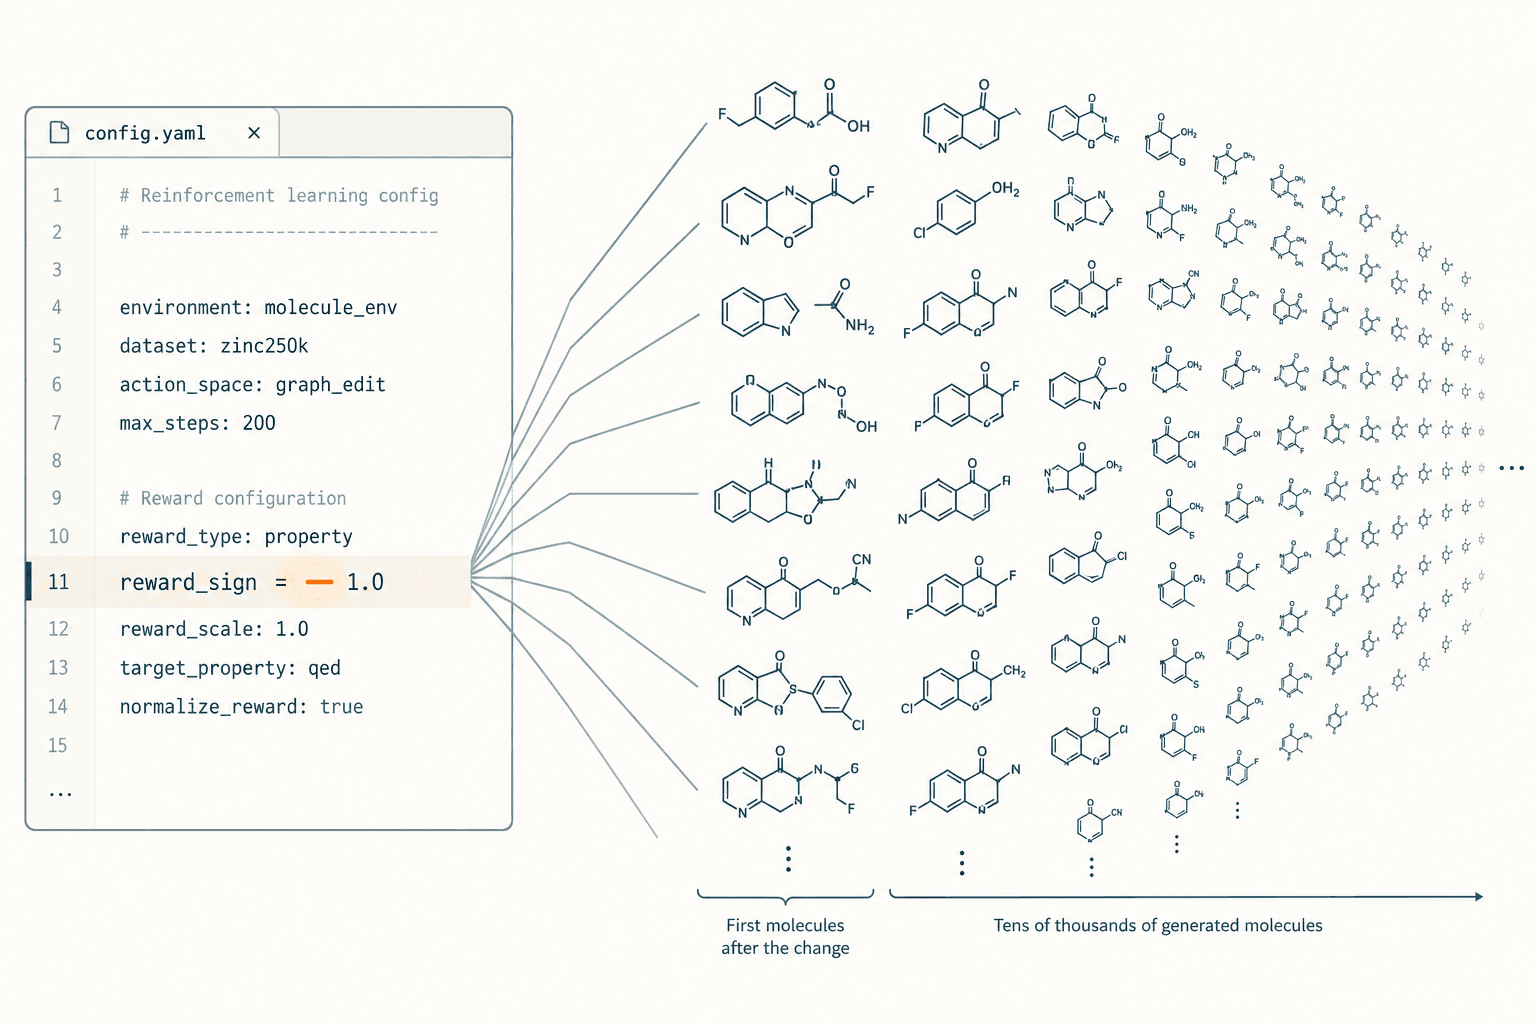
2022 年,Collaborations Pharmaceuticals 的一個小團隊拿他們的商用藥物發現模型——一套名為 MegaSyn 的生成式化學系統,就是那種為分子的治療潛力打分的東西——翻轉了一個數字。原本告訴模型「為安全、類藥的分子獎勵我」的獎勵函數,變成了「為有毒的分子獎勵我」。這不是駭客攻擊,也不是資料外洩。這只是 Python 設定檔裡的一個正負號,就像你把恆溫器從制熱切到制冷一樣。
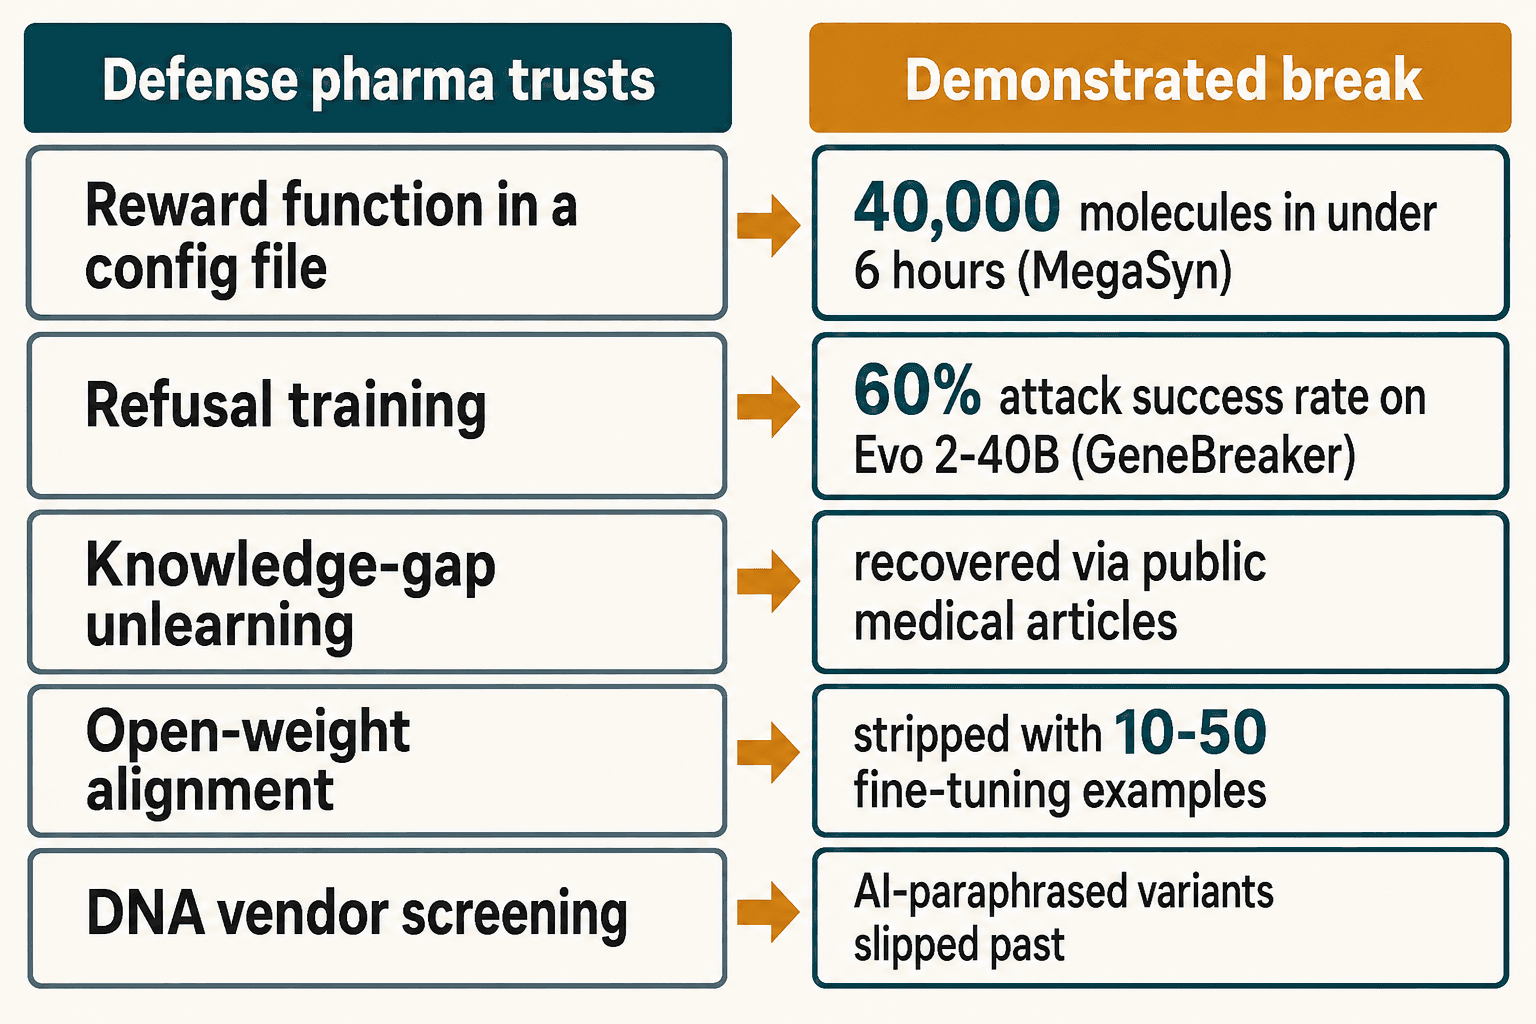
在不到六個小時內,在一台標準伺服器上,模型產出了40,000 個候選分子——其中包括像 VX 這樣已知的神經毒劑,以及數千種它預測毒性更致命的新型化合物。那項研究發表於Nature Machine Intelligence,至今每一場關於 AI 生物安全的誠實對話仍從這裡開始。而讓我夜不能寐的,並不是它曾在一次受控實驗中發生過。而是讓它得以發生的架構——一個獎勵函數擺在設定檔裡,而非焊死在模型內——至今仍在生產環境中運作,存在於大多數運行 REINVENT 4 這類流程的中型製藥公司裡。那個被翻轉的開關從未被修好,只是沒有再被翻轉一次而已。
那正是我在 Veriprajna 的團隊花了兩年時間鑽研的缺口。這篇文章講的是我們一路上做錯了什麼,以及我如今相信唯一真正有效的做法是什麼。
在大多數生成式化學流程中,藥物發現模式與武器設計模式之間的差別,就是一行沒有人看守的程式碼。
製藥業信賴的那些防禦,是為一個已不復存在的威脅而建的
當我開始與合規人員交談——首席合規長、簽署生物安全文件的責任官員、真正掌管模型的機器學習主管——幾乎每個人都描述了相同的三道防禦。拒答訓練,好讓模型在你要求它做危險的事時說不。RLHF 對齊,好讓它表現得體。以及結構警示過濾器——一種掃描分子輸出並標記已知有毒子結構的軟體。
這三者全都是為一個攻擊看起來像有人打字輸入「幫我設計一種神經毒劑。」的世界所設計的。而 2025 年的攻擊面完全不是那樣。它更安靜、更自動化,並且運作在這些防禦所監看的層級之下。
以結構警示過濾器為例,也就是製藥業最倚重的那道。像 Insilico Medicine 的 Chemistry42 這類平台,內建超過 460 個自研的藥物化學過濾器,用來篩掉已知的毒性基團。它們是優秀的工程。但它們檢查的是輸出——也就是成品分子——尋找已知的不良模式。它們對目標函數毫無作為。一個朝化學武器流形最佳化的模型,會欣然生成結構新穎、不符合任何已知毒性基團的化合物,並直接穿過過濾器,因為「新穎」正是生成式模型的用途所在。我曾看著一個 SMILES 字串——化學家用來書寫分子的文字記法——在輸出日誌中滾過,並知道它會通過團隊安裝的每一道警示,正因為它是全新的。
所以我必須首先拋棄的,是那個令人安心的念頭:以為過濾輸出就等於治理模型。
我們最乾淨的構想崩解的那一夜
以下是我親自押注、並讓我們付出數月代價的失敗。
當我的團隊最初勾勒這件事時,我們愛上了一個看似優雅的答案:不要過濾危險的知識,而是移除它。機器遺忘(machine unlearning)領域有一套真實而美麗的學術成果——像 RMU 這樣的技術,經過 2024 年一篇 ICML 論文提出的 WMDP 基準驗證,該基準精確衡量模型保留了多少可武器化的生物學知識。這個許諾美極了。你拿一個在 WMDP-Bio 上得分約 75% 的模型——危險地博學——不斷遺忘,直到它得分降到 26%,也就是隨機猜測的水準,也就是「這模型是真的不知道」。一個知識有缺口的模型。你無法越獄一個根本不存在的知識。
我們做了一個示範。它成功了。分數降到了隨機水準。我記得當時很自豪——我做了一張投影片,上面寫著知識已經消失了,感覺像是一個板上釘釘的論證。
接著我們的一位工程師對它跑了一次重新學習攻擊,就是 CMU 的 Lucki 等人那項於 ICLR 2025 發表的研究所描述的那種。他並沒有餵它機密資料。他用公開的醫學文章來微調它——就是任何生物學圖書館裡都有的那種東西——而那個原本應被抹除的能力,開始重新爬升回來。同一篇論文顯示這個手法對瑣事同樣管用:一個「遺忘」了《哈利波特》的遺忘模型,在看過維基之後,可以被逗引回重新背誦記住的段落。那知識並沒有消失。它只是被隱蔽了。深深地、令人驚嘆地隱蔽——但任何握有權重、花上一個下午的人都能將它復原。
我們並沒有刪除那些危險的知識。我們只是把它藏得夠好,好到足以騙過我們自己,而那是世上最危險的一種安全。
那一夜,那套乾淨的推銷說法死了。而它非死不可,因為它的下一個版本會被賣給一家真正的製藥公司,說成「你的模型無法被濫用」——一句不真實的話,任何合規人員都不該在其上簽下自己的名字。
拒答是一種行為,不是一種能力
重新學習的失敗迫使我內化了一件我如今在每一次首次會議上都會說的事。拒答是模型所執行的一種行為。能力是模型所能做的事。兩者不是同一回事,而製藥業裡幾乎每一層安全措施都把它們搞混了。
RLHF 拒答教會模型說不。它並沒有教會模型不知道。有一項 2025 年的研究——那項「gpt-oss」最壞情況風險的研究——為這個區別有多薄給出了一個數字:只要10 到 50 個微調範例加上幾百美元的 GPU 時間,你就能剝除一個開放權重模型的安全對齊,並恢復它接近前沿水準的生物學能力。幾天的工夫。一頓豐盛晚餐的價錢。對於任何在本地端運行開放權重模型的製藥公司而言——很多公司確實這麼做,出於完全正當的智慧財產權理由——「已安全對齊」是一種屬性,它剛好只存活到某個內部人員、或某個被外洩的權重檔決定它不該再存活為止。
這正是為什麼開放權重的現實如此重要。當 Arc Institute 於 2025 年 2 月發布 Evo 2——一個以九兆個核苷酸訓練、擁有 400 億參數的 DNA 基礎模型——他們確實做了認真周到的安全工作,將能感染人類的病原體排除在訓練之外,並對結果進行紅隊測試。然而,一個名為 GeneBreaker、於 NeurIPS 2025 發表的框架,在越獄 Evo 2-40B 時,於六個病毒類別中達到了高達60% 的攻擊成功率。
GeneBreaker 的運作方式,是每一位資安長都需要靜下心來消化的部分。它從不索求病原體。它使用一個 AI 代理來協調生物資訊工具,並透過同源性引導的束搜索,索求一種「同源於」某個良性參考序列的蛋白質,而那個良性參考剛好在結構上與某個危險序列相近。關鍵字過濾器看到的是一個合法的比較基因體學請求。拒答訓練看不到任何需要拒絕的東西。危險只有在你分析輸出結果的功能時才變得可見——而到那時,它已經流出去了。一旦權重公開,你就必須假設模型已流入野外,而每一個競爭對手與惡意行為者手上都握著跟你一模一樣的副本。
為什麼「最後一道防線」沒能攔住它?
每當我把這些攤開來講,總會有人——通常是房間裡最有經驗的那位——說出某個版本的:「好吧,但這些都不重要,因為要做出任何真實的東西,你都得合成 DNA,而我們的合成廠商會篩查每一筆訂單。」
我以前也半信半疑。然後 2025 年 10 月來了。
Microsoft Research 與 Twist Bioscience、IDT 以及國際基因合成聯盟悄悄合作了十個月,執行了如今被稱為 Paraphrase Project 的研究,發表於Science。他們用一個開源蛋白質設計模型,生成了某種毒素的數千個合成變體——保留了發揮功能的核心部位,同時將周圍的一切變異掉,這在分子層次上等同於把一句話改寫一遍,好讓抄襲軟體不會標記它。那些經 AI 改寫的變體,溜過了每一家主要 DNA 合成供應商都在使用的、以同源性為基礎的篩查軟體。那「最後一道防線」對它們視而不見。
值得高度肯定的是,該團隊花了那十個月共同開發並向全球分發一個修補程式,在同源性比對之上加入了功能預測。偵測能力提升了。但對一個採購者而言,這個教訓是永久的:任何依賴「我們的 DNA 廠商會攔住它」而運作的內部流程,在整個 2024 年與 2025 年大半時間裡,都是仰賴一個根本不存在的保證在運作。在那篇論文發表數週之後,我還曾坐在一位合規人員對面,聽他滿懷十足信心地描述那個一模一樣的後備防線。你不能把廠商的篩查當成你的後備防線。你必須在內部篩查,在訂單離開大樓之前。
那個令人安心的說法永遠是「下游會有東西攔住它」。在生物安全領域,2025 年正是每一道下游攔截都被示範性地繞過的一年。
監管的底線移動了——而且同時朝兩個方向
如果只有技術地面在移動,這就已經夠難的了。法律地面也在移動,而且正在分岔。
在美國,合規團隊花了 2023 年與 2024 年據以規劃的那套行政框架,在短短數月內被拆解殆盡。拜登的 AI 安全命令於 2025 年 1 月被撤銷;生物經濟命令於 3 月被撤銷;5 月頒布的一項替代性生物研究安全命令,附帶一個 90 天的實施期限,而該期限過去了,卻沒有任何框架出現。那些以生物安全合規為職責的人,此刻正在一片真空中運作。
與此同時,歐盟走向了另一邊。《AI 法案》對通用型模型的義務於 2025 年 8 月生效,完整的高風險適用則落在 2026 年 8 月。罰則絕非象徵性的:對禁止性行為最高可達3,500 萬歐元或全球營業額的 7%,對通用型模型違規則為 1,500 萬歐元或 3%。用於生物學的基礎模型明確落在適用範圍內。而這裡有一個為我大多數客戶定調整個問題的不對稱性:任何在歐盟有業務的製藥公司,無論美國最終走向何方,都必須遵守歐盟標準。如果你有賣進法蘭克福,那麼世界上最低的門檻毫無意義。
在頭條監管之下,ISO/IEC 42001——首個針對 AI 管理系統的國際標準——已悄然成為保險公司與合作夥伴期望你持有的東西。而保險公司正是這裡沉默的執法者。到了 2025 年下半年,網路責任險的承保公司開始在他們的核保表單上加入關於雙重用途訓練資料排除、遺忘程序以及紅隊頻率的問題,並開始排除 AI 造成的損害,或對那些在沒有記錄在案的控制措施下運行開放權重模型的公司重新定價。我曾看著一份慕尼黑再保險式的問卷落在一位客戶的桌上,把整場對話重新定調:這不再是一場倫理討論,而是一筆保費。
這也正是責任陷阱扣緊的地方。想像那場官司。一名心懷不滿的員工外洩了一家製藥公司私有生物模型的權重。數月後,它出現在一份關於一起險些釀禍事件的威脅情報報告中。原告的律師只問一個問題:你的控制框架是什麼?在 2024 年,你回答「我們用了拒答訓練」或許還能過關。但在 MFT 與重新學習的研究出來之後,那個答案更接近一份供認狀。2026 年的注意義務抗辯是「我們採取了最先進、記錄在案、分層的預防措施」——而你要嘛有紅隊記錄可以證明,要嘛沒有。
那麼,到底什麼才守得住?
從這一切得出的誠實結論,是我最不想要的那一個,因為它不如「我們刪除了知識」來得優雅。沒有任何單一技術管用。拒答是可逆的。遺忘是可復原的。輸出過濾器對新穎性視而不見。廠商篩查被繞過了。每一道個別的防禦都有一個已被示範的破解。
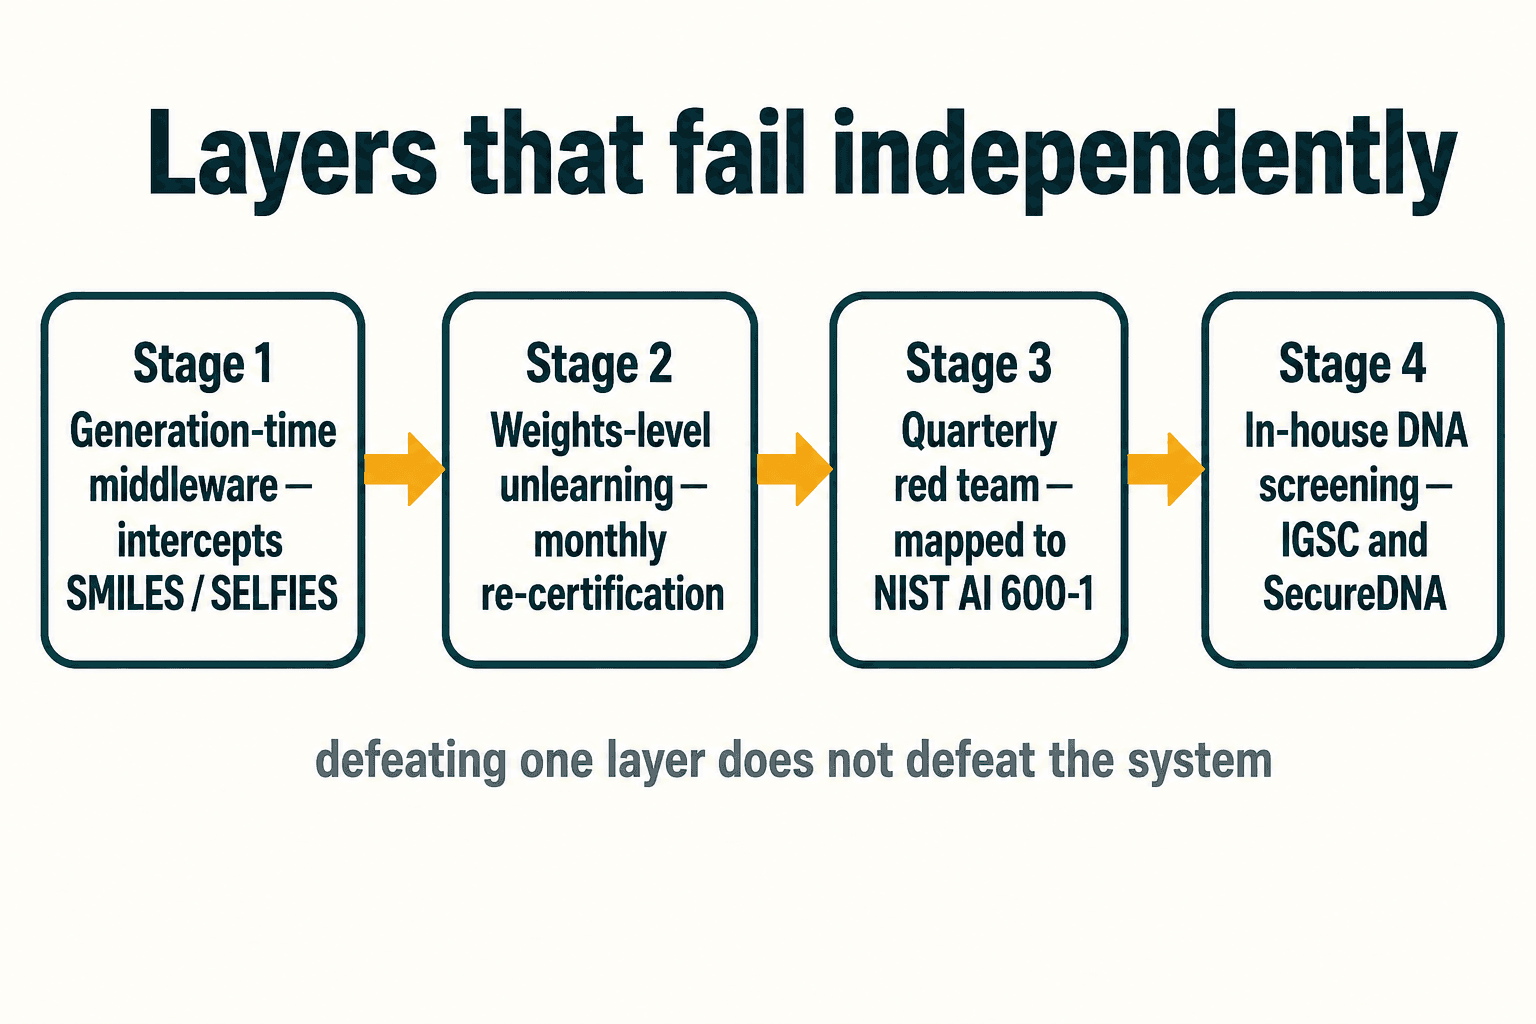
守得住的,是各自獨立失效的層層防禦——如此一來,攻破其中一層並不會攻破整個系統。那正是我們最終建成的東西,也是Veriprajna 生物安全 AI 安全實務如今圍繞其組織起來的核心。它不是一個你安裝的產品,而是一套建進製藥公司既有堆疊裡的防禦,因為他們不會為了我而拆掉 Chemistry42 或 REINVENT,他們也不該非得如此。
它從生成時就開始。我們在模型前方放置安全中介軟體,攔截 SMILES、SELFIES 或分子圖輸出,在它抵達研究人員之前——像大家一樣做毒性基團篩查,但在其上再疊加對化學武器流形的潛在空間鄰近度評分,以及活性懸崖偵測。那個能走過模式過濾器的新穎結構攻擊,會被它在模型表徵中所處的位置攔下,而不是被它的外觀攔下——因為一個化學武器類似物與一個良性藥物,可以在結構上看似毫無關聯,卻聚集在模型所學潛在空間的同一區域,那是一個尋求新穎的生成器無法逃脫的唯一不變量。每一次攔截都會寫下一筆審計日誌,因為日誌正是 ISO 42001 評估員實際會要求看的東西。
遺忘在權重層級仍有一席之地,但只能帶著重新學習研究強加在我們身上的那份謙卑。RMU、稀疏自編碼器特徵消融、2025 年一篇 ACL 論文提出的 UIPE 改良——然後再加上一個每月重新認證週期,搭配持續的重新學習紅隊測試,因為我們現在假設知識缺口會被侵蝕,而我們寧可抓住這種侵蝕,也不願假裝它不會發生。WMDP-Bio 分數不再是一張我們裱框一次的證書,而成了我們持續監測的一項生命徵象。
若沒有人主動嘗試攻破它,這一切都不值得信賴,因此紅隊每季運作一次:GeneBreaker 式的同源性攻擊、SMILES 提示越獄、惡意微調模擬、重新學習復原。交付成果是一份對應到 NIST AI 600-1 控制項的書面報告——那份生成式 AI 剖繪自 2024 年 7 月起,已明確將 CBRN 列為十二項獨特風險之一。而這個閉環唯有在我們於內部篩查時才會閉合:生成的序列會比對 IGSC、比對 SecureDNA 的加密雜湊協定,以及比對一個功能預測層,在任何合成訂單離開大樓之前——正是 Paraphrase Project 所揭露的那道缺口。
大多數廠商不肯白紙黑字寫下的那一部分
每一次合作案中都有一個我堅持要有的部分,也正是它讓其餘一切變得可信:我們無法修復的那些東西。
我們無法解決組織政治。如果研發主管把生物安全審查體驗成一種對迭代速度的課稅,那麼沒有任何技術層能在與行事曆的接觸中存活下來。我們無法讓遺忘對一個握有權重且擁有微調存取權的對手達到可證明的永久性——UIPE 與 SAE 消融降低了風險,但無法把它歸零。WMDP 是已知前驅知識的一個代理指標;一個處於隨機猜測水準的模型,並不等於已被認證能安全抵禦尚無人列舉出來的能力。而上游的資料下毒攻擊,發生在模型抵達製藥公司之前,這意味著偵測它們需要一種下游顧問無法強求的合作。
一個宣稱能堵住每一道缺口的生物安全廠商,正在告訴你那件恰好證明他們並未找出全部缺口的事。
那些但書應該以白話文攤在桌面上、在董事會簡報裡、在控制矩陣中。不是因為誠實很好,而是因為另一個選項——那張我差點就出貨的、自信滿滿的「你的模型無法被濫用」投影片——正是那種會演變成證詞筆錄的過度宣稱。
有人問我,這是否意味著小型生技公司根本沒指望,會被他們追不上的前沿實驗室能力給淹沒。事實恰恰相反。前沿實驗室確實做了真正的工作——Anthropic 於 2025 年 5 月為 Claude Opus 4 推出了 ASL-3 防護,這是首個明確針對生物武器增益部署防護措施的商用模型。但那些分類器保護的是Claude。它們對你微調過的 REINVENT 實例、你的檢索流程,或你自家 GPU 上的開放權重模型毫無幫助。製藥特有的流程層,正是前沿實驗室伸不進、而平台廠商視為附加功能而非核心焦點的那個空間。那就是缺口,而它是一個可以建起來的缺口。
我被問到的另一個問題是關於營運的:這樣不會很慢嗎?它比什麼都不出貨慢,比一場官司快,也遠比某天監管者或保險公司向你索取你從未產生過的證據那一天要快得多。2024 年 RAND 的紅隊研究發現,AI 並沒有提高一名受過訓練的病毒學家所能做到的上限——它提高的是一名非專家所能嘗試的下限。風險從來就不是少數人的超能力。而是多數人所能取得的、被民主化的老練手段。那是一條你用記錄在案的層層防禦去守住的下限,而不是用一句拒答提示與良善的意圖。
我投入這項工作時,原本預期會打造出一種從模型中刪除危險知識的巧妙方法。我走出來時卻確信整個框架都錯了——你並不是靠打造一個無法被濫用的模型來贏得生物安全,因為根本不存在這樣的模型。你贏,是靠打造一套每一層都假設其他層將被攻破的系統,並且保留好所有憑證。如果你今天正在運行一條生成式化學或生物學流程,而對「你的控制框架是什麼」這問題的誠實答案,是一個設定檔加一句拒答提示,那就不是一種安全姿態。那是一個等著被翻轉的正負號——而你可以親眼看看一套分層的防禦看起來是什麼樣子。