您的 AI 應用程式距離一場訴訟僅差一次不良輸出。加拿大航空(Air Canada)的聊天機器人承諾了違背公司政策的喪親票價退款,加拿大法院裁定該航空公司承擔責任。一家雪佛蘭(Chevrolet)經銷商的聊天機器人在遭遇提示詞注入攻擊後,同意以一美元出售一輛 Tahoe。DPD 的快遞機器人遭越獄後輸出髒話,在 24 小時內吸引了 800,000 次觀看。
這些並非假設情境,而是來自在未具備足夠安全層級的情況下上線 AI 之企業的生產環境資安事件。「在示範中運作正常」與「在生產環境中安全可靠」之間的差距,正是多數 AI 部署停滯不前的原因——而這正是我們的安全基礎設施旨在彌合的鴻溝。
生產環境防護護欄的真實樣貌
生產環境防護護欄堆疊並非單一工具,而是一個分層架構,每一層都能捕獲其他層遺漏的威脅,且任何單一層級的故障都不會危及整個系統。我們的方法是從五個獨立層級來設計並建置這些堆疊。
輸入篩選
提示詞注入檢測使用的是經過微調的分類器,而非正規表示式(regex)。頂尖的開源檢測器能達到約 0.91 的 F1 分數,但生產級檢測需要針對新型攻擊模式進行持續重新訓練。我們部署混合式檢測:快速分類器負責處理不可信輸入的高輸送量掃描,不確定案例則轉發至基於推理的 LLM 進行兜底防護。金絲雀權杖(canary token)監控則可捕獲規避這兩層的注入嘗試(詳見 我們關於對抗性 AI 防禦的研究)。
內容分類
安全分類器依據可配置的分類標準評估輸入與輸出。Llama Guard 3、ShieldGemma 與 Qwen3Guard 各自涵蓋不同的風險類別並具備不同的準確度表現。來自 2025-2026 年基準測試的關鍵發現: Llama Guard 在良性輸入上達到 97-99% 的準確率,但僅能檢測出 4.5-21.8% 的對抗性內容。
整體表現最佳者為 Qwen3Guard-8B(達到 85.3%),但在未衍生自公開資料集的新型提示詞上,準確率驟降至 33.8%。現成的分類器僅是基準線,而非完整防禦。我們依據您的具體威脅模型進行選擇、組合並予以強化。
政策強制執行
執行時期規則約束 AI 可以表達、承諾或執行的內容。這正是加拿大航空與雪佛蘭失敗案例的癥結所在:模型可以生成任何輸出(包括合約承諾與定價決策),而在內容生成與使用者之間沒有任何屏障。
我們的方法實作了確定性政策引擎,旨在於任何輸出到達下游取用者之前,對照您的業務規則進行評估(參見 我們關於在確定性架構中封裝機率模型的技術白皮書)。定價承諾、法律用語、授權範圍及資料揭露邊界皆被定義為機器可評估的規則,而非提示詞指令。
輸出驗證
此層涵蓋個人識別資訊(PII)遮蔽、毒性過濾、事實一致性檢查以及特定領域限制驗證。PII 檢測印證了分層架構的重要性:基於正規表示式的檢測僅達到約 65% 的召回率,洩漏高達 35% 的敏感資料。基於命名實體識別(NER)的檢測在標準實體上可達 94-96% 的 F1 分數,但面對新型格式與對抗性混淆時則告失效。
我們兩者並行——正規表示式處理結構化模式(信用卡、社會安全號碼、電話號碼),機器學習模型捕獲依賴上下文的實體(姓名、地址、自由格式識別碼)——並校準至您的偽陽性容忍度。
代理式安全
對於使用工具、執行程式碼或呼叫 API 的 AI 系統而言,輸出過濾是遠遠不夠的。防護護欄必須在執行前介入,而非在事後。我們的方法是建置規劃階段的驗證,旨在任何動作觸發之前檢查工具呼叫、參數值與執行計畫(參見 企業級 AI 責任防護護欄的可運作示範)。依風險分級的核准機制會自動放行低風險動作、標記中風險動作以供日誌記錄,並對高風險作業(例如資料庫寫入、金融交易或外部通訊)要求人工授權。
無人談論的偽陽性問題
堆疊安全分類器在表面上看似良好的工程實踐,直到您親自計算機率。若每個防護機制的準確率為 90% 且您執行了五個,那麼在給定請求中五者皆正確的機率將驟降至 59%。這意味著 41% 的合法請求會被錯誤標記。您的使用者將不再信任系統、您的支援團隊將不堪負荷於呈報事件,而您的安全投資反而淪為使用者體驗(UX)的負擔。
我們的方法透過分層架構解決此問題,而非強行堆疊。快速的規則型檢查(微秒級延遲)處理顯而易見的違規;機器學習分類器(50-200ms)處理微妙細緻的內容;LLM 評審機制(LLM-as-judge,數秒級)則僅處理更平價層級無法解決的模糊邊緣案例。
每個層級都具備經校準的信賴度閾值,只有在前一層級的信賴度低於其閾值時,請求才會呈報至成本更高的層級。此設計在 90%+ 的請求中將整體防護護欄開銷控制在 200ms 以內,同時對真實威脅維持高檢測率。
為何現成防護護欄必不可少但仍顯不足
防護護欄市場分散於開源框架、託管平台與雲端提供商功能之間。每項解決方案都僅解開了拼圖的一角,無一能提供端到端的完整方案。
| 工具 | 所提供的功能 |
|---|---|
| Guardrails AI | 具備 50+ 項預建檢查的可組合驗證器。 |
| NeMo Guardrails | 基於 Colang 的對話政策管理。 |
| AWS Bedrock Guardrails | 支援跨模型提供商運作,具備 PII 遮蔽與自動化推理(Automated Reasoning)檢查功能。 |
| Lakera Guard | 支援 100+ 種語言的 50ms 以下提示詞注入檢測。 |
2026 年的生產團隊通常在同一系統中同時執行 NeMo Guardrails 用於對話管理,並執行 Guardrails AI 用於輸出驗證。該整合屬於客製化工程。雲端提供商雖提供強大的基準覆蓋,但針對特定領域政策的自訂彈性有限。
多模態防護護欄(影像、音訊與視訊輸入)幾乎缺乏現成工具支援,儘管在尖端模型上,攻擊透過簡單的影像變換就能達到 75-82% 的成功率。平台所提供的功能與生產環境安全所需之間的差距,正是我們諮詢專案所承擔的任務。
法規監管壓力切實存在,而技術標準尚未就緒
《歐盟 AI 法案》的高風險條款全面生效時間為 2026 年 8 月 2 日。CEN/CENELEC JTC 21 正在制定定義高風險 AI 系統「適當風險緩解」的協調技術標準,但他們錯過了原定的 2025 年 8 月截止期限,目前目標指向 2026 年第四季。決定合規與否的標準目前甚至尚未成形。
NIST AI RMF 1.0 與生成式 AI 設定檔(AI-600-1)將包含內容過濾器在內的防護護欄列為預期控制項。OWASP 2025 年 LLM 應用程式十大風險新增了系統提示詞洩漏(System Prompt Leakage)與向量/嵌入弱點(Vector/Embedding Weaknesses)作為全新類別,反映出多數企業資安團隊尚未建立監控機制的威脅。
等待最終標準出台後才建置安全架構的組織,將在毫無緩衝時間的情況下面臨截止期限的慌亂應對。我們所設計的防護護欄架構既能經受現行法規架構的檢驗,又能適應仍在草案階段的標準(參見 我們關於企業級 AI Agent 責任防火牆的研究)。
我們的交付成果
每個諮詢專案皆始於針對您的應用程式、您的資料以及您的法規曝險量身定制的威脅模型。我們不銷售單一平台。我們的方法是建置一套防護護欄架構,旨在將頂尖工具(開源與託管平台)整合為連貫一致的堆疊,精準契合您的延遲預算、偽陽性容忍度與合規需求。
諮詢專案的範圍旨在產出:
- 具備經量測之各層延遲預算的分層防護護欄架構。
- 具備混合檢測(分類器 + LLM 支援兜底 + 金絲雀監控)的提示詞注入防禦。
- 校準至您的實體類型與偽陽性容忍度的 PII 遮蔽管線。
- 源自您的業務限制條件而非通用範本的政策強制執行規則。
- 針對工具使用、程式碼執行與 API 呼叫的代理式安全控制項。
- 嘗試使用當前攻擊技術(PAIR、GCG、間接注入、多模態注入)繞過各層的對抗性測試套件。
- 具備漂移檢測、分類器衰退警報以及由資安事件觸發的重新訓練管線的防護護欄可觀測性。
- 對應至《歐盟 AI 法案》、NIST AI RMF 及 OWASP LLM Top 10 控制項的法規映射。
我們同時提供客觀誠實的評估:您現有的平台防護護欄已涵蓋哪些風險、哪些缺口需要客製化工作,以及哪些威脅更適合透過上游架構變更(資料治理、模型選擇、存取控制)來因應,而非單純在頂層疊加更多安全層。
安全防護護欄與驗證層
 觀看
AI 定價合規與演算法公平性 | Veriprajna
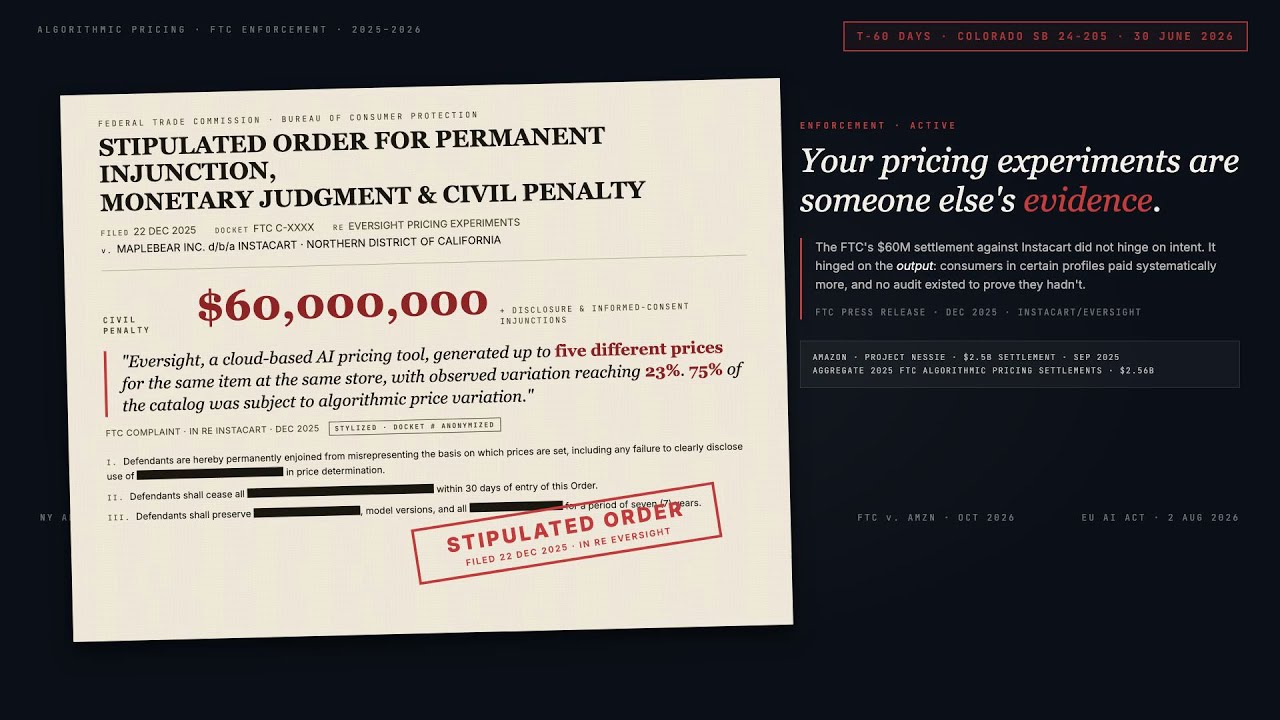
2025 年,FTC 從兩家公司收取了 25.6 億美元的演算法定價和解金。紐約州、加州與科羅拉多州頒布了使每一筆 AI 驅動價格都可能構成違法的法律。
 觀看
AI 驗證與反 AI 洗白合規 | Veriprajna
在監管機關上門前,先佐證你的 AI 主張。Veriprajna 為因應 SEC、FTC 與各州檢察長合規的企業打造 AI 驗證架構、AIBOM 系統與主張佐證資料包。
 觀看
企業 AI 責任與護欄(Enterprise AI Liability & Guardrails)|Veriprajna
2023 年 12 月,一個聊天機器人同意以 1 美元出售一輛價值 76,000 美元的雪佛蘭 Tahoe。2024 年 1 月,一個快遞聊天機器人寫了一首詩,稱自己的公司毫無用處。2024 年 2 月,一個喪親聊天機器人虛構了一個根本不存在的退款期限,法庭裁定該航空公司須承擔責任。


常見問題解答
實作 AI 防護護欄需要多少成本?預算的主要驅動因素為何?
成本取決於三個變數:您需要多少層級、您具備多少延遲預算,以及您的政策與特定領域的關聯深度。使用開源分類器(Llama Guard、Guardrails AI 驗證器)搭配雲端提供商防護護欄(Bedrock、Azure)的基礎堆疊實作成較低,但需要持續調優。客製化提示詞注入分類器、特定領域政策引擎以及代理式安全控制項則需要更多工程投入。具備 AI 專屬安全控制項的組織平均可減少 $2.1M 的外洩成本,且省略防護護欄的代價向來遠高於建置成本。我們依據您的實際威脅模型進行評估,而非收取平台固定費用。
堆疊多個安全分類器時,該如何降低偽陽性?
複合準確率問題確實存在:五個準確率各為 90% 的分類器意味著僅有 59% 的合法請求能完全通過全部五者。解決方案在於分層架構,而非增加分類器。我們設計分層堆疊:快速的規則型檢查(微秒級延遲)處理顯著違規,機器學習分類器(50-200ms)處理細緻內容,LLM 評審機制(數秒級)僅處理更低成本層級無法解決的模糊案例。每個層級皆具備經校準的信賴度閾值,使請求僅在必要時呈報。此架構在維持檢測品質的同時,為 90%+ 的流量將總開銷控制在 200ms 以內。
NeMo Guardrails、Guardrails AI 與 Llama Guard:生產環境中應使用哪一個?
它們解決不同的問題,且通常協同使用。NeMo Guardrails 跨五個管線階段使用 Colang 政策管理對話流程(100-300ms 延遲,在 NVIDIA 基礎設施上更低)。Guardrails AI 提供具備 50+ 項預建檢查的可組合輸出驗證器(每次驗證 50-200ms)。Llama Guard 是用於內容審核的安全分類器(1B 變體在整體準確率上實際上優於 8B,達 59.9% 對 48.4%)。2026 年的生產團隊通常在同一系統中同時執行 NeMo 用於對話管理,並執行 Guardrails AI 用於輸出驗證,並由 Llama Guard 或 ShieldGemma 處理內容分類。我們依據您的延遲預算與威脅受攻擊面設計整合架構。
對於使用工具並呼叫 API 的 AI Agent,我們需要哪些防護護欄?
對於代理式系統,輸出過濾是不夠的。當 AI Agent 能夠執行程式碼、呼叫 API、寫入資料庫或發送通訊時,防護護欄必須在執行前、在規劃階段進行介入。我們建置工具使用驗證,在任何動作觸發之前檢查每個函式呼叫、參數值與執行計畫。這包括參數型別檢查(Agent 常捏造參數名稱並傳遞錯誤資料型別)、範圍強制執行(Agent 僅應存取明確允許的工具),以及風險分級核准路由:低風險動作自動進行,中風險動作予以記錄與標記,而高風險作業(金融交易、資料庫變更、外部通訊)則需要人工授權。
我們在生產環境中如何阻止提示詞注入攻擊?
沒有任何單一技術能阻止所有提示詞注入。最佳的生產級防禦是分層架構:快速微調分類器(特定領域檢測器的 F1 約 0.91)以高輸送量篩選所有不可信輸入。不確定案例轉發至基於推理的 LLM 進行深入分析。嵌入提示詞中的金絲雀權杖(canary token)可檢測擷取嘗試。基於困惑度(perplexity)的異常評分可捕獲對抗性權杖序列。針對間接注入(隱藏在檢索文件、影像、PDF 中的指令),內容在到達模型上下文之前會單獨進行掃描。防禦機制會持續演進,因為提示詞注入穩居 OWASP 首要 LLM 風險其來有自:在缺乏充分防禦的情況下,針對專有模型的自動化攻擊成功率可達 80-94%。
為了符合《歐盟 AI 法案》,需要哪些 AI 安全防護護欄?
《歐盟 AI 法案》的高風險條款將於 2026 年 8 月 2 日全面生效,但定義「適當風險緩解」的協調技術標準(由 CEN/CENELEC JTC 21 制定中)錯過了原定期限,目前目標指向 2026 年第四季。該法案要求具備記錄有高風險 AI 緩解措施的風險管理系統。NIST AI RMF 及其生成式 AI 設定檔(AI-600-1)指定包含內容過濾器在內的防護護欄為預期控制項。OWASP 2025 年 LLM 十大風險新增了系統提示詞洩漏與向量嵌入弱點為新威脅類別。我們設計的防護護欄架構在現行框架下具備防護力,且能適應仍在定稿中的標準。違規罰款最高可達 3500 萬歐元(EUR 35 million)或全球年營業額的 7%。
我們如何監控防護護欄在生產環境中是否真正發揮作用?
安全分類器會無聲無息地衰退。在 2025-2026 年基準測試中表現最佳者(整體達到 85.3% 的 Qwen3Guard-8B),在其訓練分佈之外的新型提示詞上準確率驟降至 33.8%。若缺乏監控,您將無法得知此情況何時發生。我們建置防護護欄可觀測性機制,持續追蹤檢測率、偽陽性率、各層延遲以及隨時間變化的分類器信賴度分佈。當輸入分佈偏離分類器的訓練資料時,漂移檢測會發出警報。當識別出新型攻擊模式時,由事件觸發的重新訓練管線會更新分類器。這不是一個儀表板,而是隨著威脅演進保持防護護欄有效的維運基礎設施。
模型層級的安全(RLHF、憲政 AI)是否足夠,還是我們也需要執行時期防護護欄?
模型層級的安全是必要的,但單憑其自身顯然不足。RLHF 與憲政 AI(constitutional AI)創造的是行為偏好,而非架構約束。OWASP 2025 年的指引明確指出:系統提示詞並非安全控制項,因為 LLM 具備隨機性而非確定性,本質上無法作為可稽核的安全邊界。自動化越獄攻擊透過利用行為對齊與結構強制執行之間的落差,對專有模型達到 80-94% 的成功率。執行時期防護護欄運作於模型生成程序之外的確定性程式碼中,使其具備可稽核性、可測試性且獨立於模型行為。兩者皆不可或缺:模型層級安全可降低有害輸出的基準頻率,而執行時期防護護欄則能捕獲模型對齊所遺漏的威脅。
自信打造您的 AI。
與一支在打造新世代企業級 AI 方面擁有深厚經驗的團隊攜手合作。讓我們協助您設計、建置並部署值得信賴的 AI 策略。
Veriprajna 深度科技顧問公司 專精於為醫療、金融及法規監管領域打造攸關安全的 AI 系統。我們的架構均依循既定規範進行驗證,並備有完整的合規文件。