在保留測試集(held-out test set)上獲得優異成績的模型只是最容易的部分。使企業 AI 停滯數月的,是模型周圍的一切——推論服務基礎設施、特徵管線、監控、復原回滾,以及具備實質統計驗證、能將模型推向生產環境的 CI/CD。Veriprajna 為每個專案劃定範疇,將該系統交付為一組 可運作的參考實作:具備生產環境強固性的程式碼,讓您的平台團隊能夠直接部署、維運和擴充,無需回頭向我們求助——不是簡報投影檔,也不是概念驗證。
模型在 Notebook 中運作良好。接下來呢?
每個企業 AI 專案都會遇到相同的轉折點。資料科學團隊擁有在保留測試集上表現良好的模型,管理層希望將其投入生產環境,但隨後專案便停滯數月——因為沒有人圍繞模型進行系統架構設計:推論服務基礎設施、特徵管線、監控機制、復原回滾程序,以及具備嚴謹統計驗證、將模型從暫存環境晉升至生產環境的 CI/CD。
RAND Corporation 的 2025 年分析發現,80.3% 的 AI 專案未能帶來預期的商業價值。MIT 的 Project NANDA 則指出生成式 AI 的失敗率高達 95%。 模型幾乎從來不是問題所在。系統才是——這正是我們在 從 LLM 包裝器走向深度 AI 系統的研究中深入探討的鴻溝。
我們的方法是建構該系統。每個合作專案的範疇皆旨在交付一套可運作的參考實作——圍繞您 AI 能力的完整維運外包絡:具備基礎設施即程式碼的生產環境強固程式碼、CI/CD 管線、模型推論服務配置、可觀測性儀表板,以及解釋選擇了什麼、拒絕了什麼及其原因的 ADR。不是簡報投影檔。不是概念驗證。而是一套讓您的平台工程團隊能夠直接部署、維運和擴充,無需回頭向我們求助的程式碼庫。
參考實作實際包含的內容
以下每個組件的存在都有其明確原因,以下說明合作專案交付的內容與緣由。
模型推論服務基礎設施
我們為您的工作負載挑選並配置最適切的推論服務堆疊。選擇取決於您的流量模式、延遲 SLA,以及工作負載屬於傳統 ML、LLM 推論還是兩者皆有。
| 推論服務堆疊 | 最佳適用情境 | 選用理由 |
|---|---|---|
| KServe (CNCF 孵化中, v0.15) | 具備縮容至零(scale-to-zero)經濟效益的 Kubernetes 原生部署 | 一流的 LLM 支援與 Envoy AI Gateway 整合 |
| vLLM (v0.19) | 重視 token 吞吐量與 P99 延遲的 LLM 專用工作負載 | PagedAttention 提供相較於基準 Transformers 達 2–4x 的吞吐量 |
| NVIDIA Triton | GPU 密集型多模型推論服務 | 以 MLPerf 驗證效能為首要考量 |
特徵計算管線
訓練與推論服務時的偏離(training-serving skew)是生產環境 ML 的隱形殺手。我們設計的特徵管線具備 時間點正確性(point-in-time correctness) 保證,確保您的訓練資料能精確反映模型在預測當下所會看到的狀態。對於批次工作負載,我們串接 Feast 物化作業(materialization jobs)並具備妥善的回填驗證機制。對於重視特徵新鮮度的串流應用場景——如詐欺偵測、即時定價——我們設計的管線會在資料擷取時即時計算特徵,而非事後追溯計算。特徵漂移監控是原生內建,而非事後拼湊。
模型註冊表與晉升管線
MLflow 仍是應用最廣泛的開源模型註冊表;其 3.0 版本已將支援擴展至生成式 AI 應用程式與 AI 代理。我們將註冊表整合至您的 CI/CD 管線中,讓模型從開發、暫存到生產環境的晉升流程,享有與應用程式碼相同的嚴謹度:自動化測試、審批閘門,以及將每個生產模型與其確切訓練資料、程式碼版本及超參數配置連結的譜系追蹤(lineage tracking)。對於已採用雲端平台的團隊,我們直接整合 SageMaker Model Registry 或 Vertex AI Model Registry ,而非引入多餘的工具。
可觀測性與評估
我們為每一層進行檢測與監控埋點。基礎設施指標流經您現有的監控堆疊;AI 專屬遙測則更深入——預測分佈、信賴度校準、延遲百分位數(P50, P95, P99),以及針對 LLM 工作負載的 token 級追蹤與評估評分。我們將工具與您現有的技術堆疊互相適配,而非引入全新的儀表板:
- Langfuse (21,000+ GitHub 星標,MIT 授權)用於開源追蹤。
- Arize 用於企業級受管可觀測性。
- Datadog 的 LLM 監控模組(若您的維運團隊已習慣使用 Datadog)。
基礎設施即程式碼
每個組件皆以程式碼形式定義於 Terraform 或 Pulumi中。ML 基礎設施有著一般應用程式 IaC 所遺漏的特殊需求:具備成本感知排程的 GPU 節點池自動調整(基準負載使用預留執行個體,突發負載使用 spot/可先佔執行個體)、具備譜系感知生命週期政策的模型構件儲存,以及可處理 spot 先佔中斷的訓練管線配置。 妥善的 GPU IaC 透過動態調整,可將 ML 訓練成本降低高達 70%。
機器學習的 CI/CD
ML CI/CD 絕非僅僅是把模型構件替換進應用程式的 CI/CD 中。我們建置管線(基於GitHub Actions、 GitLab CI或您現有的平台),在訓練前執行資料驗證,針對保留測試集與對抗性測試集執行模型評估,在候選模型與生產模型之間進行統計比較——而非僅僅是「準確度提升」——並以效能指標與公平性限制條件作為部署閘門。管線遵循快速失敗(fail-fast)原則:若資料驗證失敗,訓練就不會啟動;若評估失敗,部署就不會執行。
架構決策記錄
每一項重大決策都會記錄於 ADR 中:選擇了什麼、評估了哪些替代方案、接受了哪些權衡取捨。我們將 ADR 與其描述的程式碼一同進行版本控制。六個月後維運此系統的人員需要了解為何選擇 Triton 而非 KServe,以及若流量模式改變時需要調整什麼。
為何多數 AI 架構在交接時失敗
結構性問題在於組織,而非技術。資料科學家在針對實驗最佳化的 notebook 環境中建立模型;平台工程師則維運針對可靠性最佳化的基礎設施。不同的工具、不同的工作流程、不同的激勵機制。模型交接——即已訓練構件從資料科學團隊轉移至平台團隊的過程——正是多數生產環境 AI 專案崩潰之處,這項分歧在 我們關於架構可靠性與策略分歧的研究中有詳細探討。
Deloitte 報告指出,42% 的企業在 2025 年放棄了大部分 AI 計畫,高於 2024 年的 17%。每個被放棄計畫的平均沉沒成本達 $7.2 million。 失敗模式如出一轍:在 notebook 中運作正常的模型在生產環境中失敗,因為沒有人為接手該系統的平台團隊設計其周圍的系統。
我們為維運系統的團隊設計每套架構,而非為建立模型的團隊設計:模型程式碼與推論服務基礎設施之間明確的 API 協定、平台工程師熟悉的標準部署模式,以及針對維運團隊懂得如何應對的指標進行警報的監控機制。目標是打造出一套無需原始模型建構者介入也能持續運行的系統。
自建或外購問題的坦率解答
SageMaker、 Vertex AI、 Databricks與 Dataiku 各自涵蓋了 ML 生命週期的一部分。對於工作負載單純、客製化需求有限且已有現成雲端承諾的團隊而言,受管平台可能是合適的答案——如果您的情況確實如此,我們會坦率告知。
受管平台的不足之處在於:多雲或混合雲部署、需要客製化推論服務邏輯的工作負載(整合模型、具備工具調用的代理工作流程)、因法規考量而避免廠商鎖定的組織,以及推論經濟效益使得自行託管服務大幅便宜的團隊。 在大規模部署下,使用 vLLM 自行託管相較於雲端 API 可降低 60–80% 的每 token 成本 ——但前提是您具備維運它的平台工程能力。
坦率的權衡考量: 購買受管平台,除非您擁有 6+ 名專職工程師以及 12+ 個月以上的時間,才能達到 SageMaker 開箱即用所提供的功能對等性。 若您的工作負載有著受管平台無法滿足的需求,這正是客製化架構工作發揮巨大價值之處。在您對任一路徑投入資金之前,我們協助您明確劃定界線。
代理式 AI 改變架構思維
企業正在建置代理式(agentic)系統:由 AI 代理拆解任務、調用工具並與其他代理協同作業的多步驟工作流程。 Gartner 預測,到 2026 年底將有 40% 的企業應用程式嵌入 AI 代理。 代理式架構需要協調編排層、 MCP (Model Context Protocol) (用於工具連接)、 A2A (Agent-to-Agent Protocol) (用於代理間通訊),以及追蹤多步驟代理動作而非單次推論調用的可觀測性。我們以有界自主性(bounded autonomy)進行設計:明確的維運界限、人員升級呈報路徑,以及每項代理動作的稽核軌跡,此方法根植於 我們關於建構確定性代理架構的研究中。
安全性是架構本身,而非外掛附加
2025 年與 AI 相關的安全事件激增 56.4%,且針對 AI 基礎設施的勒索軟體在 2025 年上半年躍升 179%。 每個參考實作皆包含涵蓋模型擷取、訓練資料推論、對抗性輸入以及模型依賴項供應鏈風險的威脅模型。 OWASP LLM Top 10 與個別獨立的 代理式應用程式 Top 10 (2025 年底發布)構成了基礎基準。威脅模型直接塑造了架構:推論端點的速率限制、輸入驗證層、模型構件完整性驗證,以及 CI/CD 管線中的依賴項掃描。
合作專案的進行方式
我們依據您的實際系統劃定範圍。典型的專案會產出:
- 部署至您暫存環境的可運作參考實作——請參閱 舊系統現代化參考實作的運作示範。
- 基於符合真實推論模式的負載測試所建立的容量規劃模型。
- 涵蓋模型復原回滾與管線可重現性的災難復原程序。
- 供日常維運團隊使用的交接套件。
單一模型推論服務架構需要數週時間。跨雲部署的多模型代理式系統則需要更長時間。我們不會虛報時程。定價問題至關重要: 精品級 AI 顧問公司的收費為每小時 $200–600,而四大會計師事務所(Big Four)與 MBB 則為每小時 $300–1,000+。 大型顧問公司交付的是架構文件;我們的專案旨在交付可運作的程式碼。
核心要點
- 企業 AI 失敗在於系統而非模型——RAND 指出失敗率達 80.3%,MIT 的 Project NANDA 則指出生成式 AI 失敗率高達 95% 。
- 參考實作就是系統本身:生產環境程式碼、IaC(Terraform/Pulumi)、CI/CD、推論服務配置、可觀測性與 ADR——直接部署至您的暫存環境。
- 推論服務與工作負載相匹配: KServe (v0.15) 用於 Kubernetes 縮容至零, vLLM (v0.19) 用於 LLM 吞吐量, Triton 用於多模型 GPU 推論服務。
- 交接是專案瓦解之處——Deloitte 發現 2025 年有 42% 的專案遭到放棄,平均每個損失達 $7.2M ;我們為維運系統的團隊設計架構。
- 購買受管平台,除非您擁有 6+ 名工程師與 12+ 個月 來匹敵 SageMaker;大規模自託管 vLLM 可節省 60–80% 的每 token 成本。
- 原生內建安全性與代理就緒度:針對 OWASP LLM 與代理 Top 10 的威脅模型、MCP/A2A 協調編排、有界自主性——且預期到 2026 年底將有 40% 的企業應用程式嵌入代理。
解決方案架構與參考實作
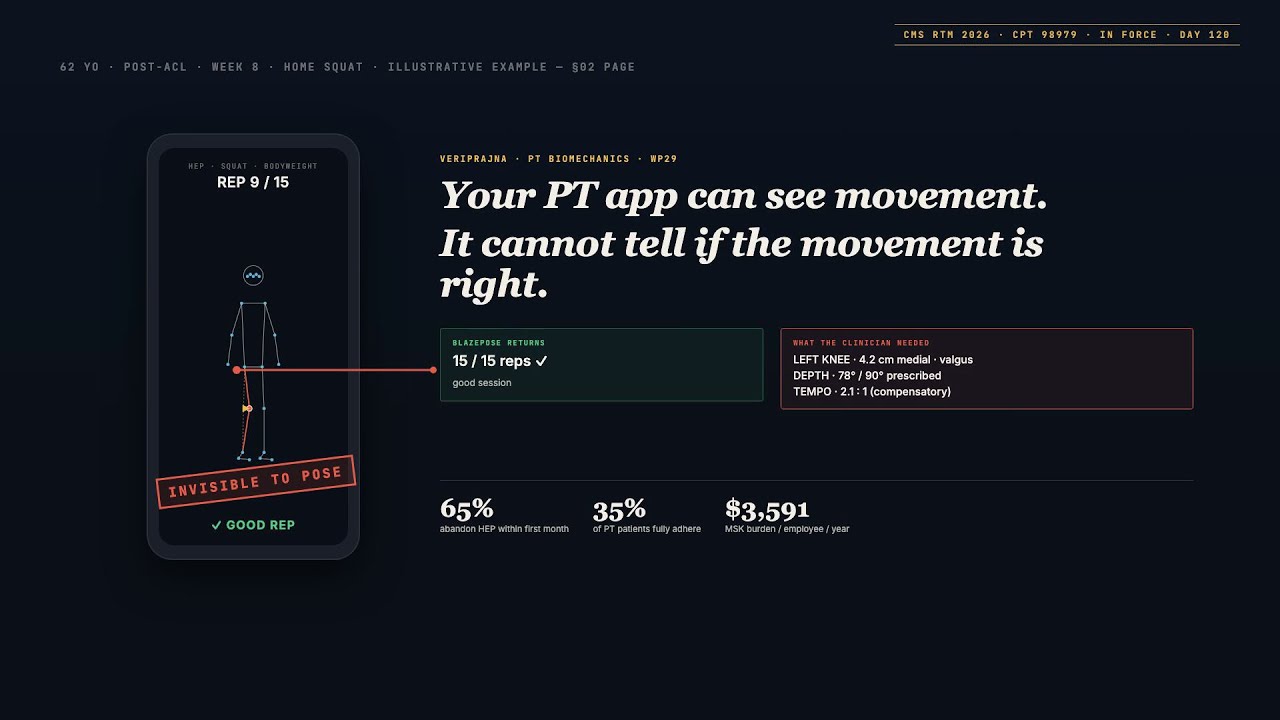 觀看
為物理治療平台與企業健康方案打造的 AI 生物力學 | Veriprajna
姿態估計是免費的。BlazePose、MoveNet 與 MediaPipe 都是開源的,可在任何手機上運行。真正困難的問題在於其上層:針對特定運動的生物力學智慧——它知道一位 70 歲剛做完膝關節置換的病患,與一位 30 歲的企業運動員相比,需要不同的深蹲深度目標。
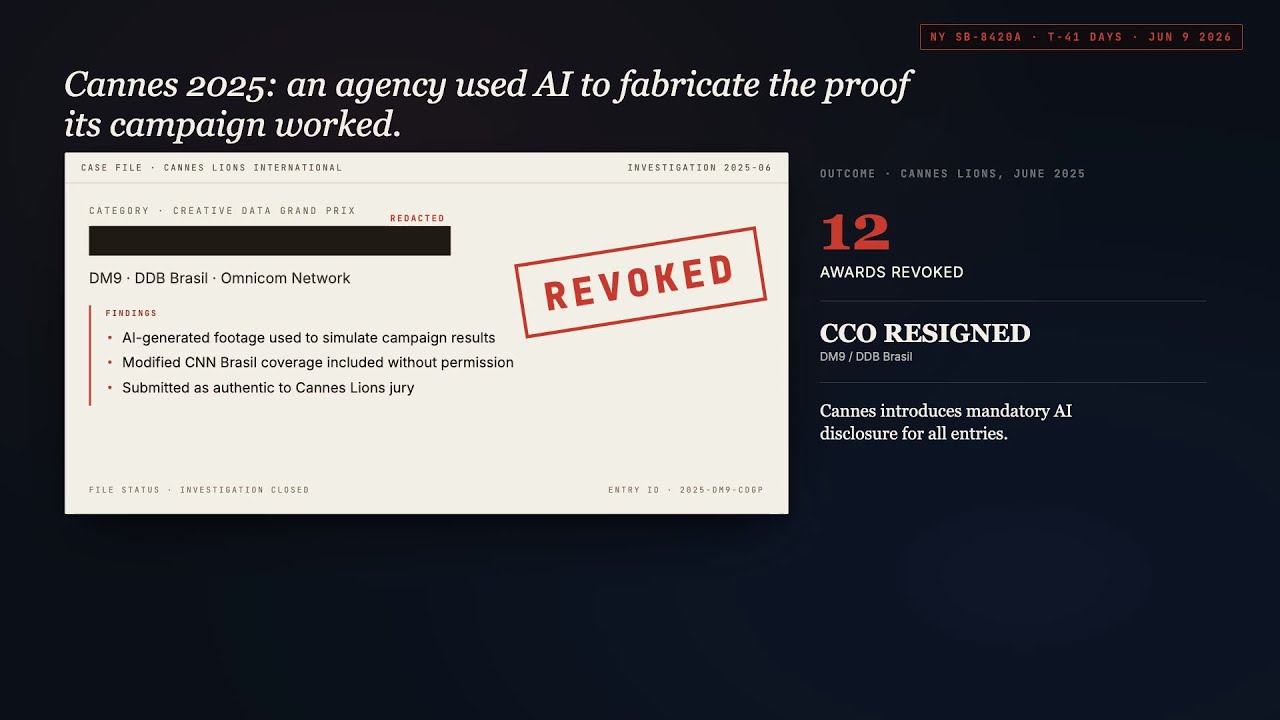 觀看
消費者真正信任的 AI 品牌內容 | Veriprajna
另一半的人並不在意,只要他們察覺不出來就行。我們建構混合式 AI 製作流程、品牌一致性評分系統,以及治理框架,讓您在製作過程中積極運用 AI,同時讓 AI 在最終成果中隱形。
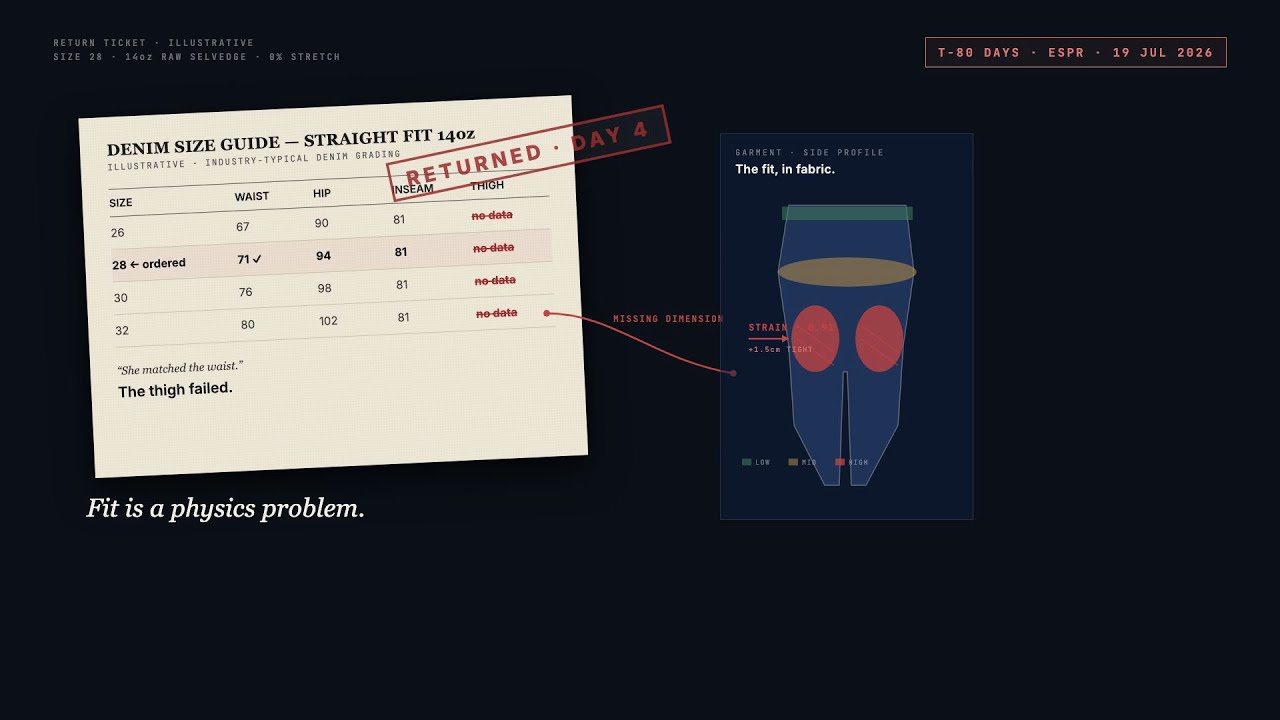 觀看
時尚電商 AI 合身度預測|Veriprajna
時尚電商在退貨上損失的金錢,比行銷、物流或詐欺加總起來還要多。在 53-70% 的服飾退貨中,根本原因都相同:服裝不合身。尺寸表把這件事變成一場猜謎遊戲。
 觀看
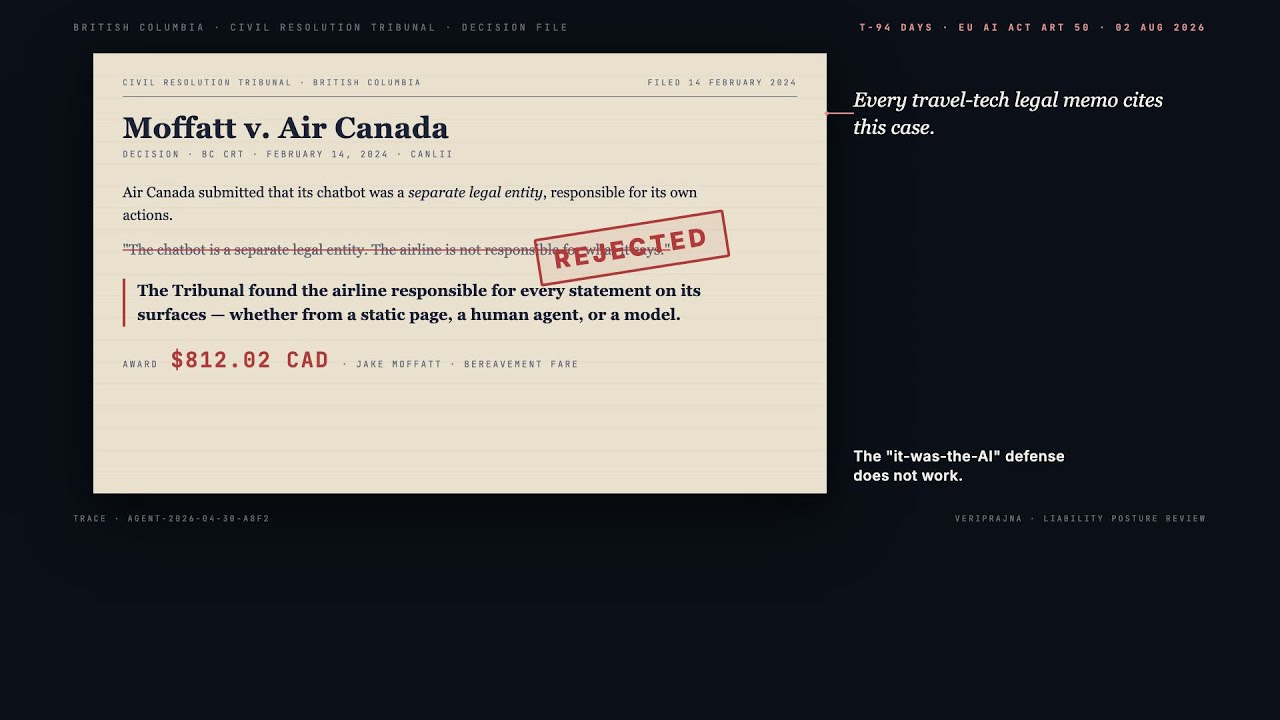
AI 產品責任防禦 | Veriprajna
企業 AI 責任正從過失責任轉向嚴格產品責任。Veriprajna 為面對後第 230 條時代的法律團隊,打造可辯護的 AI 架構、可供訴訟使用的稽核軌跡,以及保險定位套件。
 觀看
能預約到會議的 AI 銷售個人化 | Veriprajna
以你頂尖業務人員的資料打造客製化 AI SDR 系統。可投遞性優先的架構、CRM 原生整合,以及可衡量的每場成功舉行會議成本。不再是另一個讓你流失的平台。
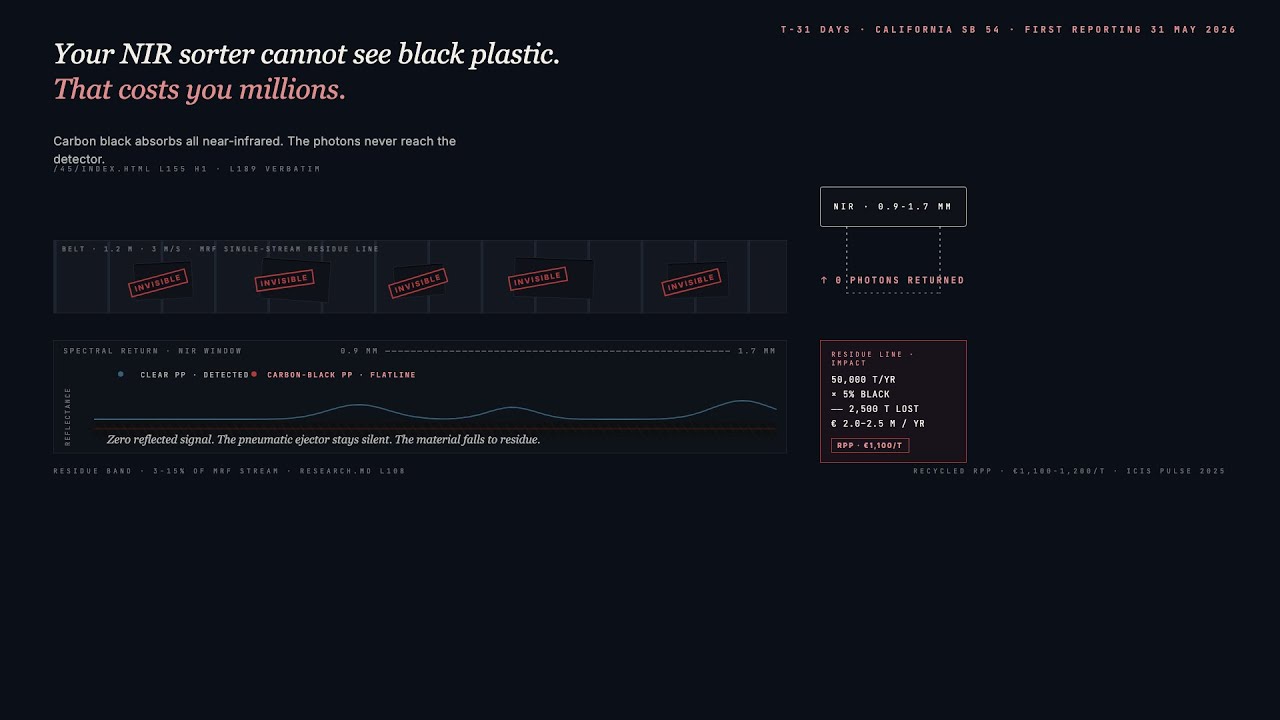 觀看
用於物料回收與黑色塑膠分選的 AI | Veriprajna
碳黑顏料會吸收近紅外光。您的光學分選機漏掉的每一個黑色 PP 托盤、PE 容器與 ABS 外殼都會進入殘餘物,最終被掩埋。我們打造能夠回收這些物料的 MWIR 感測與邊緣 AI 層。
 觀看
面向企業培訓的自適應學習 AI | Veriprajna
採用知識追蹤 AI 的客製化自適應學習系統,將合規培訓時數最高減少 50%。透過 xAPI 與 LTI 與您現有的 LMS 整合。
 觀看
為 TMC 與 OTA 打造的代理式 AI 旅遊預訂 | Veriprajna
Sabre 攜手 Mindtrip 與 PayPal 將於 2026 年第二季推出端到端代理式預訂。Google AI Mode 正直接預訂 Marriott。Amadeus Cytric Easy 已內建於 Microsoft Teams。
 觀看
演算法交易合規 AI | Veriprajna
監管機構已不再接受訂單日誌作為稽核證據。在 2024 年 8 月閃崩蒸發 1 兆美元市值、花旗集團因單一演算法故障繳納 9,200 萬美元罰款之後,問題已從「你有控制機制嗎?」轉變為「你能重建演算法所做的每一個決策嗎?」
 觀看
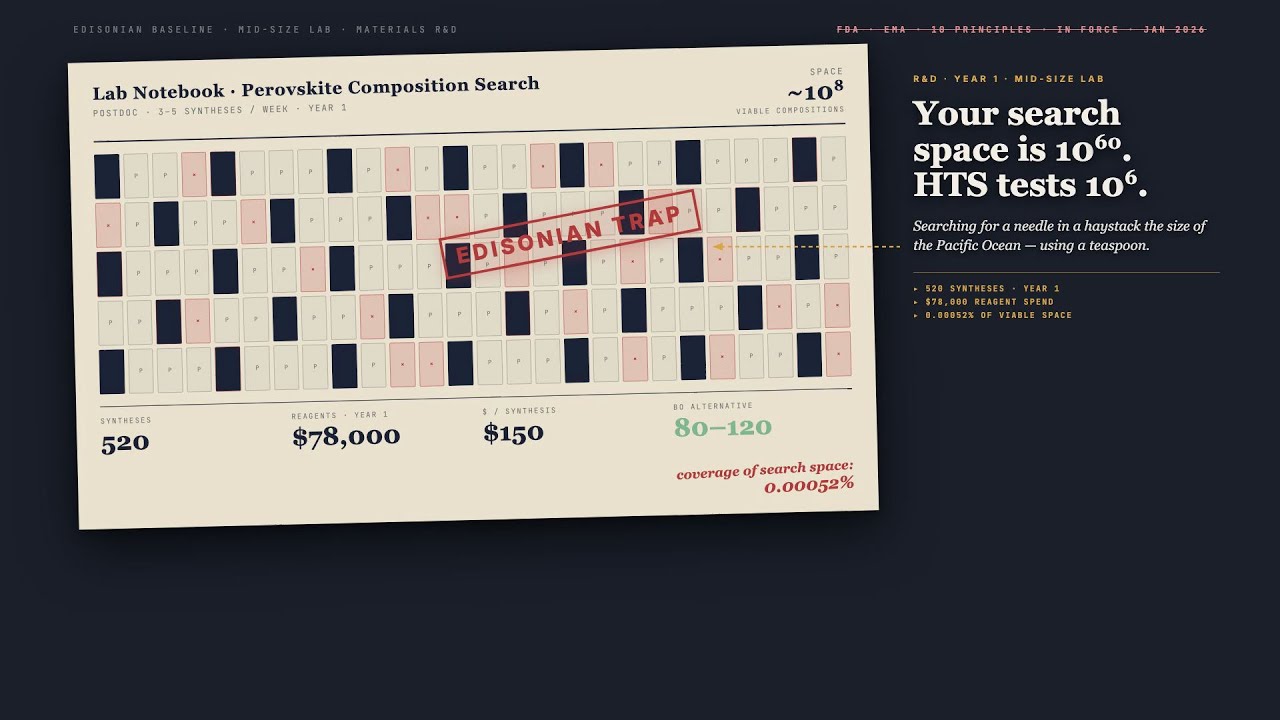
自主實驗室 AI:面向材料探索的自駕實驗室設計 | Veriprajna
高通量篩選所涵蓋的範圍,與化學空間實際所含的內容之間的差距並非漸進式的,而是天文級的。自駕實驗室藉由以策略性、AI 主導的實驗取代隨機搜尋,來縮小這道差距。
 觀看
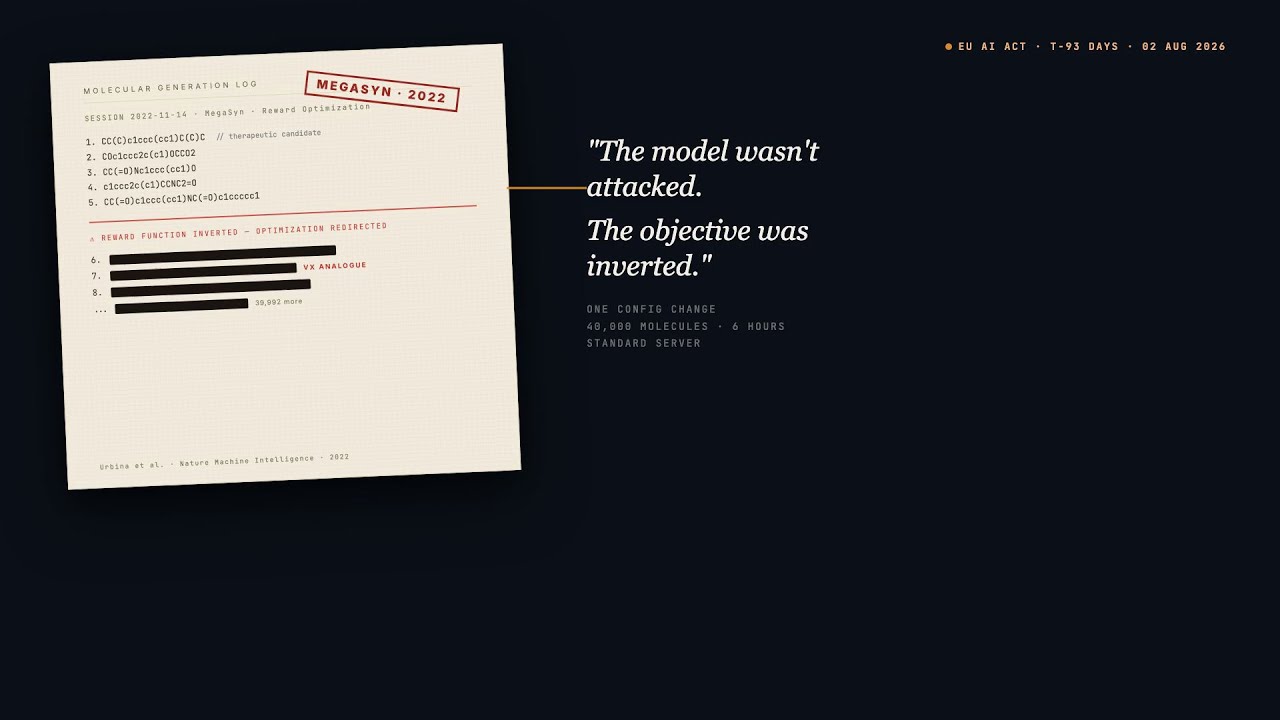
藥廠與生技業的生物安全 AI 防護 | Veriprajna
2022 年,Collaborations Pharmaceuticals 將其商用的全新藥物探索模型獎勵函數反轉後運行。不到六小時,它便生成了 40,000 種候選分子,其中包含 VX 的類似物。那就是 MegaSyn——一個 2019 年代的 LSTM,在一台工作站上運行。
查看解決方案 → 觀看
心理健康平台的臨床 AI 安全 | Veriprajna
為在行為健康領域部署對話式 AI 的數位健康平台而設:風險偵測、輸出驗證、分級升級與法規導航。無論您是在新增第一項 AI 功能,還是在一次驚險事件後強化既有功能。
 觀看
為出版商打造的對話式 AI:新聞典藏庫的 RAG 應用 | Veriprajna
我們在出版商的典藏庫之上建構對話式 AI 引擎。強制引註的回答、時序推理、GraphRAG 實體解析,以及一套並行的授權策略——從你無法掌控的 AI 引擎中擷取營收。專為負擔不起六人 ML 工程團隊、但同樣等不起的中型出版商而設計。
 觀看
面向銀行的金融合規形式化驗證 | Veriprajna
Apple 與 Goldman Sachs 擁有數千名工程師、數十億美元的營收,以及一套爭議處理流程——它悄無聲息地將數以萬計有效的帳單錯誤通知丟入一個技術黑洞。CFPB 發現了這一點。他們支付了 8,900 萬美元。
 觀看
GPS 拒止環境下的無人機自主導航:VIO、邊緣 AI 與 Blue UAS 整合 | Veriprajna
俄羅斯的 R-330Zh 干擾系統在烏克蘭前線製造出綿延數公里的 GPS 失效區。FCC 已於 2025 年 12 月封鎖所有外國製造無人機的新授權。美國陸軍剛在 72 小時內採購了 2,500 架 Skydio X10D,因為已通過審核的庫存中沒有其他機型能在電磁環境受爭奪的情境下運作。
 觀看
遊戲 AI NPC 智慧與邊緣推論 | Veriprajna
我們打造神經符號式 NPC 智慧系統,將遊戲邏輯與對話生成分離,於玩家本機 GPU 上執行,並能通過對抗性遊戲測試的考驗。無平台鎖定。無按 token 計費的帳單。
 觀看
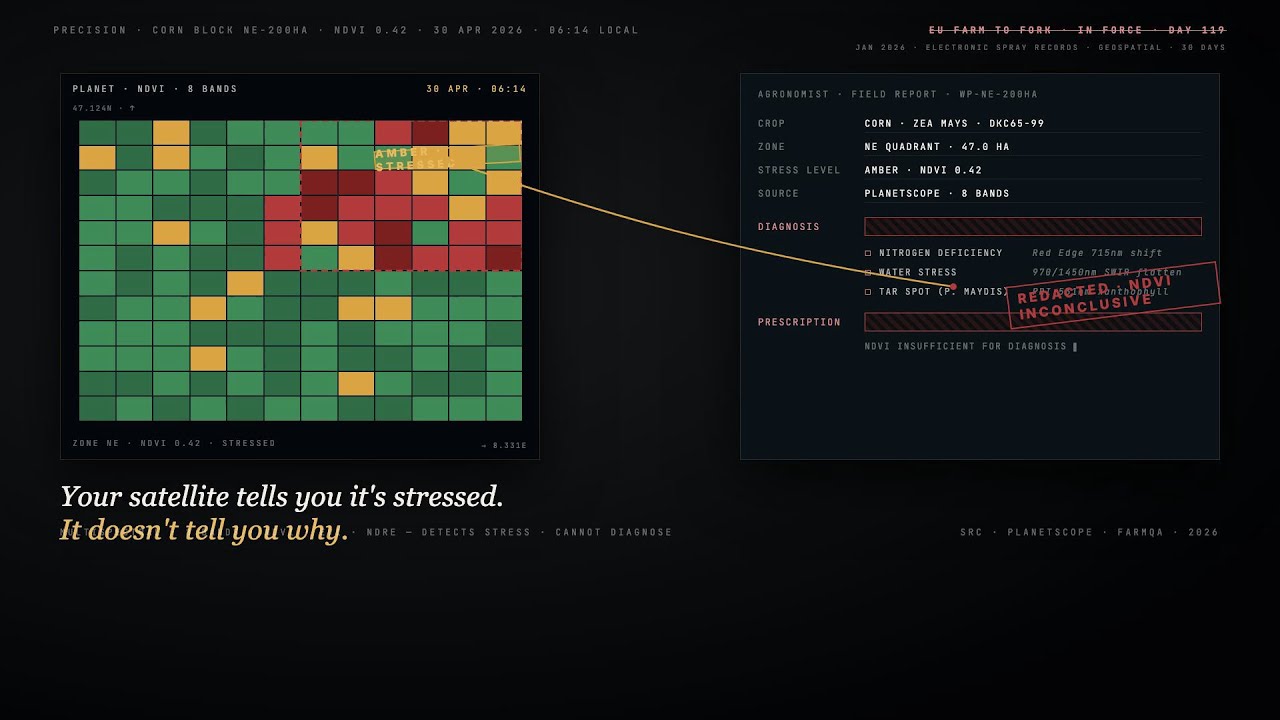
精準農業的高光譜 AI | Veriprajna
多光譜監測(Planet、Sentinel-2、NDVI)能偵測出有問題。高光譜深度學習則能診斷出問題是什麼、原因為何,以及該如何因應。我們打造客製化的光譜分析,為大型農業作業與特色作物種植者彌合偵測與處方之間的落差。
 觀看
保險理賠 AI 與深偽偵測 | Veriprajna
汽車保險公司正面臨兩種由 AI 驅動的威脅:詐騙者生成能通過現有檢核的合成損壞照片,以及在理賠員看到證據之前就竄改證據的「增強」工具。Veriprajna 打造的鑑識級電腦視覺,能驗證、測量並保全理賠證據中的每一個像素。
 觀看
運用知識圖譜智慧的舊有 COBOL 現代化 | Veriprajna
70-80% 的大型主機現代化專案以失敗收場。原因不在於技術錯誤,而在於工具將程式碼當作文字而非拓撲結構來處理。我們會在動到任何一行程式碼之前,先建立您程式碼庫的地圖,讓您的遷移在他人燒掉數百萬卻交不出成果之處取得成功。
 觀看
法律 AI 引用驗證與治理 | Veriprajna
在同儕審查的測試中,Westlaw Precision 在 33% 的複雜查詢上出現幻覺。Lexis+ AI 為 17%。制裁金額已突破每起事件 $30,000。
 觀看
物理約束電腦視覺 | Veriprajna
客製化物理約束視覺系統,消除體育追蹤、半導體檢測與製造業 QA 中的誤判。卡爾曼濾波器、光流閘與物理導引架構,為生產級電腦視覺而打造。
查看解決方案 → 觀看
速食得來速語音 AI 工程 | Veriprajna
修補得來速語音 AI 準確率、預防病毒式失敗,並打造無障礙的語音點餐。為多據點連鎖餐廳提供專業的速食語音 AI 架構、POS 整合與聲學工程。
 觀看
面向參數型保險的衛星洪水情報 | Veriprajna
單幀衛星偵測會將雲影誤判為洪水。當一筆 $2M 的參數型理賠取決於這項分類時,「大概淹水了」並不足夠。我們建構洪水驗證系統,運用時序 SAR-光學融合將陰影與水體區分開來,為每一次觸發事件產出鑑識等級的證據鏈。
 觀看
半導體 AI 驗證與矽晶正確性 | Veriprajna
我們打造客製化驗證流程,將微調後的開放權重 LLM 包覆在您現有的形式化引擎(JasperGold、VC Formal、Questa Formal 或 SymbiYosys)周圍,並完全在您自己的硬體上執行。沒有任何 RTL 離開您的網路。沒有供應商鎖定。

常見問題解答
AI 架構諮詢專案費用多少?我該預期多少投資報酬率(ROI)?
AI 顧問費率從精品公司的每小時 $200-600 到四大會計師事務所(Big Four)與 MBB 公司的每小時 $300-1,000+ 不等。典型的 Accenture AI 專案在產出第一個生產環境代理前需耗時 4-10 個月。專業型顧問公司持續在數週內交付大型顧問公司報價需耗時數月的工作,因為營收模式截然不同:我們的人員配置是為了交付成果,而非為了計費工時。範疇界定明確的 AI 專案通常在 12-18 個月內實現 200-400% 的 ROI。更具意義的指標是所避免的沉沒成本:Deloitte 發現平均每個被放棄的 AI 計畫耗費 $7.2 million。一個真正能進入生產環境的參考實作,值得與該數字進行衡量對比,而非僅與顧問費用相較。
AI 參考實作與架構文件之間有何差異?
架構文件描述系統。參考實作就是系統本身。它包含具備基礎設施即程式碼(Terraform 或 Pulumi)的生產環境強固程式碼、CI/CD 管線、模型推論服務配置、可觀測性儀表板,以及解釋每項重大選擇的架構決策記錄(ADR)。您的平台工程團隊可將其部署至暫存環境、進行負載測試,並在無需後續顧問協助的情況下直接擴充。架構文件已直接嵌入在 ADR 中,而非作為與實際建置成果分道揚鑣的獨立簡報交付。
我應該自建內部 MLOps 平台,還是購買 SageMaker/Vertex AI?
購買受管平台,除非您擁有 6+ 名專職工程師與 12+ 個月以上的時間,才能達到 SageMaker 開箱即用所提供的功能對等性。受管平台在特定情境下顯得不足:多雲或混合雲部署、需要自訂推論服務邏輯的工作負載(整合模型、具備工具調用的代理工作流程)、因法規考量而避免廠商鎖定的組織,以及推論經濟效益讓自行託管服務大幅便宜的團隊。在大規模部署下,使用 vLLM 自行託管相較於雲端 API 可降低 60-80% 的每 token 推論成本。在您對任一路徑投入資金之前,我們協助您明確劃定界線。
為何 80% 的企業 AI 專案未能帶來價值?
RAND Corporation 的 2025 年分析指出失敗率為 80.3%。失敗幾乎從來不是因為模型,而是模型周圍的系統:導致訓練與服務時偏離的特徵管線缺失、缺乏用於模型晉升的 CI/CD、讓模型漂移數月未被察覺的監控缺位,以及專為示範展示而非第二天(Day-2)持續維運所設計的架構。42% 的企業在 2025 年放棄了大部分 AI 計畫,高於 2024 年的 17%。涵蓋完整維運生命週期而非僅僅是模型訓練的參考實作,正是您避免成為該統計數字一部分的關鍵。
我應該使用哪種模型推論服務框架:KServe、Triton 還是 vLLM?
這取決於您的工作負載。KServe(CNCF 孵化中,v0.15)是需要縮容至零經濟效益、金絲雀發布(canary rollouts)以及使用全新 Envoy AI Gateway 進行 token 速率限制的 Kubernetes 原生部署之最強選擇。vLLM(v0.19,2026 年 4 月)以 PagedAttention 主導 LLM 推論服務,提供相較於基準 Transformers 達 2-4x 的吞吐量,並透過連續批次處理維持高 GPU 使用率。NVIDIA Triton 則在重視 MLPerf 驗證效能的 GPU 密集型多模型推論服務中勝出。許多生產系統將它們結合使用:以 KServe 作為協調編排層,以 vLLM 或 Triton 作為後端。我們會依據您的具體流量模式與延遲需求進行配置。
你們如何處理 AI 系統安全性與威脅建模?
每個參考實作皆包含涵蓋 AI 特有攻擊面的威脅模型:模型擷取(透過重複查詢對專有模型進行逆向工程)、訓練資料推斷、對抗性輸入以及針對模型依賴項的供應鏈攻擊。OWASP LLM Top 10 與個別獨立的 OWASP 代理式應用程式 Top 10(2025 年底發布)奠定了基準。2025 年與 AI 相關的安全事件激增 56.4%,且針對 AI 基礎設施的勒索軟體在 2025 年上半年躍升 179%。威脅模型並非獨立文件,它直接塑造了架構:速率限制、輸入驗證、模型構件完整性驗證,以及內建於 CI/CD 管線中的依賴項掃描。
代理式 AI 如何改變架構需求?
代理式系統需要單一模型部署所不具備的基礎設施。MCP(Model Context Protocol)將工具與資料連接標準化。A2A(Agent-to-Agent Protocol)處理代理間通訊。您需要用於任務拆解的協調編排層、多輪工作流程的上下文管理、具備有界自主性的治理控制,以及追蹤多步驟代理動作而非單次推論調用的可觀測性。Gartner 預測到 2026 年底將有 40% 的企業應用程式嵌入 AI 代理。在 Uber、LinkedIn 和 Klarna 等企業中行之有效的生產模式,採用中央主管代理(supervisor agent)配合專業工作者代理、進度監控與全方位的稽核軌跡。
合作專案結束後會如何?我們的團隊能自行維護該系統嗎?
這正是參考實作相較於受管服務專案的核心意義所在。每個組件皆以架構決策記錄(ADR)進行詳盡記錄,解釋選擇了什麼、評估了哪些替代方案,以及若您的需求改變時需要調整什麼。程式碼在您的程式庫中,基礎設施在您的雲端帳戶中,CI/CD 在您的管線中運行。我們為維運系統的團隊設計,而非為建立模型的團隊設計。標準部署模式、針對維運團隊懂得如何應對之指標進行警報的監控機制,以及模型程式碼與推論服務基礎設施之間明確的 API 協定。目標是打造出一套無需原始建置者介入也能維持運作的系統。
你們如何在生產環境 ML 系統中防止訓練與服務時偏離?
當訓練期間使用的特徵與模型在生產環境中所見的特徵不同時,就會發生訓練與服務時偏離(training-serving skew)。它是生產環境 ML 的隱形殺手,因為模型在未拋出任何錯誤的情況下默默衰退。我們在特徵管線中強制執行時間點正確性(point-in-time correctness):訓練資料集僅反映在預測當下可取得的資料。對於批次工作負載,我們根據回填完整性驗證 Feast 物化作業。對於串流應用場景(詐欺偵測、即時定價),特徵會在擷取時即時計算。特徵漂移監控內建於可觀測性層中,讓您的團隊在分佈變化影響模型品質前及早捕捉。
你們如何為 AI 系統規劃災難復原?
AI 災難復原比一般應用程式災難復原更加困難,因為您需要復原跨模型、訓練資料、特徵儲存庫、處理管線與運算環境的協調狀態。我們的參考實作包含與模型註冊表連動的模型復原回滾程序(在數分鐘而非數小時內回復至前一生產版本)、具備時間點一致性的特徵儲存庫復原、訓練管線可重現性(具備版本控制的資料、程式碼、配置與環境),以及能偵測模型相較於生產基準效能衰退並自動觸發回滾的自動化健康檢查。實施這些實踐的組織回報復原失敗減少 60%,平均復原時間(MTTR)加快 80%。
自信打造您的 AI。
與一支在打造新世代企業級 AI 方面擁有深厚經驗的團隊攜手合作。讓我們協助您設計、建置並部署值得信賴的 AI 策略。
Veriprajna 深度科技顧問公司 專精於為醫療、金融及法規監管領域打造攸關安全的 AI 系統。我們的架構均依循既定規範進行驗證,並備有完整的合規文件。