「我們在模型中去除了種族和收入」是導致動態定價訴訟敗訴的辯詞

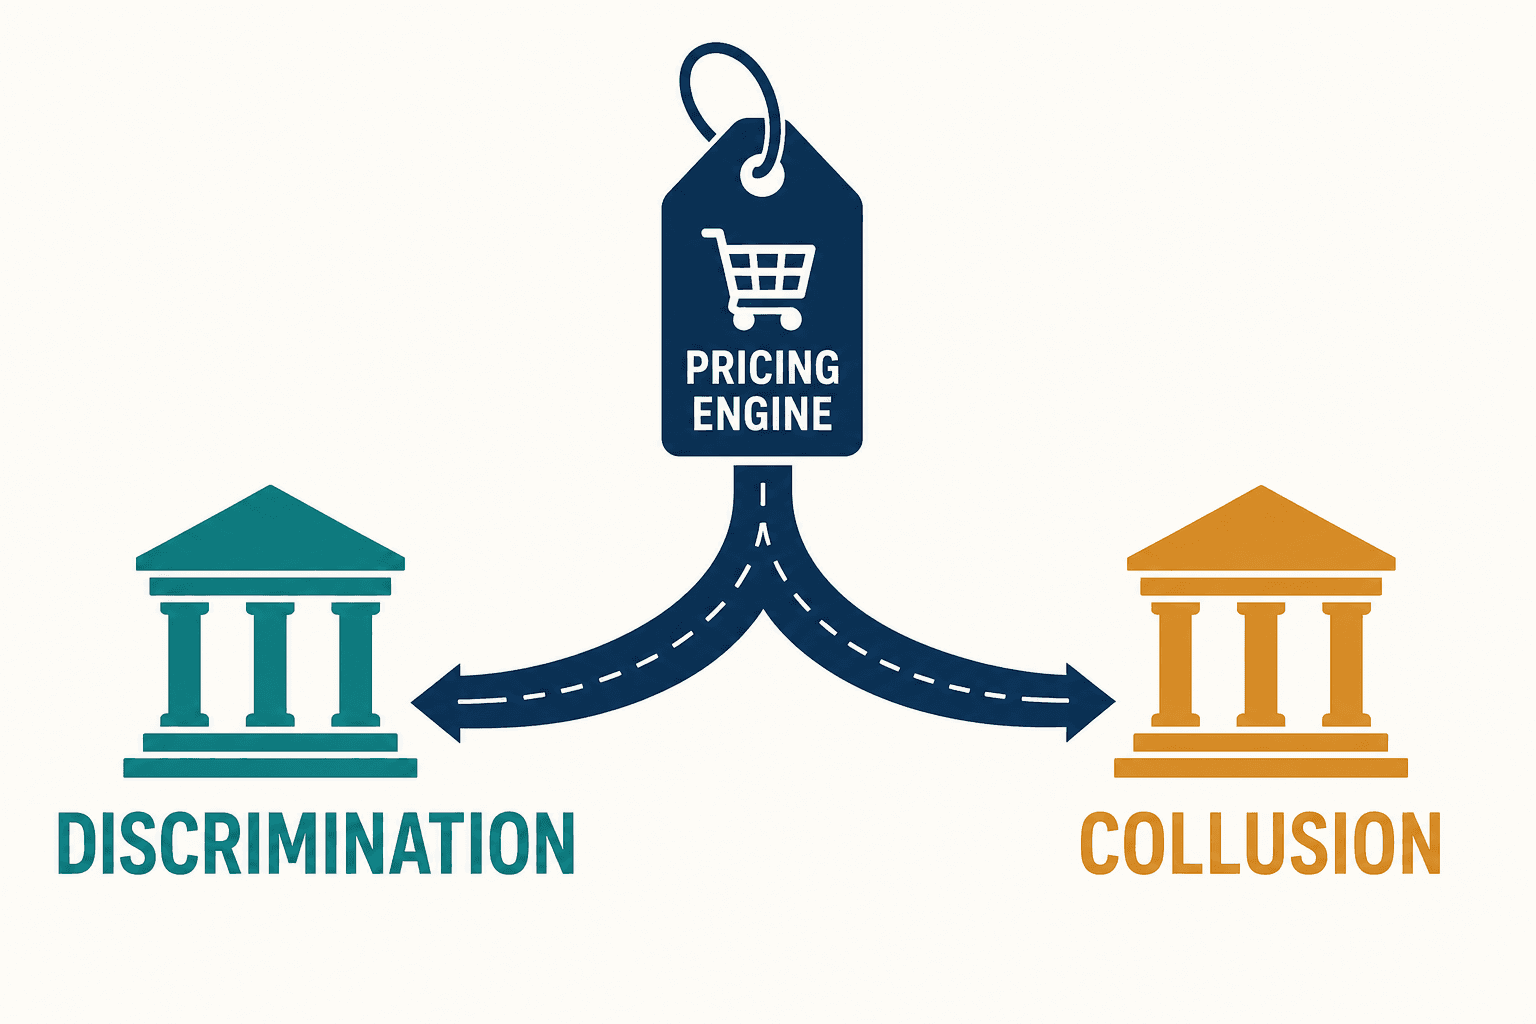
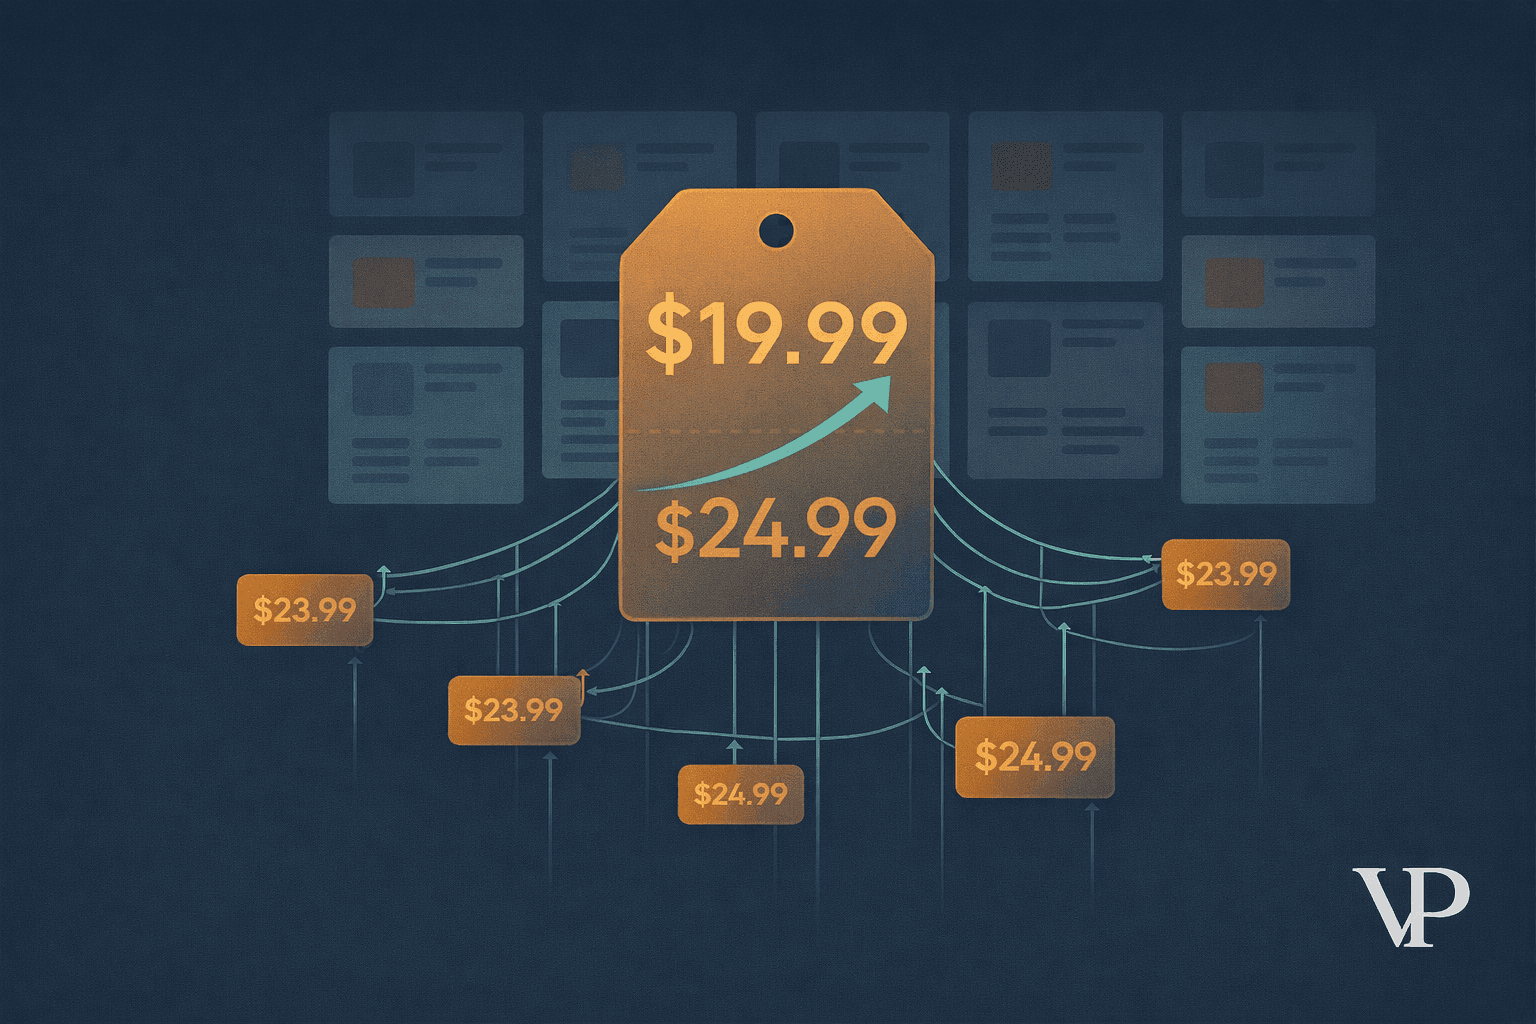
2025年12月,美國聯邦貿易委員會(FTC)就Eversight動態定價實驗與Instacart達成6000萬美元的和解協議,起訴書記錄了完全相同商品的價格差異高達23%。FTC從不需要查明演算法接收了什麼指令;訴訟完全建立在不同買家針對同一商品實際被展示的價格之上。
每個定價團隊慣常訴諸的說辭恰恰與結果責任論背道而馳:我們在模型中去除了種族與收入特徵。我相信說出這句話的團隊是真誠的。但我也認為,這正是導致敗訴的辯詞。與其進行抽象辯論,我構建了一個能夠如實自我聲明此點的定價引擎,隨後對其進行了審計。該引擎是一個擁有7個價格臂(arms)的LinUCB情境多臂老虎機(contextual bandit),隨機種子設為42,在故意植入了代理變數結構的10,000名合成消費者群體上進行以收益最大化為目標的訓練。我將該虛擬零售商命名為ShopMart。沒有真實零售商接受審查,也沒有真實顧客被多收費,這正是我知曉客觀基準(ground truth)並能據此評估審計的原因。其上層的系統是一個我命名為Equity的控制台,旨在運行於零售商已有的任何定價引擎之上;在本次構建中,接受審計的引擎正是我自己的老虎機。完整執行過程請造訪veriprajna.com/demos/ai-pricing-compliance。
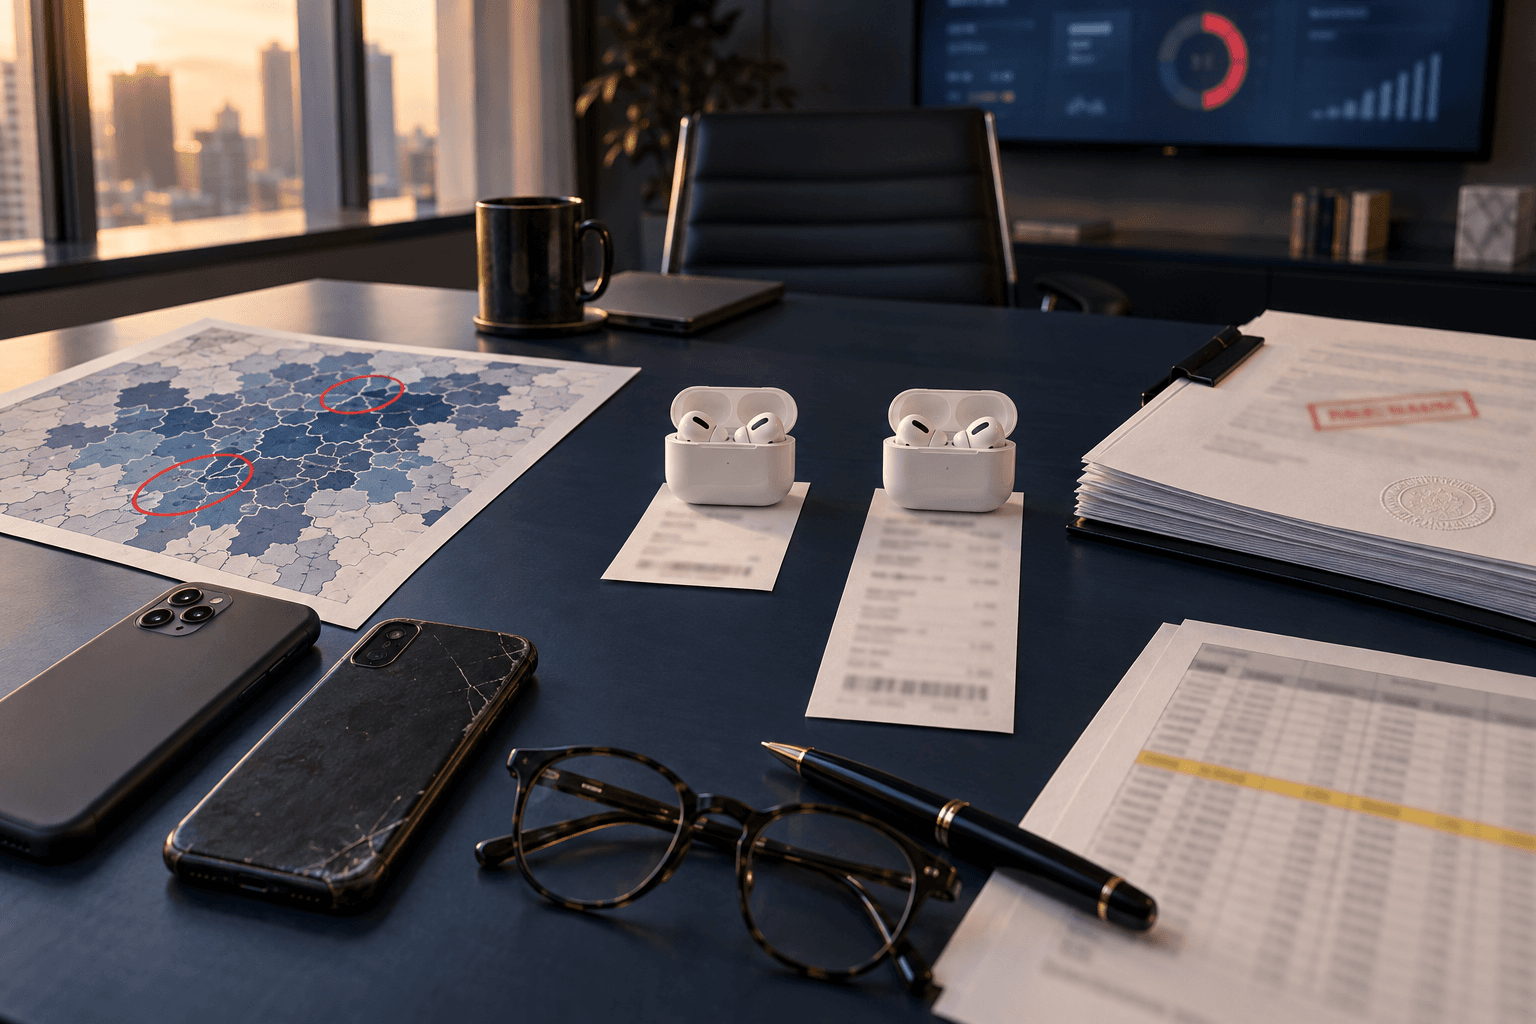
同款耳機,需求匹配,加價26%
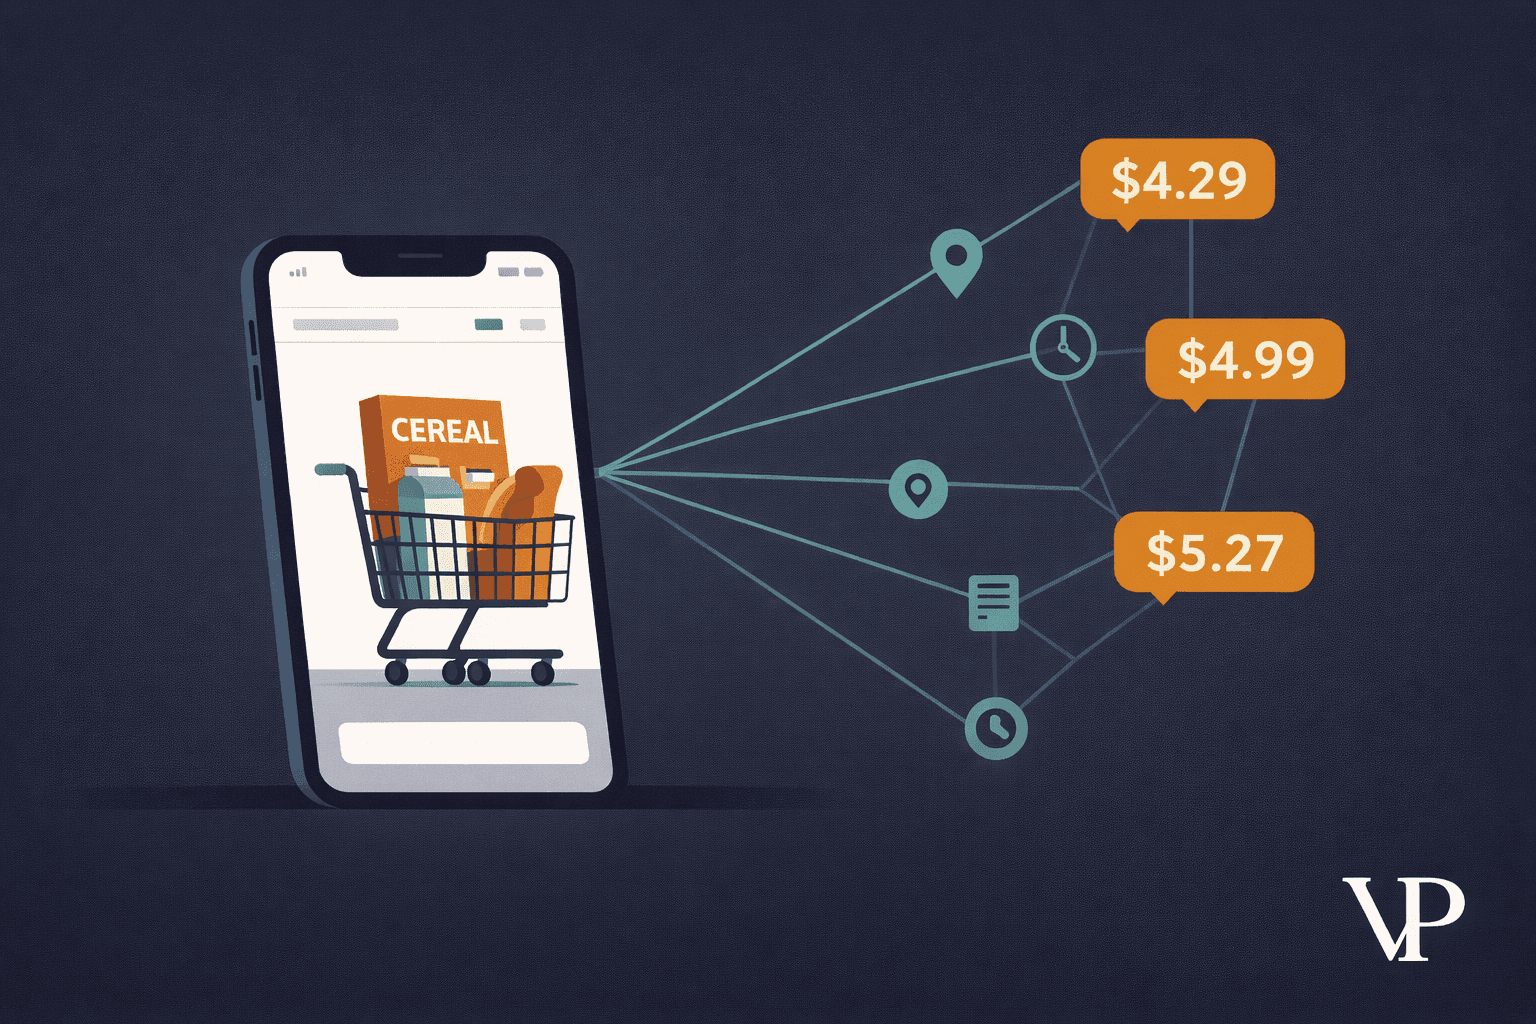
我為老虎機提供了9個輸入變數,沒有一個屬於受保護屬性:郵遞區號(ZIP)收入指數、設備檔次、引流管道、停留時間、購物車金額、回購率、會話次數、高級會員資格以及一天中的時段,外加引流管道與停留時間的交叉項。因為現實中的許多引擎包含交叉項或決策樹,我希望自己的引擎能夠具備同等能力。然後我讓它在全部10,000次決策中,為單一SKU——官方標價79.00美元的Aura Wireless Earbuds——制定價格。
控制台上的核心概覽卡是運行任何操作前螢幕上首先呈現的內容。兩個群體,同一款產品,匹配的需求信號。決策集A是高收入郵遞區號與最新設備群體(2,880次決策),在卡片上由上東區郵遞區號和新款iPhone代表:顯示價格為74.06美元。決策集B是少數族裔占多數的郵遞區號與舊設備群體(3,037次決策),由南布朗克斯郵遞區號和舊款Android手機代表:顯示價格為93.47美元。測得的差異為+26.2%。這些是基於各自約3,000次決策的群體平均值,因此這是定價策略的系統性行為,而非某位偶發消費者的運氣問題。每張卡片上的郵遞區號與手機是該群體的代表性畫像,而非其定義。
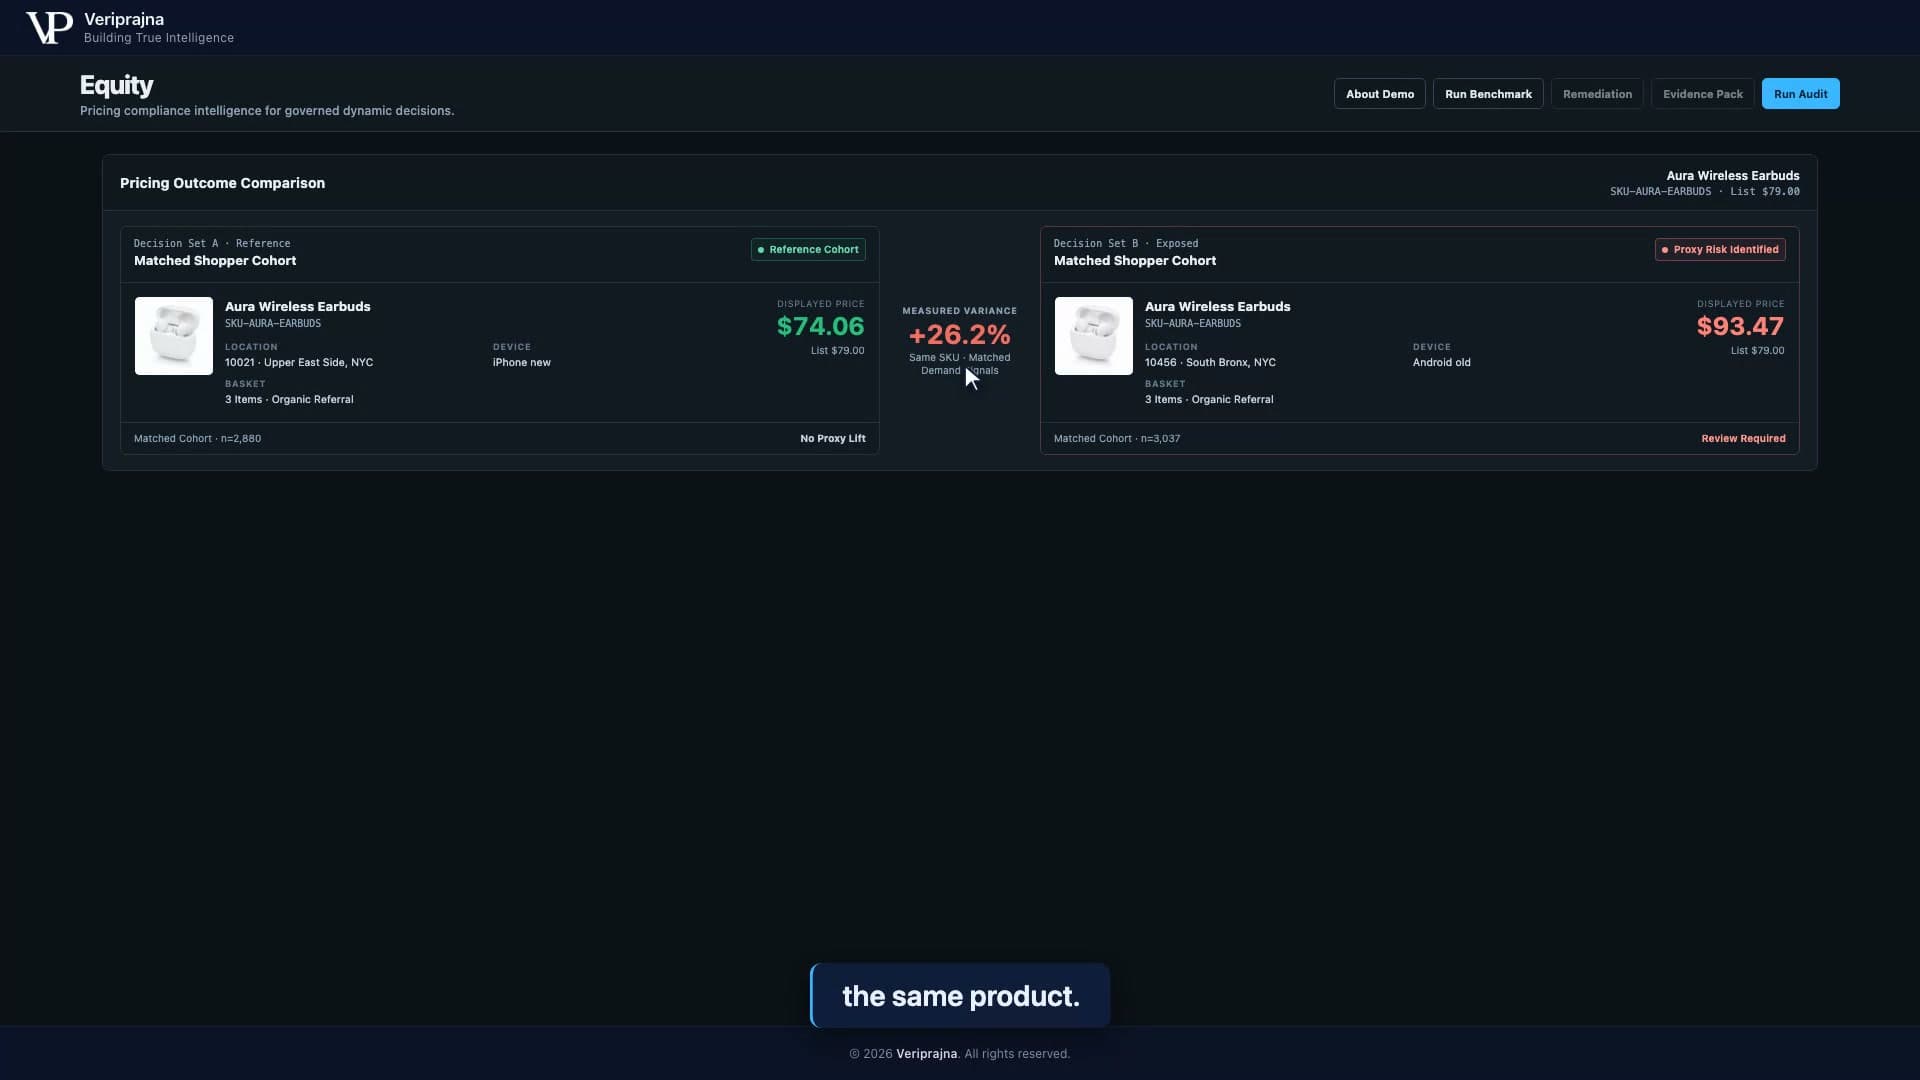
令我感到不安的是,我未曾寫過任何可以被稱為歧視性規則的代碼。我編寫了一個收益最大化程式,並向其輸入了預測支付意願的信號。郵遞區號預測收入,收入預測價格敏感度,舊款Android手機預測比價行為更少。這些都不是種族。但它們都與種族同向變動,而以收益為獎勵的老虎機會捕獲每一個關聯。當信號承載了群體資訊時,這26%就是收益最佳化的必然表現。
隱藏在兩個乾淨特徵之間的代理變數
我設計的審計方案透過三種方式評估每個輸入特徵,因為我能想到的每一個單項測試都存在漏洞:針對受保護群體的絕對皮爾森相關性(審計本身從不接收該標籤)、正規化互資訊(NMI),以及反事實價格重放。反事實重放將受保護群體的該特定輸入替換為優勢群體的參考基準值,保持所有其他輸入不變,重新運行引擎的自身策略,並衡量受保護群體的價格位移幅度。重放機制與模型無關:它透過擾動輸入並觀察輸出,因此無需在乎引擎是老虎機、決策樹還是黑盒。
Input Audit表的前兩行完全符合所有人的預測。郵遞區號收入指數:|r| 0.95,MI 1.00,反事實位移+7.8%,判定為VIOLATION。地理位置在該人群中完全編碼了受保護群體,引擎據此定價。設備檔次:0.32,0.08,+2.9%,VIOLATION,這是一個表面中立但超出了我在代碼中設定的0.30相關性閾值和0.05互資訊閾值的信號。
第三個VIOLATION是單特徵審計無法察覺的。引流管道單獨測試:|r| 0.00,MI 0.00,PASS。停留時間單獨測試:0.17,0.03,PASS。單特徵審計會放行這兩項並繼續。引流管道×停留時間的交互項讀數為:|r| 0.00,聯合互資訊為0.73,反事實位移+1.7%,VIOLATION。這相比最佳單項特徵產生了0.71的交互增益。
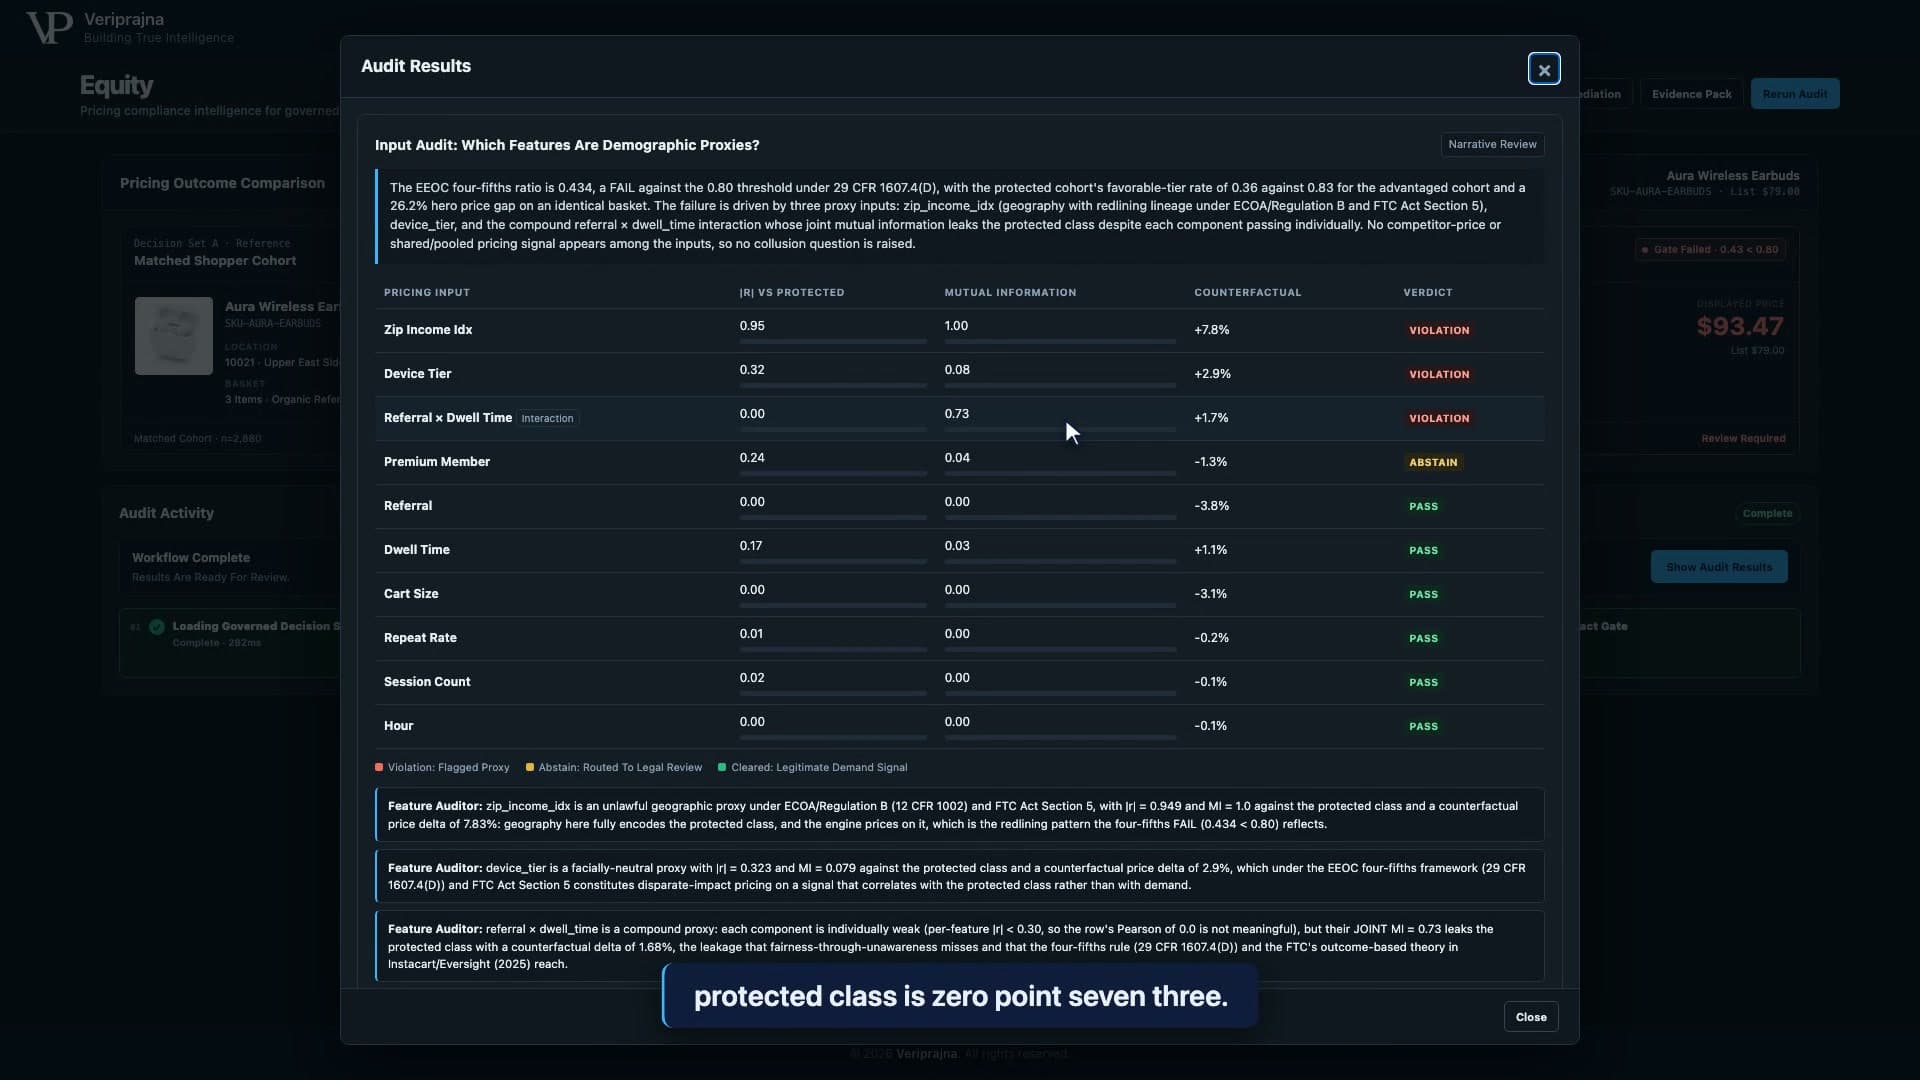
我以互斥或(XOR)邏輯閘方式植入了這種結構。自然搜尋且長停留時間標記了受保護群體。比價管道且短停留時間同樣標記了受保護群體。自然搜尋配短停留、比價管道配長停留則標記了優勢群體。無論是引流來源還是停留時間單獨都無法區分群體;唯有兩者結合才能區分。相關性分析作為單列工具對此視而不見。雙變數聯合互資訊則洞若觀火。逐個審計輸入特徵的合規程序審計的是錯誤的對象,而如果不構建一個單特徵分析確定性失效的受控群體,我無法證明這一點。
我曾經也會採用的辯護策略
我測試了自己以往面對監管機構時也會提出的抗辯,即不知情下的公平性(fairness through unawareness):移除郵遞區號和設備特徵,重新訓練引擎,回報結果。我知道複合代理依然存在。我不知道的是,在0.43的比例中,究竟有多少僅由郵遞區號和設備導致,又有多少源自隱藏的交互對。去除郵遞區號和設備並重新訓練後,五分之四比例從0.43上升到0.59。仍然不合規,而遺留的差距正是逃避單特徵審計的部分。基準卡用四個詞直指根源:Compound Proxy Still Leaks。
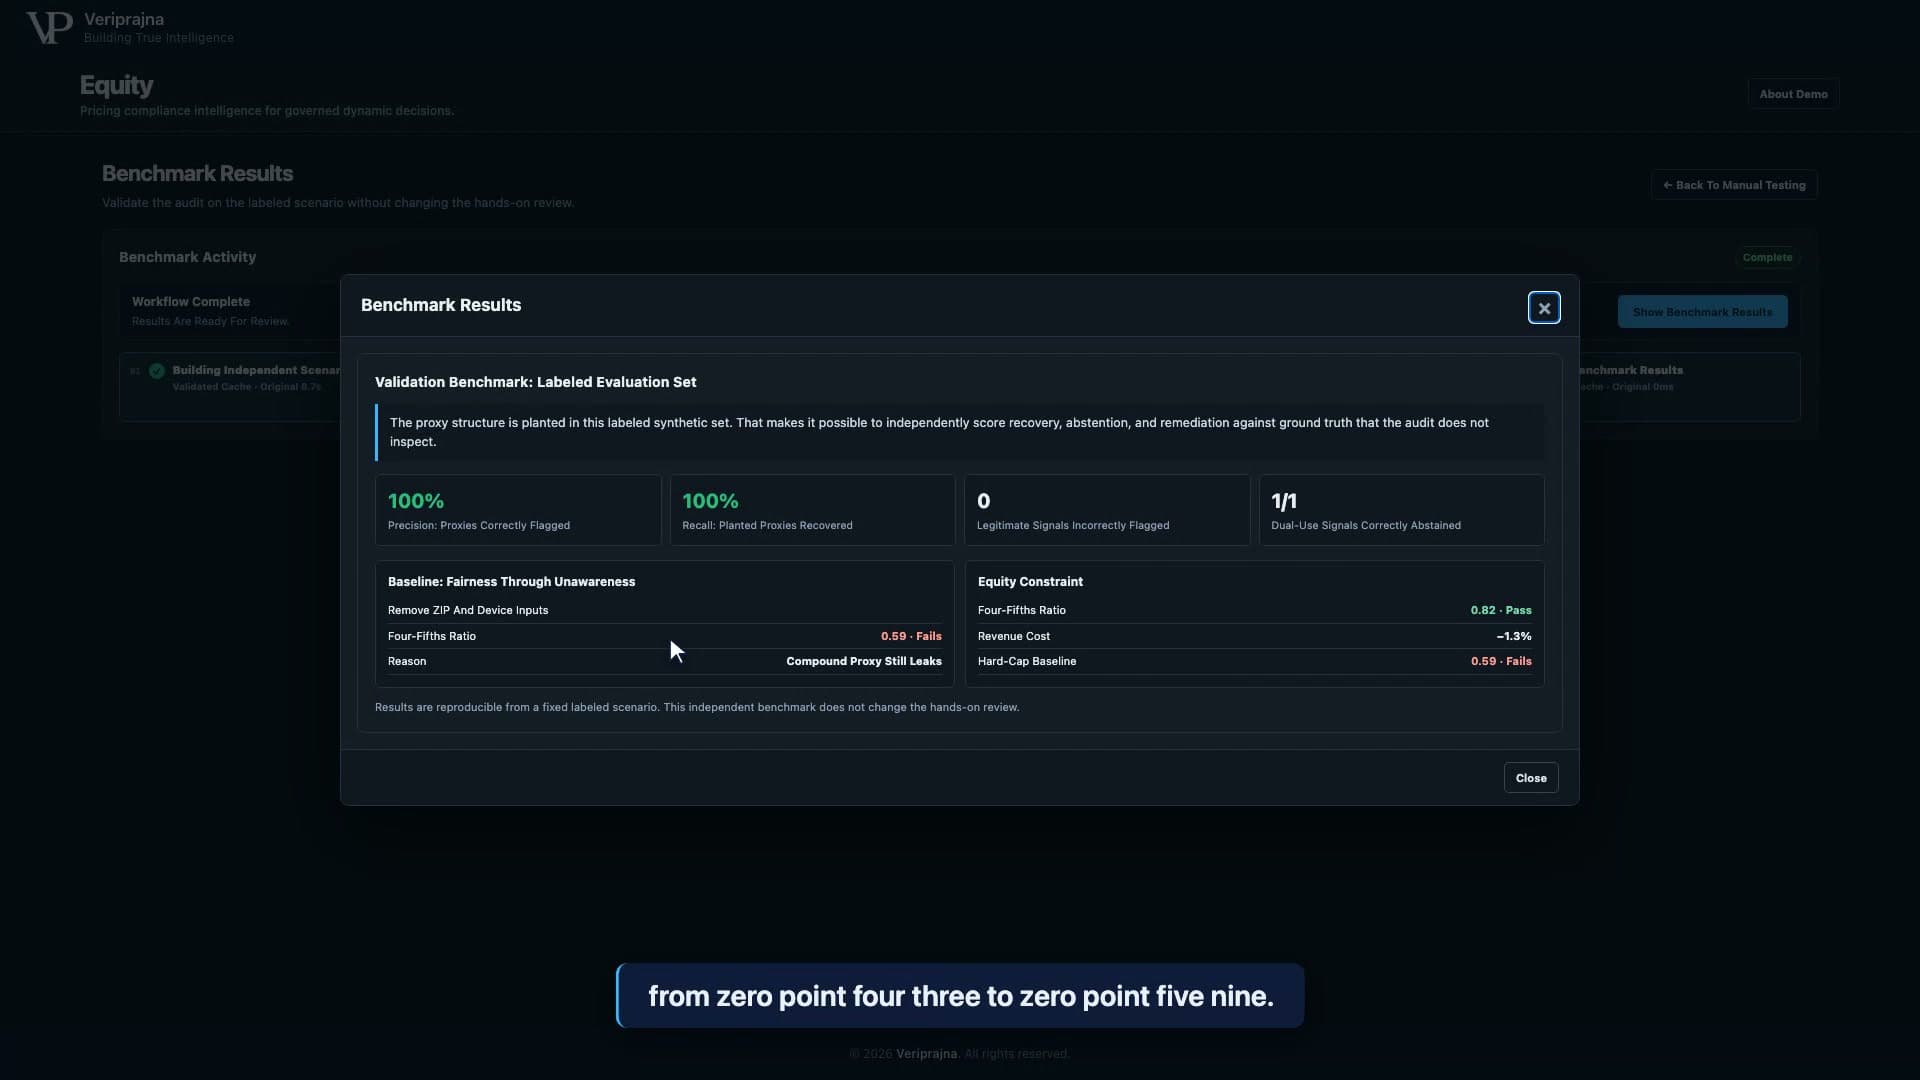
這一結果徹底改變了我對那句辯詞的理解。引擎透過兩個在單列測試中完全合格的信號,依然鎖定了該群體,並且會一直鎖定下去——因為找出這一關聯正是收益最大化演算法獲得獎勵的原因。主張不知情對團隊而言沒有任何成本,但卻交出了一個他們日後必須在法庭上解釋的數據。
卡片上的100%具有嚴格界定的含義。該基準重建了種子為42的同一人群,並針對我植入的標籤對審計進行評分,因此100%的精確率與召回率意味著在帶標籤的合成資料集上以零誤報識別出全部3個預埋代理。這是針對已知基準的自我驗證,我不會將其援引為真實企業定價日誌中的準確率,因為真實日誌存在著合成環境中無法模擬的複雜混淆變數。
0.43的含義以及為何不由模型做出判定
我拒絕捏造一套自創的內部合規指標,因為自製指標沒有理由得到監管機構的認可。Equity中的准入標準是一項外部法定標準:EEOC五分之四規則(29 CFR 1607.4(D)),已從錄取率適配至價格階梯。在此,有利待遇意味著未被分配至最高價格檔。在交付的原始引擎中,36%的受保護群體獲得了優惠檔位,相比之下優勢群體則有83%。0.36除以0.83得出0.43,法定門檻為0.80,儀表板亮紅燈顯示Fail。旁邊標明:受保護群體中有64%被置於最高價檔,相比優勢群體的平均溢價高達+15.6%。
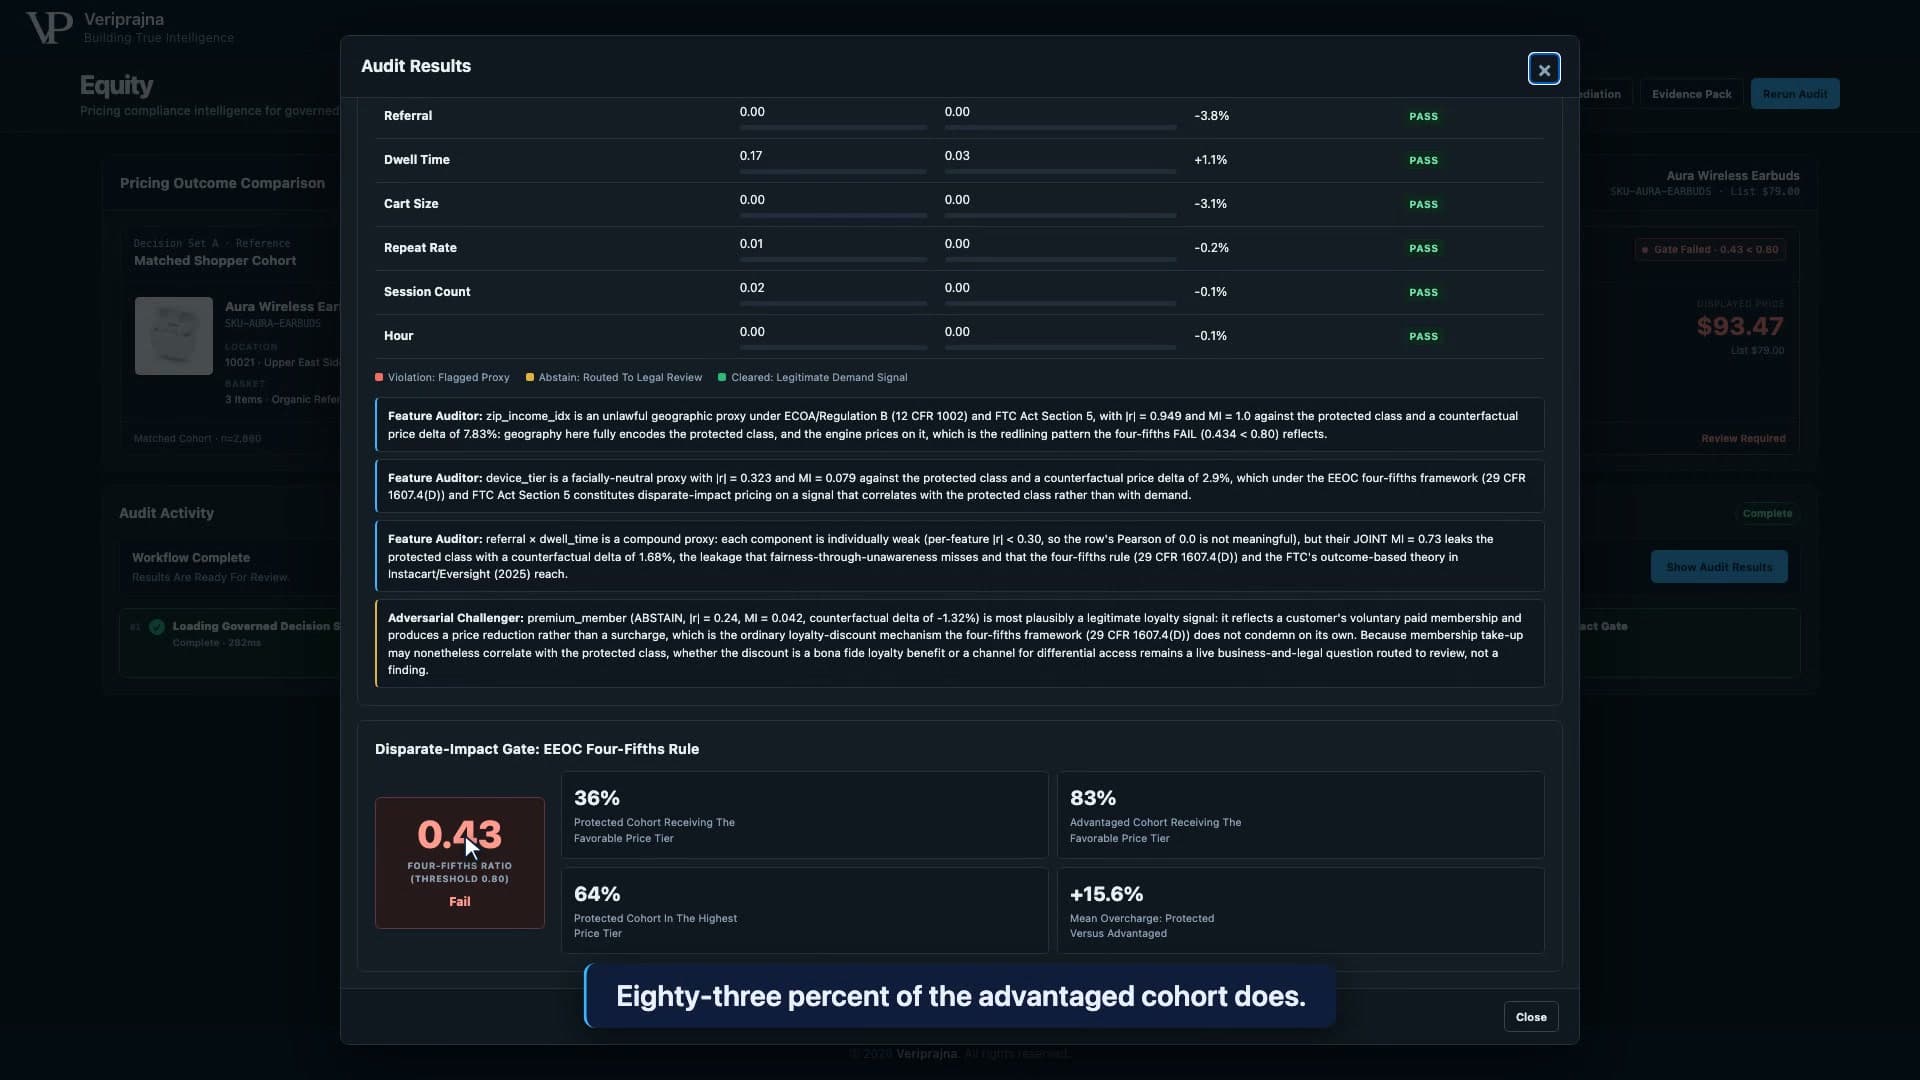
判定邏輯完全基於純NumPy在智慧體層之外運行,遵循可以向法官逐項宣讀的固定順序。雙重用途信號在違規測試前優先接受評估:高級會員特徵與受保護群體的相關性為0.24,同時也是合法的忠誠度指標,因此代碼返回ABSTAIN並交由法務審查,而不是草率認定違規或直接豁免,且下游流程一律不得將其擅自提升為違規。隨後依次是違規閾值檢測、棄權區間判定,最後是PASS。購物車金額、回購率、會話數和時段全部合格。審計系統絕非盲目全盤亮紅燈,而一個逢檢必疑的審計在民事調查要求(CID)面前,就如同一個一無所獲的審計一樣毫無價值。
團隊中的智慧體(特徵審計員與對抗質詢員)負責撰寫論證文本;架構中設定的第三個角色監管映射員,在本次構建中是一張固定查找表而非大模型。質詢員的職責是竭力為棄權特徵陳述忠誠度利益辯護,並在介面上即時呈現。但它無法篡改0.24的數據,無法改動判定結果,也無法裁定0.43是否低於0.80。我在初始階段就劃定了紅線:智慧體提供建議,代碼做出裁決。模型可以針對禁止其觸碰的數據盡情發揮其說服力。
我曾寄予厚望的修復方案
我嘗試的第一個修復方案是價格上限,因為這是每個定價團隊本能採取的措施:絕不允許價格高於公平參考價的15%。我將其作為Hard-Cap Baseline實現,預期它會是一個穩妥平庸的方案。它導致了0.2%的收益損失,並在合規門控中以0.59不合格。卡片上的博弈特徵揭示了原因:29%的受保護群體被精準定價在上限閾值的1%以內。判定結果顯示為Gamed To The Boundary。價格上限之所以低成本,正是因為引擎將受影響群體重新定價在了臨界線下方——而在預算會議上頗具吸引力的低成本違規方案,根本經不起法庭證據開示程序的檢驗。
收益最大化系統會將價格上限視為衝刺目標。
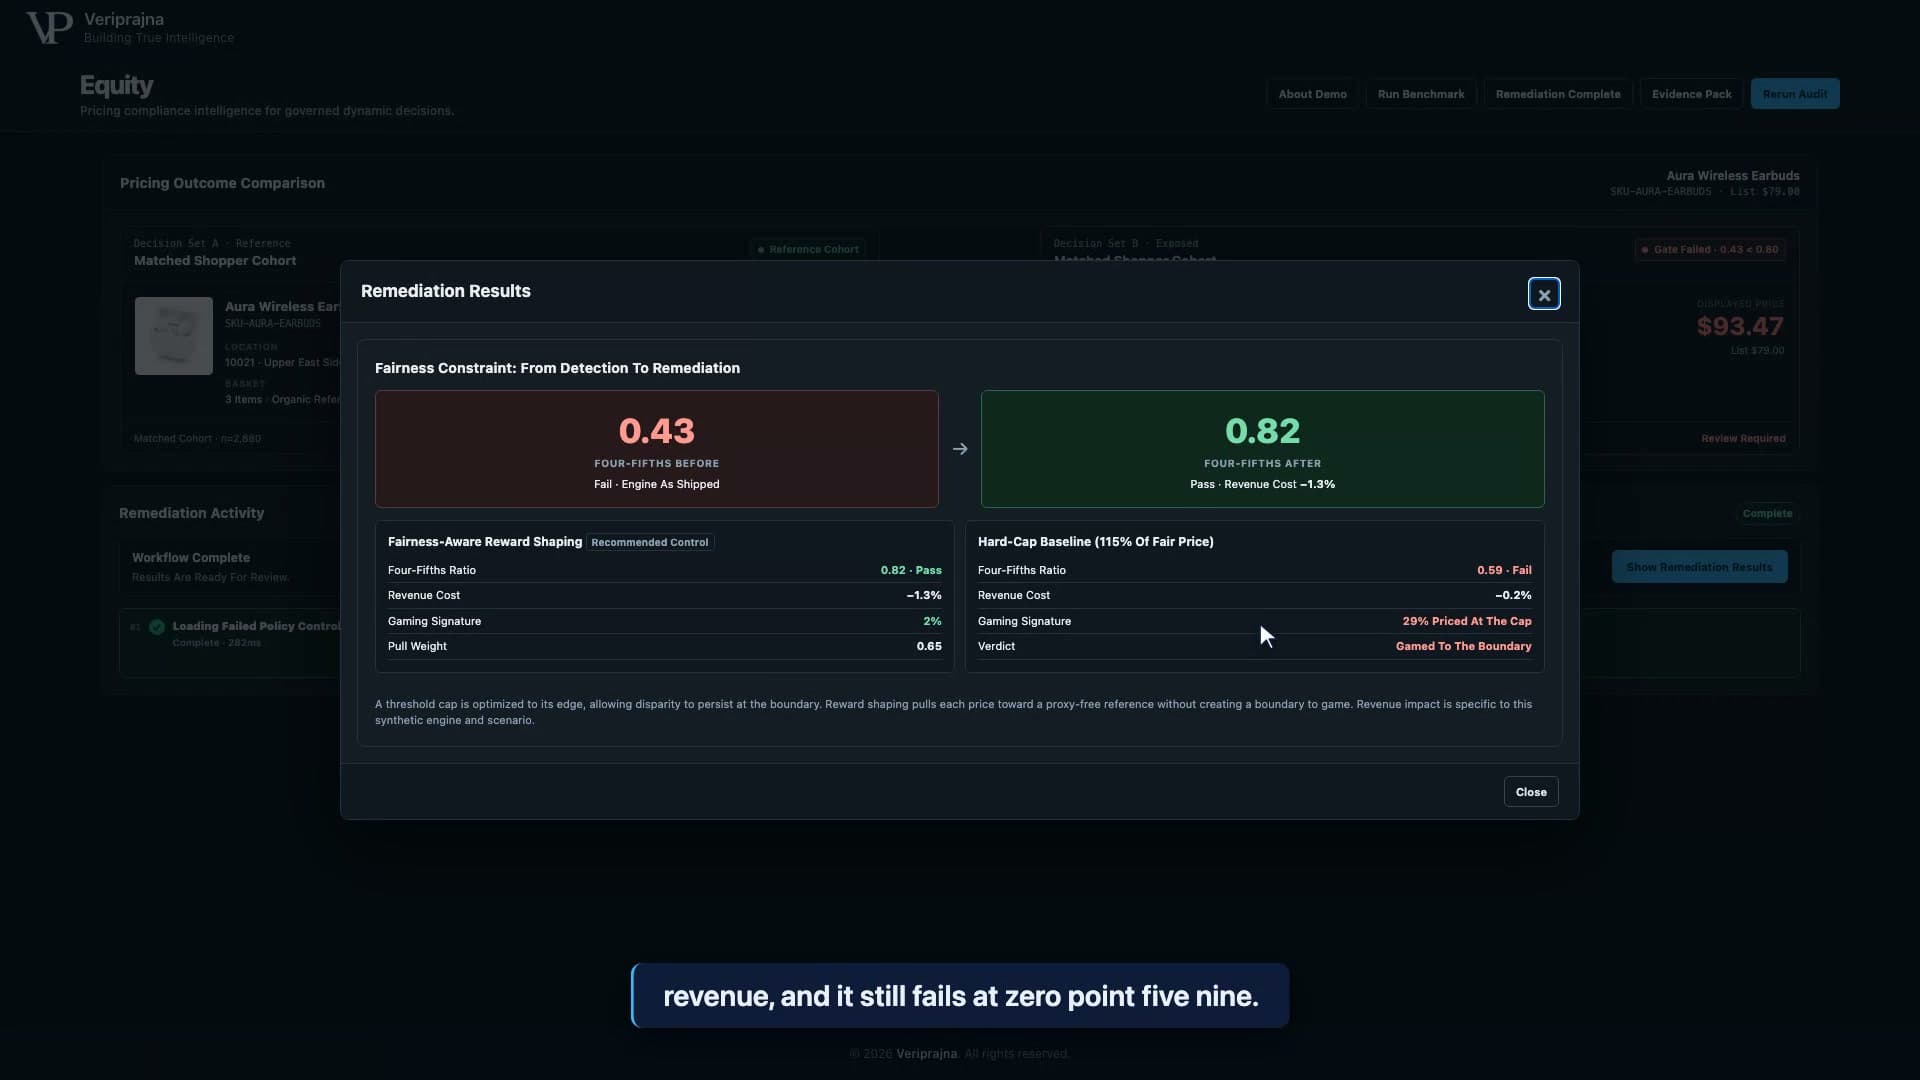
真正奏效的控制機制是公平感知獎勵塑形(Fairness-Aware Reward Shaping)。它沒有設置生硬的截斷邊界,而是將所有價格持續拉向無代理參考基準價(透過剝離代理特徵、僅保留合法信號訓練出的第二個老虎機),並透過二分搜尋求出超過0.80紅線的最小牽引權重。在該引擎上該權重為0.65;若低一檔設為0.625,比率僅能達到0.778。整改後的五分之四比率為0.82,判定Pass。收益成本為1.3%。博弈特徵僅為2%,因為不存在可以鑽營的斷崖邊界。控制台底部的說明指出收益影響為該合成場景特定值,我也在此再次強調:1.3%只是單個受控群體的測算數據,絕不可作為實現演算法公平的通用對價對外宣傳。
審計檔案的真正用途
我最後構建證據合規包,是因為前面的一切只有在律師能夠正式立案呈堂時才有意義。當民事調查要求(CID)送達時,未能合規記錄關鍵數據的企業將耗費數月進行數位鑑識級數據抽取。Equity將審計產出密封為一個包含可列印HTML版本的JSON憑證包:引擎名稱與版本、審計的10,000次決策、合規門控、典型差距、每個輸入的審查結論與依據、整改結果,以及作為防篡改雜湊的憑證包正文SHA-256摘要。每個VIOLATION均映射到五部法典框架:EEOC五分之四規則、紐約州演算法定價揭露法(2025年11月10日生效,單次違規民事罰款最高1,000美元)、科羅拉多州AI法案(SB 24-205,2026年6月30日生效)、歐盟AI法案第13條與第14條(2026年8月2日起施行高風險義務),以及FTC法案第5條。棄權輸入對應單項法務複核流程。
法規映射是一張靜態查找表。委託模型撰寫分析是很容易的,但我明確拒絕了這一做法:每個VIOLATION必然獲得完全相同的五條法規引註,棄權項對應一條審查標註,整個映射環節不生成任何自由文本。擅自推論法條適用性的模型在下一個版本就會改變其論證邏輯——而法規對齊隨著模型漂移的憑證包,在監管專家面前不堪一擊。憑證包內的說明由模型生成並快取;數字、裁決和法律引註則由確定性代碼鎖死。無論底層模型如何更迭,該證據包始終保持法庭呈堂有效性。完整的系統拆解及憑證包螢幕示範請參閱veriprajna.com/demos/ai-pricing-compliance。
Veriprajna不制定價格,不取代Pricefx、PROS、Zilliant或Competera,也不出具法律判決。客戶的引擎繼續運算價格。我提供客觀堅實的證據鏈,由客戶的法務團隊做出決策裁量。
如果您更傾向於觀看實際審計運行而非閱讀文字敘述,這裡呈現了端到端的全流程操作。
我一次又一次回到定價團隊常說的這句話,因為它確實是事實:模型中沒有種族和收入特徵。但在我構建的引擎中,這句屬實的話語旁邊,並存著同一副耳機上26%的價差、0.43的紅燈門控,以及一個貌似有效實則破產的價格上限。沒有人告知引擎買家的身分。一個收益獎勵函數就足夠了,因為揣測買家身分是利潤最高的估算途徑——而審計精確測定了這一揣測到底走得有多遠。真正能在法庭上立足的辯詞要嚴苛得多:我們清楚引擎在未經告知的情況下依然能找出特定群體,我們測定了其偏離的幅度,這就是我們為了遏制它所付出的代價。