人臉識別預警得分為0.83:我構建了將其攔截的關卡

FaceFirst原始得分為0.83,無法為芝加哥的一起合成人臉識別預警確立同意基礎,因此確定性策略關卡將其攔截。我構建該場景是為了檢驗:生物識別系統究竟是將治理視作決策內在的一部分,還是視作決策早已推進之後才追加的文書手續。
該預警編號為LP-0834,是芝加哥地區一個特意設定的合成場景。它不是客戶實際事件,不是實時攝像流,也不是任何真實個人的案例。測試樣本是一張80像素的低光照抓拍圖,與一張15年前的入案登記照進行比對。FaceTrust將原始得分校準至0.50,置信區間為[0.217, 0.783],其93%保形預測集同時包含{mate, no_mate}。但決定性的事實更為純粹:沒有存檔的同意記錄,因此確定性策略關卡依據演示中植入的BIPA規則攔截了該次掃描。
我不斷回溯這一先後順序。模型可以提供證據。但它絕不能因為自身得分看似誘人,就有權認定可以忽略缺失的法定理據前提。
這裡的完整拆解展示了操作介面、影片演示以及底層機制的運行方式。以下是我在構建過程中汲取的更深刻教訓:如果一項控制措施只能在事後解釋錯誤行動,那麼它來得太遲了。
我原本以為0.83意味著什麼
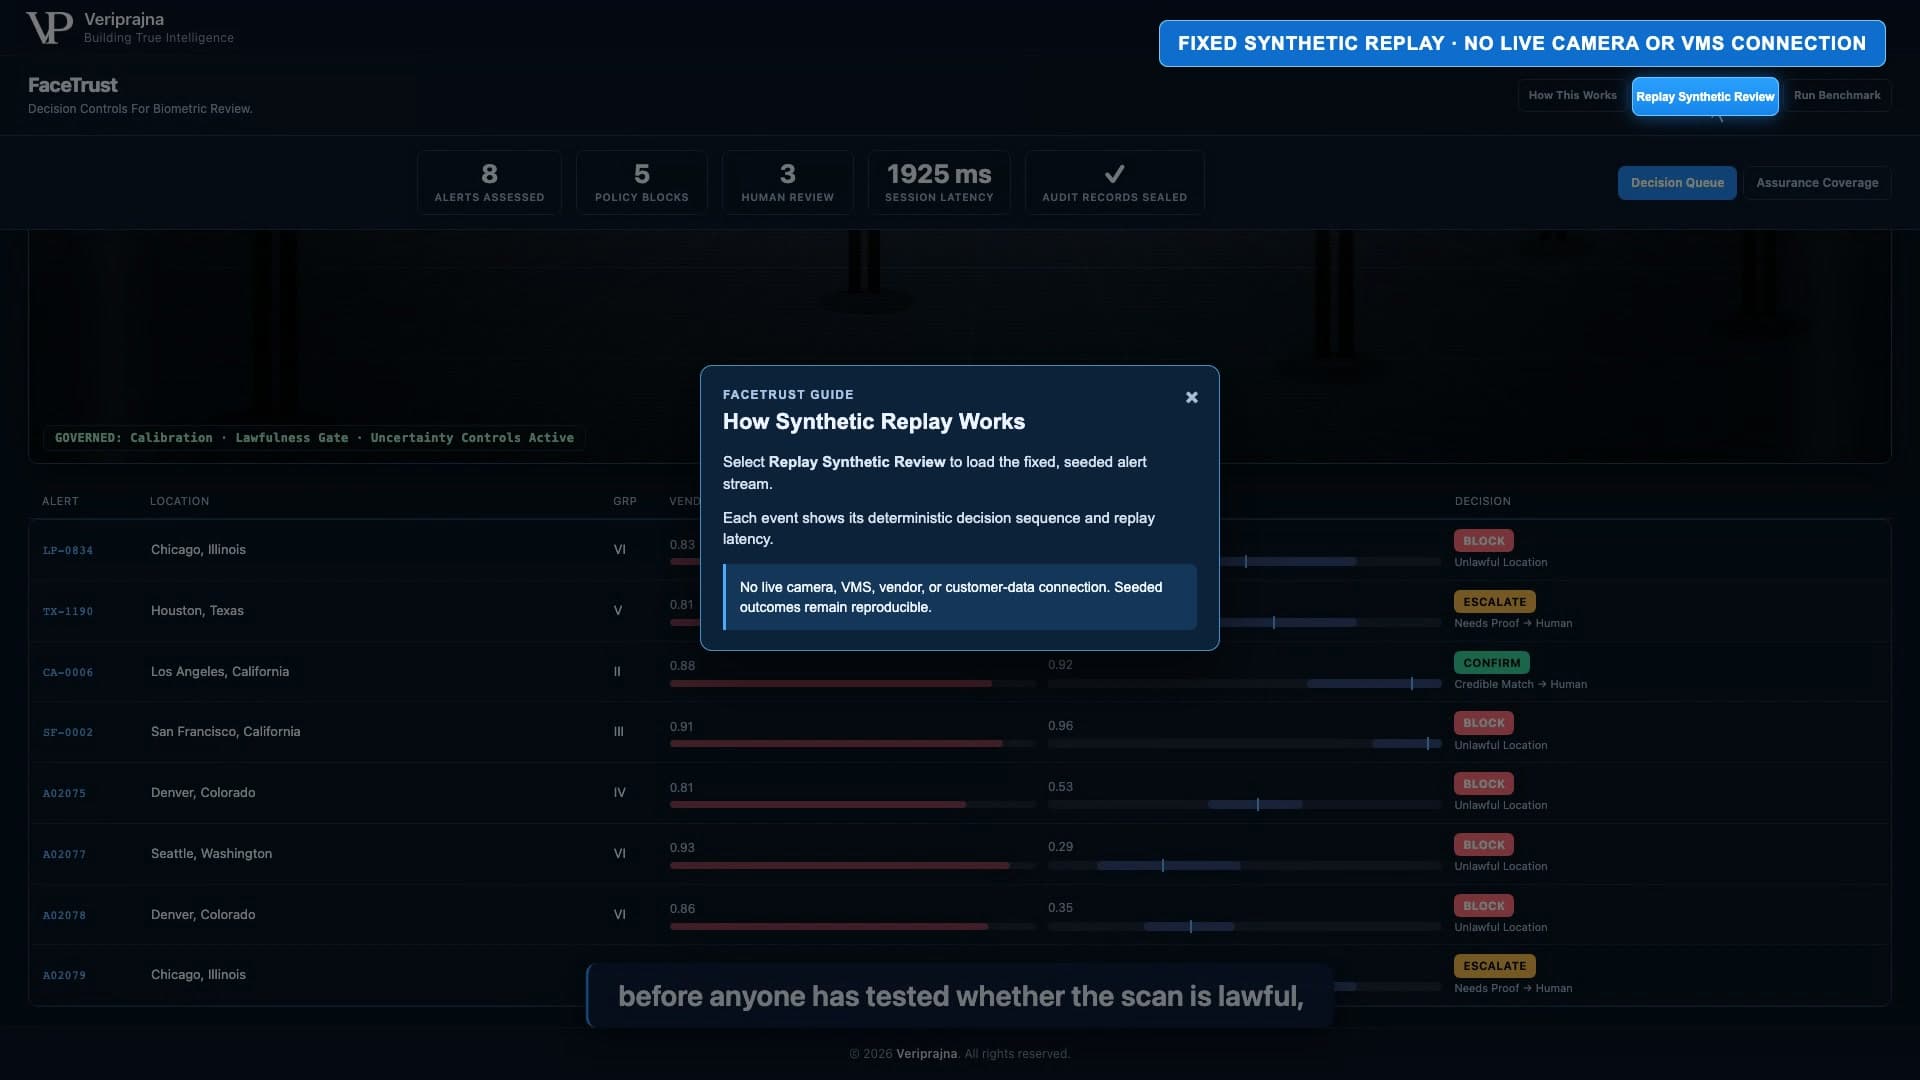
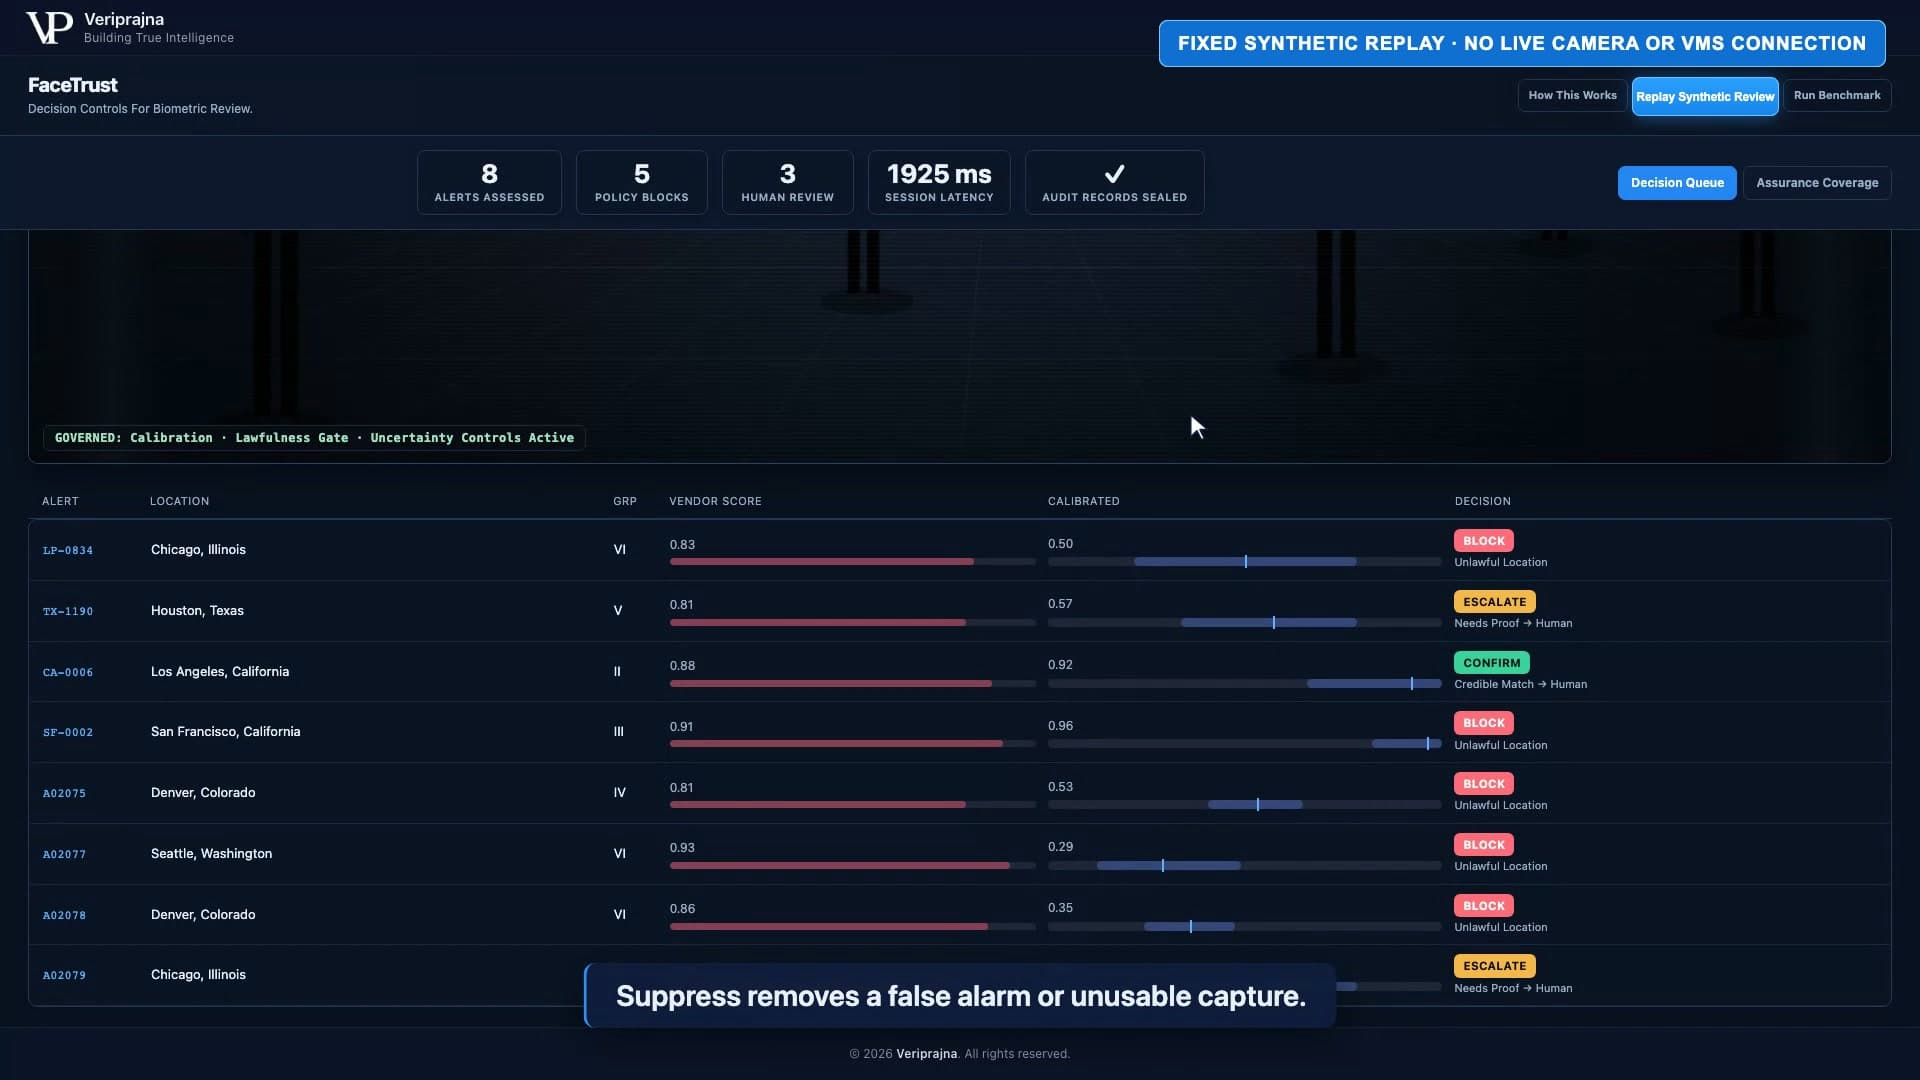
我最初是從那個數字著手的,因為目光總會不由自主落向那裡。在植入隊列中,LP-0834與其他原始得分在0.81至0.91之間的預警並列排布。瞥上一眼,它們就像同類事物的不同變體:等待業務響應的高確信度匹配。這個隊列激發了我自身先排名、後質疑的下意識反應。
而這種下意識反應恰恰是我希望剖析的對象。供應商的原始得分僅代表單一識別系統的輸入值。它並不能告訴我信息採集是否獲得許可,抓拍質量是否足以支撐眼下的裁決,或者校準結果周圍的不確定性是否依然涵蓋非匹配情形。然而,一個精確到兩位小數的分數往往給人一種塵埃落定的錯覺。其視覺上的精確性超越了其決策權威性。
我發現相鄰的幾行數據極具價值,因為它們粉碎了制定簡單規則的幻想。TX-1190的原始得分為0.81,由於其校準後的證據尚未決斷,因而被路由至ESCALATE。CA-0006的原始得分為0.88,被路由至CONFIRM,這意味著合格的審查員可以介入行動,但絕不代表系統可以自動對任何人採取指控。SF-0002在四者中擁有最高的原始得分0.91,卻依然被路由至BLOCK,原因在於預置的管轄區域表中將舊金山的人臉識別列為禁用類別。
這些數據行在設計上是合成的,但設計本身所探討的問題卻極為具體:什麼資訊被允許推翻該分數?如果答案是「沒有任何資訊」,那麼周圍的合規流程不過是裝點門面的花瓶。如果合法性與不確定性規律能夠在預警傳遞給一線團隊之前改變路徑,治理才真正具備了執行力。
高分可以強化證明力度。但它無法創設同意,也無法撤銷法律禁令。
分數失控的時刻
我打開LP-0834的檔案卷宗,原本以為校準面板會佔據主導地位。0.83的原始得分驟降為0.50的校准後匹配概率。置信區間橫跨0.217至0.783,預測集涵蓋了兩種可能的標籤分類。該證據不支援確定性結論。
隨後我的目光移向面板下方的同意審查結論。正是這裡鎖定了最終路徑。抓拍圖像為80像素,高出演示所設定的72像素最低門檻。入案照已有15年歷史,卷宗將其列為審查與審計標識,但未將其作為獨立的路由阻斷關卡。缺失同意則完全不同:它直接觸發BLOCK。
我對這種先後層級體系的糾結超出了自身預期。校準在數學上十分迷人,置信區間顯得精深高級。但如果我任由不確定性敘事主導,就會帶來一種風險,誤讓人以為更理想的概率可以補救這次掃描。它無法挽救缺失的前提條件。確定性策略關卡必須完全獨立於模型的置信度來評估行動的合法性。
這徹底改變了我向自己闡釋該產品的方式。FaceTrust展示的是Biometric Decision Firewall。它不是又一款人臉識別引擎。一個樁化的供應商適配器負責對預警進行歸一化,本地校準器量化不確定性,而確定性控制機制則在BLOCK、SUPPRESS、ESCALATE與CONFIRM之間做出裁決。合規審查員可以在這些結構化事實確立後起草易讀的備忘錄,但它無法掌控路由走向。在本次演示中,該備忘錄是預先生成並快取的,或者派生自確定性備用模板。
我之所以希望這種界限清晰可見,是因為大語言模型極擅長生成聽起來無懈可擊的說辭。然而,一份邏輯嚴密的備忘錄並不等同於合法依據。建議屬於透過可審查規則確定路徑之後的事項,絕不能作為替代規則的說服工具置於前端。
我必須停止將校準視作最終判決
我過去總希望單一的校準概率能承擔超出其負荷的作用。那是我在構建初期走入的思想誤區:用更優的分數取代原始分數,再把這個更優的分數直接當成決策。LP-0834打破了這種走捷徑的幻想,因為即便是0.50的測算結果,依然需要置信區間、預測集、同意審查、管轄區判定以及圍繞任何獲准行動所設的人工規程。
93%保形預測集之所以關鍵,是因為它重塑了系統的判斷語彙。當集合同時包含{mate, no_mate}時,FaceTrust不會將模糊性強行壓縮為武斷的確信標籤。它可以將合法但懸而未決的預警路由至ESCALATE。當證據明確排除匹配時,它可以實施SUPPRESS。而當集合僅包含{mate}時,CONFIRM路由依然嚴格代表訓練有素的審查員行動,絕非自動化的當面盤查、羈押或指控。
我從隊列檢視切換到了統計保障檢視,因為單個檔案卷宗無法解答覆蓋率問題。在包含3,000個預警的確定性合成留出測試集上,標稱93%的保形集合在評估的六個Fitzpatrick膚色分類組別中,均達到了至少91.5%的經驗覆蓋率。而原始基準的最低覆蓋率僅為40.6%。系統介面清晰展示了跨六個受評估Fitzpatrick組別的留出覆蓋率情況。
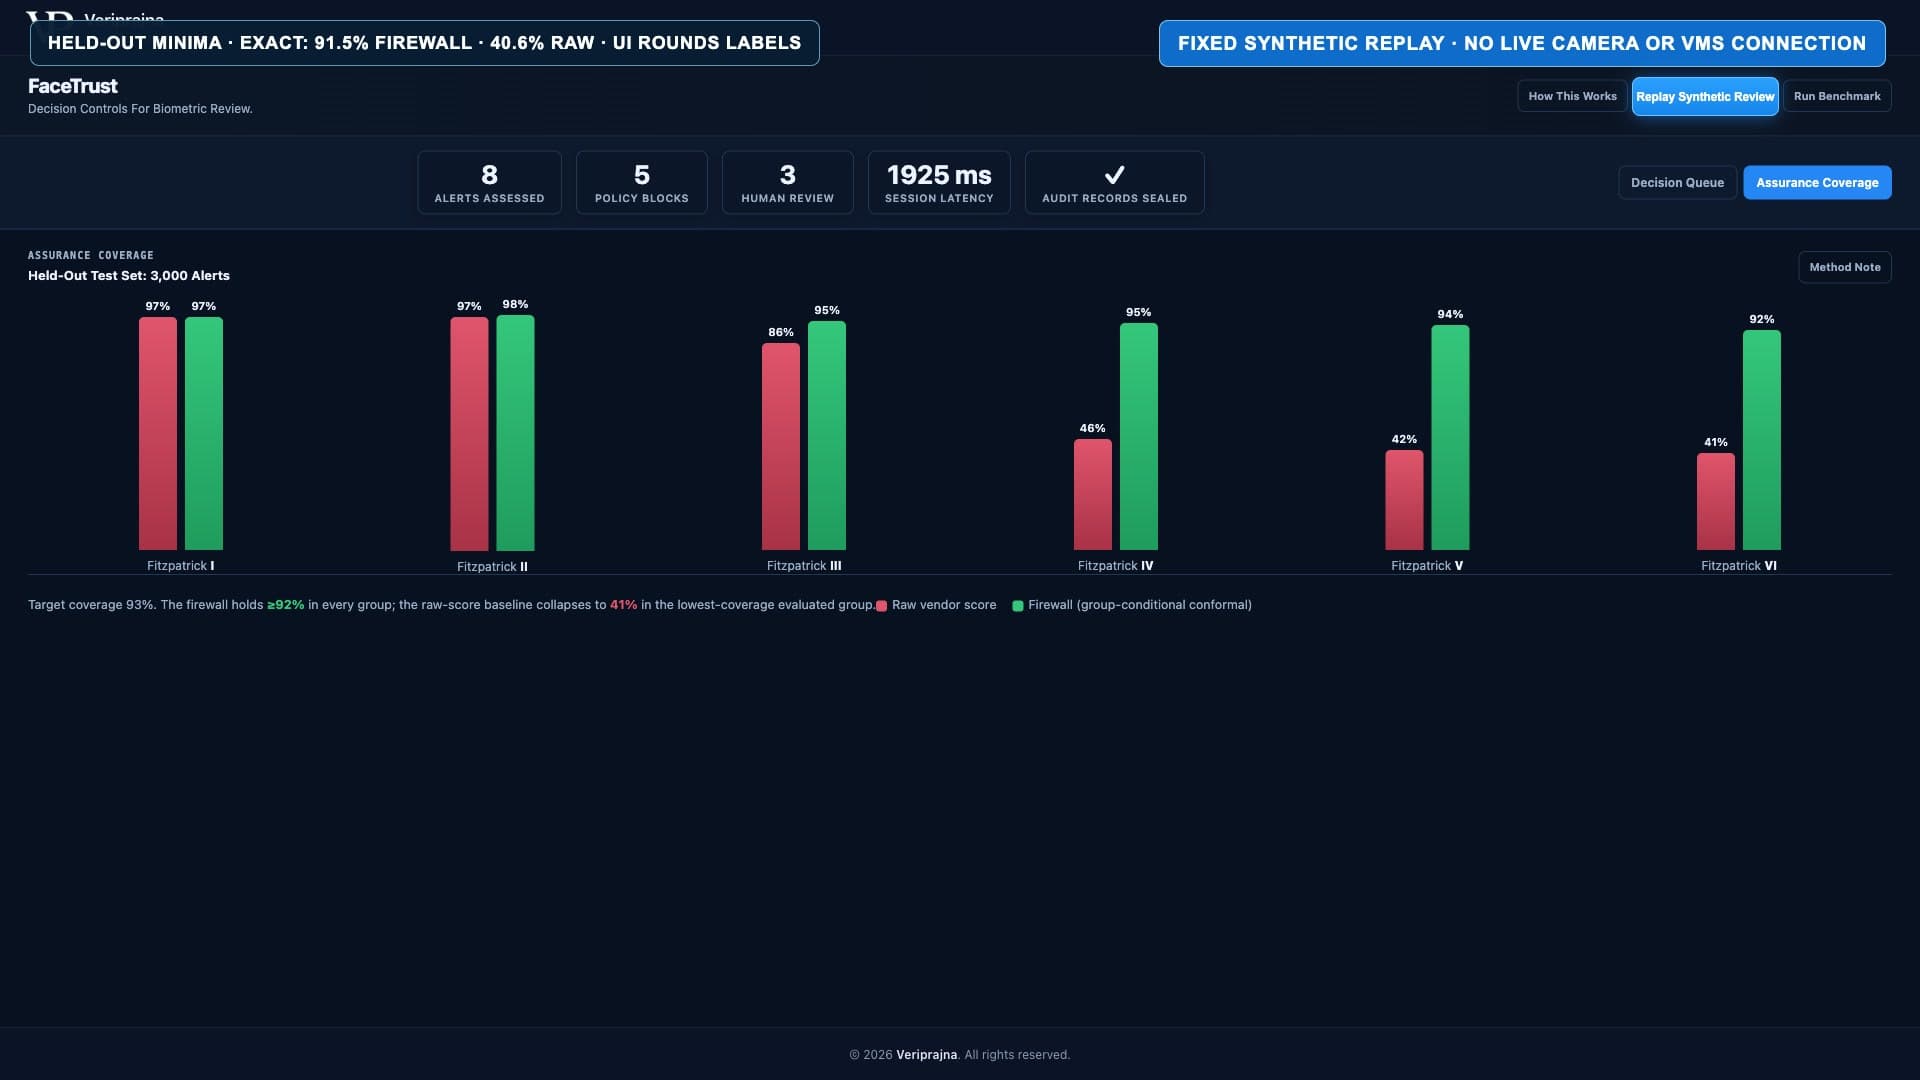
這些數據並不代表生產環境下的效果宣稱。測試集是合成構建的,旨在模擬已被記錄的典型失效模式,而生產級校準則必須依賴客戶經過仲裁裁決的歷史數據。我之所以列出該結果,是因為它指明了我們應當審查的重點,而非盲目迷信綜合得分:最脆弱的受評估群體,在既定的測試設計規範與劃定的適用邊界之下。
該圖表同樣抑制了我盲目慶祝標稱目標的衝動。93%的目標並不意味著每個群體都能恰好落在93%,更不意味著系統在開放現實世界中擁有93%的準確度。這套展示賦予我的是一種覆蓋率診斷工具,而不是脫離合成測試集進行無節制推廣的許可證。
只有當業務流被允許因不確定性的存在而做出差異化處置時,不確定性才真正具備價值。
重放測試讓運營代價直觀顯現
我運行了固定的合成重放測試,以觀察該層級機制在工作流規模下的實際表現。在涉及的全部364起預警中,原始閾值會直接引發303起當面盤查行動。而防火牆機制則轉化為121條人工審查路徑並堅決攔截了179起預警,按該重放的統計口徑實現了60.1%的縮減率。這一縮減屬於該植入的重放測試,不應被視作客戶實際部署效果或生產環境承諾。
我並未將此結果解讀為「自動化承擔了更多工作」。事實上,該架構的核心價值恰恰在於它拒絕將最終的人性化後果全盤自動化。它排除了禁止或未經同意的掃描,壓制了排除匹配的證據,並將存疑或可信的個案引入嚴格界定的人工審查軌道。業務重心的轉變體現為從分數主導的慣性轉向特定路徑的責任。
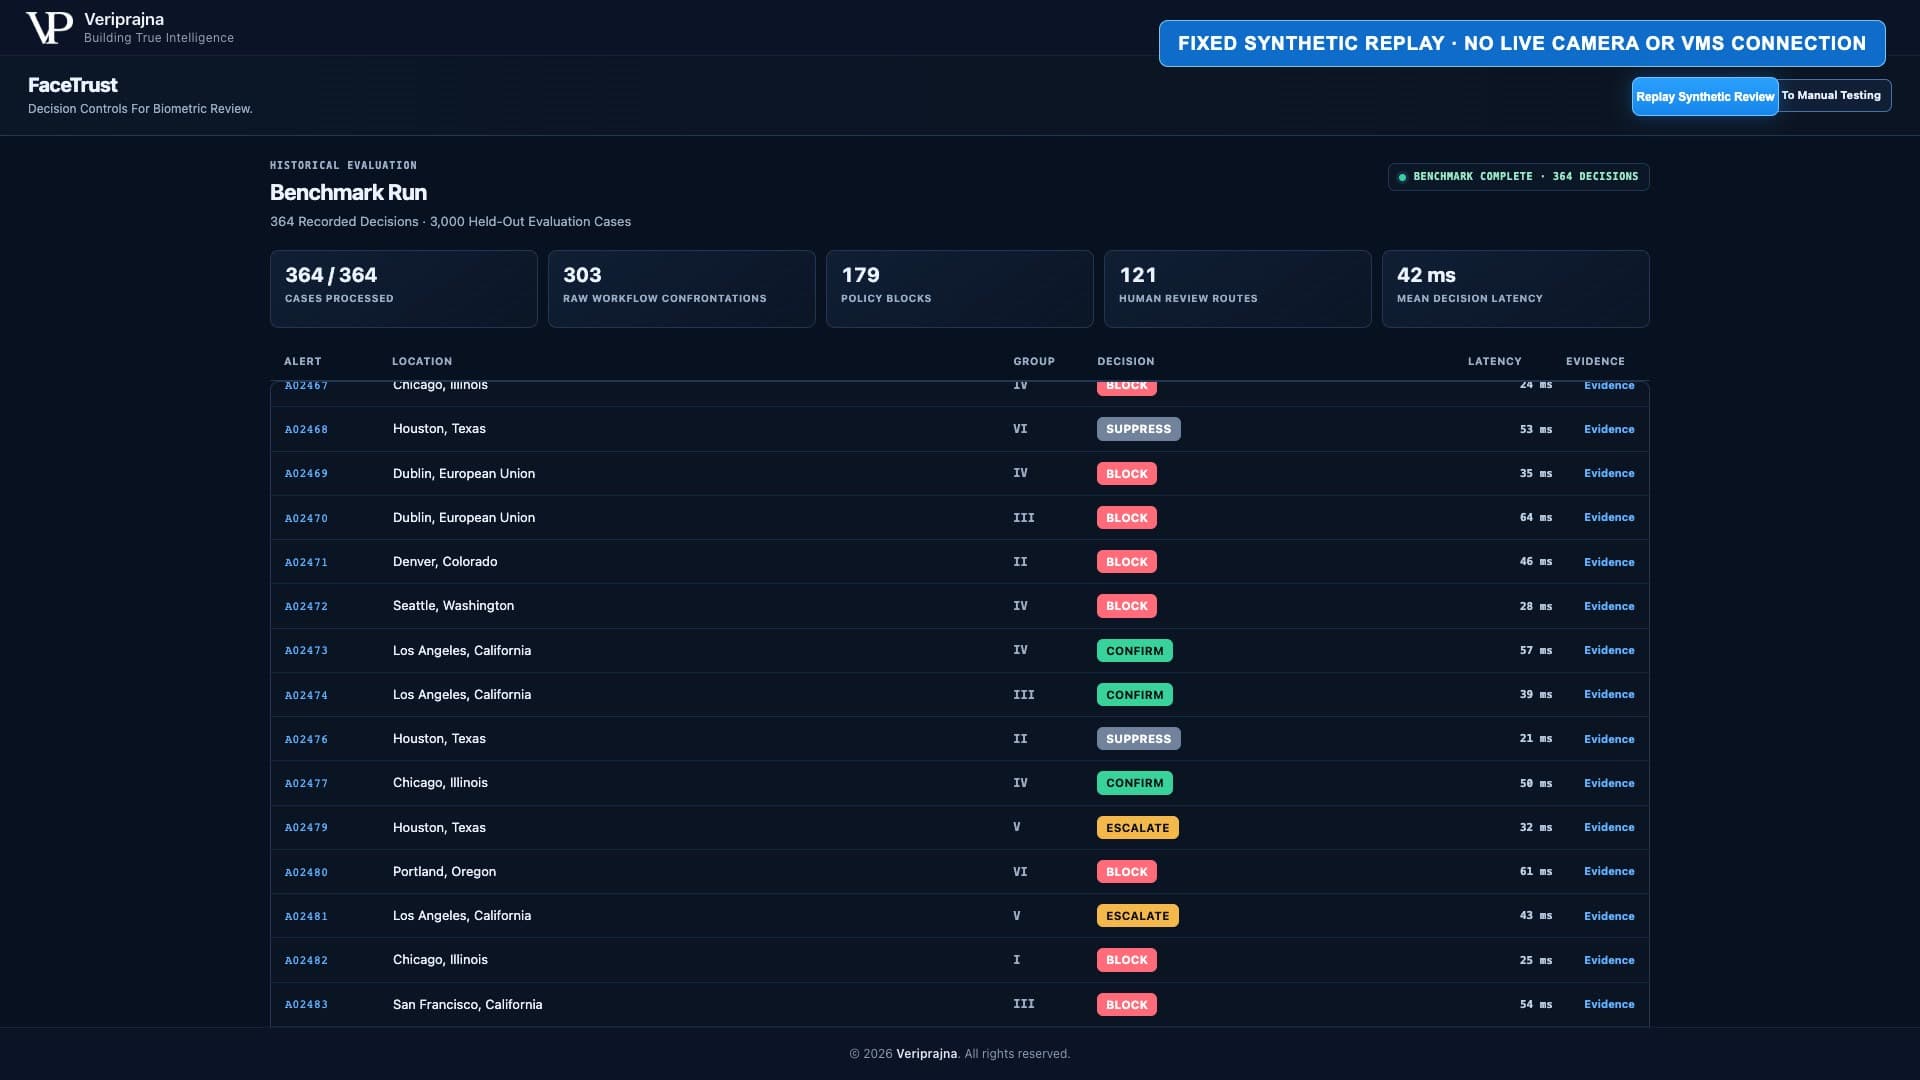
留出基準測試揭示了一個同樣受到明確邊界約束的結論。在1,566起合成冒名(非匹配)預警中,原始基準會以69.3%的比例發起盤查,而防火牆的確認率僅為3.8%,依照這一定義實現了94.5%的降幅。在1,434起合成真匹配預警中,真實目標留在防火牆預測集內的比例達到93.1%,相比之下原始閾值基準為99.3%。這種對比揭示了一個客觀權衡:如果系統甘願對海量冒名者採取貿然行動,那麼保全更多真實匹配易如反掌。
這種權衡改變了我對「減少預警數量」這一目標的理解——孤立來看,這本身是一個糟糕的目標。系統若不加甄別地拋棄疑難個案,自然能輕易降低工作負荷。而在本系統中,每條路徑的選擇依據始終保持完整綁定:同意授權、司法管轄、抓拍門檻、校準預測集或證據排除理由。路徑之所以可解釋,是因為決定該路徑的各項輸入完全明晰。
這也是為什麼在本演示中,建檔年齡僅保留為警示標識而非獨立關卡的原因。LP-0834那張15年前的入案照對於審查員和審計來說是關鍵背景信息。倘若假裝演示內置了一條放之四海皆準的年齡鐵律,只會憑空捏造出方案與實現均不支援的虛假確定性。
我希望這種拒絕能夠經受住任何審查
在重放測試結束後,我打開證據檢視,將判定路徑與相應留存記錄並排對照。LP-0834絕不會以一枚彩色徽標敷衍了事。每一項決策都會生成一條由SHA-256雜湊鏈接的完整記錄,介面可導出可供列印的HTML審計存證報告。該拒絕具備可追溯的溯源憑據。
我向來對那些僅憑一段自動生成文字進行解釋的系統抱有警惕。文本段落可以概述事實,但它無法證明路徑是在文字生成之前就已鎖定,更無法證明底層記錄未曾被悄然篡改。雜湊鏈本身並不能證明決策絕對正確。它的價值在於使雜湊鏈內部的任何後延篡改無所遁形,並為調查人員提供堅不可摧的檢驗實物。
正是這種界限守護了審計主張的誠實度。本演示絕非合規資質認證、法律意見書,亦不能取代法律顧問或運營控制流程。它依託於設定的合成試驗場、樁化適配器以及模擬的法規與同意數據表。它不連接任何實時攝像頭、VMS、商業引擎、NIST、活體檢測或真實客戶數據。它證明的是一種機制與順序次序,而非生產環境下的交付結果。
我能清晰預見未來面臨的質詢:絕不是「給我看摘要備忘錄」,而是「向我證明系統當時掌握了什麼、觸發了哪條確定性規則、誰保留了處置行動的責任,以及事後記錄是否未被篡改」。審計報告正是為了契合這一連串嚴苛質詢而精心設計的。
我在構建系統過程中確立的核心準則
我不再將人臉識別的治理機制看作匹配聲明確立後才啟動的輔助層。到了那個階段,預警本身已經裹挾了巨大的既成推力。有人看到了耀眼的高分,運營處置機制隨即啟動,後續的所有安全防線都不得不與一個看似無可辯駁的既成結論艱難抗辯。
LP-0834這一典型場景為我賦予了一條更為嚴密的準則:在證據置信度能夠授權某條路徑之前必須先行評估合法性,而且在要求人員介入採取行動之前,證據的置信度必須伴隨其不確定性一併表達。訓練有素的審查員始終對CONFIRM或ESCALATE路徑之後的處置行動負全責。BLOCK與SUPPRESS必須成為完全正當合法的處置結果,而不是等待被人為強行推翻的錯誤狀態。
這正是蘊藏在Biometric Decision Firewall背後的核心裁決思想。智能體可以起草條理清晰的建議,但唯有確定性控制才能決定路徑方向。這裡的演練展示與完整拆解展示了FaceTrust如何使這一界限變得具象可見。
如果您更傾向於親眼目睹其實際運行而非聽我敘述,這裡提供了從頭至尾全流程運轉的完整演示。
我始於一個看似強悍到足以牽著人鼻子走的分數。最終以基於缺失前提、受控證據和可查驗記錄的正當拒絕而收官。在整套系統中,最具責任感的決策,往往正是那個阻止分數盲目轉化為實際行動的決斷。