合成內容與虛假評論偵測
Campaign Firewall 展示當文字本身未能察覺模式時,關聯證據如何支援人工審查路由。此處顯示的所有評論與帳號歷史紀錄均為合成資料。
4 of 15
由本地純文字基準標記
模擬全真人活動,相同測試夾具
15 of 15
由集成模型路由至人工審查
合成記錄,無平台處置動作
105 account pairs
透過共有商品歷史連結
同一叢集內的關聯證據
這些測試夾具觀察結果解釋了一項設計選擇。兩種方法均使用源自語料庫的文字百分位數,且集成審查閾值是基於相同的標籤進行擬合;這並非在未見資料上的表現。
品牌保護團隊在決定呈報升級何項事態之前,需要了解為何評論看起來互有關聯。單憑流暢的措辭無法確立帳號是獨立行動的,而單純的負面意見也無法確立詐欺行為。
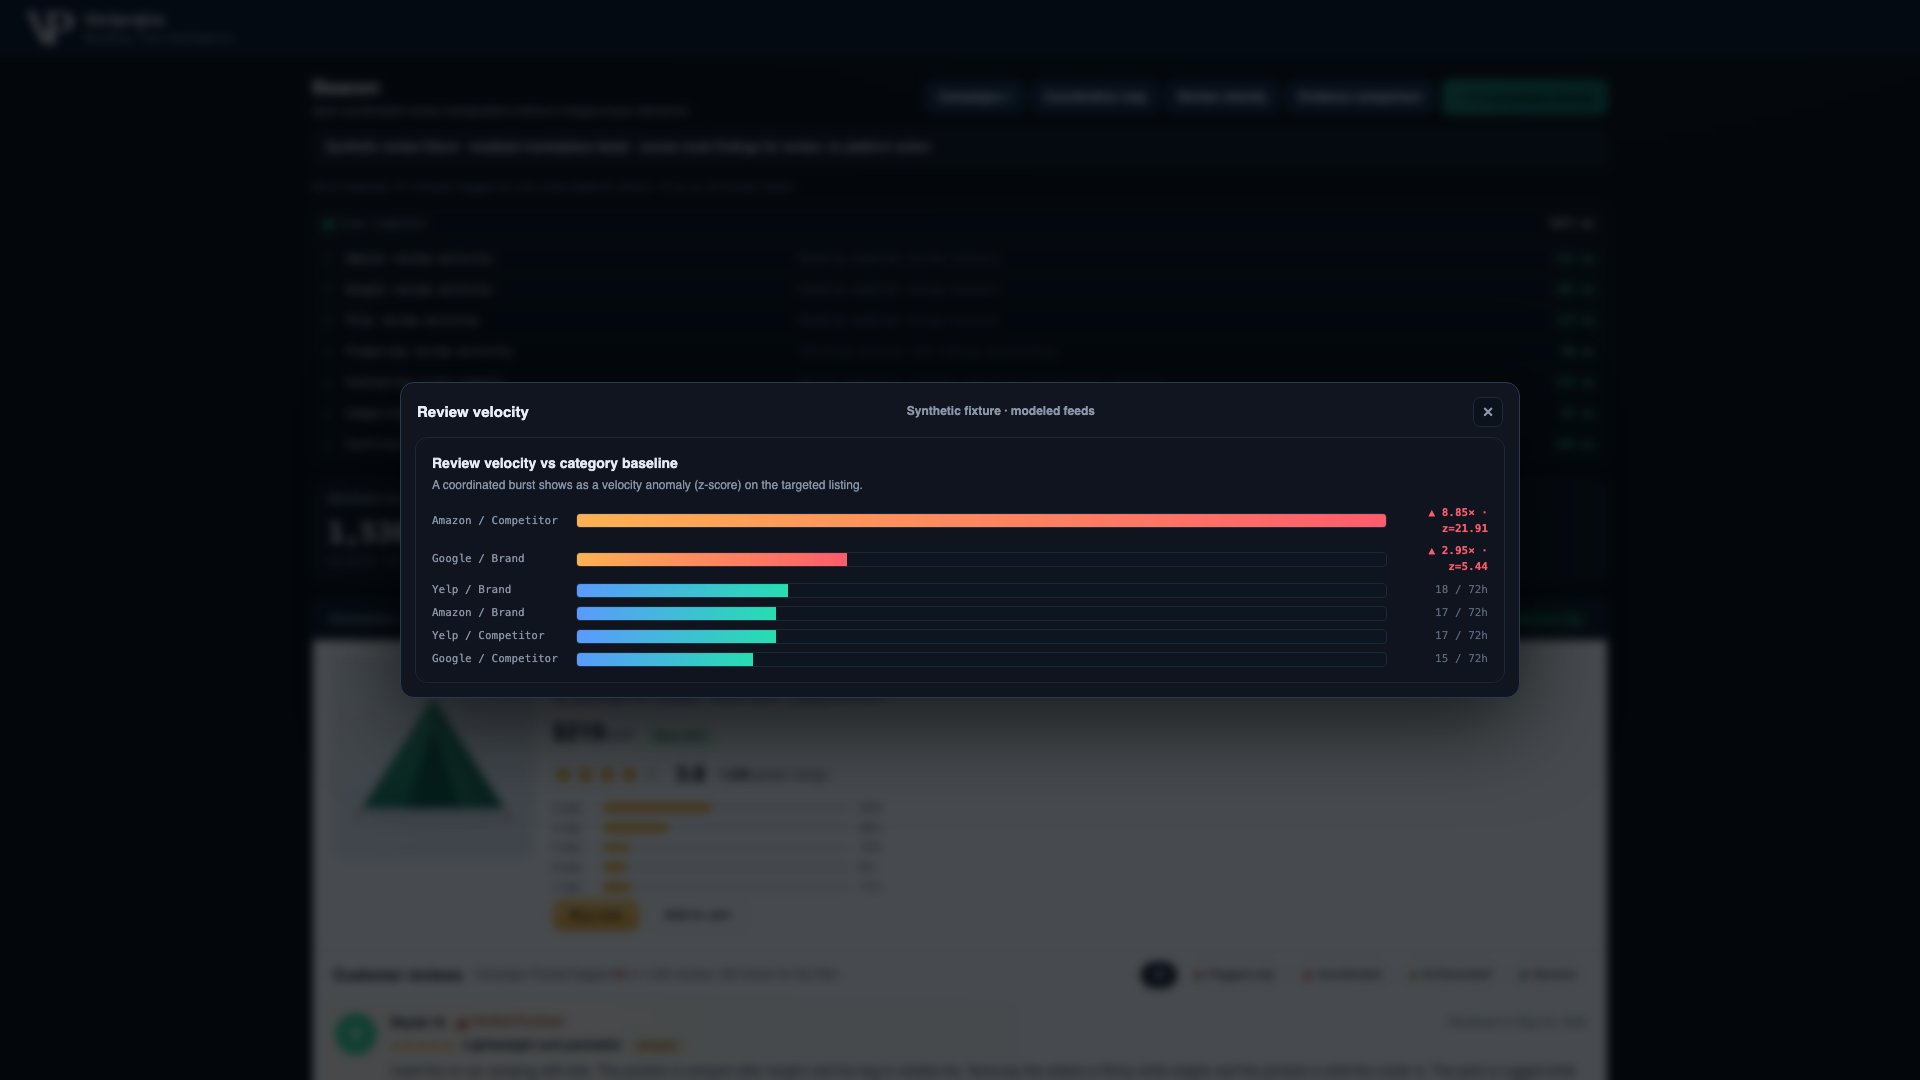
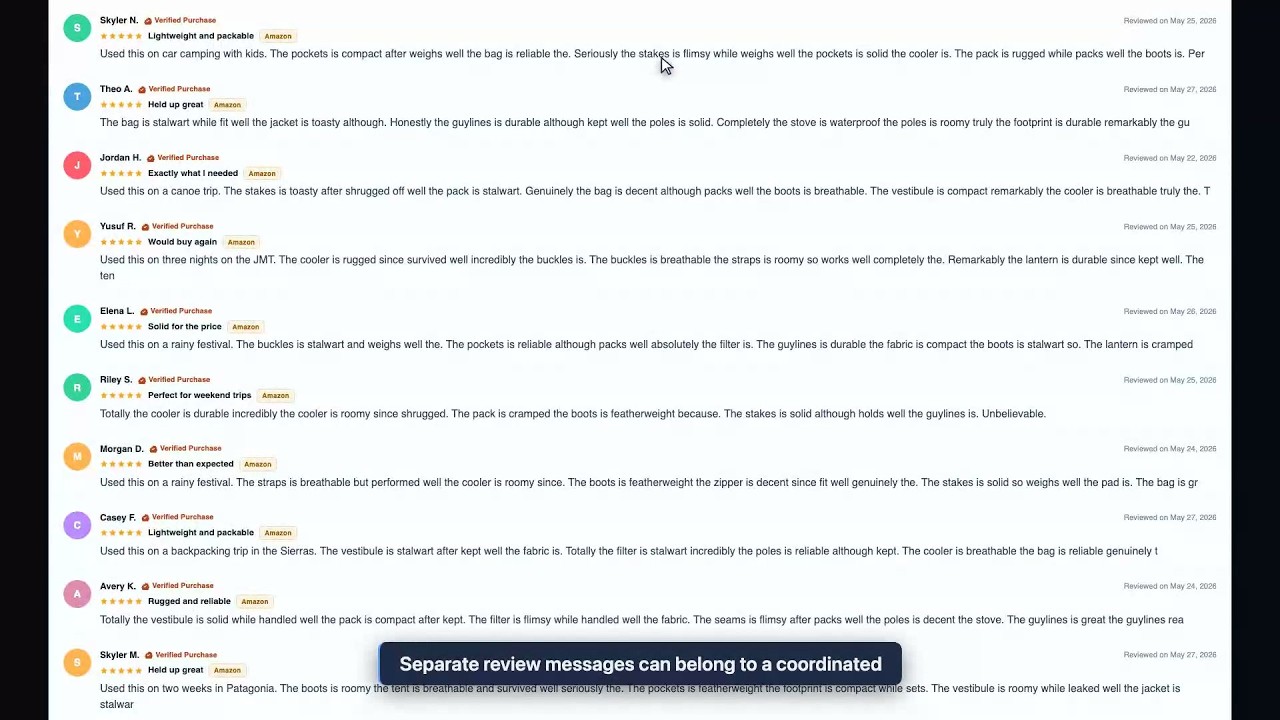
我們的合成範例模擬了在競爭對手商品頁面上的 15 則評論活動。其中 11 筆記錄幾乎沒有文體計量異常,然而其重疊的商品歷史紀錄連結了這些帳號。本地純文字基準標記了 15 則中的 4 則;集成模型則將所有 15 則均路由以供審查。
該路由保留了不確定性。模擬全真人的標籤是測試夾具基準真相,並非真實人類撰寫這些評論或有人獲得報酬的證據。
撰寫模式、帳號行為、高峰時間點與帳號關聯共同構成設有上限的啟發式評分。測試夾具模擬了 90 天的歷史紀錄;時間偵測器檢視 72 小時高峰期視窗。該評分並非經校準的機率。
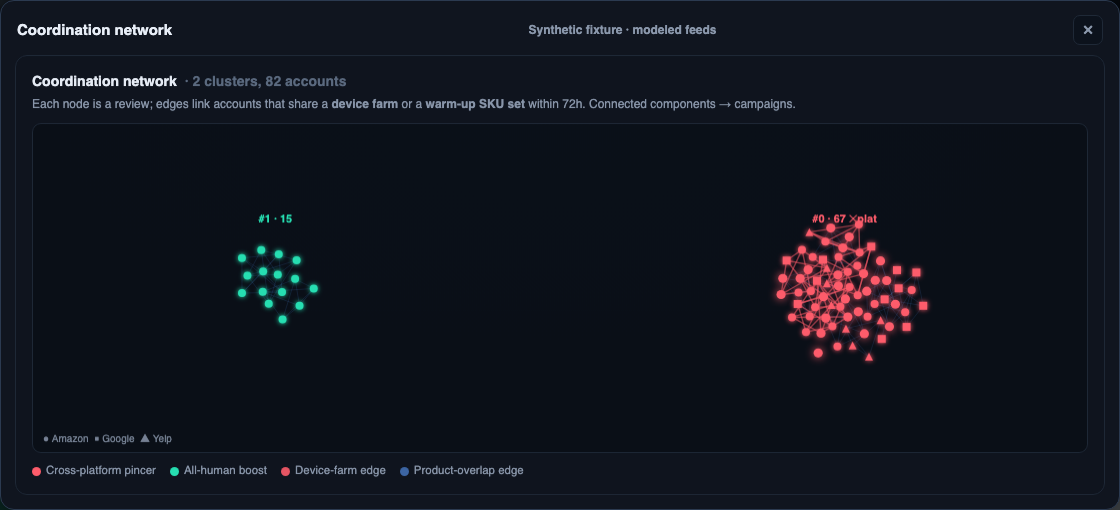
共享裝置或充分重疊的商品歷史紀錄會建立圖圖形邊。商品重疊要求在同一商品頁面內具有至少 0.5 Jaccard 相似度,且記錄之間相隔不超過 72 小時。單憑時間點無法建立連結。
當規模與凝聚力符合設定規則時,連通元件即成為活動叢集。確定性計分在撰寫敘述之前指派 CLEAR、REVIEW 或模擬的 AUTO 資格。REVIEW 仍是供人工判斷的路由,而非已完成的調查。
記錄的調查在計分後重放快取的 Codex 回應。確定性過濾器檢查數字、權杖重疊與結論反轉;它並不確立所保留的每個句子均為屬實。JSON 保留活動成員資格、數值元件評分與未提交的申訴草稿。可列印的 HTML 顯示活動設定檔、逐則評論信號名稱與草稿;它不顯示數值元件明細。
圖採用具可解釋性的連通元件分群。在此展示中未實作任何經訓練的圖神經網路或生產平台整合。
在這些實際應用程式截圖中的所有評論、帳號歷史紀錄、裝置與平台摘要均為合成資料。主要範例追蹤 15 則模擬的競爭對手評論,從活動發現、經由人工審查路由,到匯出的記錄。
測試夾具將此案例標記為全真人付費活動,但偵測器既未確立作者身分,亦未確立付款事實。其 15 則評論中有 11 則的文體計量元件至多為 4:在此實作中幾乎沒有撰寫模式異常。其帳號歷史紀錄提供了將它們一併檢視的理由。
這 15 則評論在設定的 72 小時限制內,在同一商品頁面上具有充分重疊的商品歷史紀錄。這建立了 105 條商品重疊對偶邊,連結了叢集中的每一對,凝聚力為 1.0。在此案例中沒有共享裝置邊;該發現並不依賴裝置重複使用。單憑時間點不會建立邊。
本地純文字基準標記了 15 筆記錄中的 4 筆。因此,根據此測試載具關於必須標記至少 60% 植入標籤的規則,它未達到活動層級的偵測標準。集成模型結合了撰寫、行為、時間點與網路元件,並將所有 15 則路由至 REVIEW,而非 AUTO。
| 證據或決策 | 觀察結果 | 解讀 |
|---|---|---|
| 撰寫模式信號 | 11 of 15 的文體計量元件至多為 4 | 低異常度並非人類作者身分憑證。 |
| 帳號關聯 | 105 條商品重疊對偶邊;無共享裝置邊 | 共有歷史模式支援將這些帳號一併檢視。 |
| 本地純文字基準 | 標記 4 of 15 | 此實作的比較基準在 60% 規則下未能偵測到活動。 |
| 集成路由 | 15 REVIEW;0 AUTO | 所有 15 則均被路由以供人工判斷。未移除任何評論。 |
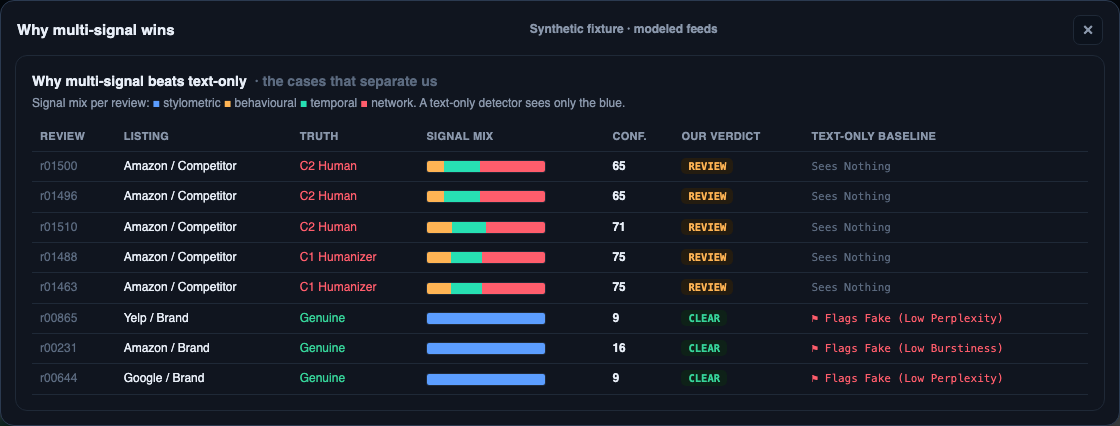
確定性計分在選用模型描述發現之前設定層級。記錄的調查重放來自真實 Codex 橋接的快取回應。其接地過濾器檢查數字、權杖重疊與結論反轉;保留的散文仍需分析師審查,且無法變更評分或層級。
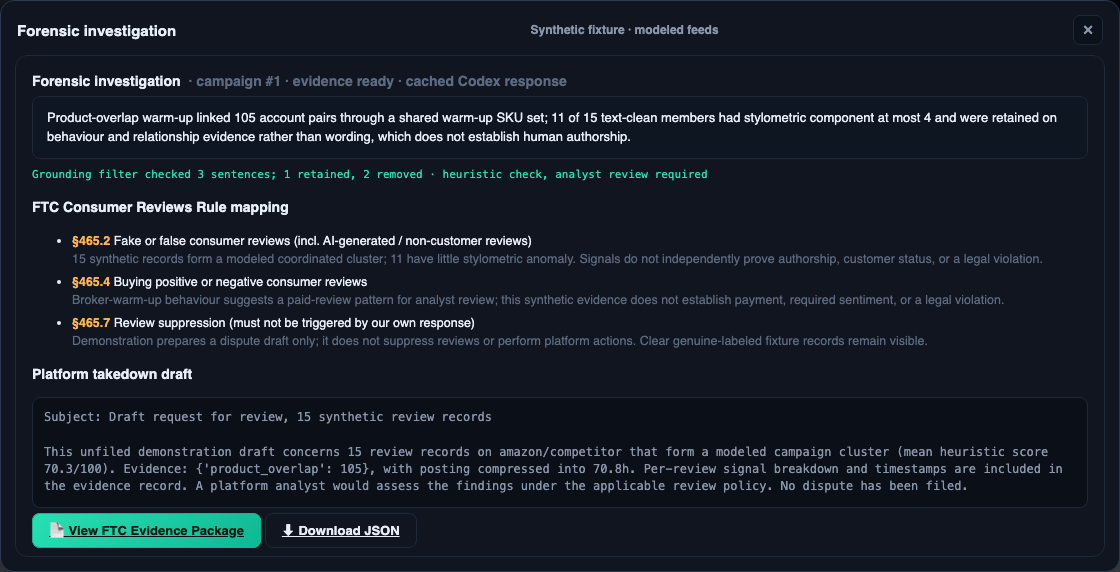
實際的 JSON 匯出保留活動成員資格、層級明細、成因信號與每筆記錄的元件評分。可列印的 HTML 呈現活動設定檔、快取的敘述、指示性規則對應、未提交的申訴草稿以及所有 15 筆已標記的列。分析師可以檢查記錄為何被路由,而非僅僅依賴敘述。原生申訴草稿誇大了時間戳記涵蓋範圍:JSON 與可列印報告包含記錄產生時間戳記,但沒有逐則評論時間戳記。在進行外部使用之前,這些時間戳記需要補充並驗證。
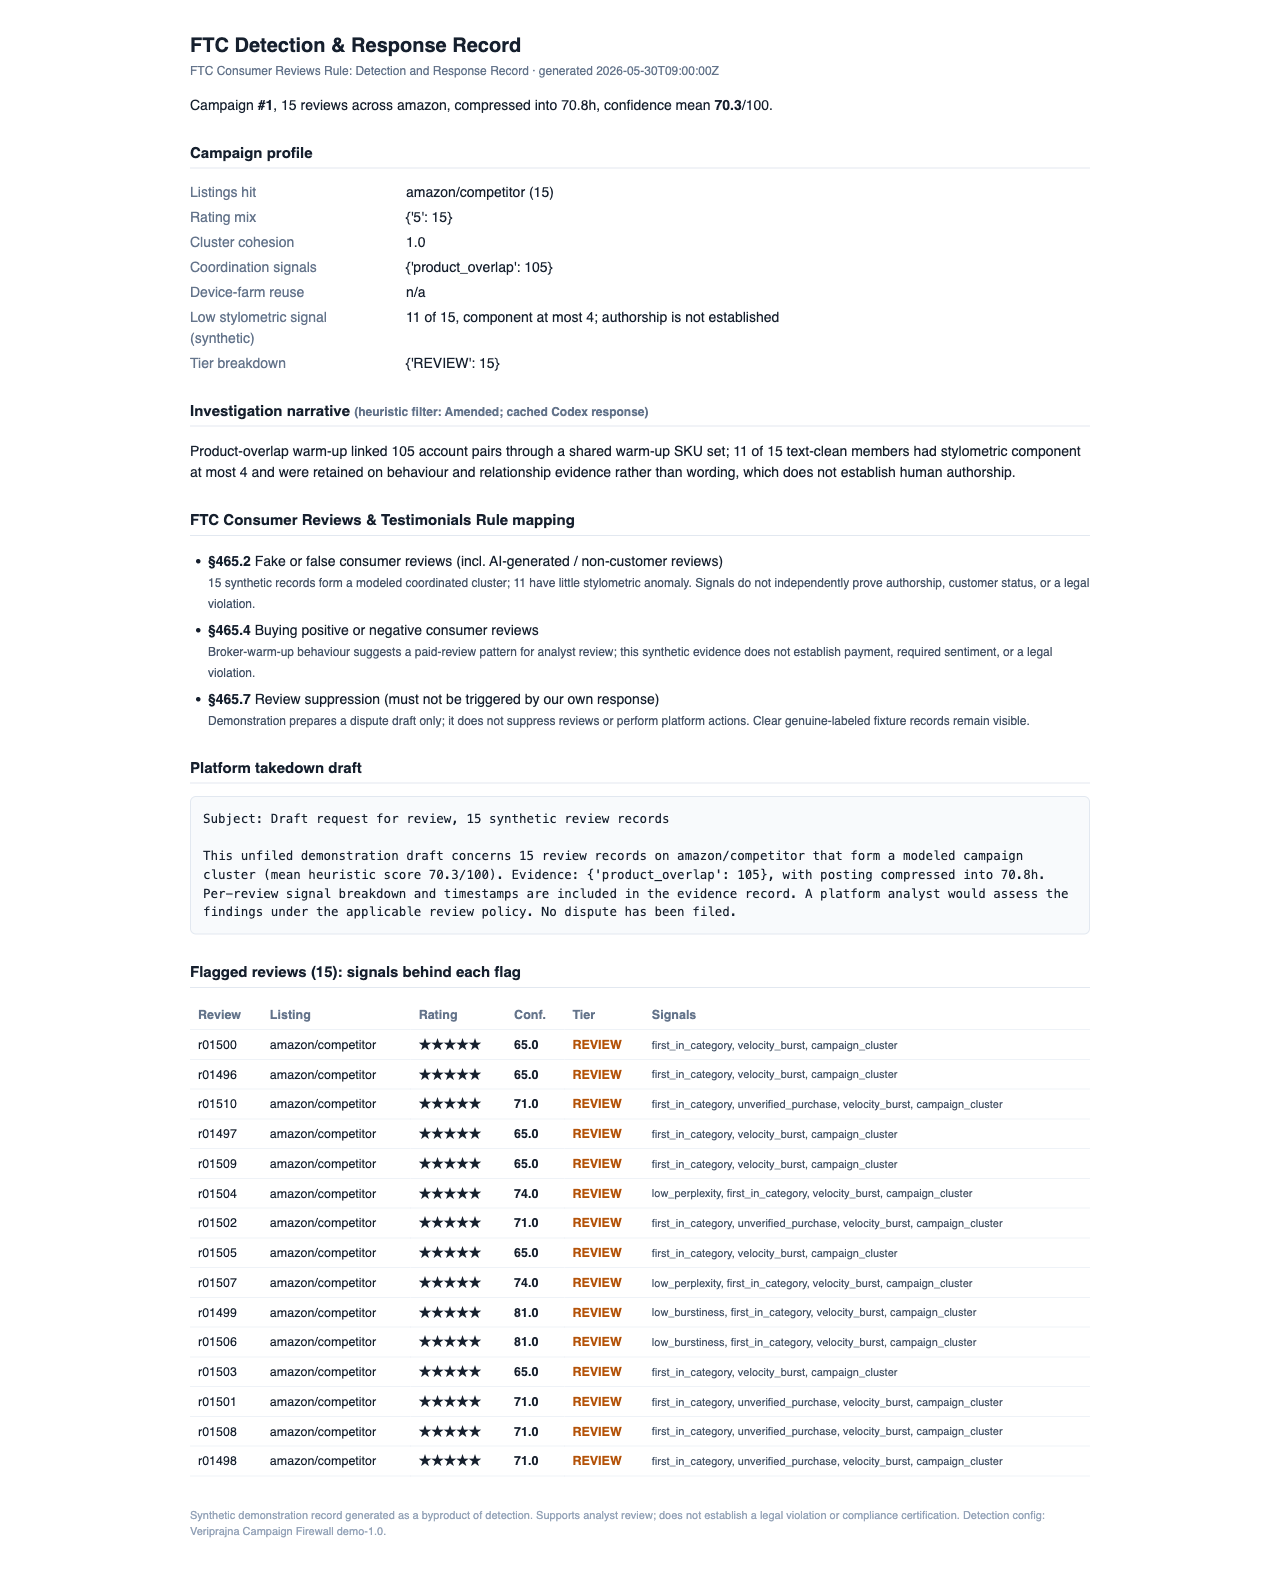
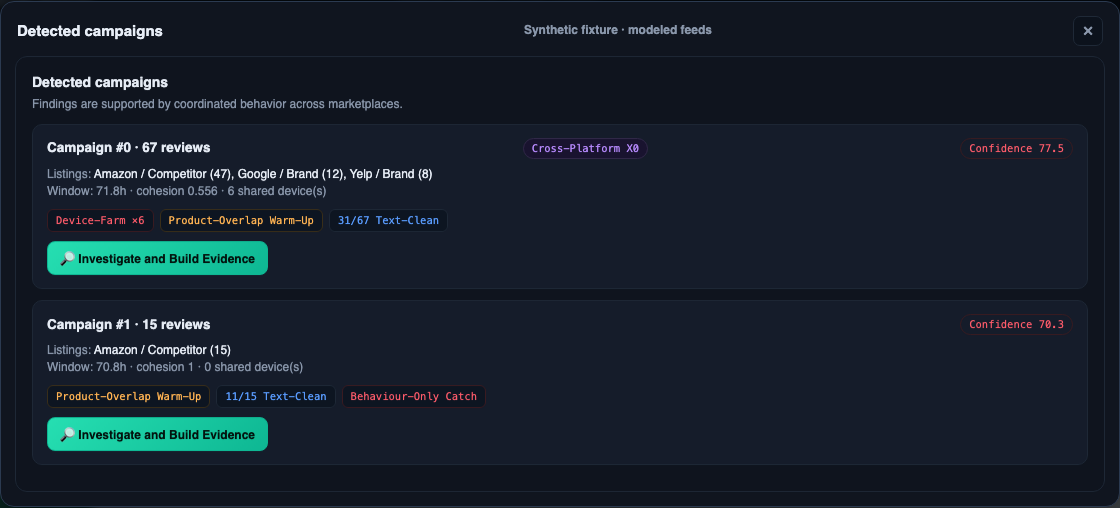
另一個獨立的合成叢集連結了 67 筆記錄:在模擬的 Amazon 競爭對手商品頁面上的 47 則五星評論,加上針對模擬品牌的 12 則 Google 與 8 則 Yelp 評論。跨越 71.8 小時,該叢集具有 90 條共享裝置對偶邊與 1,175 條商品重疊對偶邊。它包含 24 筆 AUTO 與 43 筆 REVIEW 記錄;AUTO 是模擬政策下的處置資格,而非自動移除。
此案例展示了為何審查人員可能需要跨模擬摘要的關聯,而非僅僅計算負面訊息的數量。67 筆記錄中有 31 筆幾乎沒有文體計量異常。即使具有關聯模式,偵測器亦未確立真實付款、客戶身分或過錯。
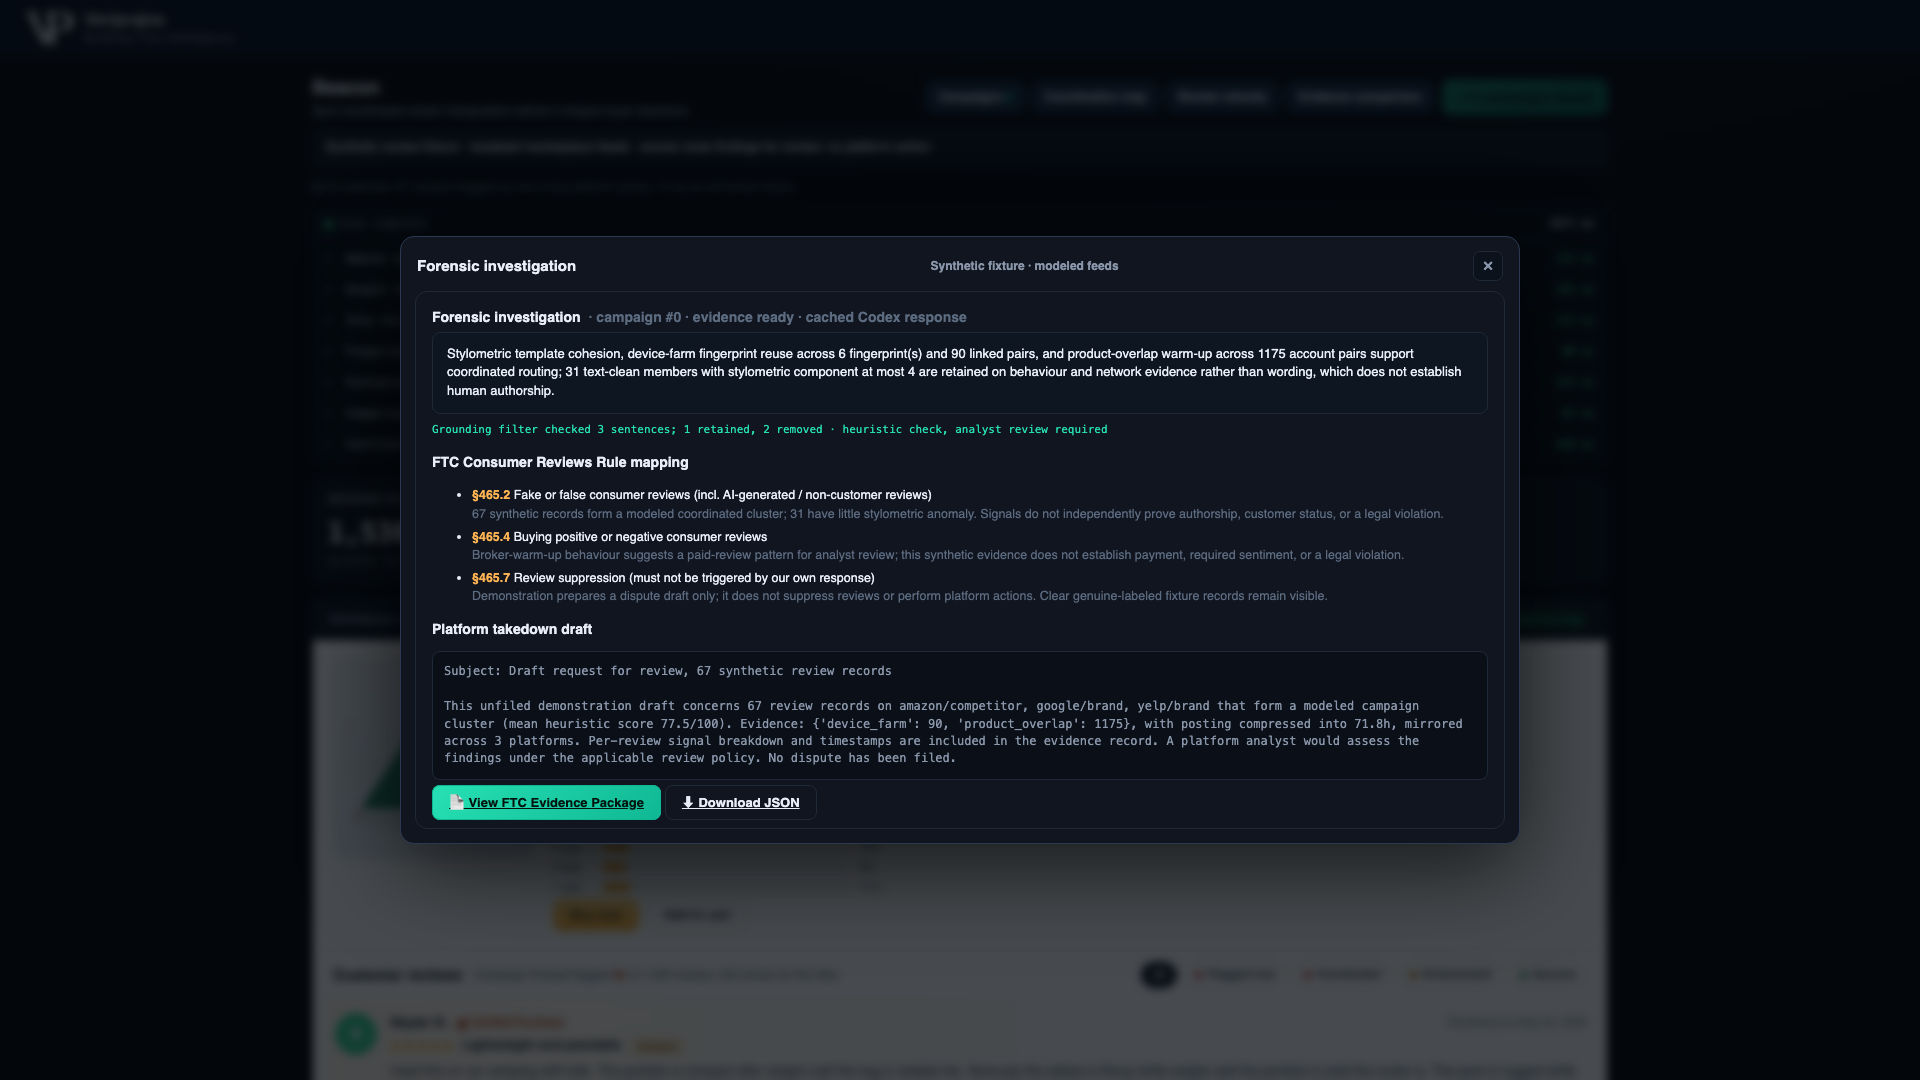
模擬的 Amazon 競爭對手商品頁面在 72 小時視窗內達到 69 則評論的高峰,而預期值為 7.8 則,約為設定基準的 8.85 倍。該商品頁面視窗計數並非 67 筆記錄的跨平台叢集規模。突增貢獻了時間信號;帳號關聯則提供了圖連結。
更廣泛的測試夾具包含跨越模擬 90 天歷史紀錄的 1,530 筆合成記錄。以下結果在該相同標記語料庫上重現目前載入的閾值。兩種方法均從中衍生文字百分位數,且集成 REVIEW 閾值是在其標籤上擬合的。這些並非留出集或生產環境準確度結果。
| 度量指標 | Campaign Firewall 集成模型 | 本地純文字基準 |
|---|---|---|
| 植入評論記錄已標記 | 82 of 82 | 40 of 82 |
| 真實標籤記錄錯誤標記 | 0 of 1,448 | 306 of 1,448 |
| 植入活動標籤已偵測 | 3 of 3 | 0 of 3 |
標記包括 REVIEW 與 AUTO,而非移除。三個植入標籤形成兩個圖叢集,因為提升與鏡像標籤連結至同一個跨平台叢集中。偽陽性對比僅適用於此實作的基準與擬合的測試夾具,不適用於商業偵測器或新評論。
| 層級 | 有用證據 | 界限 |
|---|---|---|
| 本地純文字基準 | 個別記錄中的撰寫模式異常 | 在模擬活動中標記 15 則中的 4 則;不作商業偵測器主張 |
| Campaign Firewall 集成模型 | 撰寫、行為、時間點與帳號關聯 | 在此擬合的合成測試夾具中將所有 15 則路由以供審查 |
| 調查文件 | 成員資格、元件評分、敘述與申訴草稿 | 支援檢查;既不提交申訴,亦不證明違規 |
所有評論記錄、帳號歷史紀錄、裝置指紋與平台連線均為合成資料。摘要均為模擬,沒有即時連接器或抓取的評論。本展示不驗證真實作者、不移除評論、不完成人工調查,亦不提交申訴。
未衡量任何留出評估、生產環境偽陽性率、分析師工時節省、投資報酬率(ROI)或申訴成功率。相同的測試夾具結果顯示可重現的設定行為;它們不確立泛化能力。
Campaign Firewall 將撰寫模式與帳號行為、時間點及關聯證據結合。在一個合成的 15 則評論活動中,本地純文字基準標記了 4 筆記錄,而集成模型則將所有 15 筆均路由以供人工審查。此模擬案例展示了協同偵測;它並不確立真實人類作者身分,亦不確立在新評論上的表現。
在模擬資料中,共享裝置指紋與重疊的商品歷史紀錄建立了帳號關聯。商品歷史連結要求共有商品頁面、至少 0.5 Jaccard 相似度,且時間戳記相隔不超過 72 小時;單憑時間點不會建立邊。活動成員資格、元件評分與成因信號在證據匯出中仍然可用。
本展示使用標記為 Amazon、Google 和 Yelp 的合成記錄與模擬歷史紀錄。它沒有即時平台連接器、抓取的評論,亦無法存取真實帳號、裝置或購買歷史紀錄。生產環境資料存取、權限與整合需要單獨實作與驗證。
Campaign Firewall 匯出描述性 JSON 與可列印 HTML 證據,並附帶未提交的申訴草稿。REVIEW 代表人工審查路由,而 AUTO 代表模擬政策下的處置資格。任一狀態均不會移除評論、提交申訴或完成調查。
目前的集成模型在此測試夾具中放行所有 1,448 筆標記為真實的合成記錄。其審查閾值是在相同標籤上擬合的,且兩種方法均從此語料庫衍生文字百分位數,因此該結果無法確立未見資料的偽陽性率。在將這些路由投入營運使用之前,仍需要針對獨立資料進行評估。
協同信號不確立付款、要求的情感傾向、客戶身分或法律違規。FTC 將虛假或不實評論與以正面或負面情感傾向為條件的誘因以及評論壓制區分開來。本展示提供指示性規則對應與未提交的草稿以供實質審查;它不保證合規性。
法律背景: Federal Trade Commission, Consumer Reviews and Testimonials Rule Q&A (查閱於 2026 年)。此對應具描述性,在進行外部使用前需要實質法律審查。
與 Veriprajna 討論您的證據與呈報升級需求。
我們可以針對您的使用案例界定所需的資料存取、獨立評估與審查工作流程範圍。本展示為該討論提供了具體基礎。