摩爾定律已死。AI 是 除顫器:下一代矽架構中 強化學習的戰略要務
執行摘要:矽晶懸崖
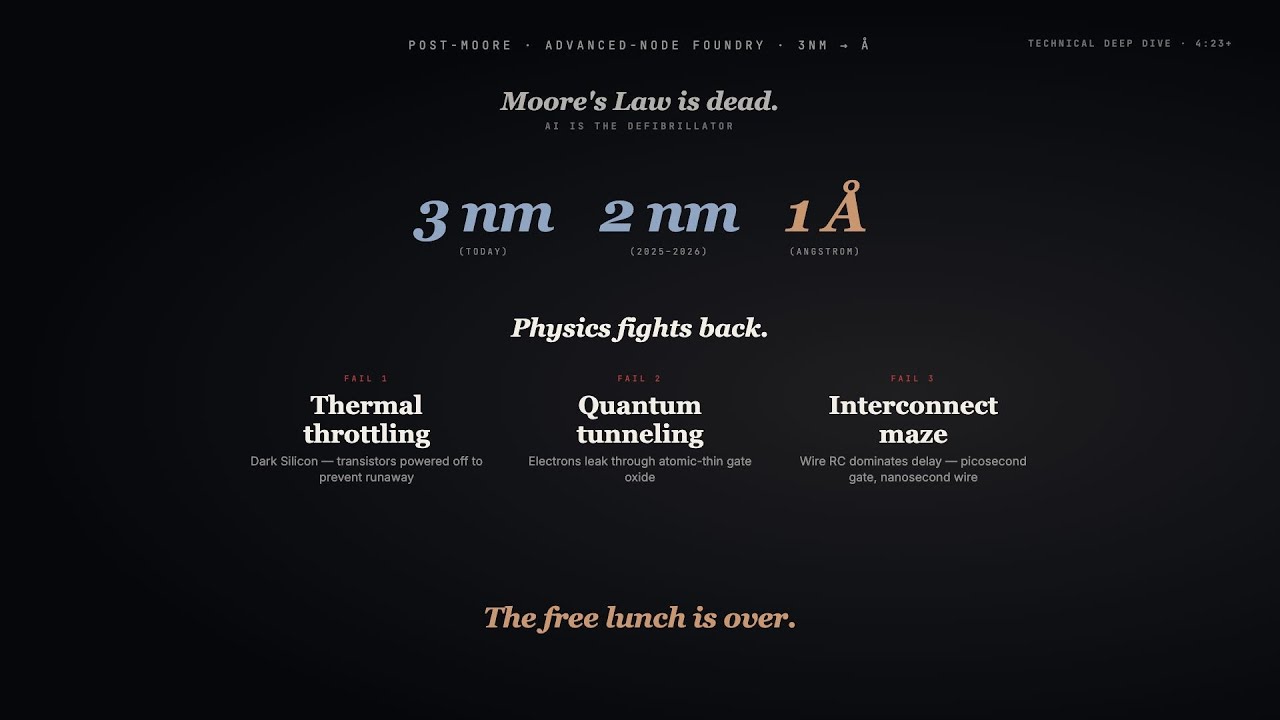
全球半導體產業正站在一個岌岌可危的轉折點, 技術史學家很可能會將此標記為「古典縮放」時代的終結。五十餘年來, 產業隨著摩爾定律的節拍前進,這項經驗觀察指出電晶體密度約每兩年 翻倍,帶來可預期的效能與效率紅利。這一節奏支撐了數位 經濟,使個人電腦革命、雲端 運算興起與智慧型手機普及成為可能。然而,隨著製程推進至 3 奈米、2 奈米及即將到來的埃米級節點的原子極限,傳統 進步引擎已停滯不前。我們進入了一個物理反擊的時代。「免費 午餐」——源自光刻微縮的自動加速——已經結束,取而代之的是殘酷的 熱節流、量子穿隧與互連瓶頸景觀, 威脅著運算進步的停滯。 我們面臨的危機不僅是製造物理的危機;更是設計 1
複雜度的危機。現代系統單晶片(SoC)可說是人類迄今 建造的最複雜人造物,包含數十億顆電晶體,組織成錯綜的邏輯、 記憶體與互連層級。放置這些 元件的設計空間——針對功耗、效能與面積(PPA)最佳化——超過可觀測 宇宙中所有原子的數量。數十年來,人類工程師在啟發式 電子設計自動化(EDA)工具輔助下,憑直覺與經驗法則 探索這一空間。如今,該方法已撞上認知天花板。將數十億 元件放置以最小化線長與熱量,同時滿足數千項硬約束的問題 已超出人類認知負荷。傳統工具依賴 1980 年代開發的模擬退火等演算法, 將設計困在局部最優,無法察覺釋放極紫外(EUV)光刻 潛力所需的全域架構調整。 本白皮書作為 Veriprajna 的宣言,建立從 3
以人為中心的啟發式到 AI 原生設計的典範轉移框架。我們主張人工 智慧——特別是深度強化學習(RL)——是 摩爾定律的必要除顫器。將晶片物理設計重新定義為 類似西洋棋或圍棋的序貫博弈,而非靜態最佳化任務,我們得以發現「異域」架構: 違背人類對稱與直覺、卻經物理驗證跑得更快、 更涼、更高效的佈局。我們分析 Google AlphaChip 的開創性工作, 以及 MediaTek 與 NVIDIA 等巨頭的產業驗證,證明 RL 代理並非 實驗玩具,而是矽晶主導地位的新引擎。 對企業而言,轉向 6 對企業而言,轉向 深度 AI 解決方案已非可選的研發實驗;而是後摩爾時代的 生存定策。
1. 摩爾定律之死與認知天花板
1.1 古典縮放的崩潰
要理解 AI 在晶片設計中的必要性,必先體認傳統縮放所面對問題的 規模。Gordon Moore 1965 年的預測本質上是 驅動整合的良性循環。數十年來,這一點成立。Dennard 縮放 伴隨摩爾定律,確保電晶體縮小時功率密度維持 恆定,使時脈可提升而不燒熔晶片。 Dennard 縮放在 2000 年代中期因漏電流與熱限制而崩潰,
迫使產業進入多核心時代。如今,摩爾定律本身也搖搖欲墜。先進節點如 3 奈米的 每電晶體成本上升而非下降,因多重圖形化與 高數值孔徑 EUV 光刻的極端複雜度。此外,效能增益 遞減。我們進入「暗矽」時代,熱約束要求 晶片上相當比例的電晶體在任何時刻必須關閉,以 防止熱失控。瓶頸已從電晶體閘極轉向導線。在 現代奈米製程中,微觀銅互連的電阻與電容 主導訊號延遲與功耗。訊號穿越邏輯 閘極僅需皮秒,卻可能需奈秒才能穿越晶圓上電阻性 導線迷宮。 這一物理現實意味著區塊的幾何排列——佈局規劃——是 1
晶片效能最關鍵的決定因素。拉長 關鍵路徑的劣質佈局無法靠更快的電晶體修復。人類工程師偏好的「曼哈頓」佈局—— 整齊的直角行列——是人類 組織限制的審美產物,而非物理最優。它們利於人類理解 卻不利於電子流動。 1.2 認知負荷與搜尋空間爆炸 3
現代邏輯綜合與物理設計的複雜度驚人。高階 AI
加速器或伺服器 CPU 可能包含數千個記憶體巨集(SRAM)與數百萬個 標準邏輯單元。可能放置排列的數量之大,使 暴力搜尋成為不可能。 設計師必須同時最佳化相互衝突的目標:
1. 線長(HPWL): 最小化互連總長以降低延遲與
動態功耗。 2. 時序收斂: 確保訊號在精確時脈週期
視窗內到達正反器,橫跨數十億條路徑。 3. 擁塞: 確保金屬層有足夠物理空間佈線
而不短路。**** 4. 熱密度: 分散高活動邏輯以防止劣化
可靠度或觸發節流的熱點。 人類工程師以「分而治之」管理此複雜度。他們將晶片
人類工程師以「分而治之」管理此複雜度。他們將晶片 拆成較小可管理的區塊,個別最佳化後再縫合。 雖實用,此法犧牲全域最優。一區塊的最佳化可能 在鄰近區塊造成擁塞噩夢,但人類設計師無法 在腦中模擬放置決策在整個系統的連鎖效應。我們已 達到「濕件」最佳化的極限。 3
1.3 啟發式的失敗
傳統 EDA 工具旨在協助人類工程師自動化此流程的 繁瑣面向。它們依賴「啟發式」——源自過去 經驗的經驗法則。例如,「將相連區塊放近」是一條啟發式。雖 然大致合理,卻無法考量二階效應,如佈線擁塞或密集區域的 電源網格壓降。
模擬退火(SA)等演算法自 1980 年代起成為佈局規劃業界標準, 透過隨機移動區塊並「降溫」系統以 收斂至解。然而,SA 在現代情境下有兩個致命缺陷。首先,它是 無記憶的 。每次 SA 執行都從隨機種子開始。它不從 前次執行學習,也不從前一代 晶片設計轉移知識。它反覆燒掉可變的運算量,從零解決同一類問題 。其次,它易被困在 局部極小值 。在現代 PPA(功**耗、效能、**面積)指標的 崎嶇高維景觀中,SA 常 滿足於「夠好」的解,因為它無法「看見」隱藏在高成本山脊後的 全域最優。 4
結果是晶片設計仍是勞力密集的迭代流程。專家 物理設計工程師團隊花費數週或數月手動調整佈局, 手動移動巨集以修復啟發式工具遺漏的時序違規。此 「人在迴路」瓶頸是先進矽晶爆炸性成本與 上市時間的主因。 12
2. 典範轉移:晶片設計作為博弈
2.1 從啟發式到學得的直覺
Veriprajna 倡導設計自動化哲學的根本轉變:從 啟發式(靜態規則)轉向** 學得的直**覺(動態策略)。正如西洋棋 特級大師不計算每一步,而是依賴深度、模式匹配的 直覺辨識最強走法,AI 代理可為矽晶 物理發展出「直覺」。
此典範轉移由 深度強化學習(RL) 驅動。在此框架中,我們 將晶片佈局規劃視為要玩的博弈,而非要解的數學問題。
● 棋盤: 矽晶晶粒(畫布),離散為放置網格。
●** 棋子:** 網表元件——記憶體巨集、邏輯叢集與 IP 區塊。
●** **走法: 在特定 座標與方向放置元件。
●** 得分:** 源自最終佈局物理品質的複合獎勵函數(線長、功耗、面積、時序)。 透過在各式晶片上玩此「博弈」數百萬次,RL 代理學得泛化
策略。它學到將記憶體控制器放在 I/O 介面附近可降低延遲。它 學到以特定叢集模式排列算術單元可減少擁塞。 關鍵是,它學到這些規則並非因人類編程,而是因 獲得獎勵。 2.2 矽晶的馬可夫決策過程(MDP) 3
技術上,我們將佈局規劃問題表述為馬可夫決策過程(MDP)。
1. 狀態空間(
): 在步驟**,狀態包含當前部分佈局(已** 放置的區塊)、畫布可用空間的「遮罩」,以及剩餘未放置區塊(網表圖)的豐富特徵 表示。狀態必須 捕捉電路的複雜拓撲——哪些區塊相連、 連接強度如何。 2. 動作空間( 12
): 動作是決定下一個巨集放在哪裡。在**AlphaChip 表述中,畫布離散為網格(例如 $128 \times 128$),** 動作是選擇網格單元。此序貫決策過程有別於 試圖同時求解所有位置的解析式放置器。序貫 性使代理能依佈局湧現的現實調整策略。 3. 轉移機率( ): 環境是確定性的;在單元放置區塊 12
可靠佔據該空間並更新密度圖。4. 獎勵函數( ): 這是行為驅動力。與稀疏勝負訊號的棋類不同,晶片設計提供稠密、多目標獎勵。獎勵
通常是**成本的負加權和,目標為最小化: ** 其中 HPWL 為半周長線長(線長代理)。代理尋求
最大化累積獎勵,對應最小化 PPA 成本。12 2.3 「異域」佈局現象 此方法最有說服力的驗證之一,是結果設計的視覺本質。人類工程師受認知 可管理性約束,偏好邏輯分組與對稱。我們將記憶體區塊排成整齊欄位,邏輯置於矩形
區域。我們稱此為「曼哈頓」佈局,因其類似城市街區結構。
此方法最有說服力的驗證之一,是結果設計的視覺本質。 設計。人類工程師受認知可管理性約束,偏好邏輯 分組與對稱。我們將記憶體區塊排成整齊欄位,邏輯置於矩形 區域。我們稱此為「曼哈頓」佈局,因其類似城市街區結構。
然而,RL 代理不受人類視覺秩序需求的束縛。其首要忠誠 在於成本函數的物理。因此,AI 生成的佈局在人眼看來常顯混沌。 巨集散佈於不規則叢集;邏輯雲團顯得無定形。 這些被稱為「異域佈局」。然而模擬時,這些異域配置 一致優於人類設計。「混沌」實則是更高階的秩序—— 以剛性人類幾何無法達成的方式,超最佳化關鍵網路的歐幾里得距離。 AI 發現訊號最短路徑很少是沿 主軸的直線,而常是在可用空間中的精巧編織。 這就是「除顫器」效應:向停滯的 設計流程注入非直覺、物理最優的活力。 6
3. AlphaChip 革命:技術深度剖析
3.1 發現的架構
Google 的 AlphaChip(2021 年《自然》論文首次披露)堪稱 EDA 中 AI 的「史普尼克 時刻」。它是首個嚴格證明深度強化 學習代理能在商用級矽晶上超越專家人類團隊的示範。 理解 AlphaChip 架構對掌握 Veriprajna 方法潛力至關重要。
AlphaChip 的核心創新,是能將晶片網表感知為圖,而非文字列表。 標準卷積神經網路(CNN)擅長處理影像 (規則像素網格)。然而,網表是超圖——邏輯閘的不規則連線網。 以導線相連。兩個閘在網表文字中可能相鄰,卻要放於相反的 晶片角落,或反之亦然。
AlphaChip 採用創新**的 基於邊的圖神經網路(Edge-GNN) **。
● 嵌入: 系統為網表中每個節點(巨集/叢集) 與每條邊(導線)建立向量嵌入。
●** 訊息傳遞: 經** GNN 多層,資訊在圖上傳播。記憶體控制器節點「學到」它與三跳外的特定 算術邏輯單元(ALU)節點高度相連。所得嵌入捕捉各元件的 拓撲「中心性」與「引力」。 ● 策略與價值網路: 這些嵌入送入兩個神經網路。策略網路
預測最佳下一步(放置當前區塊位置)的機率分佈。價值網路 從當前部分狀態估計晶片最終品質,引導搜尋。 3.2 預訓練與遷移學習 AlphaChip 的「超能力」,也是與模擬退火關鍵差異,是 3
遷移學習 。Google 在多元晶片
區塊資料集上預訓練代理——記憶體控制器、TPU 核心、PCIe 介面與開源 RISC-V 設計 (如 Ariane)。在這些多樣景觀上練習,代理學得佈局規劃的一般原則。 例如,將佈線密集區塊放在 晶粒中心通常造成擁塞。 面對 全新、未見的 TPU 區塊時,代理並非從零(tabula rasa)開始,而是帶著預訓練直覺。這使其在數小時內收斂至超人類
佈局,而人類團隊需數週。隨著代理設計更多 晶片(TPU v5e、v5p、Trillium),它愈發聰明,形成啟發式工具無法匹敵的 良性改進循環。 3.3 優越性指標 AlphaChip 對 Google TPU 世代的影響可量化且深遠。 6
● 速度: 設計週期從數月壓縮至數小時。
● 線長: 總線長顯著縮減,直接關聯降低
電容與功耗。****
● 面積: 巨集更緊密封裝,可縮小晶粒面積或在相同 footprint 納入更多邏輯。
●** 時**序: RL 代理最佳化時序收斂,減少需手動修復的「負 slack」 路徑。
在最新第六代 Trillium TPU 中,AlphaChip 用於設計更大 比例的區塊,貢獻峰值運算效能較前代提升 4.7 倍
、能源效率提升 67%。6 4. 產業驗證:MediaTek 案例研究 雖然 Google 的成功可被視為擁有無限運算的超規模業者獨特優勢,
領先無晶圓廠半導體公司 MediaTek 採用此技術,
證明其廣泛商業可行性。MediaTek 運用 AlphaChip 原則最佳化旗艦 Dimensity SoC,驅動全球數百萬部 Android 智慧型手機。 4.1 Dimensity 與 PPA 三合一 MediaTek 的 RL 佈局規劃實作鎖定行動矽晶的聖杯:
功耗、效能與面積(PPA)。在激烈競爭的行動市場,5% 電池
續航增益或 2% 晶粒縮減可決定市場領導地位。 表 1:MediaTek Dimensity 9400/9500 效能增益(歸因於先進 設計與製程)
指標 相較前代
| 提升 | 戰略意涵 單核心效能 |
+35%(Dimensity 9400) |
|---|---|---|
| +35%(Dimensity 9400) | 更快的應用啟動與 | 回應性。 +28%(Dimensity 9400) |
| 增強多工與 | 背景處理。 | 增強多工與 背景處理。 |
| 功耗效率 | +40%(Dimensity 9400) | 顯著延長電池 續航;對 5G/AI 工作負載至關重要。 |
| GPU 效率 | +44% 功耗節省 | 行動裝置「主機級」遊戲 而不觸發熱 節流。 |
| AI 處理(NPU) | 2 倍運算 / 少 33% 功耗 |
支援裝置端 生成式 AI(LLM、Stable Diffusion)。 |
資料綜合自 MediaTek 新聞稿與技術分析。 18
雖然這些增益是製程節點改進(台積電 3 奈米)、架構 變更(全大核心)與物理設計的綜合結果,MediaTek 高層明確將 「智慧 EDA」與 RL 演算法歸功於實現這些指標的佈局。 具體而言,RL 代理協助最佳化複雜 L3 快取與 記憶體控制器層級的放置,縮短線長與延遲,直接提升 功耗效率數字。 6
4.2 跨產業連鎖效應
MediaTek 的成功引發業界「FOMO」(錯失恐懼)浪潮。
競爭者與夥伴皆認識到 RL 驅動的 PPA 最佳化是 競爭必需品。
●** 三星晶圓廠** 報告在關鍵區塊使用類似 AI 驅動流程,將功耗降低 8%, 並在數週而非數月內將時序改善逾 50%。 22
● 學術驗證: 哈佛、紐約大學與喬治亞理工教授將 AlphaChip 方法稱為現代研究的「基石」,驗證這是 根本科學進展,而非僅是產品功能。 6
5. 超越佈局規劃:標準單元與佈線
Veriprajna 的願景超越大型巨集區塊的放置。RL 革命是 分形的;它適用於巨觀與微觀尺度。
5.1 NVIDIA NVCell:微觀最佳化
Google 聚焦「巨集」視角,NVIDIA Research 則鎖定微觀世界的 標**準單元佈局 。**標準單元(如 NAND 閘或正反器)是數位 設計的原子單位。最佳化這些單元的內部佈局——排列電晶體與 內部佈線——是涉及 3 奈米/2 奈米層級複雜設計規則檢查(DRC)的 極度細緻工作。
NVIDIA 的 NVCell 框架運用強化學習自動化此流程。
● 方法: NVCell 結合模擬退火做初始放置 與 RL 代理做詳細佈線與 DRC 修復。RL 代理學會「清理」 佈局,移動導線與通孔以滿足製造規則,同時最小化 面積。
●** 結果:** NVCell 生成的佈局面積 92% 小於或等於 專家佈局工程師手繪版本,且 零人為介入。
● 意涵: 縮小標準單元庫本身,使用該庫建造的每顆晶片 都更小、更高效。這是乘數優勢。 7
5.2 佈線前沿
下一個主要障礙是** 佈*線 ——在 10–15 層金屬上 以數百萬條導線連接已放置元件。這是規模驚人的 3D 迷宮求解問題。傳統 佈線器(如 A 搜尋)依序佈線。先佈 Net A,再 Net B。到 Net Z 時,板面已擁擠,導致擁塞與長繞道。
RL 代理正被開發用於「擁塞感知」佈線。將佈線視為 多代理路徑規劃問題,AI 可預見擁塞。佈線 Net A 的代理 可能刻意選稍長路徑,為 Net B 保留關鍵通道, 而它從 GNN 嵌入「知道」Net B 是時序關鍵路徑。此「協作」 遠見對序貫啟發式不可能,卻對在全域 獎勵函數上訓練的 RL 代理很自然。 6
6. Veriprajna 方法:企業的深度 AI
Google 與 NVIDIA 的例子代表超規模研發的巔峰。然而,對更廣泛的半導體市場——汽車、IoT、工業與消費 電子——採用 RL 並非複製 GitHub 儲存庫那麼簡單。開源研究論文與量產級流片流程之間 存在巨大鴻溝。 Veriprajna 的存在就是為了橋接此鴻溝。 6.1 「包裝層」與「深度 AI」的區別
今日許多顧問公司提供「EDA 的 AI」,實則只是 LLM
包裝層——為舊工具寫 Tcl 腳本的聊天機器人。雖對生產力有用, 卻非變革性。它不會改變晶片的物理。 Veriprajna 提供 深度 AI 解決方案 。我們不只自動化工具的 介面;我們
替換迴路內的** 最佳**化引擎。我們的代理直接與網表 與物理引擎互動,基於 RL 策略而非僅 腳本指令,做出數百萬次放置決策。 6.2 資料工廠挑戰
RL 進入的主要障礙是資料。RL 代理渴求資料。Google 享有
統一儲存庫收錄每顆曾設計 TPU 的奢侈。多數企業擁有「髒」資料——舊 統一儲存庫收錄每顆曾設計 TPU 的奢侈。多數企業擁有「髒」資料——舊 設計散落各伺服器,格式不一(LEF/DEF、GDSII),命名 慣例不一致。 Veriprajna 的解決方案:我們建構 EDA 資料湖。我們的基礎設施攝取舊設計 檔案,清理與正規化,轉換為「離線 RL」訓練資料集。我們 將貴公司十年流片歷史轉為競爭資產,訓練客製 「企業大腦」,體現設計團隊過去十年的集體智慧。6 6.3 「黑箱」信任問題
主要文化障礙是神經網路的「黑箱」本質。資深工程師看著
「異域」RL 佈局問:「為何把時脈分頻器放那裡?是幻覺嗎?」 Veriprajna 的解決方案:我們為 EDA 實作可解釋 AI(XAI)。儀表板不只 顯示最終結果;還顯示「獎勵軌跡」。我們視覺化代理的 決策過程,突顯敏感度圖,顯示哪些約束 (擁塞、時序、熱)驅動特定放置決策。我們證明「異域」 放置並非隨機,而是對人類工程師 未察覺擁塞熱點的計算回應。 6.4 基礎設施與成本 27
訓練 RL 代理需要大量 GPU 運算。批評者指出訓練的高運算
成本是缺點。然而,這是資本支出與營運支出的權衡。 ● 傳統: 工程薪資與數月延遲(機會成本)的高營運支出。
●** RL 驅動**: 高初始運算資本支出(訓練),但推論(生成新設計)的邊際成本近零,
並大幅縮短上市時間。 Veriprajna 透過遷移學習最佳化此點。我們在公開資料(OpenROAD、RISC-V)上 預訓練晶片設計「基礎 模型」。客戶專案僅需在其特定 IP 上「微調」,相較從零訓練, 運算成本降低數個數量級。12 7. 競爭格局:Veriprajna 對商用 工具
EDA 巨頭 Synopsys 與 Cadence 也已認識 AI 趨勢。將
Veriprajna 的深度 AI 方法與這些既有方案定位很重要。 表 2:AI-EDA 解決方案比較分析
功能
| Synopsys DSO.ai | Cadence | Cerebrus Veriprajna(深度 |
RL) 核心技術 |
|---|---|---|---|
| AI 驅動設計 | 空間探索 (DSE)。調校工具 參數。 強化 |
學習用於 參數調校與 流程最佳化。 深度 RL 直接 |
物理設計。 代理直接 放置 巨集/單元。 最佳化 |
| 層級 後設最佳化: |
以不同 設定(旋鈕)多次 執行標準工具。 流程 最佳化: |
自動化 RTL 到 GDS 流程 步驟。 原子 最佳化: |
代理_就是_放置器。 它玩放置 博弈。 「異域」能力 低。仍依賴 |
| 底層 | 解析式放置器 引擎。 解析式放置器 引擎。 |
中。可找到 受舊引擎 約束。 高。 生成 根本新穎 |
拓撲 (「異域佈局」)。 新穎拓撲 (「異域佈局」)。 |
| 學習範圍 | 專案特定。 | 強化 | 基礎 |
| Col1 | 常為新設計 重新學習。 |
學習與部分 遷移 能力。 |
模型。在龐大資料集上 預訓練; 真正的跨 架構 遷移學習。 |
|---|---|---|---|
| 透明度 | 黑箱產品。 | 專有 生態系。 |
開放/可客製。 客戶擁有 訓練策略與 權重。 |
| 經濟模式 | 昂貴授權 附加模組。 |
昂貴授權 附加模組。 |
解決方案/服務。 我們在 貴組織內 建構能力。 |
分析基於產業文獻與技術比較。 22
雖然 DSO.ai 與 Cerebrus 是最佳化既有流程 參數 的優秀工具 (例如找到正確綜合努力等級),Veriprajna 旨在以學得策略替換 演算法 本身。我們不只調校引擎;我們以電動馬達 替換內燃機。
8. 結論:後摩爾時代的戰略路線圖****
摩爾定律已死。物理驅動縮放的可靠心跳已停止。但運算需求——由 我們正在討論的 AI 革命本身驅動——正指數 加速。供給(矽晶縮放)與需求(AI 運算)之間的 背離,創造只有 AI 本身能解決的危機。
強化學習是除顫器。它透過解鎖 新維度的縮放重啟產業心臟:複雜度縮放 。若無法讓電晶體 大幅更小,我們必須更聰明地排列它們。
對半導體企業而言,前路清晰但充滿挑戰。它需要 工程文化的轉型:
1. 擁抱異域: 超越對人類可讀「曼哈頓」佈局的偏見。信任 經物理驗證的代理結果。
2. 投資資料基礎設施: 舊設計是最有價值的 IP。清理 、儲存並用於訓練 AI。
3. 從人力轉向運算: 未來精英設計團隊不是 50 名工程師手動佈局,而是 5 名工程師引導在 GPU 叢集上運行的 RL 代理艦隊。
Veriprajna 已準備好成為此轉型的夥伴。我們不賣工具;我們 交付設計不可能之物的能力。我們正在建構晶片設計 晶片的未來,創造將產業帶遠摩爾定律 限制之外的智慧遞迴迴路。
棋盤已擺好。棋子正在移動。是時候讓代理下這盤棋了。
附錄:技術詞彙
Edge-GNN(圖神經網路): 處理圖結構資料 (節點與邊)的神經網路。「以邊為中心」表示網路明確 更新導線(邊)與閘(節點)的表示,對 理解佈線擁塞至關重要。
HPWL(半周長線長): 估計連接一組接腳所需導線長度的標準啟發式。計算為包圍所有接腳 邊界框周長的一半。最小化 HPWL 是 最小化延遲與功耗的主要代理。
MDP(馬可夫決策過程): 建模決策的數學框架, 在結果部分隨機、部分受決策者 控制的情境中。它是強化學習的正式基礎。
PPO(近端策略最佳化): 流行的強化學習演算法,在 實作難度、樣本複雜度與調參難度之間取得平衡。 OpenAI(ChatGPT 訓練)與 Google(AlphaChip)均使用此演算法。
遷移學習: 為一任務開發的模型 作為第二任務模型的起點。在 EDA 中,這意味著用設計 CPU 學得的 「直覺」協助設計 GPU。
參考文獻
AI Chips Are Scaling Faster Than Moore's Law Ever Predicted - VKTR.com,2025 年 12 月 11 日閱覽, https://www.vktr.com/ai-technology/the-end-of-moores-law-ai-chipmakers-say-its-already-happened/
AI's Computing Revolution Outpaces Moore's Law - Przemek Chojecki - Medium,2025 年 12 月 11 日閱覽, https://pchojecki.medium.com/ai-moores-law-18391003432e
google-research/circuit_training - GitHub,2025 年 12 月 11 日閱覽, https://github.com/google-research/circuit_training
Floorplanning,2025 年 12 月 11 日閱覽, https://cc.ee.ntu.edu.tw/~ywchang/Courses/PD_Source/EDA_floorplanning.pdf
Simulated annealing algorithms: an overview - IEEE Circuits and Devices Magazine,2025 年 12 月 11 日閱覽,http://arantxa.ii.uam.es/~die/[Lectura%20EDA]%20Annealing%20-%20Rutenbar.pdf
How AlphaChip transformed computer chip design - Google DeepMind,2025 年 12 月 11 日閱覽, https://deepmind.google/blog/how-alphachip-transformed-computer-chip-design/
Invited- NVCell: Standard Cell Layout in Advanced Technology Nodes with Reinforcement Learning - IEEE Xplore,2025 年 12 月 11 日閱覽, https://ieeexplore.ieee.org/iel7/9585997/9586083/09586188.pdf
AI, native supercomputing and the revival of Moore's Law | APSIPA Transactions on Signal and Information Processing - Cambridge University Press & Assessment,2025 年 12 月 11 日閱覽, https://www.cambridge.org/core/journals/apsipa-transactions-on-signal-and-information-processing/article/ai-native-supercomputing-and-the-revival-of-moores-law/3791FFFAC8FCA71718FA360D0C8FC0D8
AI Chips: What They Are and Why They Matter,2025 年 12 月 11 日閱覽, https://knowen-production.s3.amazonaws.com/uploads/attachment/file/5306/AI-Chips_E2_80_94What-They-Are-and-Why-They-Mater.pdft
AI Designed an Alien Chip That Works, But Experts Can't Explain Why - Futurism,2025 年 12 月 11 日閱覽, https://futurism.com/the-byte/ai-designed-chip
FLOORPLANNING CHALLENGES IN EARLY CHIP PLANNING,2025 年 12 月 11 日閱覽, https://ceca.pku.edu.cn/docs/20180608094752776081.pdf
How Google Improves Computing Chip Design with Reinforcement Learning | by Devansh,2025 年 12 月 11 日閱覽, https://machine-learning-made-simple.medium.com/how-google-improves-computing-chip-design-with-reinforcement-learning-d59fa5fb0f73
How Google's AlphaChip is Redefining Computer Chip Design - Unite.AI,2025 年 12 月 11 日閱覽, https://www.unite.ai/how-googles-alphachip-is-redefining-computer-chip-design/
State, Action and Reward Space – AI Robotics - Reinforcement Learning Path,2025 年 12 月 11 日閱覽, https://www.reinforcementlearningpath.com/spaces/
Chip Placement With Deep Reinforcement Learning | PDF | Mathematical Optimization - Scribd,2025 年 12 月 11 日閱覽, https://www.scribd.com/document/740911130/Chip-Placement-with-Deep-Reinforcement-Learning
arXiv:2411.10053v1 [cs.AI] 15 Nov 2024,2025 年 12 月 11 日閱覽, https://arxiv.org/pdf/2411.10053
Google Alphachip Redefines How Computer Chips Work - First Movers AI,2025 年 12 月 11 日閱覽, https://firstmovers.ai/googles-alphachip/
MediaTek Dimensity 9400 | Efficiency and AI Performance,2025 年 12 月 11 日閱覽, https://www.mediatek.com/press-room/mediateks-dimensity-9400-flagship-soc -ofers-extreme-performance-and-eff iciency-for-the-latest-ai-experiences
MediaTek's Next Chip Will Boost Low-Power AI in Next Year's Top Android Phones - CNET,2025 年 12 月 11 日閱覽, https://www.cnet.com/tech/mobile/mediateks-next-chip-will-boost-low-power-ai-in-next-years-top-android-phones/
MediaTek Dimensity 9500 Unleashes Best-in-Class Performance, AI Experiences, and Power Efficiency for the Next Generation of Mobile Devices - PR Newswire,2025 年 12 月 11 日閱覽, https://www.prnewswire.com/news-releases/mediatek-dimensity-9500-unleashes-best-in-class-performance-ai-experiences-and-power-efficiency-for-the-next-generation-of-mobile-devices-302562586.html
MediaTek Announces Breakthrough in Artificial Intelligence and Chip Design,2025 年 12 月 11 日閱覽, https://www.mediatek.com/tek-talk-blogs/mediatek-announces-breakthrough-in-artificial-intelligence-and-chip-design
Cadence Extends Digital Design Leadership with ML-based Cerebrus - AI-Tech Park,2025 年 12 月 11 日閱覽, https://ai-techpark.com/cadence-extends-digital-design-leadership-with-ml-based-cerebrus/
NVCell: Generate Standard Cell Layout in Advanced Technology Nodes with Reinforcement Learning - Research at NVIDIA,2025 年 12 月 11 日閱覽, https://research.nvidia.com/publication/2020-12_nvcell-generate-standard-cell-layout-advanced-technology-nodes-reinforcement
NVCell: Standard Cell Layout in Advanced Technology Nodes with Reinforcement Learning,2025 年 12 月 11 日閱覽, https://research.nvidia.com/publication/2021-12_nvcell-standard-cell-layout-advanced-technology-nodes-reinforcement-learning
AI boost for standard cell layout at 3nm ... - eeNews Europe,2025 年 12 月 11 日閱覽, https://www.eenewseurope.com/en/ai-boost-for-standard-cell-layout-at-3nm/
The False Dawn: Reevaluating Google's Reinforcement Learning for Chip Macro Placement,2025 年 12 月 11 日閱覽,https://arxiv.org/html/2306.09633v10
The Five Biggest Challenges in Enterprise AI Adoption - Vantiq,2025 年 12 月 11 日閱覽, https://vantiq.com/blog/the-five-biggest-challenges-in-enterprise-ai-adoption/
The Limits Of AI's Role In EDA Tools - Semiconductor Engineering,2025 年 12 月 11 日閱覽, https://semiengineering.com/the-limits-of-ais-role-in-eda-tools/
AI in Test Engineering: Use Cases, Tools, and Real-World Impact - Tessolve,2025 年 12 月 11 日閱覽, https://www.tessolve.com/blogs/ai-in-test-engineering-use-cases-tools-and-real-world-impact/
Is Synopsys more user friendly to beginners compared to Cadence? : r/chipdesign - Reddit,2025 年 12 月 11 日閱覽, https://www.reddit.com/r/chipdesign/comments/1ica16y/is_synopsys_more_user_friendly_to_beginners/
EDA Deep Dive - Part 3: The AI Era - by Bharath Suresh - Chip Insights,2025 年 12 月 11 日閱覽, https://chipinsights.substack.com/p/eda-deep-dive-part-3-the-ai-era
DSO.ai: AI-Driven Design Applications - Synopsys,2025 年 12 月 11 日閱覽, https://www.synopsys.com/ai/ai-powered-eda/dso-ai.html
Cadence Cerebrus In SaaS And Imagination Technologies Case Study,2025 年 12 月 11 日閱覽, https://semiengineering.com/cadence-cerebrus-in-saas-and-imagination-technologies-case-study/
更喜歡視覺化的互動式體驗?
透過可導覽的章節與資料視覺化,以互動式格式探索本文的關鍵發現、統計數據與架構。
常見問題解答
強化學習如何處理晶片佈局規劃?
RL 將晶片佈局規劃視為表述為馬可夫決策過程的序貫博弈。矽晶晶粒是棋盤,網表元件是棋子,在特定座標放置元件是一步棋。基於邊的圖神經網路建立捕捉電路拓撲連通性的嵌入,餵入策略與價值網路以預測最佳放置。代理最佳化線長、擁塞、密度與時序的複合獎勵。
什麼是異域佈局?為何優於人類設計?
異域佈局是 AI 生成的平面圖,在人類工程師眼中顯得混沌——巨集散佈於不規則叢集而非整齊的曼哈頓行列。它們表現更優,因為人類對稱偏好是認知舒適產物,而非物理最優。RL 代理忠於物理成本函數,發現最小訊號延遲常需沿可用空間精巧編織,而非沿主軸的直角路徑。
AI 驅動晶片設計與 Synopsys DSO.ai、Cadence Cerebrus 有何不同?
DSO.ai 與 Cerebrus 執行後設最佳化——以不同參數設定執行既有 EDA 工具以找到更佳配置。Veriprajna 的方法以 RL 代理直接決定巨集座標,替換放置引擎本身。此「原子最佳化」生成舊工具約束內不可能的新穎拓撲,而跨晶片世代的遷移學習創造複利式設計智慧。
自信打造您的 AI。
與一支在打造新世代企業級 AI 方面擁有深厚經驗的團隊攜手合作。讓我們協助您設計、建置並部署值得信賴的 AI 策略。
Veriprajna 深度科技顧問公司 專精於為醫療、金融及法規監管領域打造攸關安全的 AI 系統。我們的架構均依循既定規範進行驗證,並備有完整的合規文件。