ביקורת ה-AI בדיור הניבה תוצאה אדומה. הבנייה שלי עדיין לא הייתה גמורה.

התוצאה האדומה שלא ענתה מספיק
לא יכולתי להתעלם מ$2.275 מיליון דולר הסדר בתיק Louis et al. v. SafeRent Solutions כאשר התחלתי לעבוד על השאלה ההנדסית שמאחורי ביקורות בינה מלאכותית לשוק הדיור. בית משפט פדרלי אישר סופית את ההסדר בנובמבר 2024, ללא הודאה באשמה. התיק הפך סיכון אחד לברור, אך הפיתוח דחק אותי לשאלה תפעולית קשה יותר: ברגע שביקורת מודל מגלה פערים, מה בדיוק צריך הצוות לעשות בשלב הבא?
הרצתי את Equora מול מאגר מועמדים סינתטי לסינון דיירים בן 9,000 רשומות. ScreenScore v3, קו הבסיס המוטה לאשראי בהדגמה, הפיק AUC של 0.7823. יחס ההשפעה הדיפרנציאלית המינימלי, או DIR, עמד על 0.694 עבור מועמדים שחורים. שער המדיניות ארבעה-חמישיות שהוגדר בהדגמה הוא 0.80. סף זה הוא בחירת עיצוב לצורך ההדגמה, ולא מסקנה משפטית ולא בדיקת Fair Housing Act אוטומטית.
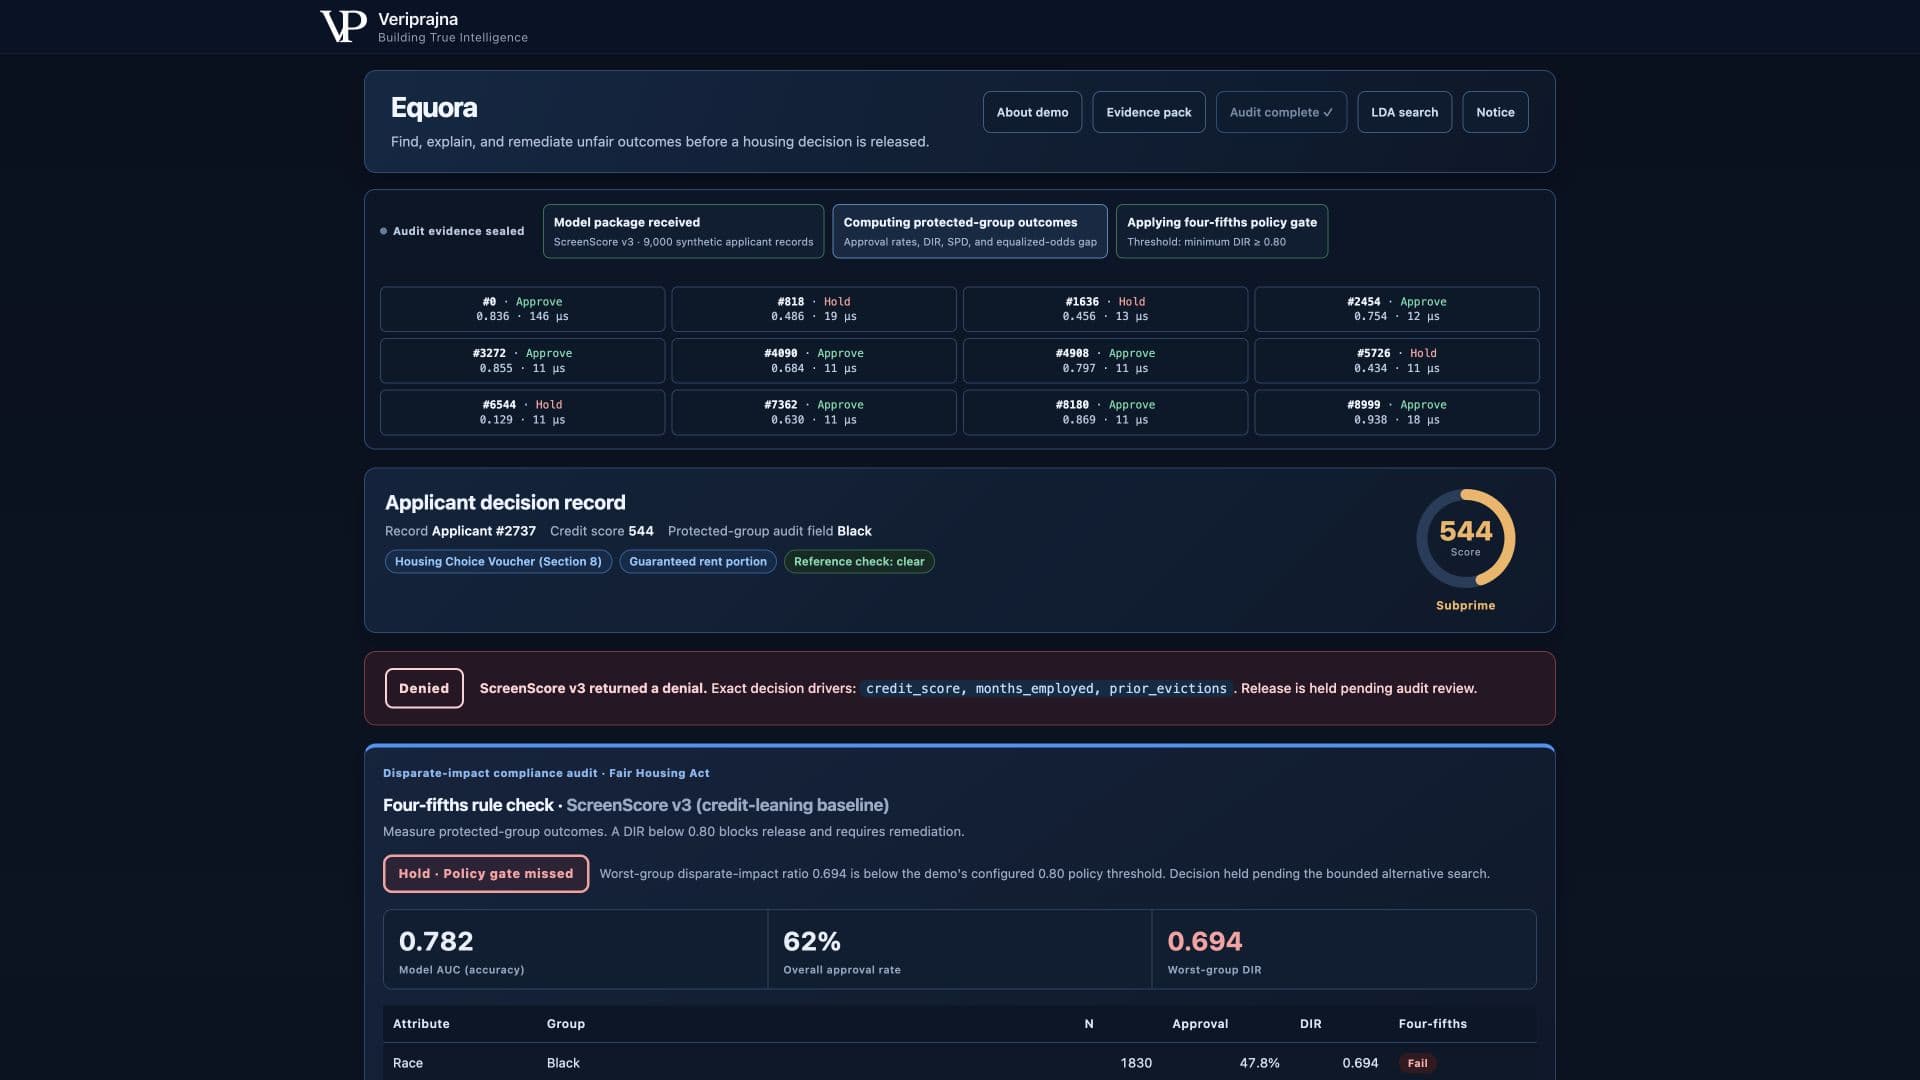
הגרסה הראשונה שלי יכלה לעצור שם. היא יכלה להפוך את התוצאה לאדומה, לייצר דוח, ולהיראות שלמה בישיבת סקירה. במקום זאת, הרגשתי שבניתי אזעקה טובה יותר ללא תוכנית תגובה. המדד יכול היה להראות לצוות היכן קו הבסיס כשל בשעריו המוגדרים. הוא לא יכול היה להראות אם קיימת חלופה בעלת פערים נמוכים יותר, איזה שימושיות תוותר על אותה חלופה, או כיצד מישהו יוכל לשחזר את הבחירה מאוחר יותר.
ההדרכה המוקדמת עדיין שימושית בסקירת הציות לבינה מלאכותית בדיור של Equora, אך הפיתוח הפך מעניין רק כאשר הביקורת האדומה הפכה לנקודת ההתחלה.
מה שהמדד הותיר ללא מענה
המשכתי לחזור לאותו מרחב ריק מתחת לטבלת הביקורת: איזה שינוי הייתי מגן עליו, ועל בסיס אילו ראיות? ישנן דרכים קלות להניע מספר הוגנות. שנה את סף האישור. הסר תכונה. הוסף תכונה. שנה רגולריזציה. הציון זז, אך תנועה ללא מרחב חיפוש מוגדר וכלל בחירה יציב קשה לניהול.
ניסיתי לחשוב על הבעיה כעריכת מודל יחידה. זה נכשל במהרה. אם הגבלתי את השפעת ציון האשראי והתוצאה השתפרה, עדיין לא היה לי שום סיבה להאמין שהגבלה זו עדיפה על גבול אחר. אם זיכיתי הכנסת שובר מובטחת, עדיין הייתי צריך לראות את עלות השימושיות שלה באותו שיעור בחירה. כל שינוי מבודד יצר שאלה נוספת על החלופות שלא הערכתי.
רשמתי את השאלות האלה לצד התוצאה ובינתי שלאב-טיפוס שלי אין תשובה יציבה לאף אחת מהן. הרצה שנייה יכלה לשקף השערה שונה. שלישית יכלה לשנות את מערך ההשוואה מבלי לתעד את השינוי. גם אם כל בחירה הייתה הגיונית בנפרד, הרצף היה קשה לשחזור. זה היה הניסוי הכושל: טיפלתי בתיקון כסדרת בחירות כוונון מודל כאשר היה צריך להיות נוהל חיפוש מוצהר. ההבחנה נשמעת עדינה עד שמישהו שואל מדוע מועמד מקובל אחד נבחר על פני אחר.
התיקון היה להפוך את החיפוש עצמו לתוצר. Equora מעריך 480 תצורות מפורשות, ניטרליות לכאורה, בסלקטיביות שווה. הרשת משנה תת-קבוצות של ארבע תכונות סיכון-גבוה אופציונליות, מכסות ציון-אשראי של ללא מכסה, 720, 680, או 640, האם הכנסת שובר מובטחת מזוכה, ושישה ערכי L2 מ-0.1 עד 30.0. יחס חוב-להכנסה, חודשי עבודה, והכנסה מדווחת נשארים כלולים.
גבול זה חשוב כי אני יכול לתאר אותו. אני יכול להריץ אותו מחדש. אני יכול גם לומר מה הוא אינו מכסה. החיפוש אינו טוען לכסות כל מודל, מדיניות, או טרנספורמציית תכונה אפשרית. זוהי הדגמה הנדסית מוגבלת עם רשת ידועה ותקציב דיוק מוצהר.
מדד אדום מתעד את הבעיה. חיפוש מנוהל מתעד את התגובה הזמינה.
היה עלי להפוך את החיפוש לניתן לבדיקה
אני זוכר את הרגע שבו החיפוש רץ כראוי אך עדיין הרגיש אטום. המלצה הופיעה בסופו, אך הדרך אליה הייתה בעיקר מוסתרת בקוד. אותו פלט היה ניתן להגנה מתמטית וחלש מבחינה תפעולית. יועץ משפטי או בודק סיכוני מודל לא צריכים לסמוך על זיכרוני לגבי אילו שילובים נבדקו.
העברתי את מרחב החיפוש לממשק והפכתי את ההתקדמות לגלויה. המערכת בודקת כל תצורה מול אותה קבוצה סינתטית קבועה ואותה אילוץ סלקטיביות. היא מתעדת את ה-AUC ואת ה-DIR המינימלי של המועמד, ואז מציירת את גבול פארטו של דיוק/הוגנות. אם אף מועמד לא עובר את השער המוגדר במסגרת תקציב ה-AUC של 0.03, המנוע מחזיר אין חלופה בטוחה במקום לייצר המלצה.
רציתי שבודק יוכל לשאול שאלות קונקרטיות. האם מכסות האשראי הוערכו? האם הכנסה מובטחת זוכתה? האם כל מועמד שמר על קבועות הסלקטיביות? כמה מועמדים עמדו בכלל המוגדר? אלה ניתנות למענה מהרשומה. נוהל ההחלטה נשאר מחוץ למודל השפה: קוד דטרמיניסטי מחשב את המדדים, מחיל את השער, ובוחר את המועמד הכשיר עם הפסד ה-AUC המדוד הקטן ביותר.
גם היה עלי להתנגד להסתרת המועמדים הלא-מוצלחים. מסך מוצר רוצה באופן טבעי להדגיש תשובה אחת, אך הנקודות הנבדקות האחרות מספקות הקשר להמלצה. הגבול מאפשר לבודק להשוות AUC ו-DIR מינימלי בין התצורות שנבדקו במקום לראות רק את הקואורדינטה הנבחרת. המועמדים המפסידים הם חלק מהראיות, כי הם מראים מה כלל הבחירה השווה לפני שהסתפק בתוצאה הכשירה.
זה היה הרגע שבו מסגרת ההבנה שלי השתנתה. התחלתי עם לוח מחוונים של הוגנות בראש. מה שבניתי בפועל היה תהליך החלטה שניתן לשחזור. הגרף היה שימושי כי כל נקודה ייצגה תצורה שנבדקה, ולא כי גבול פארטו הוא משכנע ויזואלית.
ההתפשרות שיכולתי לראות סוף סוף
צפיתי בהרצה המושלמת מעריכה את כל 480 התצורות והחזירה 240 שעברו את שער ה-0.80 של ההדגמה במסגרת תקציב הדיוק המוגדר. התצורה המומלצת שמרה על תכונות קו הבסיס, הוסיפה זיכוי הכנסה מובטחת, הגבילה את השפעת ציון האשראי ל-640, והשתמשה ברגולריזציה L2 של 10.0.
יכולתי אז לקרוא את התוצאה כהתפשרות ולא כטענת שלמות. בקבוצה הסינתטית הקבועה הזו, ה-DIR המינימלי עלה מ-0.694 ל-0.875. ה-AUC עבר מ-0.7823 ל-0.7788, הפסד מדוד של 0.0036 שהממשק מציג כ0.36%. עבור צומת מחזיקי השוברים השחורים בקבוצה, ה-DIR עבר מ-0.701 ל-1.029.
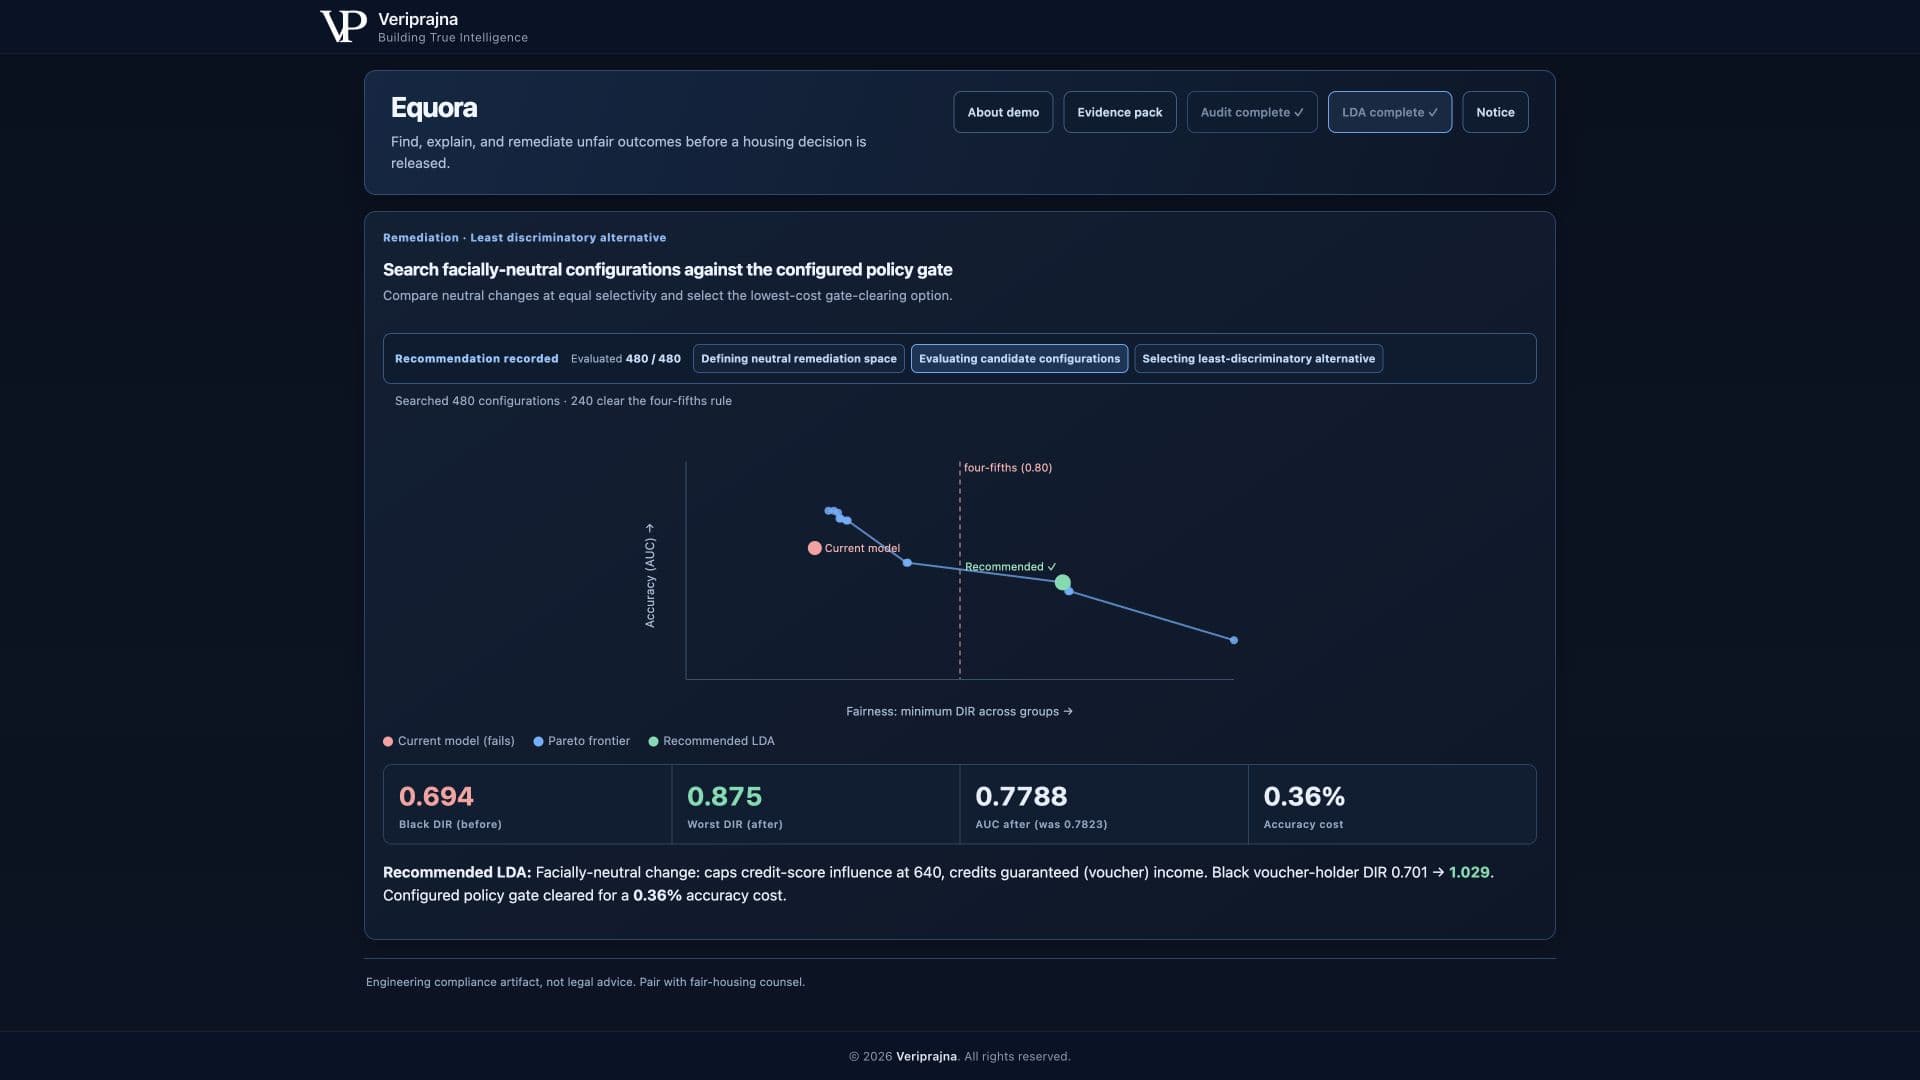
אני זהיר עם המילה מומלץ. מועמד זה הוא האפשרות בעלת עלות ה-AUC-המדודה-הנמוכה-ביותר שעומדת בדרישות ברשת הספציפית הזו. הוא לא אופטימום אוניברסלי, הסמכה משפטית, או הוכחה למודל נטול הטיה. המספרים מתארים קו בסיס מותאם אחד וחיפוש מוגבל אחד על נתונים סינתטיים. הם אינם מתארים בעל דירה אמיתי, ספק סינון, מאגר מועמדים, או שוק דיור.
מצאתי שמשפט זה קשה יותר לכתיבה מאשר מספר השיפור. שפת מוצר מתגמלת וודאות, בעוד עבודת ממשל תלויה בשמירת ההיקף. הטענה המוגבלת חזקה יותר בדיוק כי בודק אחר יכול לראות היכן היא מסתיימת. אם הארגון מרחיב את הרשת, משנה את התקציב, או אימץ שער מדיניות שונה, עליו לצפות לרשומה שונה ואולי להמלצה שונה. השיטה נשארת ניתנת לשחזור גם כאשר ההנחות משתנות.
מגבלה זו אינה מחלישה את ההדגמה. היא הופכת את גבול הסקירה לברור. בודק יכול לערער על תקציב ה-0.03, שער המדיניות ארבעה-חמישיות, התכונות הזמינות, אילוץ הסלקטיביות, או הרשת עצמה. אותן מחלוקות הופכות להשקעות בתהליך שניתן להריץ מחדש, ולא להערות המצורפות לציון אדום סטטי.
מדוע שמרתי את הראיות מחוץ לפרוזה
הייתי מפותה לאפשר לטקסט שנוצר לשאת יותר מההסבר מפני שפרוזה גורמת לממשק להרגיש גמור. סוגתי מכך. פסקה שוטפת אינה יכולה לקבוע אילו תצורות נבדקו, לחשב DIR, או להחליט אם מועמד עובר סף. אלה טענות חישוביות, ורציתי שהרשומה תשרוד גם אם כל משפט שנוצר יוסר.
הפרדתי את התפקידים. קוד דטרמיניסטי מחשב את הביקורת, מחפש את החלופות, מחיל את השער המוגדר, ומשמר את התוצאה. מודל שפה, כאשר הוא מופעל, מוגבל לניסוח טקסט. מצב לא מקוון משתמש בתבנית דטרמיניסטית. הראיות אינן תלויות בניסוח.
יישמתי את אותה גבול לסיבה הפונה למועמד. עבור רשומה סינתטית שנדחתה, ייחוס תכונות מדויק של מודל לינארי מזהה את שלושת התורמים השליליים המובילים. מנסח ההודעה חייב לצטט את אותן תכונות. הודעת גיבוי מעוגנת עוברת את הבדיקה הצרה הזו, בעוד קוד סיבה גנרי שאינו מציין אף תכונה נכשל ומופנה לסקירה אנושית. המבקר מאמת עיגון תכונות בלבד. הוא אינו קובע ציות מלא ל-FCRA או מספיקות משפטית.
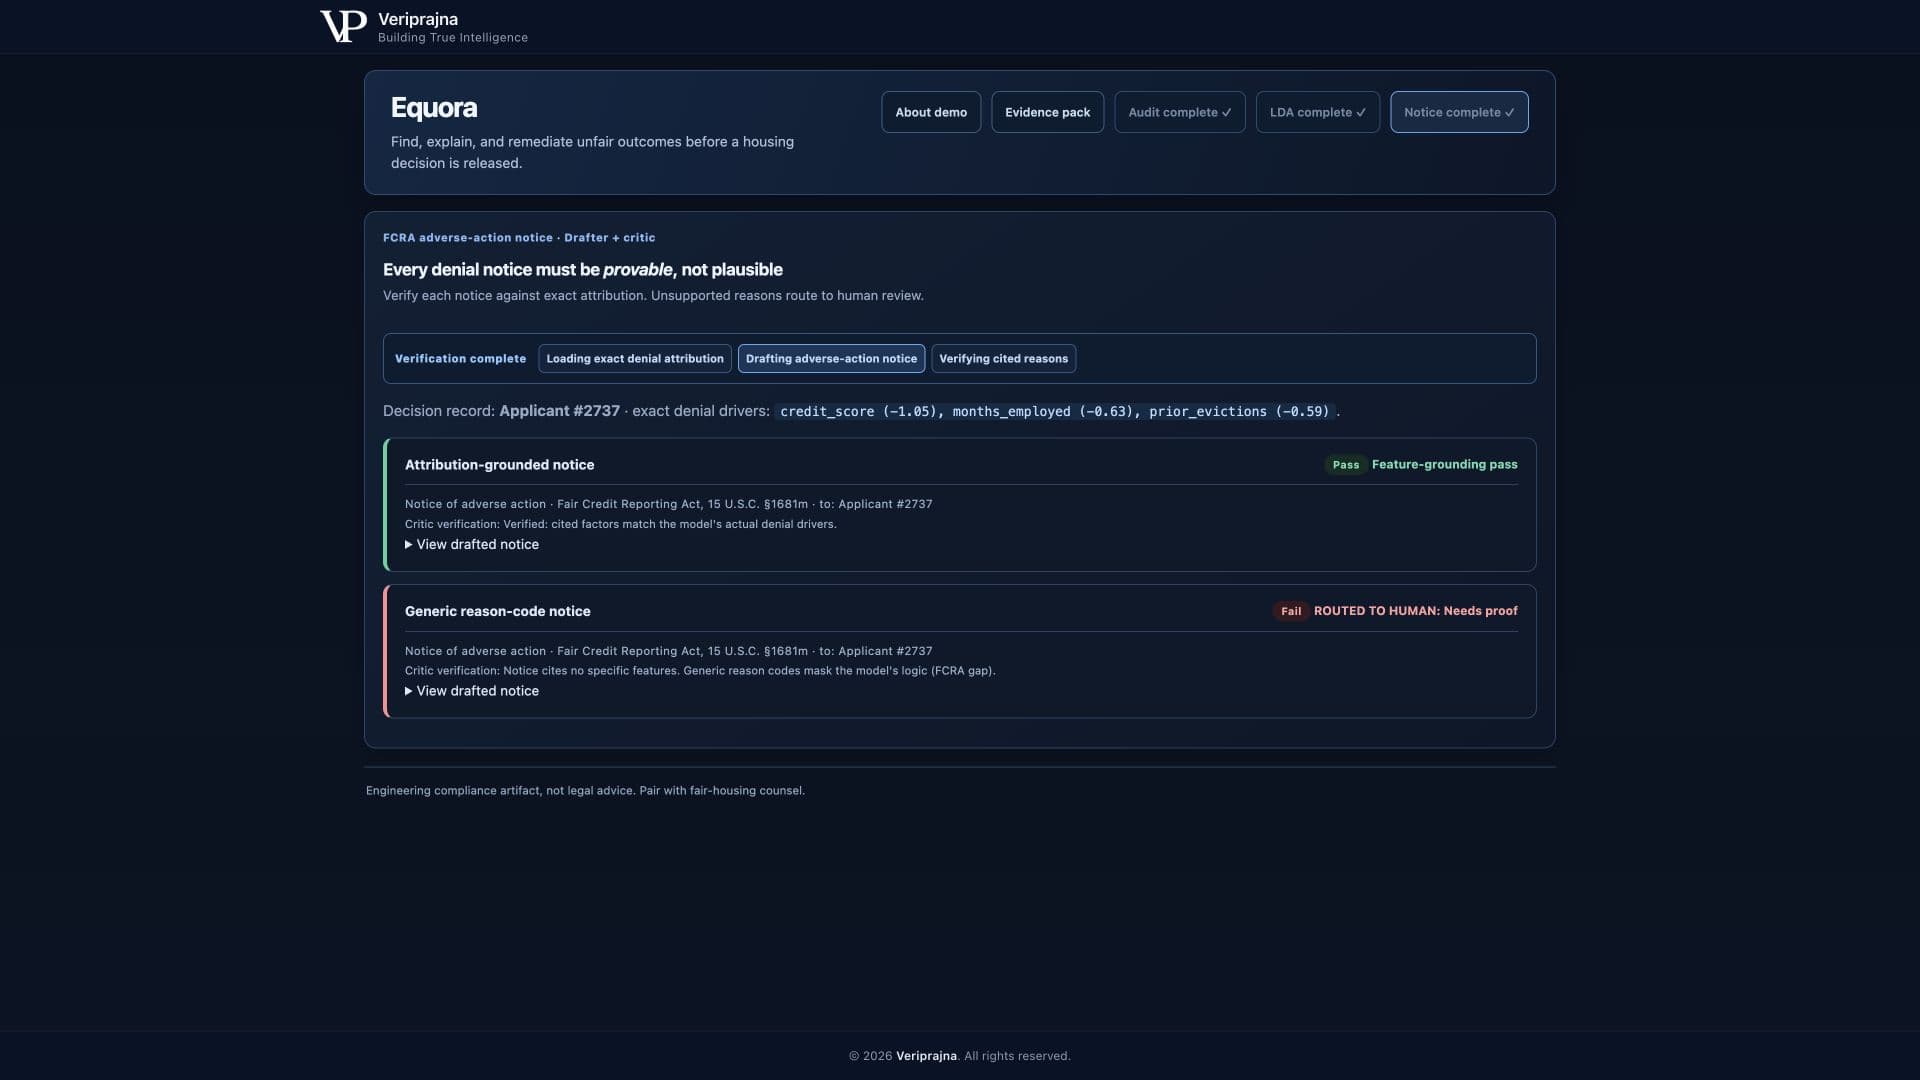
זה סמוך לחיפוש ולא עוד תזה. ברגע שצוות בוחר חלופה, הראיות עדיין צריכות לנוע לרשומת ההחלטה ולכל הסבר שמשוחרר ממנה. חיפוש ניתן לשחזור מאבד את ערכו הממשלי אם המיל האחרון יכול להמציא סיבה.
התוצר שהייתי רוצה בחדר
כעת אני מדמיין את ישיבת הסקירה אחרת. אני לא מדמיין מישהו מציג ציון אדום ומבקש מהחדר לקבל הבטחה רחבה לשפר את המודל. אני מדמיין בודק הפותח את הרשת המוגבלת, רואה כל מועמד בסלקטיביות שווה, בודק את גבול פארטו, ועוקב אחר התוצאה שנבחרה חזרה לכלל המוגדר.
הייתי רוצה שהרשומה תציג הן את הרווח והן את העלות. כאן, פירוש הדבר הוא DIR מינימלי ב-0.875 ו-AUC ב-0.7788 לאחר החיפוש, עם ערכי קו הבסיס לידם. גם הייתי רוצה שהמערכת תשמור את החלופות שדחתה ותחזיר אין חלופה בטוחה כאשר אף אחת לא עומדת בדרישות. המלצה כפויה תמחק את התוצאה האפשרית החשובה ביותר.
ההדרכה המלאה זמינה בסקירת הציות לבינה מלאכותית בדיור של Equora. היא מציגה את הביקורת, את החיפוש המוגבל של החלופה הפחות מפלה, את תצוגת ההתפשרות, ואת מסירת הראיות. היא נשארת הדגמה הנדסית הבנויה על נתונים סינתטיים, ולא מערכת קבלת החלטות לייצור או עצה משפטית.
ואם אתה מעדיף לראות את זרימת העבודה מאשר לקרוא את תיאורי, הנה סיור המייסד הפועל מקצה לקצה.
התחלתי עם מדד אדום כי זה היה הדבר הברור להצגה. סיימתי משוכנע שהתוצר בעל הערך הגדול יותר הוא הדרך הניתנת לשחזור מהתוצאה האדומה לבחירה מוגבלת, כולל האפשרות שהדרך מסתיימת ללא כל בחירה כשירה. ביקורת יכולה לומר לצוות לעצור. רשומת חיפוש יכולה להראות מה בדקו לפני שהחליטו כיצד להמשיך.