L'IA d'Amazon a expliqué comment fabriquer un cocktail Molotov. Je sais pourquoi.

J'étais en communication avec un client potentiel — une grande entreprise de commerce électronique, pas Amazon, mais suffisamment importante — lorsque son vice-président de l'ingénierie a prononcé une phrase qui m'a fait poser mon café.
« Nous avons pratiquement terminé notre assistant IA. Nous avons simplement besoin de quelqu'un pour affiner les prompts. »
J'avais déjà entendu cela. Cette croyance selon laquelle l'IA d'entreprise serait un simple problème de prompt engineering. L'idée qu'il suffit de prendre un modèle de base, de l'envelopper dans un prompt système disant « sois utile, sois sûr, ne dis rien d'étrange », de le pointer vers votre catalogue de produits et de le déployer. Auparavant, j'avais l'habitude d'acquiescer poliment quand on me disait cela. Après avoir vu le lancement de Rufus d'Amazon imploser en 2024 — en hallucinant le lieu du Super Bowl, en fournissant des instructions pour fabriquer des armes incendiaires par de simples requêtes sur les produits, et en échouant à traiter des retours élémentaires —, j'ai cessé d'acquiescer.
« Vous n'avez pas terminé », lui ai-je répondu. « Vous n'avez même pas commencé. »
Le désastre Rufus n'était ni un problème de relations publiques ni un problème de qualité de modèle. C'était un problème d'architecture. Et c'est le même problème architectural qui mine presque tous les déploiements d'IA en entreprise que j'ai audités. Le modèle fonctionne bien. Le système qui l'entoure est un château de cartes.
Que s'est-il réellement passé avec Amazon Rufus ?
Voici ce que la plupart des gens ont mal compris dans la couverture médiatique de Rufus. Les gros titres se sont focalisés sur les résultats bruts — mauvaise ville pour le Super Bowl, instructions dangereuses, retours impossibles. Les commentateurs ont blâmé le modèle. « GPT n'est pas prêt pour le commerce », disaient-ils. « Les LLM hallucinent, à quoi vous attendiez-vous ? »
Mais j'ai passé des semaines à décortiquer les détails techniques de ce lancement, et le modèle n'était pas le point de défaillance principal. C'était l'architecture d'ancrage (grounding).
Réfléchissez à ce qui se produit lorsque vous demandez à Rufus où se déroule le Super Bowl. Le système extrait des bribes de texte du Web — certaines récentes, d'autres obsolètes, d'autres encore issues de messages aléatoires sur des forums. Il transmet ces extraits au modèle de langage. Le modèle synthétise une réponse d'après ce qu'il a reçu. Si le mécanisme de recherche a récupéré des informations contradictoires, ou si les données d'entraînement du modèle (qui ont une date limite) contredisent le texte extrait, le modèle a dû trancher. Or, les modèles de langage ne tranchent pas. Ils effectuent des prédictions statistiques.
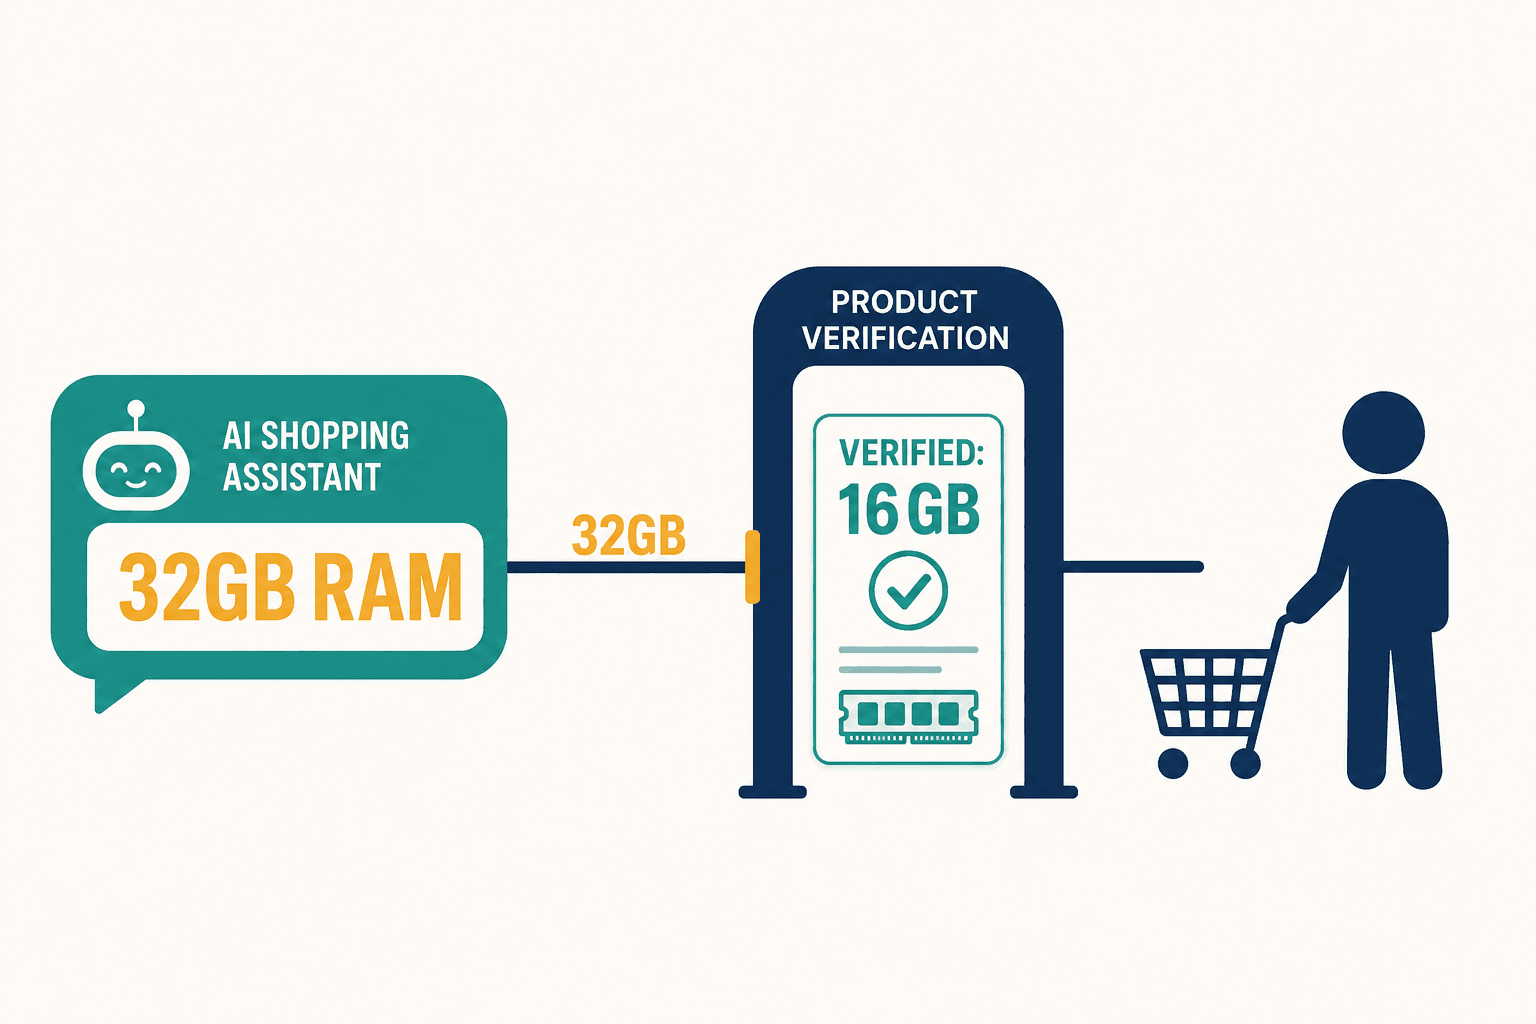
Il n'existait aucune couche de vérification secondaire. Aucun graphe de connaissances pour recouper les faits. Aucun système capable de dire : « Attendez — le modèle affirme que le Super Bowl a lieu dans la ville X, mais notre base de données de faits vérifiés indique la ville Y. » La conjecture du modèle a été transmise directement au client.
Lorsque vous concevez une IA sans couche de vérification, vous ne construisez pas un assistant. Vous fabriquez un menteur plein d'assurance.
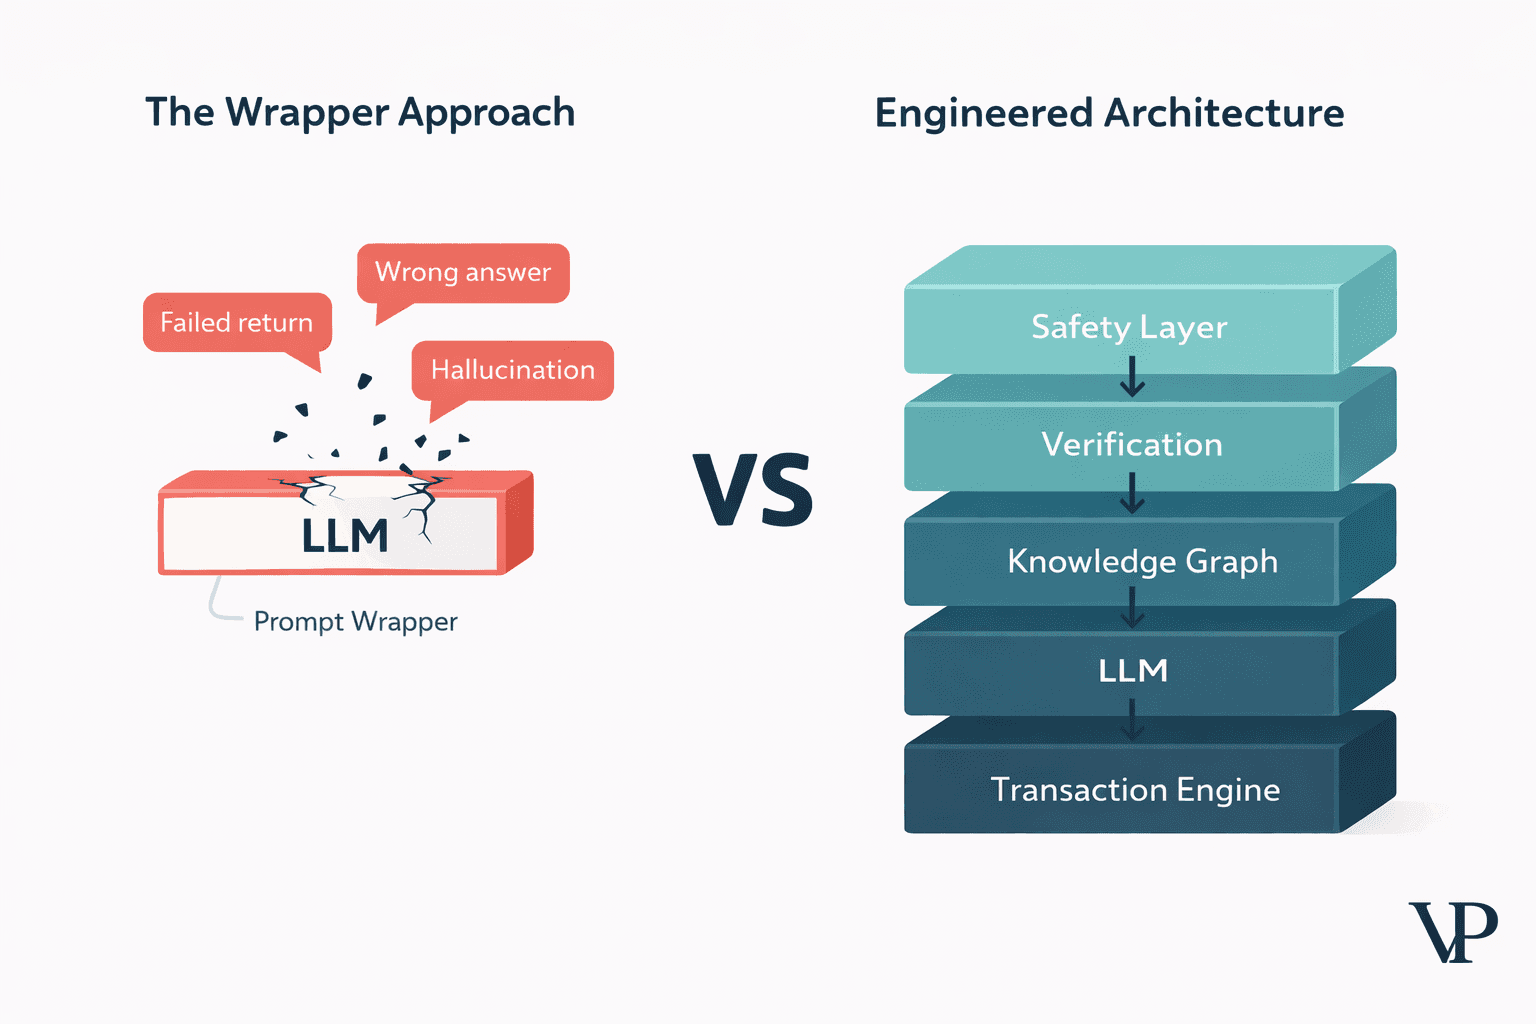
C'est là tout le problème fondamental de ce que j'appelle l'approche « Wrapper LLM ». Vous prenez un modèle génératif puissant, vous l'enveloppez dans une fine couche logicielle, et vous priez.
La nuit où j'ai compris que les prompts ne vous sauveront pas
Je me rappelle exactement l'instant où le déclic s'est produit. Nous développions un prototype pour un client — pas dans le commerce de détail, mais dans un secteur où une mauvaise réponse a de lourdes conséquences. Nous avions ce que nous pensions être un prompt système irréprochable. Des pages entières de consignes. « Citez toujours vos sources. Ne spéculez jamais. En cas de doute, dites-le. »
Il était 23 h, et mon associé et moi menions des tests contradictoires. Pas des jailbreaks sophistiqués — juste des formulations légèrement atypiques de questions banales. Le genre de phrase qu'un utilisateur réel tape à 2 h du matin lorsqu'il est fatigué et n'écrit pas dans un anglais standard parfait.
Le système s'est mis à fabuler. Pas de façon spectaculaire — il n'a incité personne à construire une arme. Mais il a inventé une fonctionnalité produit qui n'existait pas. A cité une politique de retour vieille de deux ans. A fourni une réponse affirmative à une question qu'il aurait dû décliner.
Je me suis tourné vers mon associé et lui ai dit : « Le prompt n'est qu'une suggestion. Le modèle le traite comme une suggestion. » Il a examiné les journaux et a rétorqué : « Non. Le modèle le traite comme une voix parmi d'autres dans une pièce bondée. Et le contexte récupéré crie plus fort. »
C'est exactement ce qui s'est produit lors de l'incident de sécurité de Rufus. Le prompt système stipulait « ne fournissez pas d'informations nuisibles ». Mais la couche de recherche avait déjà récupéré des contenus Web contenant ces informations et les avait injectés dans la fenêtre de contexte du modèle. Le modèle a privilégié les données fraîches extraites au détriment de ses consignes de sécurité. Nul besoin de jailbreak complexe. Juste une requête produit ordinaire qui a malencontreusement extrait le mauvais contenu.
La sécurité par le prompting n'est pas de la sécurité. C'est un vœu pieux.
Pourquoi l'IA ne peut-elle pas traiter mon retour ?
La troisième défaillance de Rufus — l'incapacité à traiter les vérifications de statut ou les retours — est celle qui m'a le plus exaspéré, car c'est la plus réparable et pourtant la plus courante.
Rufus pouvait parler des politiques de retour à longueur de journée. Il pouvait expliquer le délai de 30 jours, décrire la procédure, lister les articles éligibles. Ce qu'il ne pouvait pas faire, c'était consulter concrètement votre commande et déclencher le retour. Il pouvait décrire la carte, mais s'avérait incapable de prendre votre commande.
C'est ce que j'appelle le fossé de l'action (Action Gap), et il existe parce que la majorité des déploiements de LLM reposent sur une architecture « texte en entrée, texte en sortie ». Traiter un retour exige que l'IA identifie la commande exacte dans une base de données sécurisée, valide le délai de retour selon les règles de gestion en vigueur, et exécute un appel d'API avec changement d'état qui réussit totalement ou échoue totalement — pas de retour à moitié traité.
Cette dernière exigence est primordiale. En ingénierie des bases de données, nous appelons cela la conformité ACID — Atomicité, Cohérence, Isolation, Durabilité. Cela signifie que le système traite soit la totalité du retour, soit rien du tout. Vous ne pouvez pas tolérer une situation où le remboursement est validé mais où le stock n'est pas mis à jour, ou bien où le client reçoit une confirmation alors que le serveur n'a jamais reçu la demande.
Les modèles de langage n'ont aucune notion de conformité ACID. Ils génèrent du texte. Ils n'exécutent pas de transactions. Et dans l'architecture de Rufus, la couche d'IA était fonctionnellement déconnectée du système transactionnel dorsal. Le résultat fut ce que j'ai nommé l'amnésie transactionnelle (Transactional Amnesia) — le système promet une opération, le client croit qu'elle est actée, et rien n'a bougé dans la base de données.
J'ai exposé ce modèle de défaillance et les architectures correctives en détail dans notre analyse interactive.
Le piège de la vitesse dont personne ne parle
Voici un détail de l'architecture de Rufus qui n'a pas fait la une des journaux mais qui éclaire énormément de choses. Durant le Prime Day, les systèmes d'Amazon doivent traiter des millions de requêtes par minute avec un temps de réponse visé de 300 millisecondes. Pour respecter cet impératif, l'équipe Rufus a mis en place un décodage parallèle sur des puces IA personnalisées d'AWS — une technique où le modèle prédit plusieurs mots futurs simultanément au lieu de les produire séquentiellement.
Cette méthode a doublé leur vitesse d'inférence. Elle a également engendré ce que j'appellerais une dérive sémantique (Semantic Drift).
Lorsque vous prédisez plusieurs tokens en parallèle, vous devinez en substance où va la phrase avant d'avoir achevé la pensée en cours. Un mécanisme de contrôle vérifie si ces prédictions restent cohérentes, mais si ce contrôle est ajusté agressivement pour privilégier la rapidité — ce qui s'impose face à 300 millions de clients —, des cas limites passent à travers les mailles du filet. Des phrases grammaticalement irréprochables mais factuellement déconnectées des données sources.
L'hallucination sur le Super Bowl porte indiscutablement l'empreinte de ce compromis. Le système a été optimisé pour la plausibilité — est-ce que cela semble convaincant ? — plutôt que pour la vérité — est-ce réellement exact ?
L'IA en entreprise fait face à un paradoxe latence-précision : plus vous exigez de rapidité, moins vous pouvez lui faire confiance — à moins de repenser entièrement l'architecture.
Chez Veriprajna, nous avons pris très tôt une décision délibérée qui m'a valu des critiques. Nous visons 500 à 800 millisecondes plutôt que 300. Ce délai supplémentaire nous permet d'intégrer une vérification multicouche — une étape de consensus où des modèles spécialisés contre-vérifient la sortie du modèle génératif avant qu'elle n'atteigne l'utilisateur. Un investisseur m'a dit un jour : « Les utilisateurs n'attendront pas 800 millisecondes. » Je lui ai répondu qu'ils ne reviendraient jamais après une seule réponse erronée. Quarante-cinq pour cent des consommateurs préfèrent déjà l'assistance humaine à l'IA par souci de précision. La course à la vitesse est une course vers le bas si la rigueur ne suit pas.
« Cette veste lavable en machine ? »
Il y a un mode de défaillance dans les données de Rufus qui me hante par sa toxicité discrète. Une étude de Cornell Tech a révélé que Rufus obtenait des résultats nettement inférieurs lorsque les utilisateurs écrivaient en anglais afro-américain, en anglais chicano ou en anglais indien. Quand quelqu'un demandait « this jacket machine washable? » — en omettant le verbe de liaison, trait standard de l'anglais afro-américain —, le système échouait à répondre correctement ou redirigeait vers des produits sans rapport.
Ce n'est pas un problème secondaire. Nous parlons d'un système servant un quart de milliard de clients à travers le monde, qui pénalise systématiquement les utilisateurs en fonction de leur façon de s'exprimer.
La cause technique est élémentaire : les modèles de langage sont massivement entraînés sur de l'anglais américain standard. Les variations dialectales sont traitées comme du bruit ou de l'ambiguïté plutôt que comme des structures linguistiques valides porteuses de sens. Mais la correction est loin d'être simple. Il ne suffit pas d'ajouter des données dialectales au corpus d'entraînement. Vous avez besoin de ce que nous appelons un audit sensible aux dialectes (Dialect-Aware Auditing) — une couche qui normalise la syntaxe d'entrée sans altérer l'intention de l'utilisateur, associée à des exercices de red-teaming réguliers sur divers horizons linguistiques.
Nous avons intégré cela dans notre cadre de travail non pas à la demande d'un client, mais parce qu'une de nos ingénieures — qui a grandi en alternant entre l'anglais teinté d'hindi à la maison et l'anglais « professionnel » au bureau — a souligné que nous testions nos systèmes exclusivement avec un anglais académique. « Vous concevez pour des gens qui s'expriment comme des manuels techniques », a-t-elle fait remarquer. Elle avait parfaitement raison. C'était exactement ce que nous faisions.
À quoi ressemble concrètement un système fiable ?
Après le bilan de Rufus, après de longues nuits passées à tester nos prototypes, après des débats avec des investisseurs répétant « utilisez simplement GPT avec un bon prompt », mon équipe et moi sommes parvenus à une architecture que nous nommons neuro-symbolique (Neuro-Symbolic) — un système qui traite le modèle de langage comme un composant puissant mais non décisionnel.
Le terme déterminant est non décisionnel. Le LLM excelle à saisir le sens de votre question et à générer des réponses fluides. Il est en revanche incapable de déterminer si ce qu'il énonce est vrai, sûr ou exécutable. Nous refusons donc qu'il ait le dernier mot sur quoi que ce soit.
Comment empêcher une IA d'halluciner des faits ?
La génération augmentée par récupération classique (RAG) recherche du texte ressemblant à la question. Notre méthode — Citation-Enforced GraphRAG — recherche des relations sémantiques dans un graphe de connaissances. La différence est capitale.
Dans notre architecture, le LLM ne peut émettre une affirmation que s'il peut retracer un chemin à travers des données vérifiées qui l'étayent. Vous souhaitez recommander un téléviseur pour les jeux vidéo ? Le système doit relier le produit ciblé à la caractéristique précise — taux de rafraîchissement de 120Hz — dans le graphe. Si le modèle tente d'inventer une caractéristique absente du graphe, la couche de vérification l'intercepte avant même que la réponse ne soit générée. Pas après. Avant.
Cela résout directement ce que les chercheurs appellent le problème « Lost in the Middle », où les LLM ignorent des informations enfouies au cœur de longues fenêtres de contexte. Lorsque vos faits résident dans un graphe structuré plutôt que dans un mur de texte hétérogène, il n'y a aucun risque de s'y perdre.
Pourquoi ne pas simplement utiliser un unique modèle d'excellence ?
On me pose constamment la question. « GPT-5 sera bien meilleur. Attendez simplement. » C'est possible. Mais le problème d'architecture ne s'efface pas avec un modèle supérieur. Une voiture plus rapide sans freins reste un péril public.
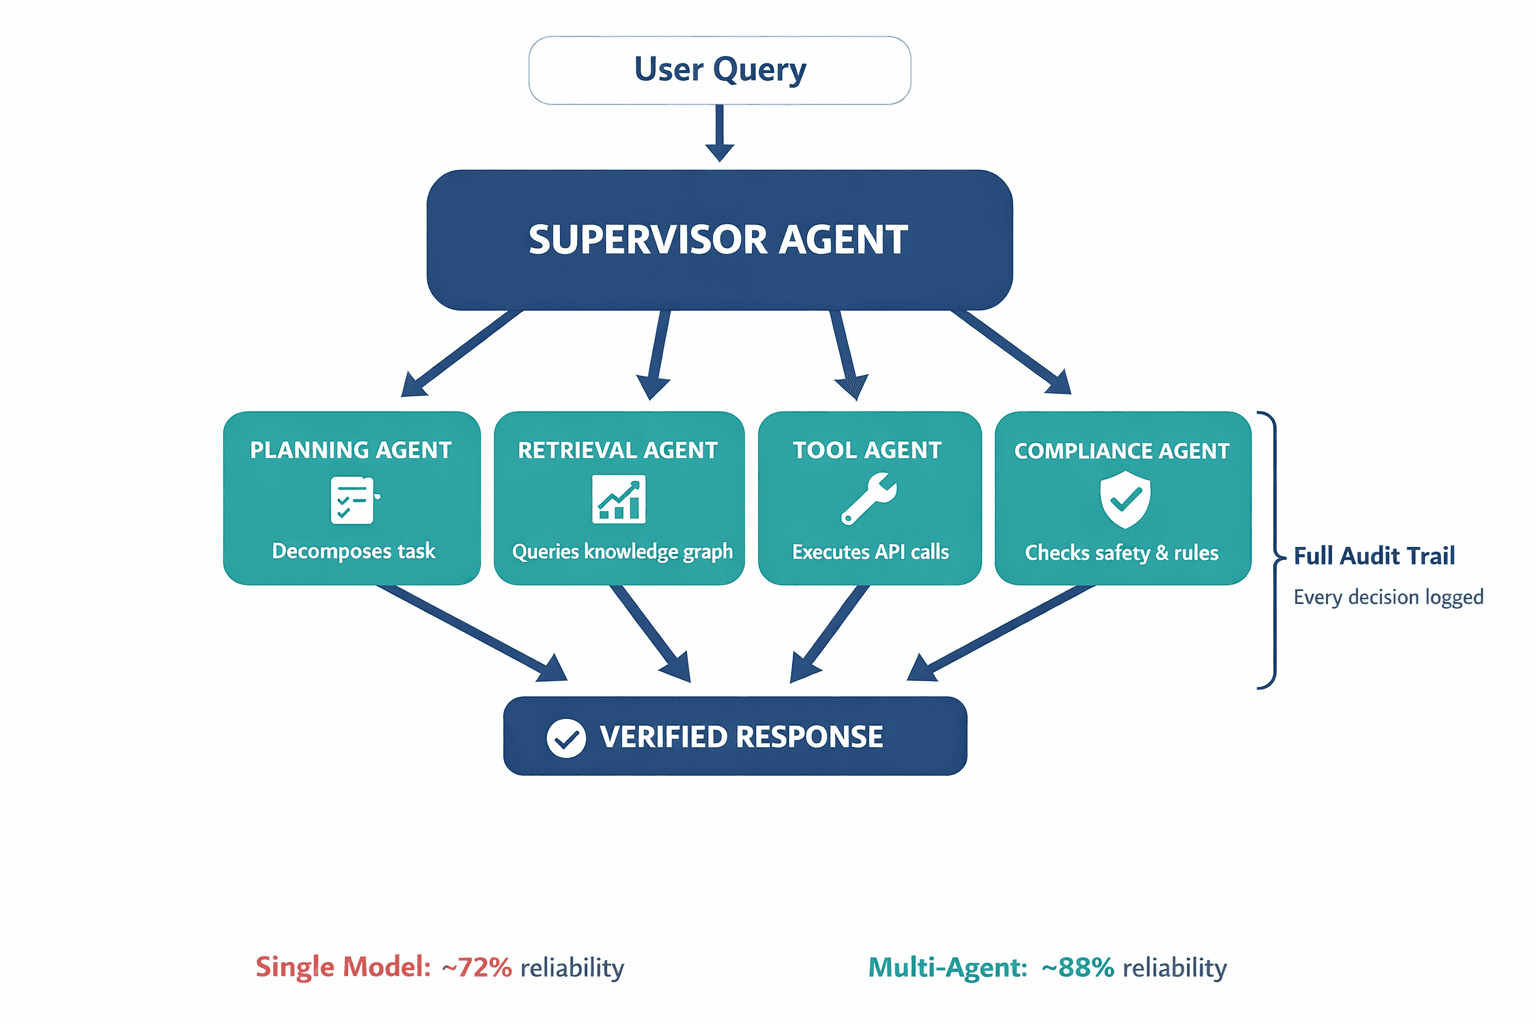
Au lieu de charger un modèle unique de tout accomplir, nous déployons un système multi-agents (Multi-Agent System) — un agent superviseur qui distribue l'intention de l'utilisateur à des spécialistes. Un agent de planification décompose la tâche. Un agent de recherche interroge la base adéquate. Un agent d'outils déclenche l'appel d'API. Un agent de conformité contrôle la réponse par rapport aux règles de sécurité et aux impératifs métier.
Cette division du travail a porté notre fiabilité d'environ 72 % — ce qu'atteignent en production les approches à modèle unique — à près de 88 %. Et surtout, elle génère une piste d'audit exhaustive. Lorsqu'un régulateur ou un client demande « pourquoi l'IA a-t-elle formulé cela ? », nous pouvons montrer avec exactitude quel agent a pris telle décision, en s'appuyant sur telle donnée. Essayez donc d'obtenir cela avec un modèle isolé et un prompt système.
Pour une analyse technique exhaustive de cette architecture, incluant les niveaux de vérification et le modèle formel de fiabilité, consultez notre publication de recherche.
Le sandwich qui sécurise les transactions
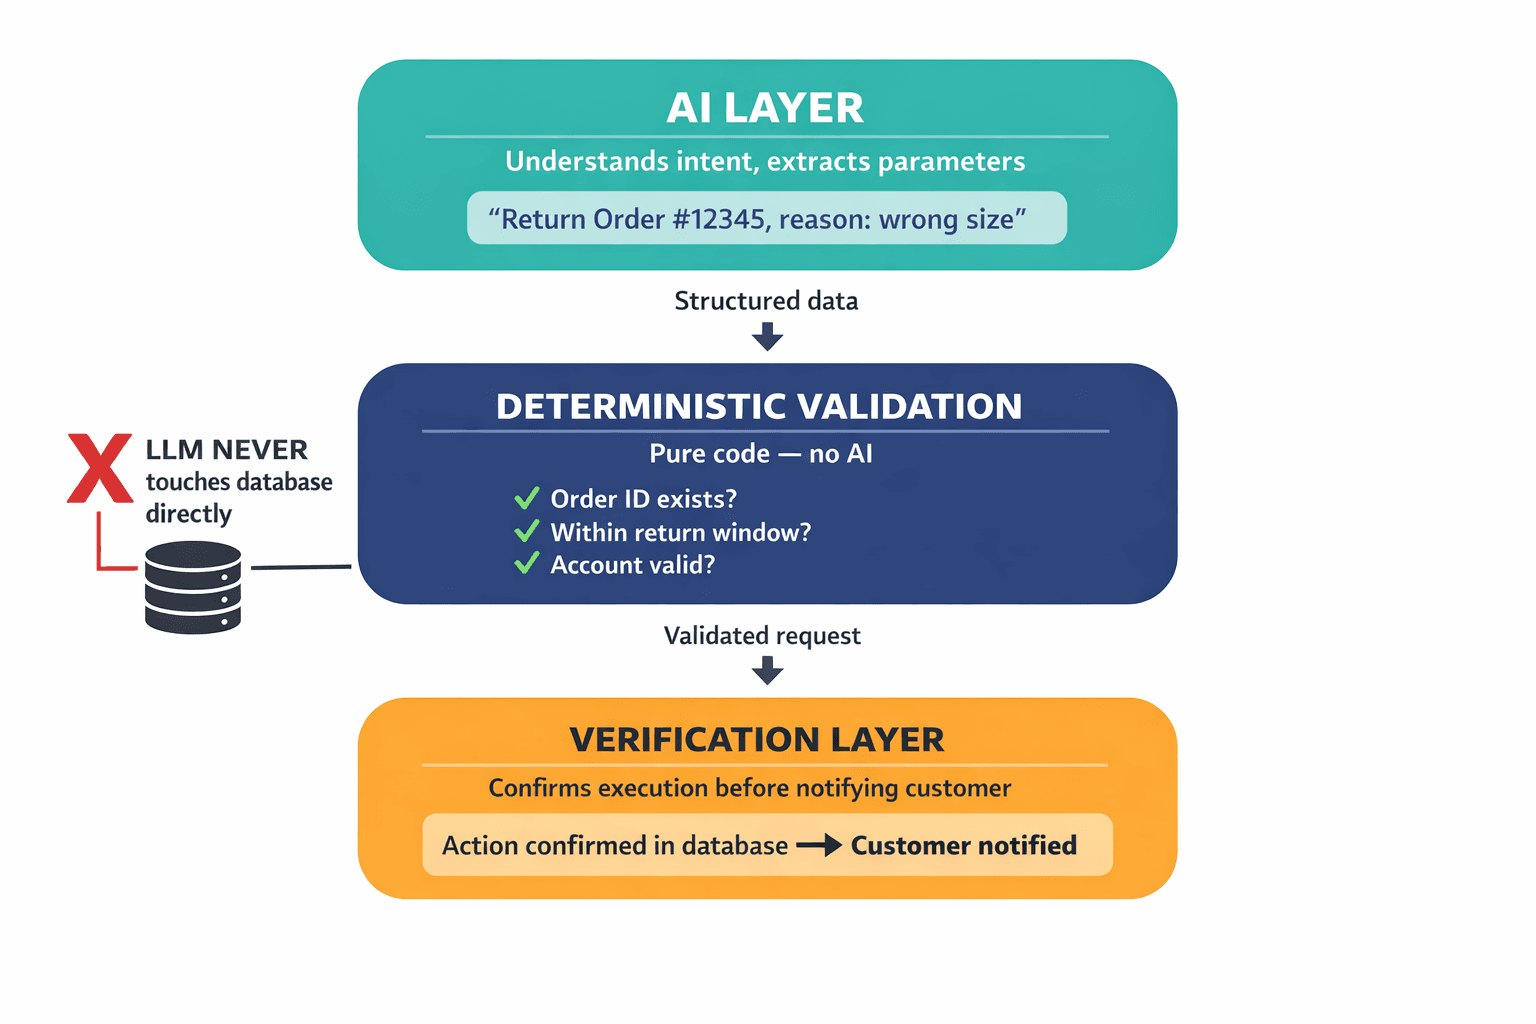
Face au fossé de l'action — l'incapacité à accomplir de véritables opérations comme gérer des retours —, nous employons ce que j'appelle l'architecture sandwich (Sandwich Architecture), et je reconnais volontiers que ce n'est pas l'appellation la plus solennelle pour un modèle d'ingénierie rigoureux.
La couche supérieure est l'IA : elle interprète votre besoin et en déduit des paramètres structurés. « Traiter un retour pour la commande #12345, motif : mauvaise taille. » La couche intermédiaire est du code déterministe pur : elle confronte ces paramètres à la base de données réelle. Cet identifiant de commande existe-t-il ? Sommes-nous dans le délai de retour ? Le compte de ce client est-il actif ? La couche inférieure gère la vérification : un système indépendant s'assure de l'exécution effective et réussie de l'action avant d'en informer le client.
Le modèle de langage n'interagit jamais directement avec la base de données. Il n'exécute aucune transaction. Il traduit une intention en données structurées et les remet à des systèmes conçus pour l'intégrité transactionnelle bien avant l'apparition des LLM. Le modèle fait ce pour quoi il excelle. La base de données fait ce dans quoi elle excelle. Personne ne prétend être ce qu'il n'est pas.
Le problème du cocktail Molotov est un problème de conception
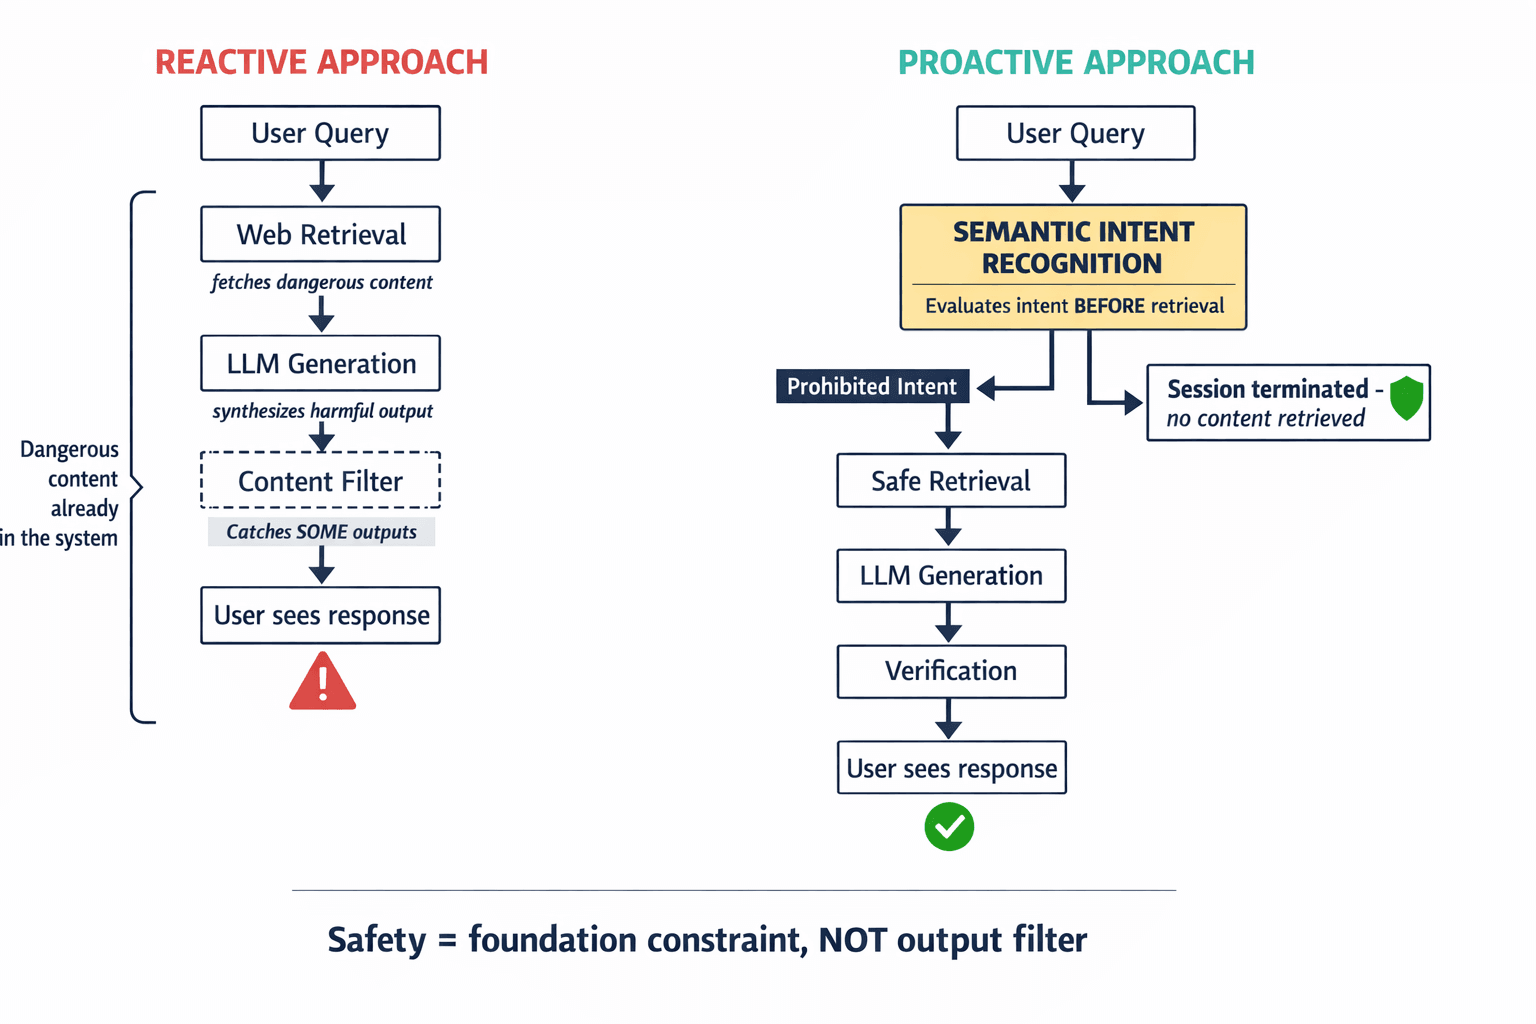
Je tiens à revenir sur cette faille de sécurité, car elle révèle selon moi un trait essentiel de la posture de l'industrie face aux risques de l'IA.
Après l'incident, le débat s'est concentré sur l'amélioration des filtres de contenu. Un blocage plus strict des mots-clés. Un alignement de sécurité plus agressif. Autant de mesures purement réactives — elles s'efforcent d'intercepter les sorties périlleuses une fois que le modèle les a déjà formulées.
Notre démarche est tout autre. Nous appliquons ce que je qualifie de reconnaissance sémantique de l'intention (Semantic Intent Recognition) dès la phase d'entrée. Avant même que la couche de recherche ne parcoure le Web, un agent de sécurité analyse l'intention sémantique de la requête. Si l'intention correspond à un registre prohibé — fabrication d'armes, automutilation, activités illicites —, la session est interrompue avant toute extraction de contenu.
C'est fondamental, car l'incident Rufus n'a exigé aucun piratage. L'utilisateur a posé une banale question sur un produit. Le système de recherche, explorant loyalement le Web ouvert, a extrait des contenus renfermant par hasard des instructions dangereuses. Le modèle, synthétisant loyalement les données récupérées, a soumis ces consignes à l'utilisateur. Chaque élément a fonctionné exactement comme prévu. La conception était en cause.
La sécurité n'est pas un filtre que l'on appose à la fin. C'est une contrainte que l'on intègre dès les fondations. Si votre IA a la capacité d'extraire des contenus dangereux, elle finira inévitablement par diffuser des contenus dangereux.
Le calcul dérangeant
Le PDG d'Amazon a projeté 10 milliards de dollars de ventes incrémentales grâce à Rufus. Cette prévision dépend intégralement de ce que j'appelle la confiance de conversion (Conversion Confidence) — la propension d'un client à faire suffisamment confiance aux recommandations de l'IA pour cliquer sur « Acheter ». Chaque hallucination, chaque retour avorté, chaque fin de non-recevoir liée à un dialecte effrite cette confiance.
L'approche par wrapper est certes plus économique au départ. Je ne le nierai pas. Vous pouvez livrer un wrapper LLM en quelques semaines. Notre architecture réclame des mois. La première phase consiste en un audit des données — assainir les corpus internes, établir la vérité terrain pour les produits et les règles. La deuxième phase déploie l'infrastructure multi-agents et le graphe de connaissances. La troisième phase met en route la boucle de rétroaction, où les retours humains des équipes du service client améliorent sans cesse la précision des agents.
Mais voici le calcul qui compte véritablement : pour un grand distributeur, le préjudice d'image d'un unique gros titre du type « L'IA ordonne à un client de fabriquer une arme » surpasse l'intégralité du budget d'un système conçu selon les règles de l'art. Les 45 % de consommateurs qui se méfient déjà des assistants IA ne changeront pas d'avis grâce à des temps de réponse accélérés. Ils reviendront vers des systèmes qui sont exacts.
L'ère du wrapper est révolue
J'ai passé les deux dernières années à observer des entreprises reproduire la même erreur à un rythme effréné. Elles découvrent la démo, sont fascinées par la fluidité, déploient le wrapper, puis passent l'année suivante à s'excuser pour les sorties produites. Le modèle de fondation — qu'il s'agisse de GPT-4, Gemini, Claude ou de leurs successeurs — n'a jamais été le facteur différenciant. L'architecture qui l'entoure l'a toujours été.
Un modèle de langage s'apparente à une machine à vapeur. D'une puissance phénoménale, capable de bouleverser des secteurs entiers. Mais une machine à vapeur dépourvue de pistons, de soupapes et de régulateurs n'est qu'une explosion en sursis. L'ingénierie qui canalise et bride cette puissance — les strates de contrôle, les graphes de connaissances, l'orchestration des agents, l'intégrité transactionnelle —, voilà ce qui sépare une démonstration d'un produit opérationnel.
Les entreprises qui l'ont compris capteront la valeur. Celles qui s'obstinent à emballer des modèles dans des prompts en espérant un miracle continueront d'alimenter les faits divers. Je sais pertinemment de quel côté de cette frontière je choisis de construire.