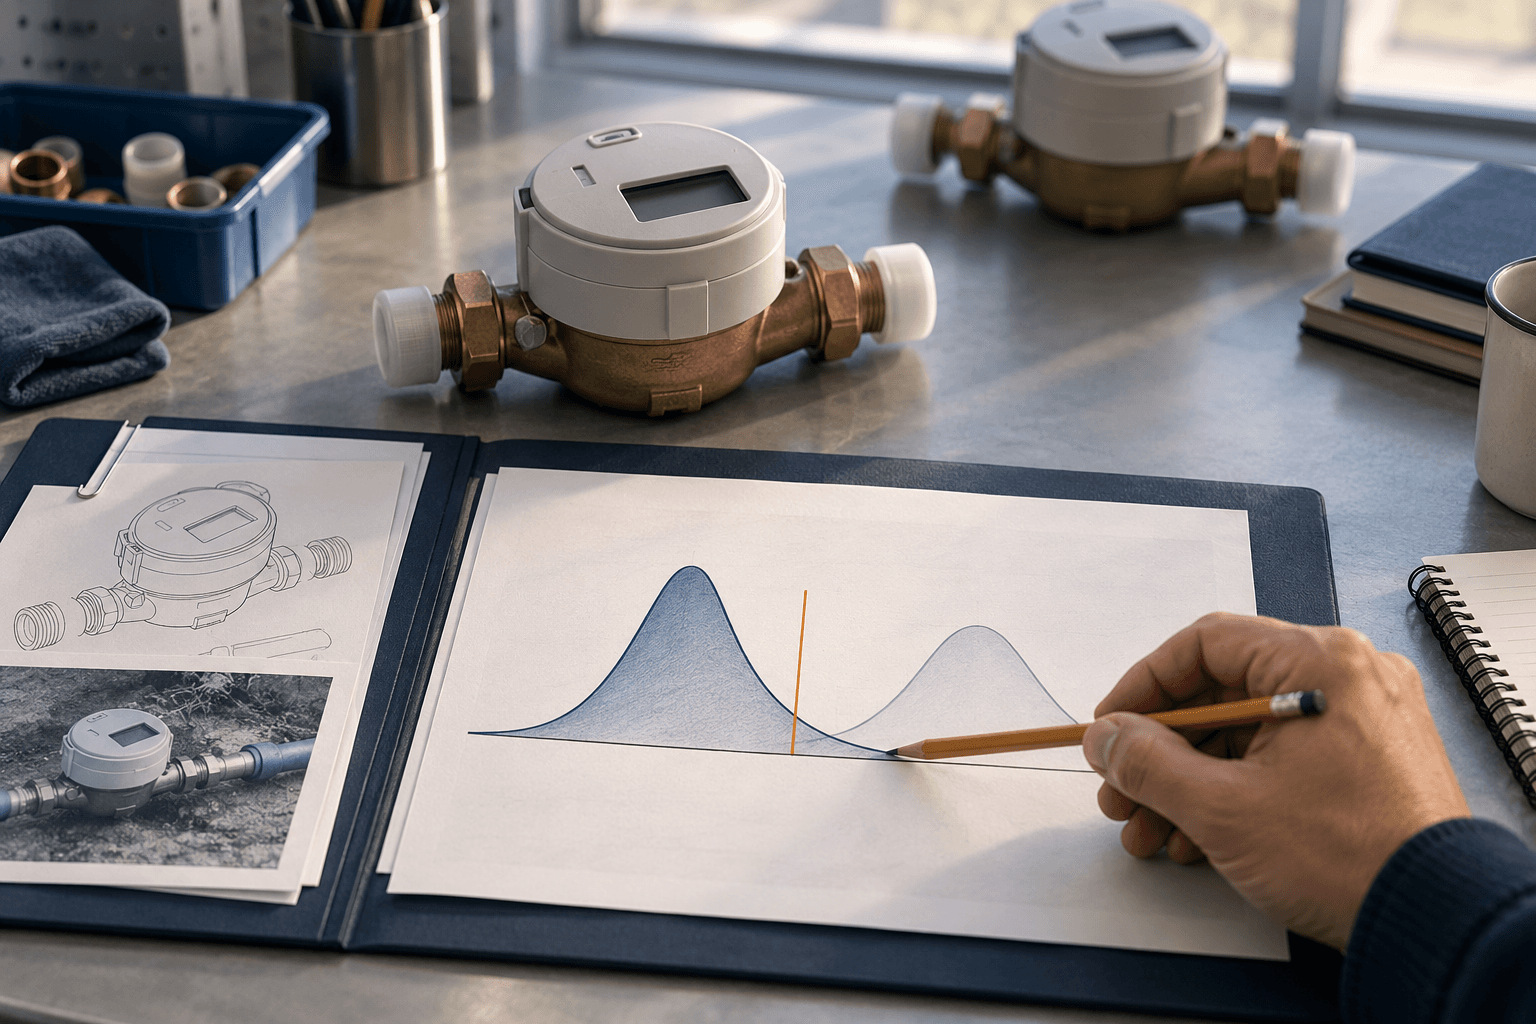
Une estimation de risque de firmware plus basse ne vaut pas autorisation de déploiement

Un correctif de firmware peut considérablement améliorer une estimation de risque tout en laissant une version inacceptable au regard de la politique déclarée. Pour une équipe d'ingénierie qui décide de mettre à jour ou non un parc de compteurs, il s'agit de jugements distincts. L'amélioration vous renseigne sur le candidat. L'autorisation dépend du risque résiduel, de la population évaluée et des preuves qui étayent l'estimation.
J'ai conçu MeterGuard pour maintenir ces jugements visibles. Il s'agit d'une démonstration de contrôle préalable au déploiement de firmware, utilisant des populations synthétiques de compteurs et des manifestes de firmware synthétiques. Elle estime le comportement à partir d'un journal des modifications, modélise ce comportement par rapport à la santé du parc et émet une recommandation locale. Elle n'envoie aucun firmware aux compteurs et ne bloque aucune mise à jour réelle. La question utile est de savoir ce que cette séparation permet à un responsable de version d'inspecter, et ce qu'elle ne peut toujours pas établir.
Amélioration et acceptabilité répondent à des questions différentes
Considérons la population synthétique désignée Plano Water. Un candidat initial produit un taux d'échec moyen modélisé de 74.22% des points de terminaison évalués. Un correctif produit 2.85%. Ces deux résultats reposent sur des profils comportementaux assistés par modèle mis en cache, plutôt que sur un comportement mesuré à partir de binaires de firmware. Dans le cadre de ces hypothèses, le correctif représente une amélioration substantielle. Cette comparaison mérite d'être conservée, même lorsque la recommandation finale reste NO-GO.
La barrière de version vérifie d'abord l'extrémité supérieure de l'intervalle modélisé à 90%. À 3.0% ou plus des points de terminaison évalués, elle renvoie NO-GO. Pour le correctif, la moyenne est de 2,449 échecs modélisés parmi 86,078 points de terminaison évalués, avec un intervalle allant de 1,536 à 3,531. Le taux supérieur étant de 4.10%, la règle de blocage strict s'applique. Par ailleurs, 1,922 points de terminaison manquent de télémétrie suffisante et sont exclus de cette prédiction, un examen manuel étant recommandé.
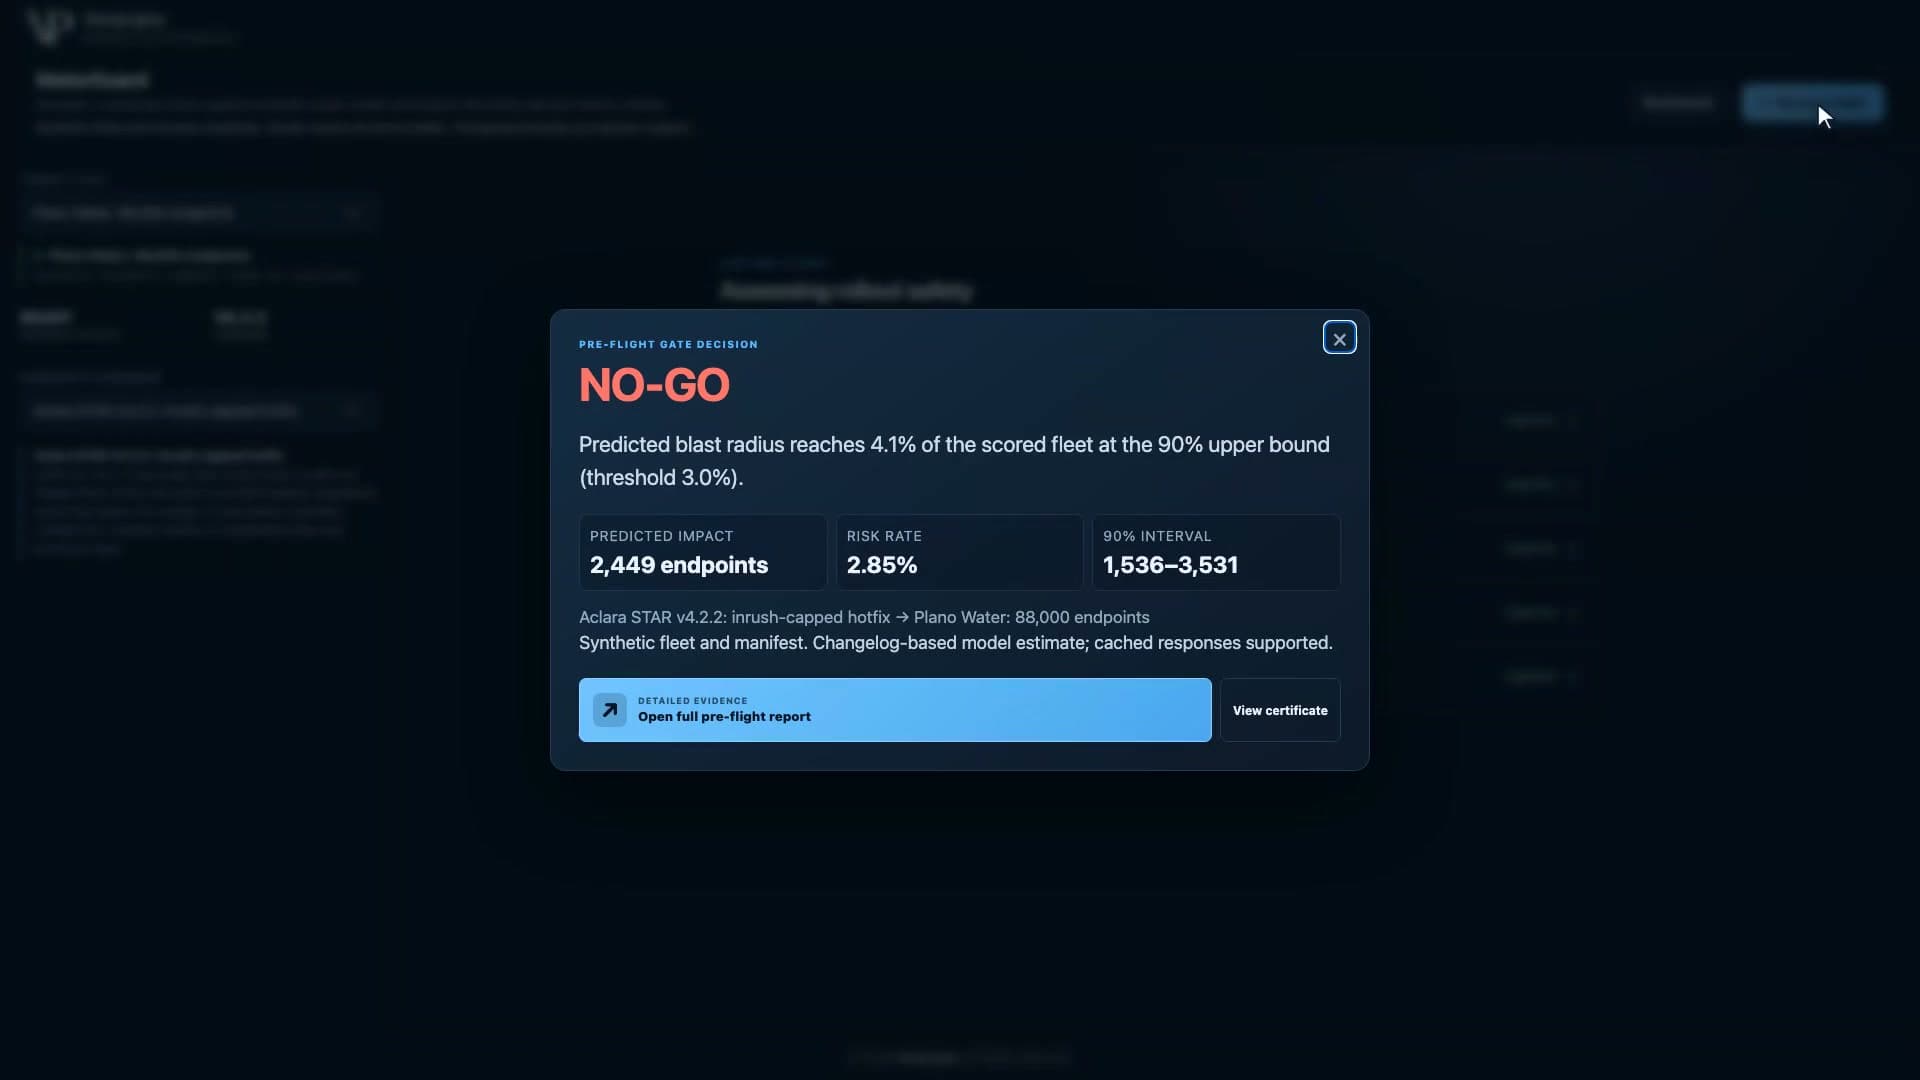
Une lecture limitée à la seule moyenne manquerait la raison pour laquelle il s'agit d'un blocage strict. Elle ne rendrait pas non plus le candidat éligible à GO selon le reste de la politique : GO exige une moyenne inférieure ou égale à 0.5%, après validation des contrôles de borne supérieure et de confiance. Un risque numérique intermédiaire mène à STAGED-CANARY. La distinction importe, car « meilleur », « éligible à une étape limitée de collecte de preuves » et « conforme à la règle GO » ne doivent pas se confondre sous une seule étiquette rassurante.
Je préfère maintenir l'amélioration visible sans lui permettre de renégocier la limite. Si une équipe réagit à une recommandation décevante en assouplissant le seuil, elle a modifié sa politique d'acceptation. Cela peut constituer une décision défendable dans un contexte particulier, mais c'est une décision distincte qui requiert ses propres justifications. La preuve qu'un candidat est meilleur qu'un autre ne fournit pas ces justifications par elle-même.
Cette position a un coût. Une limite prudente peut retarder un candidat qui aurait réussi. L'extrémité supérieure d'un intervalle modélisé n'est pas un résultat observé sur le terrain, et qualifier l'intervalle de « 90% » n'établit pas sa couverture sur le parc d'un gestionnaire de réseau. Cette démonstration ne peut déterminer le seuil qu'un distributeur réel devrait adopter. Ce qu'elle peut montrer, c'est si une recommandation respecte le seuil déclaré, plutôt qu'un seuil discrètement ajusté pour convenir au résultat.
L'autorisation relève d'un candidat et d'une population
La même estimation comportementale du correctif donne un résultat très différent sur la population générée désignée Hill Country Electric Co-op. Son taux d'échec moyen modélisé est de 0.02%, avec un taux d'intervalle supérieur de 0.03%, et la barrière renvoie GO pour 118,222 points de terminaison évalués. La population présente une distribution de batterie plus saine et un signal radio moins faible que la population synthétique de Plano. Ses 1,778 points de terminaison exclus restent en dehors de cette recommandation.
Il s'agit d'une comparaison du comportement d'écriture estimé à travers des distributions d'état générées. Elle ne dit rien sur l'installation de l'image d'un fabricant sur le matériel d'un autre fabricant. La compatibilité et la validation dérivée des binaires constituent des travaux distincts que la démonstration n'effectue pas.
La comparaison change la manière dont je souhaite voir formulée une recommandation de version. « Ce firmware présente un faible risque » laisse le périmètre indéterminé. « Ce comportement estimé respecte cette politique sur cette population évaluée » préserve les conditions dans lesquelles le résultat est valable. L'état de la batterie et la récupération radio sont des entrées du résultat modélisé, de sorte qu'un résultat favorable ne peut en être détaché pour être transposé à un autre parc.
Pour un responsable de version, cela ouvre deux manières distinctes de répondre à une recommandation défavorable. L'une consiste à améliorer le comportement du candidat ou les preuves utilisées pour l'estimer. L'autre consiste à envisager une population plus restreinte dont les conditions étayent une évaluation différente. Elles répondent à des problèmes distincts. Une évaluation plus restreinte peut réduire l'exposition modélisée, mais laisse le reste de la population sans réponse. De meilleures preuves sur le candidat peuvent affiner l'estimation, mais ne peuvent faire apparaître une télémétrie de parc manquante.
Ces options sont des choix d'ingénierie prospectifs, et non des opérations exécutées par cette démo. Leur valeur réside dans le fait qu'elles orientent le travail vers la source de l'incertitude. Le verdict seul ne peut indiquer à une équipe si elle a besoin d'un meilleur candidat, d'un meilleur profil ou d'une meilleure information sur les destinataires prévus. Les entrées et exclusions qui l'accompagnent le peuvent.
Une barrière de code ne peut valider ce que le modèle croit
MeterGuard conserve la politique sous forme de code clair. La note de gouvernance assistée par modèle intervient après le verdict et ne détient aucune autorité directe pour l'annuler. Je tiens à cette séparation, car une explication fluide ne doit pas discrètement se transformer en une nouvelle règle de publication.
Le modèle conserve une influence déterminante plus tôt dans le flux de travail. Son profil de firmware estime la consommation de courant, la récupération après réinitialisation et le comportement d'écriture flash à partir du texte synthétique du journal des modifications. Ces estimations alimentent le simulateur. Un profil différent peut modifier les défaillances modélisées et ainsi faire basculer le verdict, même si le code de la barrière ne change jamais. Une politique inspectable établit comment les entrées ont été jugées ; elle n'établit pas que ces entrées étaient correctes.
Le cas d'un journal des modifications succinct rend cette distinction visible. Face à la même population générée pour la coopérative, sa moyenne modélisée n'est que de 0.05% et son taux supérieur de 0.06%. Ces chiffres respectent les limites numériques. Le profil présente néanmoins un faible niveau de confiance, de sorte que la barrière recommande STAGED-CANARY au lieu de GO. La rareté des preuves sur le firmware est traitée comme une raison indépendante de retenir la recommandation plus large.
Il s'agit d'une protection utile, assortie de sa propre limite. L'étiquette de confiance d'un modèle n'est pas une certitude empirique calibrée. Exiger une étiquette non faible peut empêcher d'ignorer un déficit de preuves identifié ; cela ne peut certifier qu'une étiquette « élevée » soit exacte. Pour une utilisation en production, le profil nécessiterait une validation par rapport au comportement et aux résultats réels du firmware. Cela demeure un travail qui dépasse la démonstration synthétique.
L'échantillon le plus sûr laisse une question plus difficile
La trajectoire par étapes proposée utilise 500 points de terminaison issus de la cohorte au risque modélisé le plus bas, avec une période d'observation de 72 heures et une réévaluation basée sur la télémétrie observée avant tout élargissement. La démo recommande ce plan ; elle n'a pas exécuté de déploiement canari ni collecté ses observations. Le critère d'élargissement configuré est un taux d'échec observé inférieur à 0.1%.
Je perçois un arbitrage réel dans le fait de choisir d'abord la cohorte la plus sûre. Cela réduit l'exposition proposée pour l'étape initiale. Mais la logique même qui rendait l'état du parc déterminant limite également ce que cette étape peut établir pour les points de terminaison dans un état plus dégradé. Dans une campagne hypothétique, observer une mise à jour réussie sur des batteries saines et de bonnes connexions radio étayerait une affirmation sur cet échantillon testé. Cela laisserait en suspens la manière dont le candidat se comporte sur des batteries vieillissantes ou des liaisons radio faibles.
Il existe au moins deux réponses défendables à cet écart. Une équipe pourrait restreindre l'élargissement aux populations suffisamment similaires à l'échantillon observé, en acceptant un déploiement plus lent et en laissant les points dégradés en attente. Ou elle pourrait rechercher des preuves ciblées sur les conditions dégradées, comme une validation contrôlée du comportement pertinent de la batterie et de la récupération, avant d'envisager ces points. La seconde voie exige davantage de travail ; la première accepte une conclusion plus restreinte. Aucune ne rend un échantillon sûr représentatif par simple décret.
C'est pourquoi je traite STAGED-CANARY comme une demande de preuves spécifiées, et non comme un synonyme édulcoré de GO. Un plan par étapes doit préciser ce que ses observations justifieront et où elles s'arrêtent. Sans ce périmètre, un processus d'apparence prudente peut néanmoins produire une conclusion excessivement large.
Voici la présentation par le fondateur de ces décisions de déploiement de compteurs communicants dans MeterGuard.
L'explicatif MeterGuard présente le flux de travail de contrôle préalable et ses registres de décision. Ma position de conception consiste à maintenir le comportement estimé, la population évaluée, les exclusions et la règle déclarée aux côtés de la recommandation. Pour un responsable de version, le test consiste à déterminer si la prochaine étape proposée résout l'incertitude qui a causé le blocage. Si elle n'observe que les conditions les plus faciles alors que la décision concerne les plus difficiles, la limite reste en attente de preuves.