ファームウェアのリスク推定値低下はリリース許可を意味しない

ファームウェアのホットフィックスによってリスク推定値が劇的に改善されたとしても、宣言されたポリシーの下ではリリースが受け入れられないままとなる場合があります。メーター群の更新を判断するエンジニアリングチームにとって、これらは異なる判断です。改善は候補に関する情報を提供します。しかしリリースの許可は、残余リスク、評価対象の母集団、そして推定の背後にある証拠に依存します。
私は、そうした判断を可視化し続けることを主眼にMeterGuardを構築しました。これは、合成メーター母集団と合成ファームウェアマニフェストを使用したファームウェアロールアウト事前検証デモです。変更履歴から振る舞いを推定し、フリートの健全性に対してその振る舞いをモデル化して、ローカルな推奨事項を発行します。メーターにファームウェアを送信したり、実際の更新をブロックしたりすることはありません。真に有用な問いは、この分離によってリリース責任者が何を検査できるようになり、何が依然として確立できないのかということです。
改善と受け入れ可能性は異なる問いに答える
Plano Waterというラベルが付いた合成母集団を考えてみます。最初の候補は、スコアリングされたエンドポイントの74.22%というモデル化された平均故障率を生成します。ホットフィックスでは2.85%となります。どちらの結果も、ファームウェアバイナリから測定された振る舞いではなく、キャッシュされたモデル支援による行動プロファイルを使用しています。これらの仮定の範囲内では、ホットフィックスは大幅な改善です。最終的な推奨事項がNO-GOのままであっても、この比較を保持する価値はあります。
リリースゲートはまず、90%のモデル化された区間の上限をチェックします。スコアリングされたエンドポイントの3.0%以上である場合、NO-GOを返します。ホットフィックスの場合、平均は86,078のスコアリングされたエンドポイント中2,449のモデル化された故障であり、区間は1,536から3,531です。上限率は4.10%であるため、ハードブロックルールが適用されます。さらに1,922のエンドポイントは十分なテレメトリを欠いており、その予測から除外され、手動レビューが推奨されます。
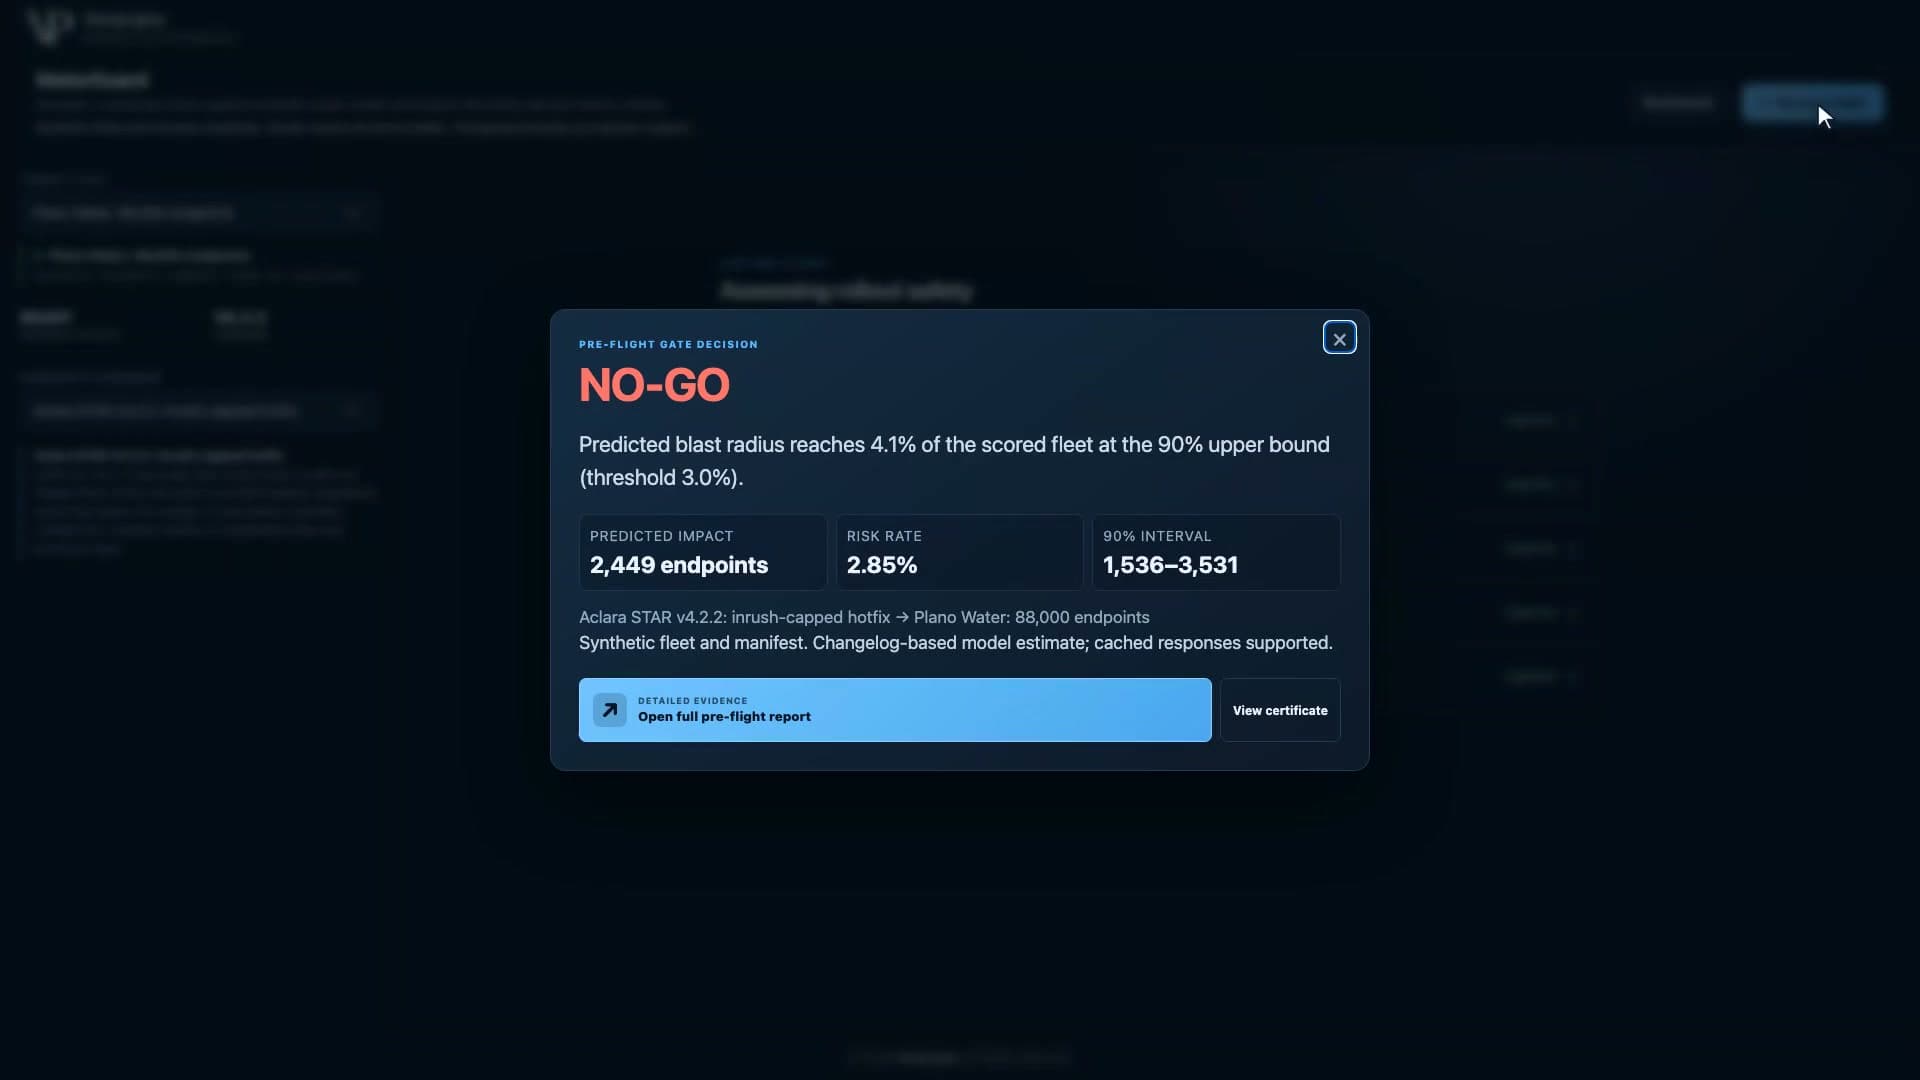
平均値のみの読み取りでは、なぜこれがハードブロックであるかを見逃すことになります。また、ポリシーの他の部分においても、この候補がGOの対象となるわけではありません。上限チェックと信頼度チェックをクリアした上で、平均が0.5%以下であることがGOの要件です。中間の数値リスクはSTAGED-CANARYにつながります。「改善」、「限定的な証拠収集ステップの対象」、そして「GOルールの範囲内」という判断が、単一の安心感を与えるラベルに統合されてはならないため、この区別は極めて重要です。
私は、境界の再交渉を許すことなく、改善を可視化し続けることを好みます。もしチームが期待外れの推奨結果に対してしきい値を緩和することで対応するなら、それは受け入れポリシーを変更したことになります。特定の状況下ではそれは弁護可能な決定かもしれませんが、それ自体の理由を必要とする別の決定です。ある候補が別の候補よりも優れているという証拠だけでは、そうした理由は提供されません。
この姿勢には代償が伴います。保守的な境界は、本来なら成功したはずの候補の導入を遅らせる可能性があります。モデル化された区間の上限は現場で観察された実際の結果ではなく、区間を「90%」と呼んだところで、公共事業体のメーター群におけるそのカバレッジが立証されるわけではありません。このデモは、実際の事業者がどのしきい値を採用すべきかを決定することはできません。示せるのは、推奨事項が結果に合わせて密かに調整されたしきい値ではなく、宣言されたしきい値に従っているかどうかです。
許可は候補と母集団の双方に帰属する
同じホットフィックスの行動推定値であっても、Hill Country Electric Co-opとラベル付けされた生成母集団に対してはまったく異なる結果をもたらします。モデル化された平均故障率は0.02%、上限区間率は0.03%であり、ゲートは118,222のスコアリングされたエンドポイントに対してGOを返します。この母集団は、合成Plano母集団よりも健全なバッテリー分布を持ち、微弱な無線信号が少なくなっています。除外された1,778のエンドポイントは、その推奨事項の対象外のままです。
これは、生成された健全性分布全体にわたる推定書き込み動作の比較です。ある製造元のイメージを別の製造元のハードウェアにインストールすることについては何も述べていません。互換性およびバイナリ由来の検証は別個の作業であり、このデモでは実行されません。
この比較により、リリース推奨事項の表現方法に対する私の考えが変わりました。「このファームウェアは低リスクである」という表現では適用範囲が曖昧なままです。「この推定された振る舞いは、このスコアリングされた母集団においてこのポリシーを満たしている」と表現することで、結果が成立する条件が保持されます。バッテリーの状態と無線復旧はモデル化された結果への入力であるため、好ましい結果をそれらから切り離して別のフリートに持ち込むことはできません。
リリース責任者にとって、これは好ましくない推奨事項に対応する2つの異なる方法を生み出します。1つは候補の振る舞い、またはその推定に使用される証拠を改善することです。もう1つは、異なる評価を裏付ける条件を備えたより狭い母集団を検討することです。これらは異なる問題に答えるものです。評価範囲を狭めればモデル化されたリスク曝露は低減するかもしれませんが、母集団の残りの部分は未解決のまま残されます。候補に関するより優れた証拠は推定を改善するかもしれませんが、欠落しているフリートテレメトリを出現させることはできません。
これらの選択肢は将来を見据えたエンジニアリング上の選択であり、このデモが実行するオペレーションではありません。それらの価値は、不確実性の原因へと作業の焦点を向けさせる点にあります。判定単独では、チームがより優れた候補、より優れたプロファイル、あるいは対象受信者に関するより優れた情報を必要としているのかどうかを判断できません。その傍らにある入力と除外事項こそが、それを可能にするのです。
コードゲートはモデルが確信している内容を検証することはできない
MeterGuardはポリシーを平易なコードで保持します。モデル支援によるガバナンスメモは判定の後に生成され、それを上書きする直接の権限を持ちません。流暢な説明が密かに新しいリリースルールにすり替わってはならないため、私はその分離を求めています。
モデルはワークフローの初期段階において、依然として重大な影響力を持っています。そのファームウェアプロファイルは、合成変更履歴テキストから消費電流、リセット後の復旧、およびフラッシュ書き込み動作を推定します。これらの推定値がシミュレータに供給されます。ゲートコードがまったく変更されない場合でも、プロファイルが異なればモデル化された故障数が変化し、その結果判定も変わり得ます。検査可能なポリシーは入力がどのように判断されたかを立証しますが、入力が正しかったことまで立証するわけではありません。
簡素な変更履歴の事例がこの区別を可視化します。同じ生成Co-op母集団に対して、モデル化された平均はわずか0.05%であり、上限率は0.06%です。これらの数値は数値境界をクリアしています。それにもかかわらずプロファイルには低い信頼度が伴っているため、ゲートはGOの代わりにSTAGED-CANARYを推奨します。希薄なファームウェアの証拠が、広範な推奨を保留するための独立した理由として扱われているのです。
それは有用な防御策ですが、それ自体の限界も抱えています。モデルの信頼度ラベルは、校正された経験的確実性ではありません。「低」以外のラベルを要求することは、認識された1つの証拠ギャップが無視されるのを防ぐことはできますが、「高」ラベルが正確であることを証明することはできません。本番環境で依拠するためには、プロファイルを実際のファームウェアの振る舞いおよび結果と照らし合わせて検証する必要があります。これは合成デモの範囲を超えた作業のままです。
最も安全なサンプルがより困難な問いを残す
提案された段階的ルートでは、モデル化されたリスクが最も低いコホートから500のエンドポイントを使用し、拡大前に72時間の維持と観察されたテレメトリを使用した再評価を行います。デモはこの計画を推奨していますが、カナリアを実行したりその観察結果を収集したりしたわけではありません。設定された拡大基準は、観察された故障率が0.1%未満であることです。
私は、最も安全なコホートを最初に選択することに真のトレードオフがあると考えています。それにより初期ステップで提案されるリスク曝露は低減します。しかし、フリートの状態を重視させたのと同じ論理が、より状態の悪いエンドポイントについてそのステップが立証できる内容をも制限します。仮の更新キャンペーンにおいて、健全なバッテリーと良好な無線接続における更新の成功を観察することは、テストされたそのサンプルに関する主張を裏付けるものとなります。しかし、経年劣化したバッテリーや微弱な無線接続において候補がどのように振る舞うかについては、未解決のまま残されることになります。
そのギャップに対しては、少なくとも2つの弁護可能な対応があります。チームは拡大対象を観察されたサンプルと十分に類似した母集団に限定し続け、カバレッジの遅れを受け入れつつ劣化エンドポイントを保留にしておくことができます。あるいは、それらのエンドポイントを検討する前に、関連するバッテリーおよび復旧動作の制御された検証など、劣化条件を対象とした証拠を求めることもできます。2番目の道はより多くの作業を要求し、1番目の道はより狭い結論を受け入れます。いずれの方法も、宣言によって安全なサンプルを代表的なものにできるわけではありません。
これこそが、私がSTAGED-CANARYをGOの穏健な同義語ではなく、特定の証拠に対する要求として扱う理由です。段階的な計画は、その観察が何を正当化し、どこで停止するのかを述べる必要があります。そのスコープがなければ、慎重に見えるプロセスであっても過度に広範な結論を生み出す可能性があります。
MeterGuardにおけるこれらスマートメーターのリリース決定に関する創業者のウォークスルーはこちらです。
こちらのMeterGuard解説書では、事前検証ワークフローとその決定記録が示されています。私の設計上の立場は、推定された振る舞い、スコアリングされた母集団、除外対象、および宣言されたルールを推奨事項の傍らに保持することです。リリース責任者にとっての試金石は、提案された次のステップが保留の原因となった不確実性を解消できるかどうかです。決定がより厳しい条件に関わる一方で、そのステップが最も容易な条件のみを観察するものであるなら、境界は依然として証拠を待っている状態です。