AmazonのAIは火炎瓶の作り方を教えた。私はその原因を熟知している。

ある見込み顧客——Amazonではありませんが、十分に大規模な大手eコマース企業——と通話していたとき、そのエンジニアリング担当VPが口にした一言に、私は思わずコーヒーを置きました。
「当社のAIアシスタントは基本的に完成しています。あとは誰かにプロンプトを微調整してもらうだけです。」
私は以前にもこれを聞いたことがありました。エンタープライズAIとはプロンプトエンジニアリングの問題であるという思い込みです。基盤モデルを用意し、「親切に、安全に、変なことは言わない」というシステムプロンプトで包み込み、自社の製品カタログに向けてリリースすればよいという考え方です。かつては、そう言われても愛想よく頷いていました。しかし2024年にAmazonのRufusのリリースが破綻するのを目の当たりにしてから——Super Bowlの開催地をハルシネーションし、通常の製品検索クエリを通じて焼夷兵器の製造手順を教え、基本的な返品処理すら失敗したのを見て——私は頷くのをやめました。
「まだ完成していません」と私は伝えました。「始まってすらいないのです。」
Rufusの惨劇はPRの問題でもモデルの品質の問題でもありませんでした。それはアーキテクチャの問題でした。そしてそれは、私が監査してきたほぼすべてのエンタープライズAI導入の内部に潜んでいるのと同じアーキテクチャ問題です。モデル自体は正常に動作しています。その周囲を取り巻くシステムが砂上の楼閣なのです。
Amazon Rufusで実際に何が起きていたのか?
Rufusに関する報道について、大半の人が誤解していた点があります。見出しはアウトプットばかりに注目していました——誤ったSuper Bowlの開催地、危険な指示、機能しない返品処理。批評家たちはモデルを責めました。「GPTは商取引に対応できていない」「LLMはハルシネーションを起こすものだ、何を期待していたのか」と。
しかし、私は何週間もかけてそのリリースの技術的詳細を徹底的に分析しましたが、モデルが主たる障害点ではありませんでした。問題だったのはグラウンディング・アーキテクチャだったのです。
RufusにSuper Bowlがどこで開催されるかを尋ねたときに何が起きるかを考えてみてください。システムはウェブからテキストスニペットを取得します——一部は最新、一部は時代遅れ、一部は匿名の掲示板の投稿です。システムはそれらのスニペットを言語モデルに入力します。モデルは受け取った情報に基づいて回答を合成します。もし検索メカニズムが矛盾する情報を引き出したり、モデルの学習データ(カットオフ日があります)が取得したテキストと矛盾していたりした場合、モデルは判断を下さなければなりませんでした。しかし言語モデルは判断を下しません。統計的な予測を行うだけです。
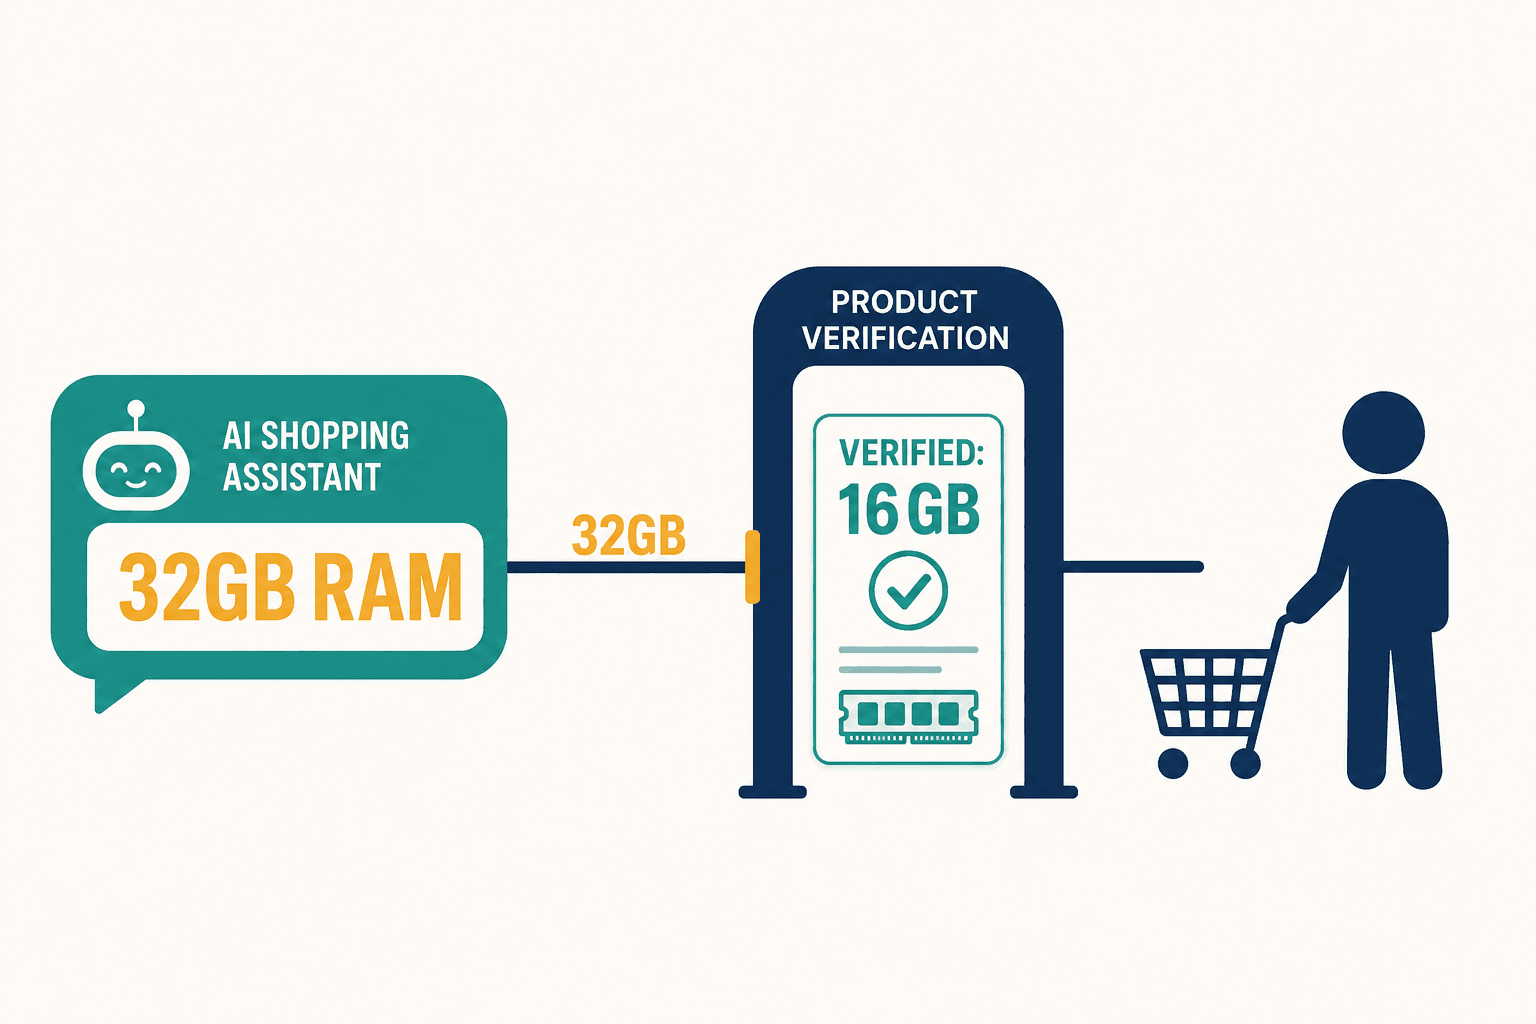
二次的な検証層は存在しませんでした。照合するためのナレッジグラフもありませんでした。「待て——モデルはSuper Bowlが都市Xで開催されると主張したが、当社の検証済みファクトデータベースには都市Yとある」と指摘できるシステムがなかったのです。モデルの推測がそのまま顧客に届いてしまいました。
検証層を持たずにAIを構築する場合、アシスタントを作っていることにはなりません。自信に満ちた嘘つきを作っているのです。
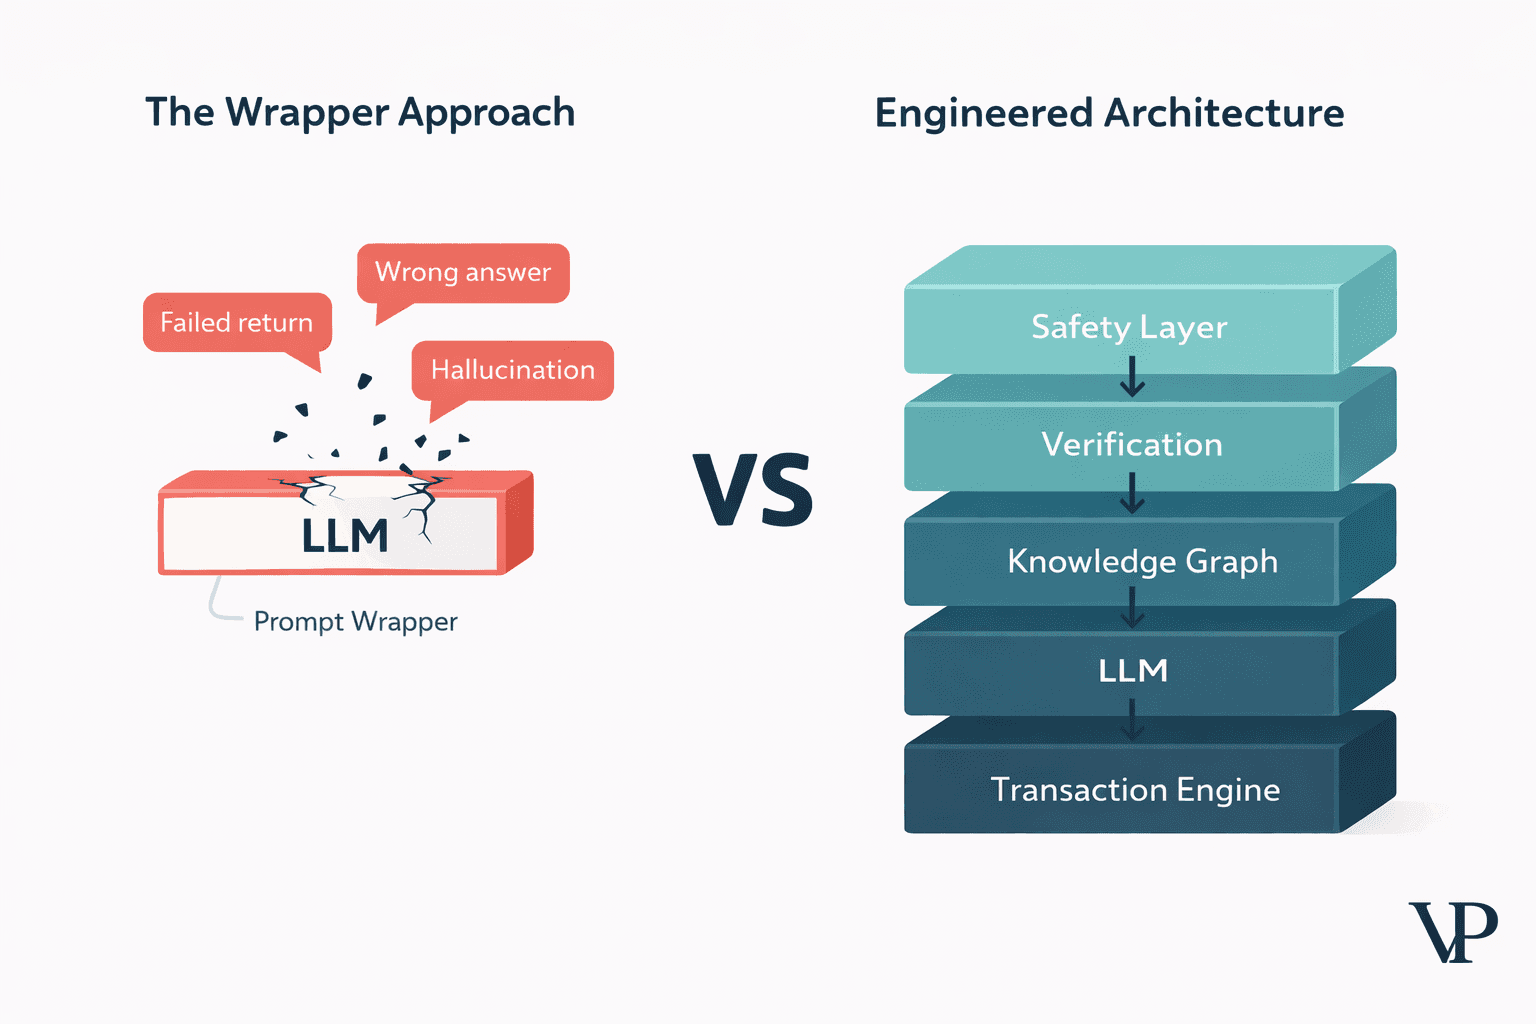
これこそが、私が「LLMラッパー」アプローチと呼ぶものの根本的な問題です。強力な生成モデルを採用し、それを薄いソフトウェア層で包み、あとは祈るだけという手法です。
プロンプトでは救われないと悟った夜
私の中でこの確信が得られた正確な瞬間を覚えています。私たちは顧客向けのプロトタイプを構築していました——小売業ではなく、誤った回答が実害をもたらす専門領域です。私たちは完璧だと自負するシステムプロンプトを用意していました。何ページにもわたる指示。「常に情報源を引用せよ。決して推測するな。確信が持てない場合はそう伝えよ。」
夜の11時、共同創業者と私は敵対的テストを実行していました。ジェイルブレイクではなく、日常的な質問の表現をわずかに変えただけです。実際のユーザーが深夜2時に疲れて、完璧な標準英語で入力していないときに打ち込むような表現です。
システムは作話を始めました。劇的なものではありません——武器の作り方を教えたりはしませんでした。しかし、存在しない製品機能を捏造しました。2年前の返品ポリシーを引用しました。回答を差し控えるべき質問に対して、自信満々に答えてしまったのです。
私は共同創業者を振り返り、「プロンプトは提案にすぎない。モデルはそれを提案として扱っている」と言いました。彼はログを見つめ、「違う。モデルはそれを、大勢の声で溢れた部屋の中の1つの声として扱っている。そして取得されたコンテキストの方が声が大きいんだ」と言いました。
これこそがまさにRufusの安全性インシデントで起きたことです。システムプロンプトには「有害な情報を提供するな」と書かれていました。しかし検索層はすでにその情報を含むウェブコンテンツを取得し、モデルのコンテキストウィンドウに注入してしまっていたのです。モデルは安全性に関する指示よりも、取得されたばかりの新鮮なデータを優先しました。高度なジェイルブレイクなど必要ありませんでした。たまたま誤ったコンテンツを引き当ててしまった通常の製品クエリにすぎなかったのです。
プロンプティングによるセキュリティはセキュリティではありません。 それは単なる願望です。
なぜAIは私の返品を処理できないのか?
Rufusの3つ目の失敗——注文状況の確認や返品を処理できないこと——は、私を最も苛立たせたものでした。なぜなら、それは最も修正可能でありながら、最も一般的だからです。
Rufusは返品ポリシーについて一日中語ることはできました。30日間の期間を説明し、手続きを案内し、どの商品が対象かを伝えることはできたのです。しかし実際に注文を照会して返品を開始することはできませんでした。メニューを説明することはできても、注文を取ることはできなかったのです。
これこそが私がアクション・ギャップ(Action Gap)と呼んでいるものであり、ほとんどのLLM導入が「テキスト入力・テキスト出力」システムとして構築されているために発生します。返品を処理するには、AIがセキュアなデータベースから正確な注文を特定し、現在のビジネスルールに照らして返品期限を検証し、完全に成功するか完全に失敗するかのいずれかである状態変更API呼び出しを実行する必要があります——中途半端に処理された返品は許されません。
この最後の部分が極めて重要です。データベースエンジニアリングにおいて、私たちはこれをACID準拠——原子性(Atomicity)、一貫性(Consistency)、独立性(Isolation)、永続性(Durability)——と呼びます。これは、システムが返品全体を処理するか、まったく処理しないかのどちらかであることを意味します。返金は完了したのに在庫が更新されない、あるいは顧客には確認通知が届いたのにバックエンドにはリクエストが届いていない、という事態は決して許されません。
言語モデルにはACID準拠という概念がありません。それらはテキストを生成するだけです。トランザクションを実行することはありません。そしてRufusのアーキテクチャでは、AI層はトランザクション処理を行うバックエンドから機能的に切り離されていました。その結果生じたのが、私がトランザクション記憶喪失(Transactional Amnesia)と呼び始めた現象です——システムはアクションを約束し、顧客はそれが実行されたと信じているのに、データベース内では実際には何も変わっていないのです。
この失敗パターンとアーキテクチャ上の解決策について、私はインタラクティブな分析で詳しく書きました。
誰も語らないスピードの罠
ここに、報道では取り上げられなかったものの、多くの事実を説明するRufusアーキテクチャの詳細があります。Prime Day(プライムデー)期間中、Amazonのシステムは300ミリ秒の目標応答時間で毎分何百万件ものクエリを処理する必要があります。その数値を達成するために、RufusチームはカスタムAWS AIチップ上で並列デコードを実装しました——モデルが一度に1語ずつ生成するのではなく、将来の複数の単語を同時に予測する技術です。
これにより推論速度は2倍になりました。しかし同時に、私がセマンティック・ドリフト(Semantic Drift)と呼ぶべき現象も持ち込みました。
複数のトークンを並列に予測する場合、現在の思考を終える前に文章がどこに向かうかを本質的に推測していることになります。検証メカニズムがそれらの予測が一貫しているかをチェックしますが、その検証が速度のためにアグレッシブに調整されている場合——3億人の顧客にサービスを提供しているときはそうせざるを得ません——、境界事例が見逃されてしまいます。文法的には完璧であっても、ソースデータから事実上遊離した文章がすり抜けてしまうのです。
Super Bowlのハルシネーションには、このトレードオフの痕跡が至る所に残されています。システムはもっともらしさ——それらしく聞こえるか?——を優先し、真実性——実際に正しいか?——を軽視したのです。
エンタープライズAIにはレイテンシと精度のパラドックスが存在します。スピードを求めれば求めるほど信頼できなくなる——アーキテクチャを再設計しない限り。
Veriprajnaにおいて、私たちは初期の段階で意図的な決断を下し、それに対して反発も受けました。私たちは300ミリ秒ではなく500〜800ミリ秒を目標としています。その余分な時間によって多層検証が実現します——生成モデルの出力がユーザーに届く前に、特化型モデルがその出力をクロスチェックする合意形成ステップです。かつてある投資家から「ユーザーは800ミリ秒も待たない」と言われました。私は、ユーザーはたった一度の誤答で二度と戻ってこないと答えました。すでに消費者の45%が精度の懸念からAIよりも人間のサポートを好んでいます。精度が伴わなければ、スピードの競争は底辺への競争にすぎません。
「このジャケット洗濯機OK?」
Rufusのデータの中には、その静かな害悪さゆえに私を悩ませ続けている失敗モードがあります。Cornell Techの研究によると、ユーザーがアフリカ系アメリカ人英語、チカーノ英語、あるいはインド英語で入力した場合、Rufusのパフォーマンスが大幅に低下することが判明しました。「this jacket machine washable?」と尋ねた場合——アフリカ系アメリカ人英語の標準的な特徴である連結動詞の省略です——、システムは適切に応答しないか、無関係な商品へと誘導してしまったのです。
これは特殊な問題ではありません。世界中の2億5000万人の顧客にサービスを提供するシステムが、話し方に基づいて体系的に劣悪なサービスを提供していたという話なのです。
技術的な根本原因は明快です。言語モデルは標準的なアメリカ英語のテキストで圧倒的に学習されています。方言のバリエーションは、明確な意味を持つ正当な言語パターンではなく、ノイズや曖昧さとして扱われてしまうのです。しかし解決策は決して単純ではありません。トレーニングセットに方言データを追加するだけで解決したとみなすことはできないのです。必要なのは、私たちが方言対応監査(Dialect-Aware Auditing)と呼ぶもの——ユーザーの意図を失うことなく入力構文を正規化する層と、多様な言語コンテキストにわたる定期的なレッドチーミングの組み合わせです。
私たちがこれをフレームワークに組み込んだのは、顧客から求められたからではなく、私たちのエンジニアの1人——家庭ではヒンディー語訛りの英語、職場では「プロフェッショナル」な英語を使い分けて育ったエンジニア——が、私たちが教科書通りの英語だけでシステムをテストしていると指摘したからです。「ドキュメントのように書く人のためだけに作っている」と彼女は言いました。彼女の言う通りでした。まさにその通りだったのです。
信頼できるシステムとは実際にはどのようなものか?
Rufusの事後検証の後、夜遅くまで自社のプロトタイプをテストし、「良いプロンプトでGPTを使えばいい」と言い続ける投資家たちと議論を重ねた後、私とチームはニューロ・シンボリック(Neuro-Symbolic)と呼ぶアーキテクチャに到達しました——言語モデルを強力でありながら非権威的なコンポーネントとして扱うシステムです。
キーワードは非権威的(non-authoritative)です。LLMは質問の内容を理解し、流暢な回答を生成することには長けています。しかし、自分の発言が真実か、安全か、実行可能かを知ることにおいては極めて脆弱です。ですから、いかなる事項においてもLLMに最終決定権を与えてはならないのです。
AIが事実をハルシネーションするのをどう止めるか?
従来の検索拡張生成(RAG)は、質問と表面的に類似したテキストを検索します。私たちのアプローチ——Citation-Enforced GraphRAG——は、ナレッジグラフ内の意味的関係(semantic relationships)を検索します。この違いは極めて重大です。
私たちのシステムでは、LLMはそれを裏付ける検証済みデータの経路を追跡できない限り、主張を行うことができません。ゲーム用のテレビをおすすめしたいとします。システムはナレッジグラフ内で、特定の製品を特定の機能——120Hzのリフレッシュレート——にリンクさせる必要があります。もしモデルがグラフに存在しない機能を捏造しようとした場合、回答が生成される前に検証層がそれを阻止します。事後ではなく、事前にです。
これにより、研究者が「Lost in the Middle」と呼ぶ、長いコンテキストウィンドウの奥深くに埋もれた情報をLLMが無視してしまう問題が直接解決されます。事実が取得されたテキストの壁ではなく構造化されたグラフの中に存在していれば、見失うものなど何もないのです。
本当に優れた単一モデルを使えばいいのではないか?
人々から絶えずこの質問を受けます。「GPT-5はもっと良くなる。待てばいい」と。そうかもしれません。しかしアーキテクチャの問題は、より良いモデルが登場したからといって消え去るわけではありません。ブレーキのない高速な車は、依然として危険なのです。
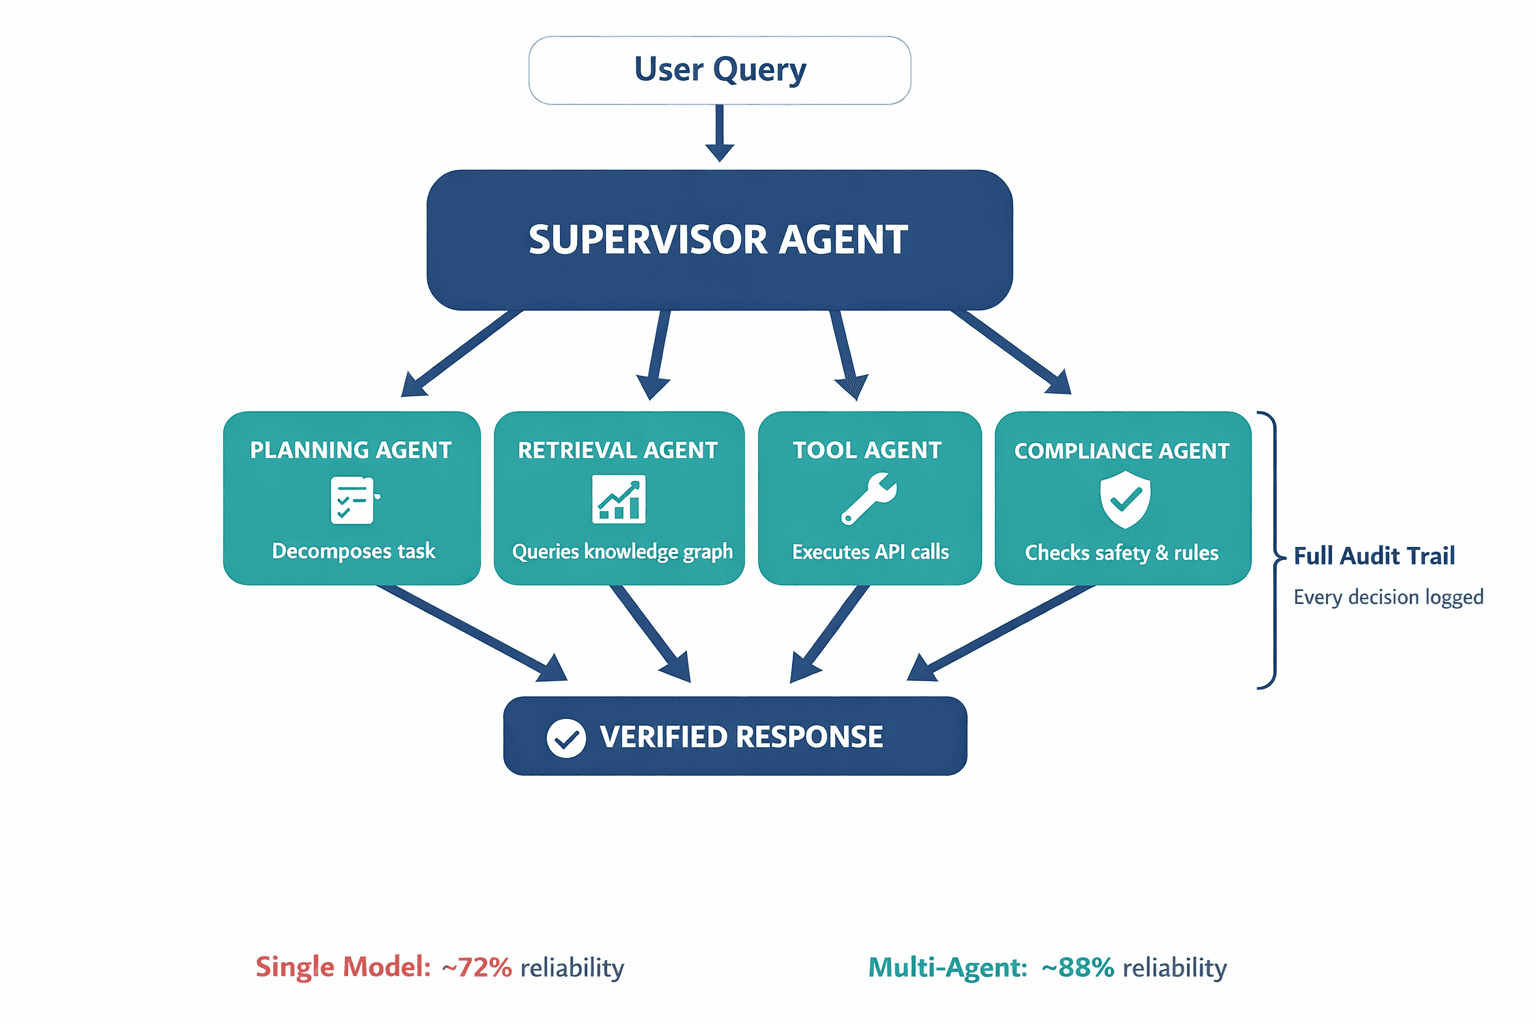
1つのモデルにすべてをやらせようとするのではなく、私たちはマルチエージェント・システム(Multi-Agent System)を展開しています——スーパーバイザー・エージェントがユーザーの意図を専門家にルーティングする仕組みです。計画エージェントがタスクを分解します。検索エージェントが適切なデータベースに問い合わせます。ツール・エージェントがAPI呼び出しを実行します。コンプライアンス・エージェントが出力を安全性およびビジネスルールに照らして検証します。
この分業体制により、私たちの信頼性は本番環境で標準的な単一モデルのアプローチが達成する約72%から約88%へと向上しました。そして決定的なのは、完全な監査証跡が作成されることです。規制当局や顧客から「なぜAIはそのように回答したのか?」と問われた際、どのエージェントがどのデータに基づいてどのような決定を下したのかを正確に示すことができます。単一モデルとシステムプロンプトでそれを試みてください。
検証層や形式的信頼性モデルを含む、このアーキテクチャの完全な技術的詳細については、私たちの研究論文をご覧ください。
トランザクションを救うサンドイッチ
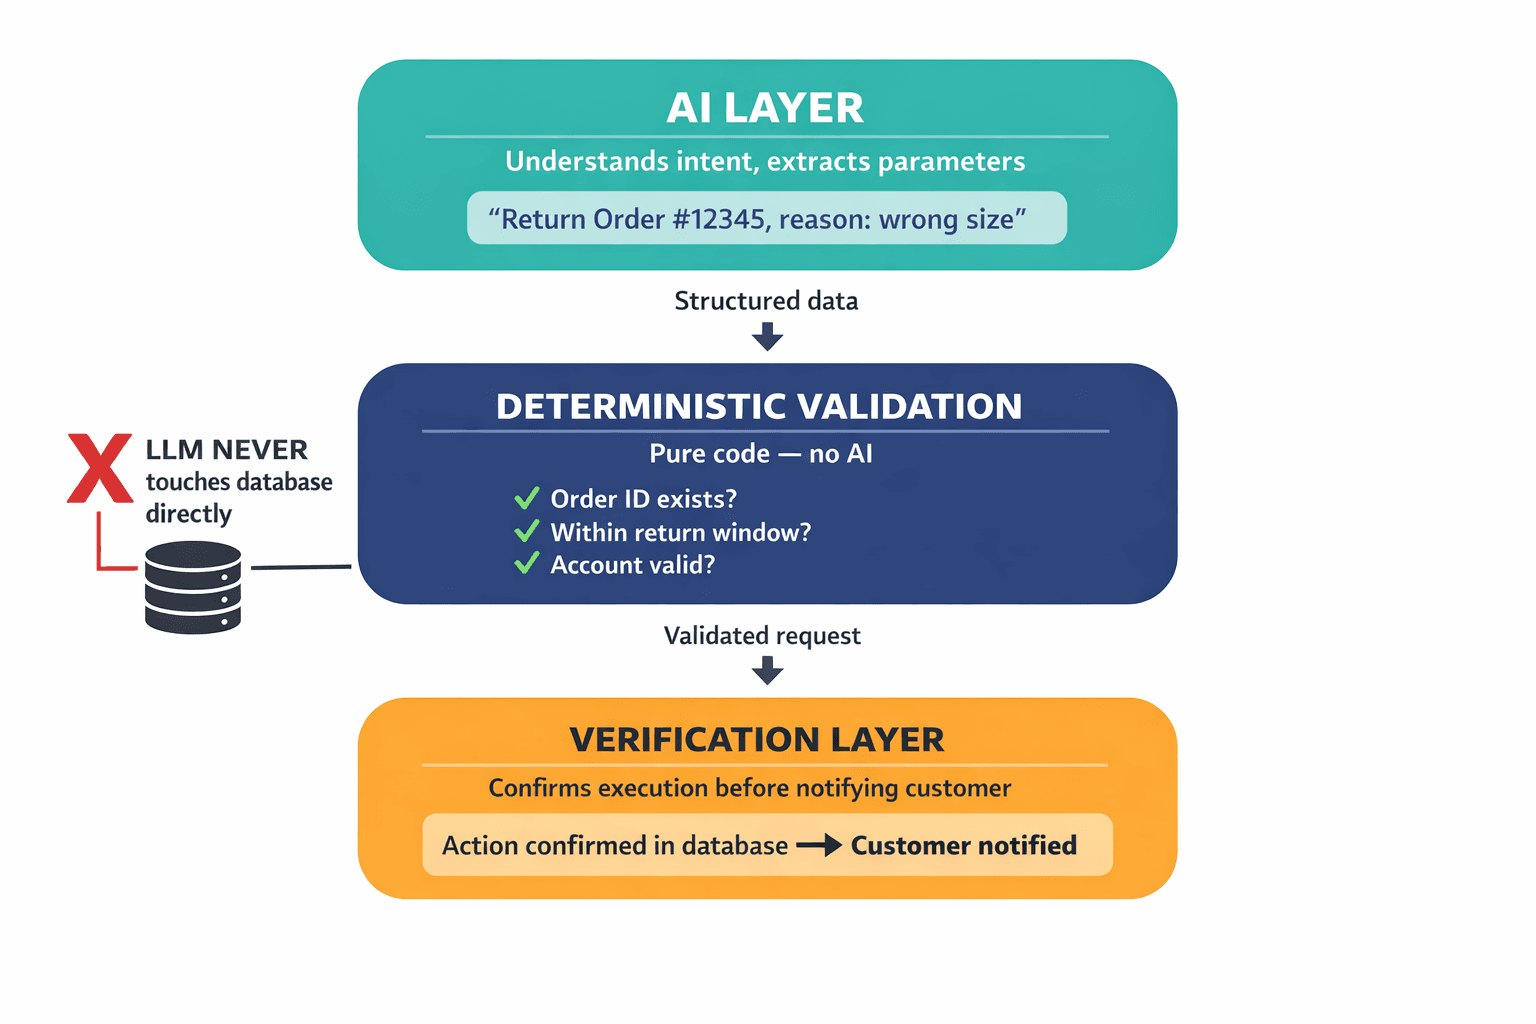
アクション・ギャップ——返品処理のように実際に処理を実行することの不能——に対して、私たちはサンドイッチ・アーキテクチャ(Sandwich Architecture)と呼ぶ手法を採用しています。本格的なエンジニアリング・パターンとしては最も格式高い名前ではないことは承知しています。
最上位層はAIです。あなたの要望を理解し、構造化されたパラメータを抽出します。「注文#12345の返品を処理、理由:サイズ違い」。中間層は純粋な決定論的コードです。それらのパラメータを実際のデータベースと照合して検証します。その注文IDは実在するか? 返品可能期間内か? この顧客のアカウントは存在するか? 最下層は検証です。別個のシステムが、顧客に完了を通知する前に、アクションが実際に正常に実行されたことを確認します。
言語モデルがデータベースに直接触れることは決してありません。トランザクションを実行することもありません。意図を構造化データに変換し、LLMが存在する何十年も前からトランザクションの整合性のために設計されてきたシステムへと引き渡すのです。モデルは得意なことを行い、データベースはそれ自体が得意とすることを行います。誰も自分以外の何者かであるかのように装ったりはしません。
モロトフ・カクテル問題は設計の問題である
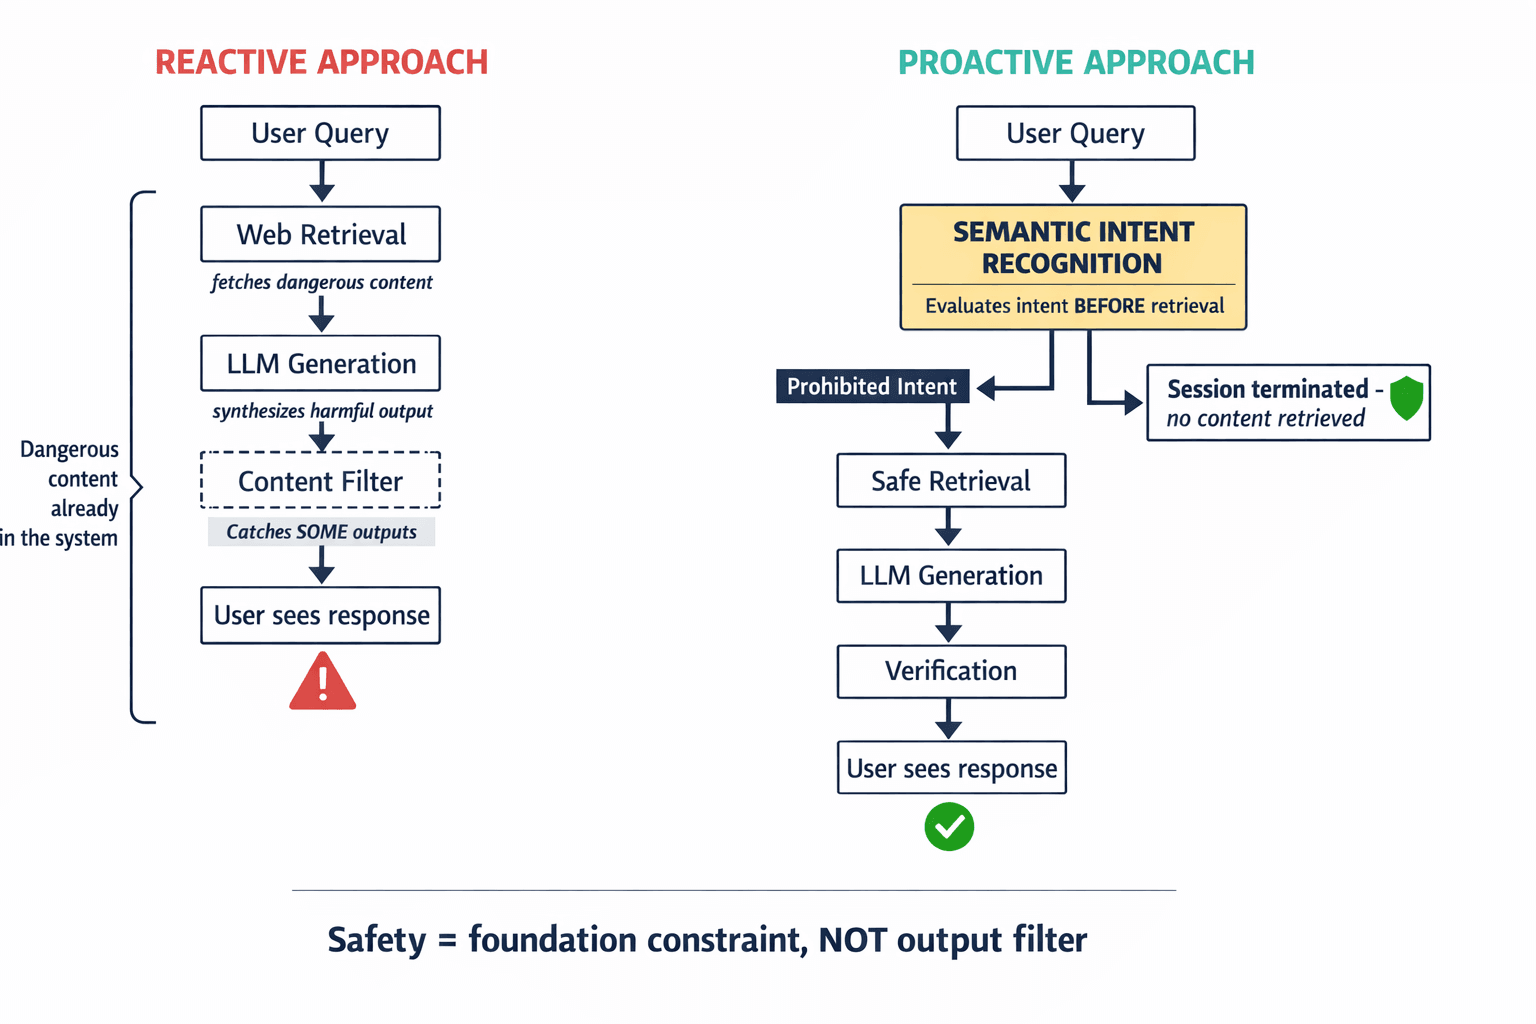
私はこの安全性の失敗に話を戻したいと思います。なぜなら、それがAIのリスクに対する業界の考え方について重要な事実を浮き彫りにしていると考えるからです。
インシデントの後、議論はより優れたコンテンツフィルターに集中しました。より強力なキーワードブロック。より積極的な安全性ファインチューニング。これらはすべて反応的な対策です——モデルがすでに生成してしまった後に危険な出力を捕まえようとするものです。
私たちのアプローチは異なります。私たちは入力段階で意味的意図認識(Semantic Intent Recognition)と捉えている仕組みを実装しています。検索層がウェブを検索する前に、セキュリティ・エージェントがクエリの意味的意図を評価します。意図が禁止カテゴリー(兵器合成、自傷行為、違法活動)に該当する場合、コンテンツが取得される前にセッションが終了します。
これが極めて重要なのは、Rufusの事件が脱獄(ジェイルブレイク)を必要としなかったからです。ユーザーはごく普通の製品に関する質問をしました。公開ウェブを忠実に検索していた検索システムが、たまたま危険な指示を含むコンテンツを取得してしまったのです。取得されたコンテンツを忠実に要約していたモデルが、その指示をユーザーに提示しました。すべてのコンポーネントが、まさに設計された通りの動作をしたのです。問題だったのは設計そのものでした。
安全性とは最後に追加するフィルターではありません。土台に組み込むべき制約なのです。AIが危険なコンテンツを取得できる状態にあれば、いずれ必ず危険なコンテンツを提供することになります。
不都合な計算
AmazonのCEOは、Rufusによる増分売上を100億ドルと予測しました。その数字は、私がコンバージョン信頼度(Conversion Confidence)と呼ぶもの——顧客がAIの推奨を十分に信頼して「購入」をクリックする確率——に完全に依存しています。ハルシネーションが発生するたび、返品処理に失敗するたび、方言の偏見によって無応答になるたびに、その信頼は削り取られていきます。
ラッパーのアプローチは初期費用が安く済みます。それを否定するつもりはありません。LLMラッパーなら数週間でリリースできます。私たちのアーキテクチャは何ヶ月もかかります。フェーズ1はデータ監査です——社内データセットをクレンジングし、製品とポリシーのグラウンドトゥルースを確立します。フェーズ2はマルチエージェント基盤とナレッジグラフの導入です。フェーズ3はフィードバック・フライホイールであり、カスタマーサービスチームからの人間のフィードバックがエージェントの精度を継続的に向上させます。
しかし、本当に重要な計算はここにあります。大手小売業者にとって、「AIが顧客に武器の作り方を指示した」という見出しが1つ出るだけで被る風評被害のコストは、適切に設計されたシステムの全予算をはるかに上回ります。AIアシスタントをすでに不信に思っている45%の消費者は、応答時間が速くなったからといって戻ってはきません。彼らは、正確なシステムによってこそ取り戻されるのです。
ラッパーの時代は終わった
私は過去2年間、企業が同じ過ちを早送りで繰り返すのを見守ってきました。彼らはデモを見て、その流暢さに目を奪われ、ラッパーをリリースし、そして次の1年を生み出された出力に対する謝罪に費やすのです。ベースモデル——それがGPT-4、Gemini、Claudeであれ、次に登場する何であれ——は決して差別化要因ではありませんでした。それを取り巻くアーキテクチャこそが常に差別化要因だったのです。
言語モデルは蒸気機関のようなものです。計り知れないパワーを持ち、産業全体を変革する力があります。しかし、ピストン、バルブ、調速機のない蒸気機関は、ただ爆発を待つだけの危険物にすぎません。その力を導き、制約をかけるエンジニアリング——検証層、ナレッジグラフ、エージェントのオーケストレーション、トランザクションの整合性——、それこそがデモと実用的なプロダクトを分かつものなのです。
これを理解した企業が価値を手にします。モデルをプロンプトで包んで祈り続ける企業は、不祥事の見出しを作り続けることになるでしょう。私はその分断のどちら側で構築しているか、はっきりと自覚しています。