韌體風險估計值的降低並不等同於發布准許

韌體熱修復可能使風險估計值顯著改善,但在已聲明的策略下,該發布版本可能依然不被接受。對於決定是否更新智慧電表機群的工程團隊而言,這是兩種截然不同的判定。改善說明了候選版本本身的某些特性;而准許發布則取決於剩餘風險、受評估的母體以及估計背後的證據。
我圍繞保持這些判定的可見性構建了MeterGuard。這是一個使用合成電表母體和合成韌體清單的韌體發布預檢演示。它根據變更日誌估計行為,對照機群健康狀況對該行為進行建模,並發布本地建議。它既不會向電表發送韌體,也不會攔截實際更新。真正有價值的問題在於,這種分離能讓發布負責人審查什麼,以及它依然無法確立什麼。
改善與可接受性回答的是不同的問題
以標有Plano Water的合成母體為例。初始候選版本在受評分端點中產生的建模平均故障率為74.22%。熱修復版本則為2.85%。兩項結果均使用快取的模型輔助行為設定檔,而非從韌體二進位檔案中實測的行為。在這些假設前提下,該熱修復是一項實質性的改進。即使最終的建議依然是NO-GO,這一對比也值得保留。
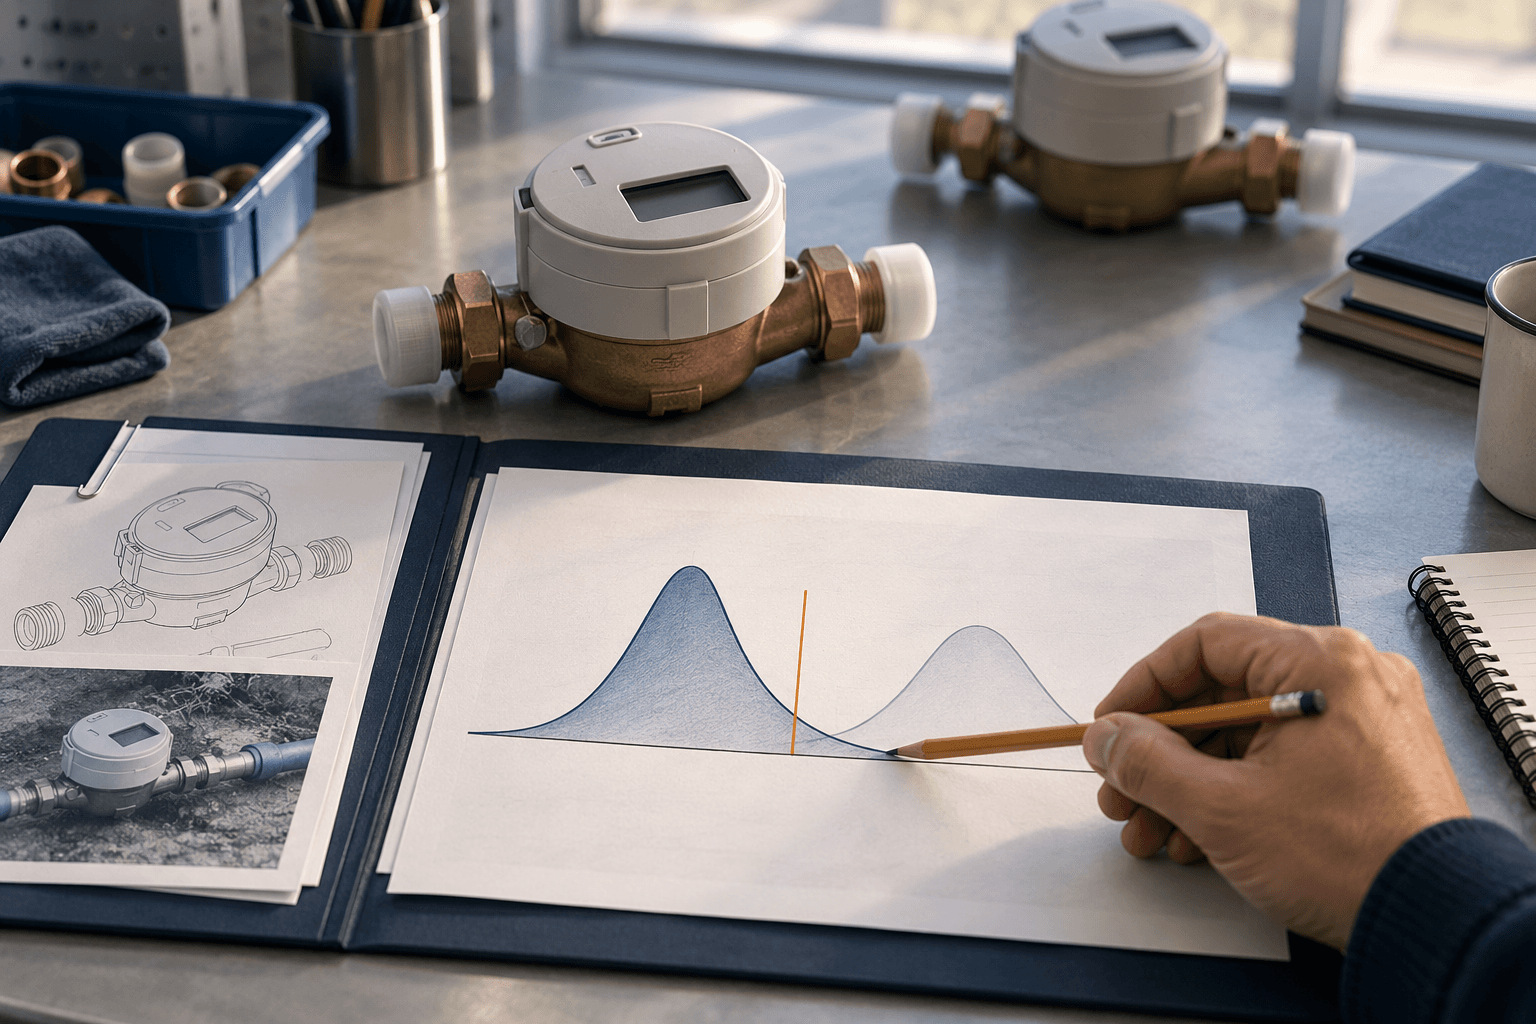
發布門首先檢查90%建模區間的上限。若達到或超過受評分端點的3.0%,則返回NO-GO。對於該熱修復版本,在86,078個受評分端點中,建模故障平均值為2,449個,區間範圍為1,536至3,531個。上限比率為4.10%,因此適用硬性阻斷規則。另有1,922個端點因缺乏足夠的遙測數據而從該預測中排除,並建議進行人工複核。
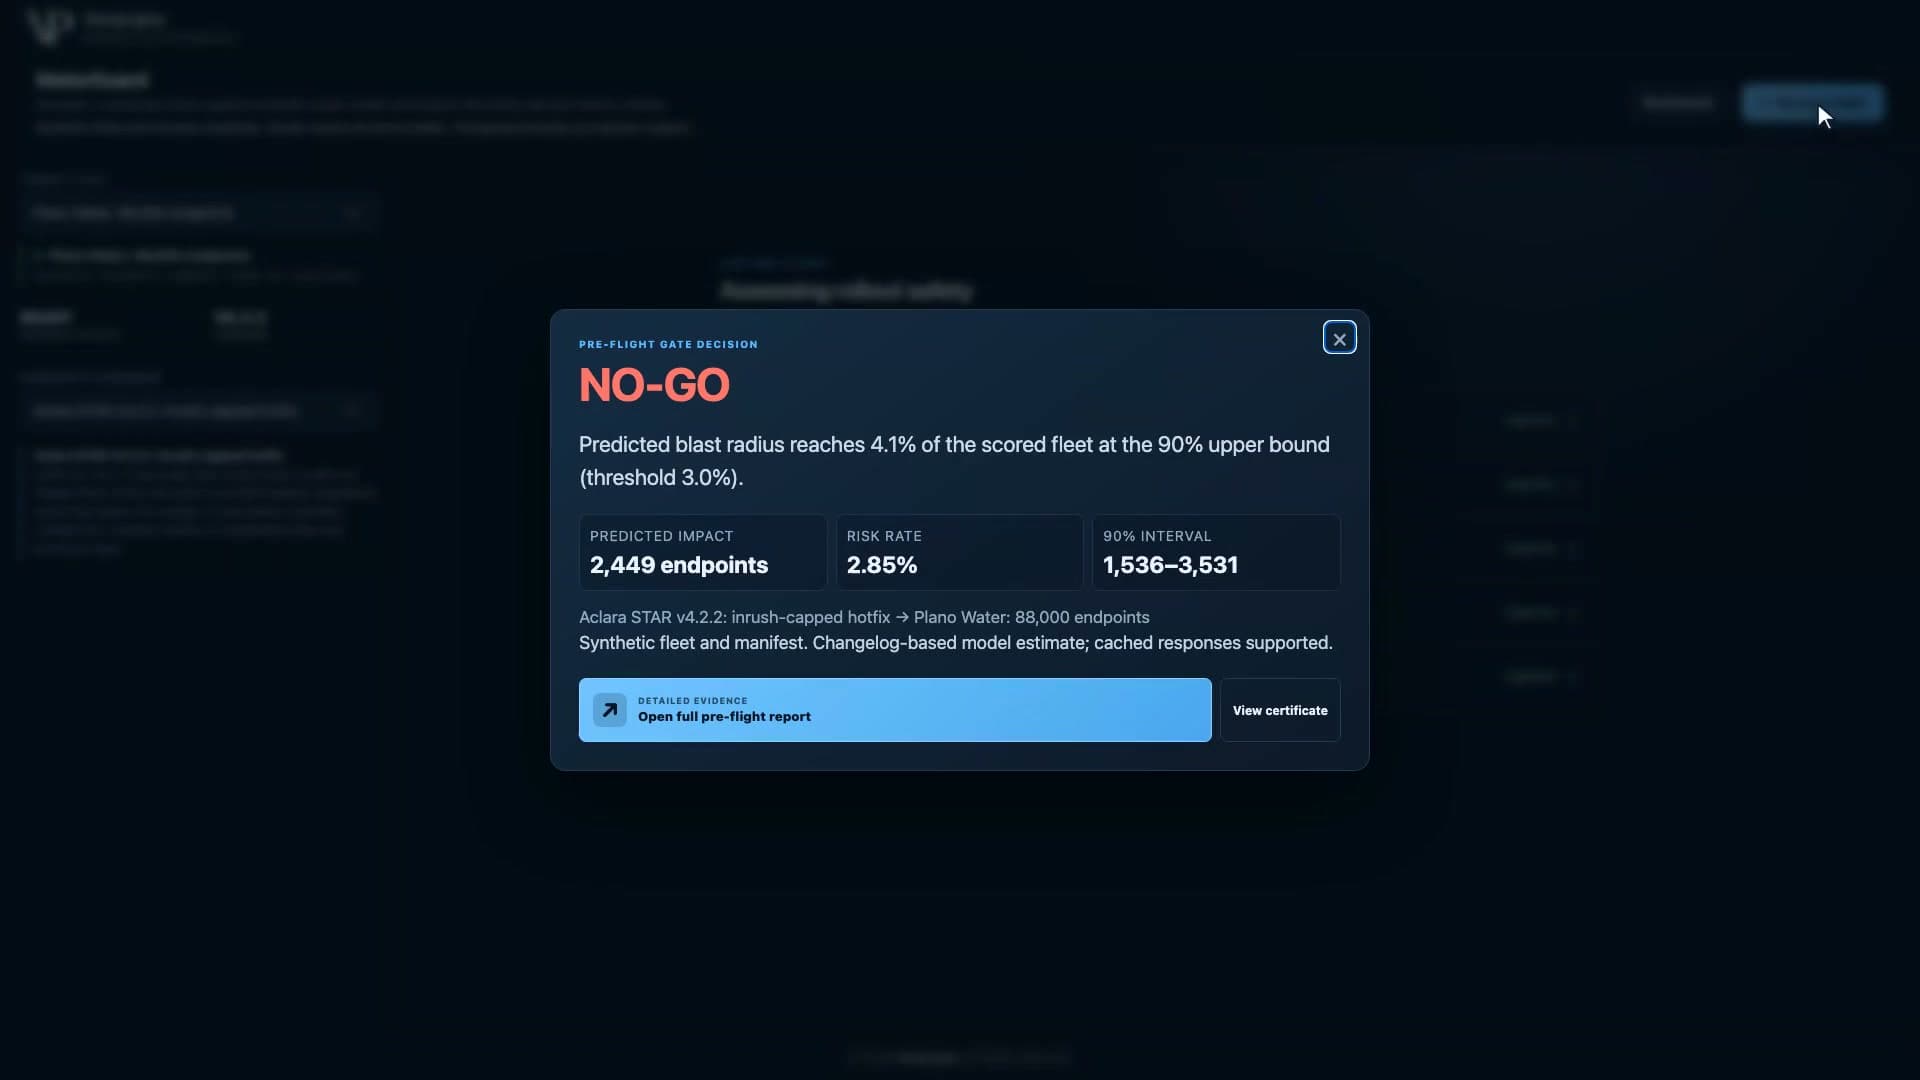
僅看平均值的解讀會忽略為何這是一個硬性阻斷。根據策略的其他部分,該候選版本同樣不符合GO的條件:GO要求在通過上限和置信度檢查後,平均值必須達到或低於0.5%。居中的數值風險則導向STAGED-CANARY。這種區分至關重要,因為「更好」、「符合有限證據收集步驟的資格」以及「處於GO規則之內」絕不應混為一談並簡化為一個令人安心的標籤。
我傾向於保持改善情況的可見性,但不允許其重新協商既定邊界。如果團隊在面對令人失望的建議時透過放寬閾值來應對,那就意味著它已經改變了驗收策略。在特定環境下,這或許是一個站得住腳的決定,但它是一個需要獨立理由的獨立決定。證明一個候選版本優於另一個候選版本的證據本身並不能提供這些理由。
這種立場是有代價的。保守的邊界可能會推遲一個本可以成功的候選版本。建模區間的上限並不是實際觀察到的現場結果,將區間稱為「90%」並不能確立其在公用事業機群中的覆蓋率。本演示無法確定真正的公用事業公司應當採用何種閾值。它所能展示的是,一項建議究竟是遵循了此前聲明的閾值,還是遵循了為了迎合結果而悄然調整的閾值。
准許同時歸屬於候選版本與母體
同樣的微調熱修復行為估計值,在針對標有Hill Country Electric Co-op的生成母體時,得出了截然不同的結果。其建模平均故障率為0.02%,上限區間率為0.03%,校驗門針對118,222個受評分端點返回了GO。與合成Plano母體相比,該母體擁有更健康的電池分佈和更少的弱無線電信號。其1,778個被排除的端點依然處於該建議之外。
這是對跨生成健康度分佈的估計寫入行為的比對。它完全不涉及將一家製造商的韌體映像安裝在另一家製造商的硬體上。相容性以及基於二進位檔案的驗證是演示原型未執行的獨立工作。
這種對比改變了我對發布建議表達方式的要求。「此韌體風險較低」未指明適用範圍。「該估計行為在此受評分母體上符合此項策略」則保留了該結果得以成立的前提條件。電池狀況和無線電恢復是建模結果的輸入參數,因此良好的結果不能脫離這些參數並直接套用到另一個機群中。
對於發布負責人而言,這催生了應對不利建議的兩種不同方式。其一是改進候選版本的行為或用於評估該行為的證據;其二是考慮條件足以支撐不同評估結論的更狹窄母體。這兩種方式解決的是不同的問題。更狹窄的評估範圍可能會降低建模暴露面,但會導致其餘母體懸而未決。關於候選版本的更充分證據或許能優化估計,但絕無法憑空變出缺失的機群遙測數據。
這些替代方案是前瞻性的工程抉擇,而非本演示所執行的操作。它們的價值在於將工作指引至不確定性的根源。單憑判定結果無法告訴團隊究竟是需要更好的候選版本、更好的行為畫像,還是需要關於目標接收對象的更完善資訊;但與之並列的輸入數據與排除項卻能做到這一點。
程式碼校驗門無法核實模型所深信的內容
MeterGuard將策略保留在純程式碼中。模型輔助的治理備忘錄生成於判定之後,無權直接推翻該判定。我之所以堅持這種分離,是因為流暢的解釋絕不能悄然演變為新的發布規則。
模型在工作流程前端仍具有重大影響。其韌體設定檔根據合成變更日誌文本估計電流消耗、重設後恢復以及快閃記憶體寫入行為。這些估計值隨後被送入模擬器。即使校驗門程式碼從未改變,不同的設定檔也會改變建模故障數,進而改變判定結果。可檢查的策略確立了輸入是如何被評判的;它並不能證明輸入本身是正確的。
變更日誌內容單薄的案例使這種區別顯現出來。在面對相同的生成Co-op母體時,其建模平均值僅為0.05%,上限率為0.06%。這些數值完全通過了數位邊界。然而該設定檔攜帶了低置信度標籤,因此校驗門推薦了STAGED-CANARY而非GO。稀疏的韌體證據被作為暫不給出廣泛推薦的獨立理由。
這是一項有益的防線,但也存在自身的局限。模型的置信度標籤並非經過校準的經驗確定性。要求非「低」標籤可以防止某個公認的證據空白被忽視;但它無法證實「高」標籤就一定準確。若要在生產環境中作為依據,該設定檔需要針對實際的韌體行為與結果進行驗證。這依然是超越該合成演示範圍的工作。
最安全的樣本留下了更棘手的疑問
提議的階段性路線採用了來自最低建模風險群組的500個端點,設定了72小時的觀察保持期,並在擴大範圍之前使用觀測到的遙測數據進行重新評估。演示原型推薦了該計劃;但它並未執行金絲雀發布或收集其實際觀察數據。設定的擴大準則是觀測故障率低於0.1%。
我認為首先選擇最安全群組存在實際的權衡。它減少了第一步提議的風險暴露面。但使機群狀況變得重要的同一邏輯,也限制了該步驟對於處於較差狀況的端點所能證明的結論。在一個假設的行動中,觀察到在健康電池和良好無線電連接下的成功更新,可以支撐針對該測試樣本的主張;但這對於候選版本在老化電池或微弱無線電連接下的表現如何,依然懸而未決。
面對這一鴻溝,至少有兩種合理的應對方式。團隊可以將擴大範圍持續限制在與觀察樣本充分相似的母體上,接受較慢的覆蓋進度,並將退化端點保持待定狀態;或者,在考慮這些端點之前,去尋求針對退化條件的專門證據,例如對相關電池和恢復行為進行受控驗證。第二條路徑需要更多工作;第一條路徑則接受了更狹窄的結論。但這兩種方式都不能僅憑一紙聲明就讓安全樣本具備代表性。
這正是我將STAGED-CANARY視作對特定證據的請求、而非GO的溫和同義詞的原因。階段性計劃需要明確其觀察數據將證明什麼以及在何處止步。若缺乏該範圍界定,一個看似謹慎的流程依然可能得出過度泛化的結論。
以下是創辦人關於MeterGuard中這些智慧電表發布決策的演練介紹。
這份MeterGuard解析指南展示了預檢工作流程及其決策記錄。我的設計理念是將估計行為、評分母體、排除對象與既定規則與推薦結果並列展示。對於發布負責人而言,檢驗的關鍵在於提議的下一步舉措能否解決導致暫停的不確定性。如果它僅在最順暢的工況下進行觀察,而決策所關切的卻是更嚴苛的條件,那麼准入邊界便依然處於等待證據的狀態。