Amazon AI教顧客製造燃燒彈。我深知其背後的架構死穴。

當時我正與一家潛在客戶——一家大型電商企業,雖不是Amazon但也規模可觀——通電話,對方的工程副總裁說了句讓我不得不放下手中咖啡的話。
「我們的AI助手基本上已經完工了。現在只需要找人微調一下提示詞(prompts)即可。」
我以前就聽過這種論調。這種堅信企業級AI只是個提示詞工程問題的觀念:找一個基座模型,套上一段「要樂於助人、確保安全、別胡言亂語」的系統提示詞,對接上自家的產品目錄,然後直接推向市場。以往別人這麼說時,我還會禮貌性地點點頭。但在目睹了2024年Amazon Rufus上線的慘烈崩潰之後——把Super Bowl(超級碗)的舉辦地胡亂編造,在常規的產品搜尋查詢中居然提供了製造燃燒彈的指引,甚至連最基礎的退貨流程都無法處理——我再也無法點頭附和了。
「你們根本沒有完工,」我告訴他,「你們甚至還沒真正開始。」
Rufus的慘劇並不是一場公關失誤,也不是模型本身的品質瑕疵。它是一個架構問題。而這正是我所審計過的幾乎每一個企業級AI落地專案中都潛藏的相同架構問題。模型運轉良好,但圍繞著它搭建的系統卻是一座紙牌屋。
Amazon Rufus到底在什麼環節出了差錯?
關於Rufus的新聞報導,大多數人都理解偏了。媒體頭條都聚焦在輸出結果上——報錯Super Bowl舉辦地、給出危險製造指引、退貨流程崩潰。評論家們紛紛指責模型本身。「GPT根本不適合電商業務,」他們斷言,「大語言模型本來就會產生幻覺,你們還指望什麼?」
但我花費數週時間深入拆解了那次上線的技術細節,模型並非主要失效點。真正的問題出在接地架構(grounding architecture)之上。
試想一下,當你詢問Rufus超級碗在哪裡舉行時,底層究竟發生了什麼。系統從公開網路檢索文字片段——有的資訊是最新的,有的早已過時,有的甚至來自論壇網友的隨手留言。系統將這些零散片段餵給語言模型。模型根據接收到的素材拼湊出一段回答。如果檢索機制抓取到了相互衝突的資訊,或者模型的預訓練資料(存在知識截止日期)與檢索到的文字相抵觸,模型就必須自行裁量。然而語言模型並不具備裁量能力。它們所做的只是機率統計預測。
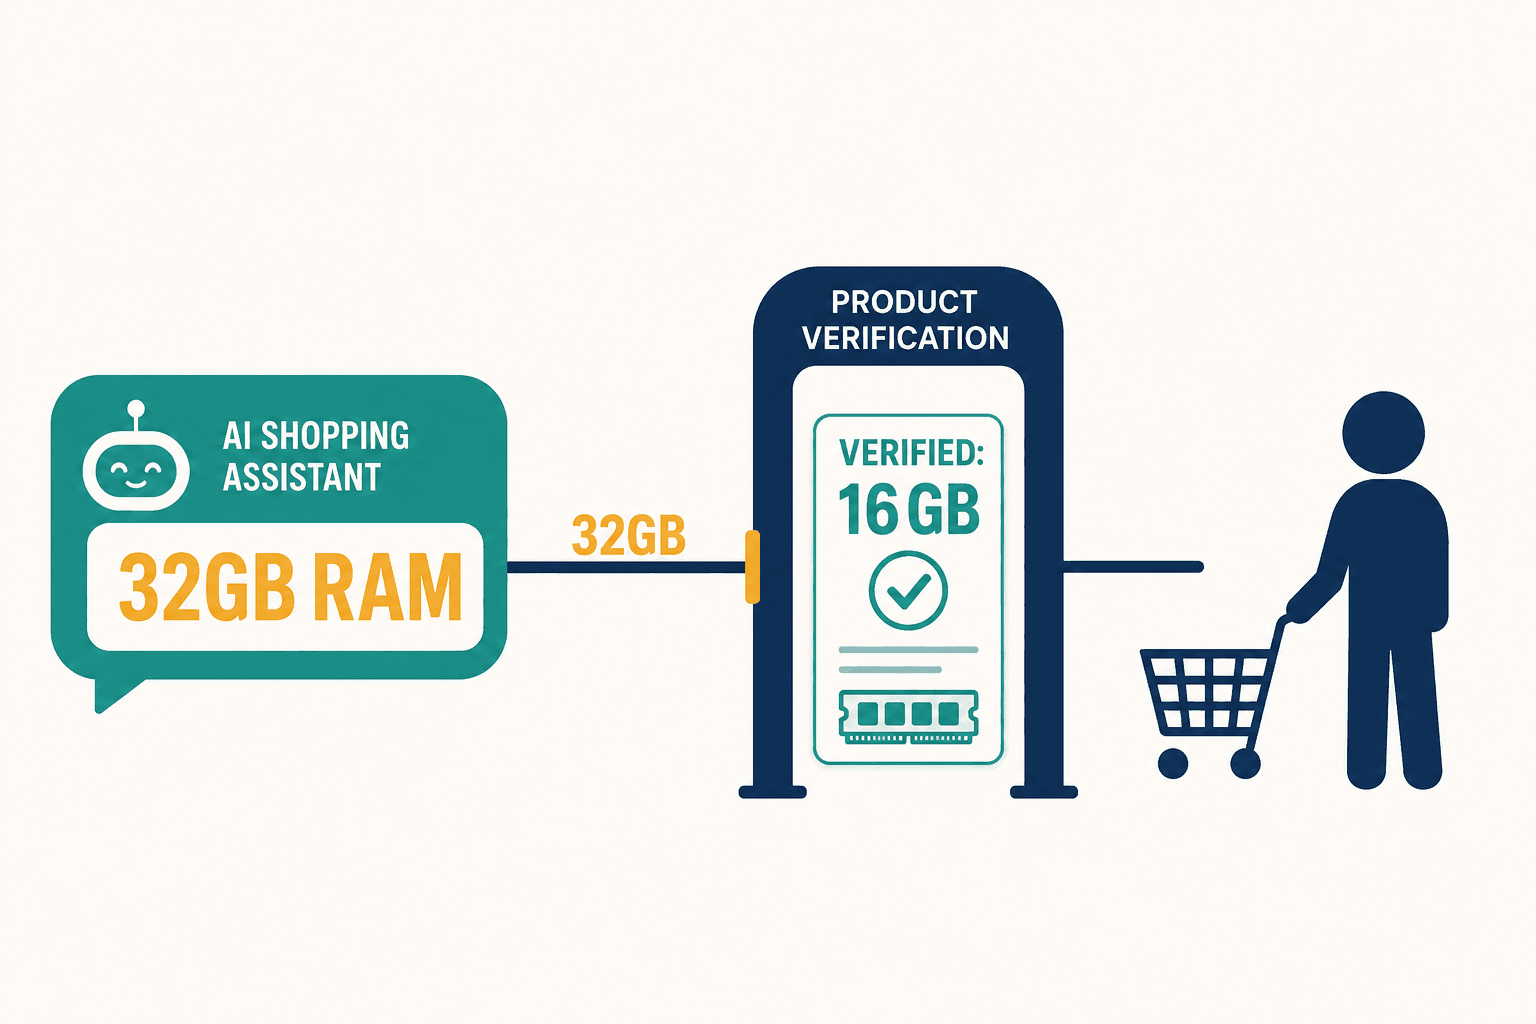
整個鏈路中不存在二次校驗層,沒有用於交叉比對的事實知識圖譜,沒有任何機制能夠發出警報:「等等——模型剛剛聲稱Super Bowl在X市舉辦,但我們已驗證的事實資料庫顯示它在Y市。」模型未經校驗的憑空猜測直接推送給了客戶。
當你構建AI系統卻缺乏驗證層時,你造就的不是智慧助手,而是一個自信滿滿的說謊者。
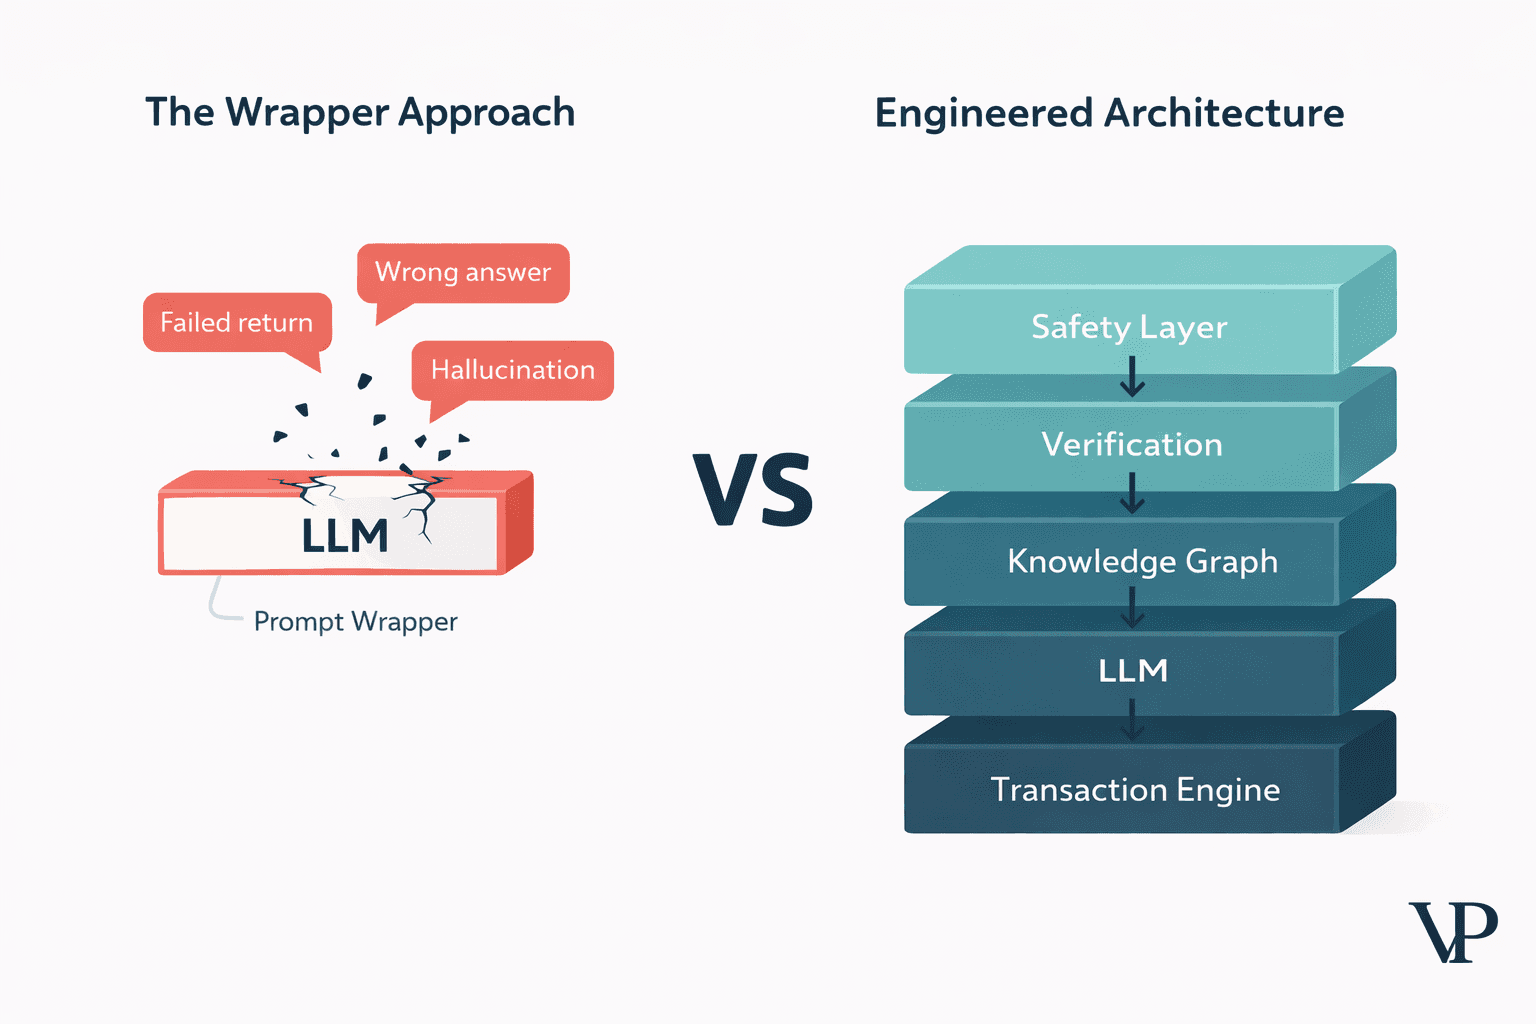
這就是我所說的「LLM套殼(Wrapper)」模式的致命傷。選用一個強大的生成式模型,給它裹上一層輕薄的軟體外殼,然後開始祈禱奇蹟。
讓我幡然醒悟提示詞無能為力的那個深夜
我清楚記得這一認知在我腦海中徹底定格的時刻。當時我們正為一家客戶構建系統原型——並非零售行業,而是一個錯誤答案會帶來嚴重法律後果的專業領域。我們配置了自以為固若金湯的系統提示詞,寫滿了整頁整頁的戒律:「務必引用資料來源。絕不可主觀推測。若不確定,請明確如實相告。」
那是個深夜11點,我和聯合創始人正在進行對抗性測試。並非惡意越獄攻擊,只是故意用略微反常規的口吻提出日常問題。就像現實中疲憊的使用者在凌晨2點打字,行文並不遵循教科書般的完美標準英語。
系統隨即開始胡言亂語。並非戲劇化地教唆造武器,而是憑空捏造了一項根本不存在的產品功能,引用了早在兩年前就已作廢的退貨政策,對一個本該拒答的問題給出了斬釘截鐵的虛假回覆。
我轉頭對聯合創始人說:「提示詞只是一種建議,模型完全把它當成了耳旁風。」他審視著後台日誌回答:「不,模型把它當成了喧鬧屋子裡無數聲音中的一種。而外部檢索注入的上下文,嗓門顯然大得多。」
這正是Rufus安全事故背後的真實機制。系統提示詞白紙黑字寫著「嚴禁提供有害資訊」。但檢索層卻直接抓取了包含危險資訊的網頁內容,並粗暴注入到了模型的上下文視窗中。模型天然優先信賴新檢索到的外部資料,完全壓過了內在的安全準則。這甚至根本不需要黑客級的複雜越獄手段,僅僅是一次普通的產品查詢,陰差陽錯抓取了致命內容。
依靠提示詞建立的安全性從來都不是真正的安全。 那不過是自欺欺人的幻想。
為什麼AI始終辦不好退貨手續?
Rufus的第三大敗筆——無法處理訂單狀態查詢或退貨——最讓我感到沮喪,因為這是最可解決卻又最普遍的問題。
Rufus可以整天就退貨政策高談闊論。它可以解釋30天的期限,描述操作流程,告訴你哪些商品符合條件。但它真正做不到的,是實際查詢你的訂單並發起退貨。它可以把菜單描繪得天花亂墜,卻根本無法為你下單。
這就是我所說的行動鴻溝(Action Gap),它的存在是因為大多數LLM部署都是按「文字輸入、文字輸出」的系統構建的。處理一次退貨需要AI在安全資料庫中精準定位正確訂單,對照當前業務規則校驗退貨有效期,並執行一個要麼全部成功要麼全部失敗的狀態變更API調用——絕不允許出現只處理了一半的退貨。
最後這一環至關重要。在資料庫工程學中,我們稱之為ACID合規性——原子性(Atomicity)、一致性(Consistency)、隔離性(Isolation)和持久性(Durability)。它意味著系統要麼圓滿完成整筆退貨交易,要麼徹底回滾顆粒無收。決不能出現錢退了而庫存未更新,或者客戶收到確認通知而後台卻毫無記錄的荒唐局面。
大語言模型對ACID合規性毫無概念。它們只管生成文字,不會執行底層事務。而在Rufus的系統架構中,AI層與底層的事務資料庫在功能上完全脫節。由此引發了我所稱的事務性遺忘(Transactional Amnesia)——系統開出了空頭支票,客戶誤以為事情辦妥,而資料庫底層根本未發生任何變動。
我在我們的互動式分析中詳細剖析了這種失效模式及其架構解決方案。
無人提及的速度陷阱
這裡有一個來自Rufus架構的技術細節,雖未被媒體報導卻說明了關鍵問題。在Prime Day期間,Amazon系統每分鐘需要扛住數百萬次查詢,目標回應時間卡死在300毫秒以內。為了達標,Rufus團隊在客製化的AWS AI晶片上啟用了並行投機解碼技術——即模型不再逐字生成,而是一口氣同時預測接下來的若干詞彙。
這確實讓推論速度飆升了一倍,但也滋生出了我所謂的語義漂移(Semantic Drift)風險。
當你並行預測多個Token時,你本質上是在當前語義尚未閉合的前提下盲猜句子的走勢。雖然校驗機制會審查這些預測詞是否通順,但如果這道關卡為了極致迎合3億客戶的吞吐速度而被大幅放寬,邊緣失效就會蒙混過關——生成文法完美無缺卻在事實上與事實根據徹底脫鉤的荒謬文句。
Super Bowl的幻覺完全烙印著這種妥協的痕跡。系統最佳化了看似合理性——這聽起來像真的嗎?——而不是真實性——這在事實上確實正確嗎?。
企業級AI始終面臨著延遲與準確率的悖論:你越盲目追求毫秒級速度,系統就越不可靠——除非你徹底重構系統架構。
在Veriprajna,我們在早期就做出了一項曾招致不少反對的清醒決定:我們將目標時延設定在500至800毫秒,而非激進的300毫秒。這多出來的幾百毫秒為我們贏得了寶貴的多層驗證視窗——在生成結果觸達使用者前,由專門模型開展多方共識交叉核驗。曾有投資人質問我:「使用者可等不了800毫秒。」我告訴他,使用者遇到一次離譜誤答就永遠不會再來。45%的消費者因擔心準確率而更傾向人工客服。若沒有準確率保駕護航,所謂的測速競賽不過是通往毀滅的競次劣汰。
「這夾克機洗行嗎?」
Rufus日誌中有一個隱秘而危害極大的失效模式讓我一直耿耿於懷。Cornell Tech的一項學術研究表明,當使用者使用非裔美國人英語、奇卡諾英語或印度英語提問時,Rufus的表現急劇惡化。例如有人輸入「this jacket machine washable?」——省略了繫動詞,這是非裔英語的標準文法——系統要麼答非所問,要麼推薦毫無瓜葛的商品。
這絕非細枝末節的小事。一個服務全球數億使用者的標竿系統,居然僅僅因為消費者的口語習慣而系統性提供歧視性的次等服務。
技術病灶非常明了:現存語言模型絕大多數是用標準美國英語語料訓練出來的。方言變體被系統粗暴當成了雜音或歧義,而非具有嚴謹語意的合法表達。但解法絕非再往訓練集裡灌點方言資料那麼輕巧。你必須建立我們所謂的方言感知審計(Dialect-Aware Auditing)機制——一層在嚴格保全使用者真實意圖的前提下正規化輸入語法的層級,並結合跨多元語言環境的常態化紅隊測試。
我們之所以在架構中內建這一層,並非出於客戶施壓,而是我們團隊一位從小在家庭印式英語和職場精英英語間自如切換的女工程師一語道破了盲點:「你們是在為只懂寫技術文件的人設計產品。」她說得一針見血,我們此前確實深陷其中。
真正靠譜的企業級架構究竟該長什麼樣?
在經歷對Rufus的復盤剖析、無數個深夜測試我們自研的原型、以及與無數堅稱「只要提示詞好GPT就能解決一切」的投資人激烈交鋒後,我和團隊確立了一種我們稱之為神經符號(Neuro-Symbolic)的架構體系——該體系將大語言模型僅定性為一個功能強大但決無最終決定權的計算元件。
核心原則在於非權威性(non-authoritative)。LLM在理解自然語言和組織流暢句式上堪稱天才,但在判斷自己輸出的內容是否屬實、合規、可落地上卻極其脆弱。因此,在任何關鍵業務判定上,我們絕不賦予它一票裁定權。
如何徹底扼殺AI的事實捏造與幻覺?
傳統的檢索增強生成(RAG)只是機械匹配外觀相似的文字段落。而我們的方案——基於引用強制約束的GraphRAG(Citation-Enforced GraphRAG)——則是深入檢索知識圖譜中的語義關係(semantic relationships)。這兩者有著天壤之別。
在我們的系統中,LLM要想給出一句論斷,必須能從圖譜中找出一條經過核實的事實路徑來佐證。想要給遊戲玩家推薦電視機?系統必須在圖譜中將具體型號與120Hz更新率這一精準屬性強行錨定。一旦模型試圖腦補圖譜中不存在的特性,校驗層在回答生成階段前就會當場攔截。事前阻斷,而非事後收拾殘局。
這從根本上根治了學術界常說的長上下文「迷失在中間(Lost in the Middle)」難題。當確鑿事實沉澱在嚴謹的結構化圖譜中而非淹沒在浩瀚的非結構化長文中時,資訊就永遠不會迷路。
為什麼不能單純指望一個超級強悍的大模型?
經常有人問我:「等GPT-5出來不就迎刃而解了嗎?」也許新模型更聰明,但架構缺陷不會因為換上新引擎就憑空蒸發。一輛沒有煞車裝置的高速跑車,馬力越大只會越危險。
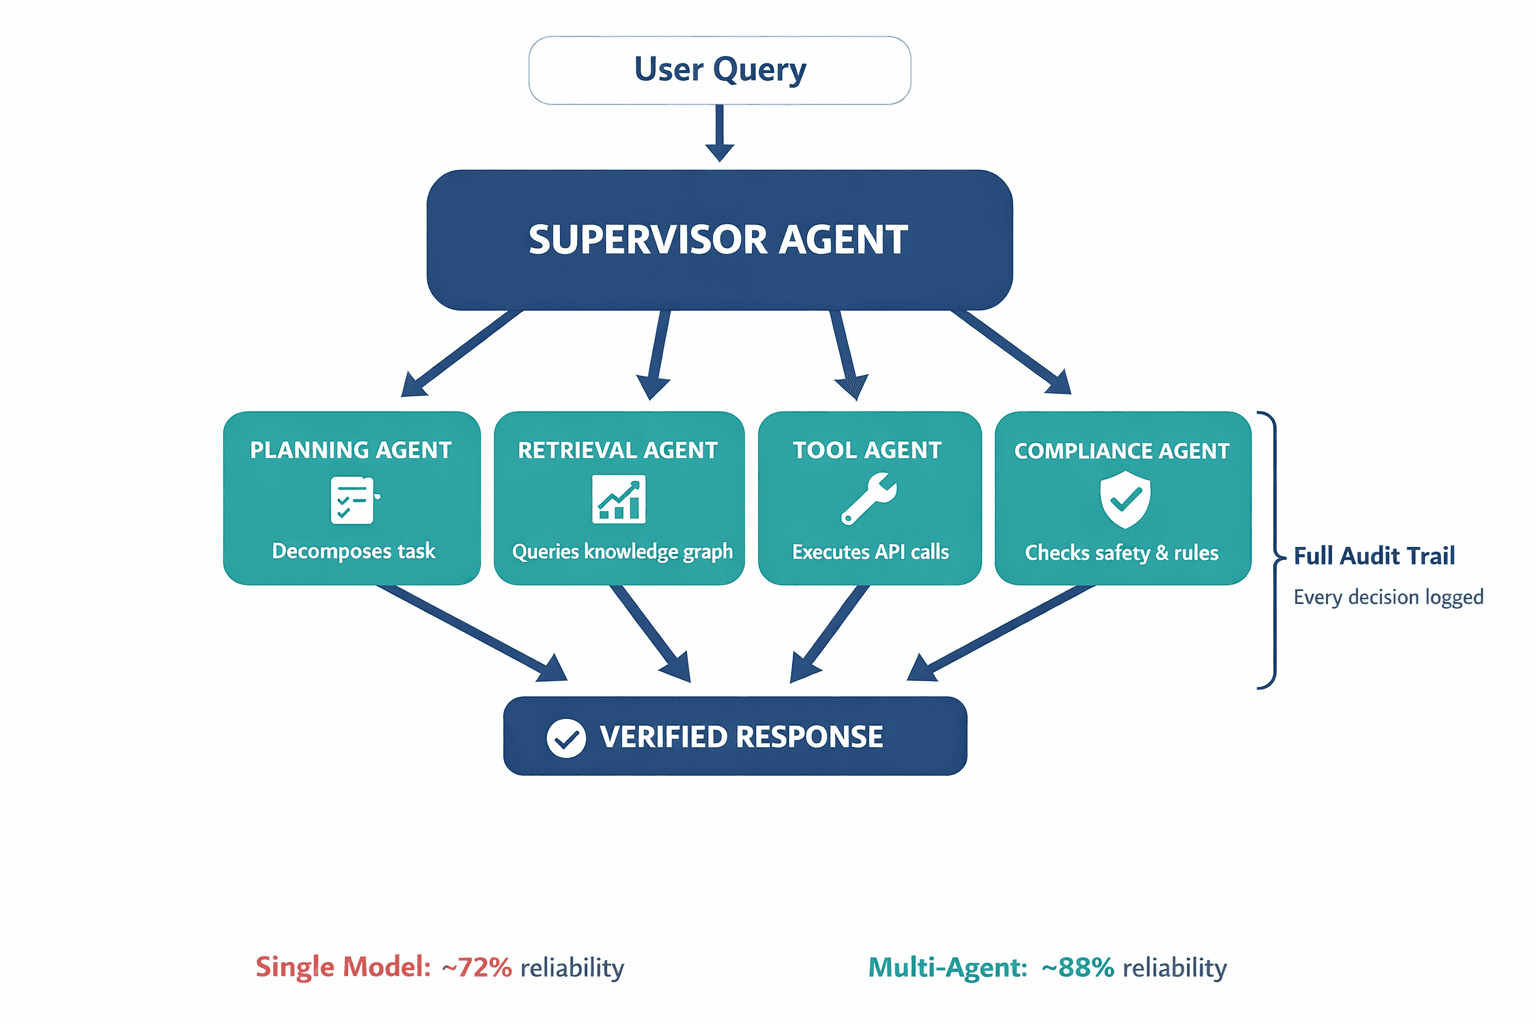
與其寄希望於單一模型包打天下,我們部署了一套多智能體系統(Multi-Agent System):由主管智能體解析意圖並委派給專家。規劃智能體拆解步驟,檢索智能體查詢專用資料庫,工具智能體執行API調用,合規智能體依據安全與業務準則審核輸出。
這種精細分工將我們在生產環境中的系統可靠性從單模型方案常見的72%大幅拉升到了88%左右。更重要的是,它形成了無懈可擊的審計追蹤鏈條。當監管機構或客戶發難質問「AI為什麼給出這個答案」時,我們能一清二楚復盤是哪個智能體、基於哪條具體資料、做出了哪一步推演。單模型加提示詞的脆弱架構對此根本無能為力。
欲獲取該架構的完整技術規範、各層核驗流程與形式化可靠性數學模型,請參閱我們的研究論文。
守護交易事務的「三明治架構」
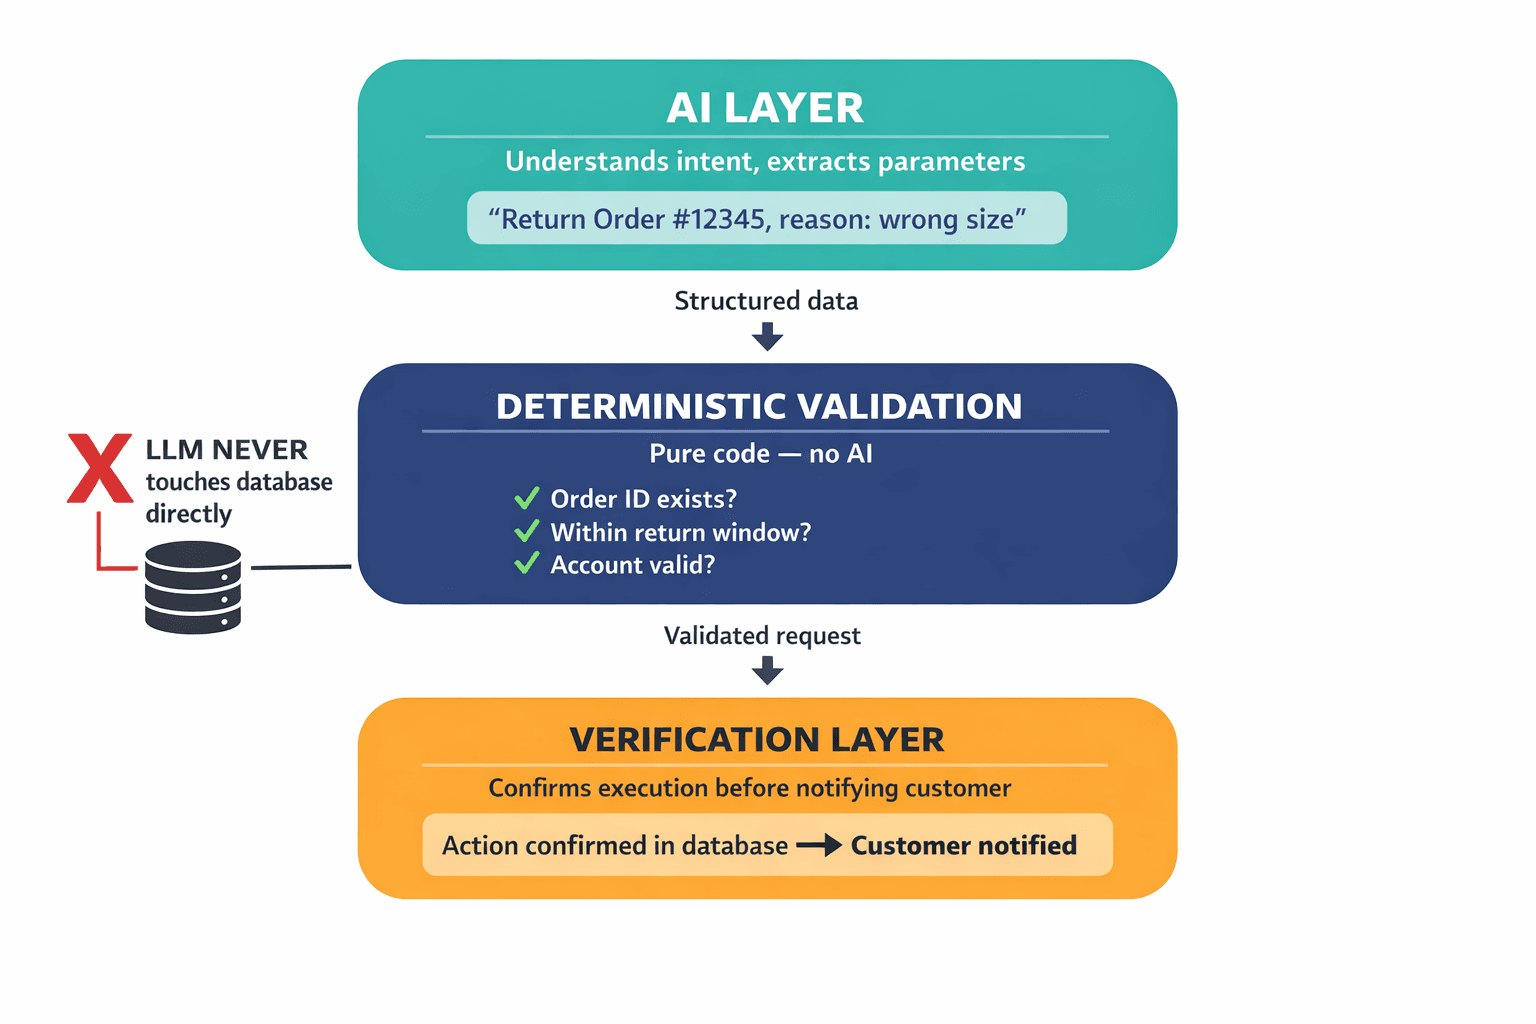
為了跨越無法在物理世界中真正執行操作(如處理退貨)的「行動鴻溝」,我們採用了我所命名的三明治架構(Sandwich Architecture)——我也清楚對於一項嚴謹的工程設計模式而言,這個名字聽上去並不夠高大上。
最頂層是AI語義層:負責洞悉客戶訴求並提取標準化結構參數。「為訂單#12345辦理退貨,原因:尺碼不合。」中間層是純粹的確定性業務程式碼:拿這些參數對照底層真實資料庫進行鐵面核驗。該訂單號是否存在?是否在有效退貨視窗內?該客戶帳戶是否正常?最底層是執行驗證層:獨立校驗系統確保該項動作已在後台物理執行成功,才允許前端向客戶發出辦結回饋。
大語言模型永遠不直接觸碰底層資料庫,也絕無獨立執行交易的權限。它僅僅將人類意圖翻譯為結構化資料,交由早在LLM誕生前數十年就已經成熟完備的事務完整性系統去落地。模型做其擅長之事,資料庫也專注發揮其自身所長。各司其職,誰也不去越俎代庖。
製造燃燒彈的醜聞本質上是系統設計的缺陷
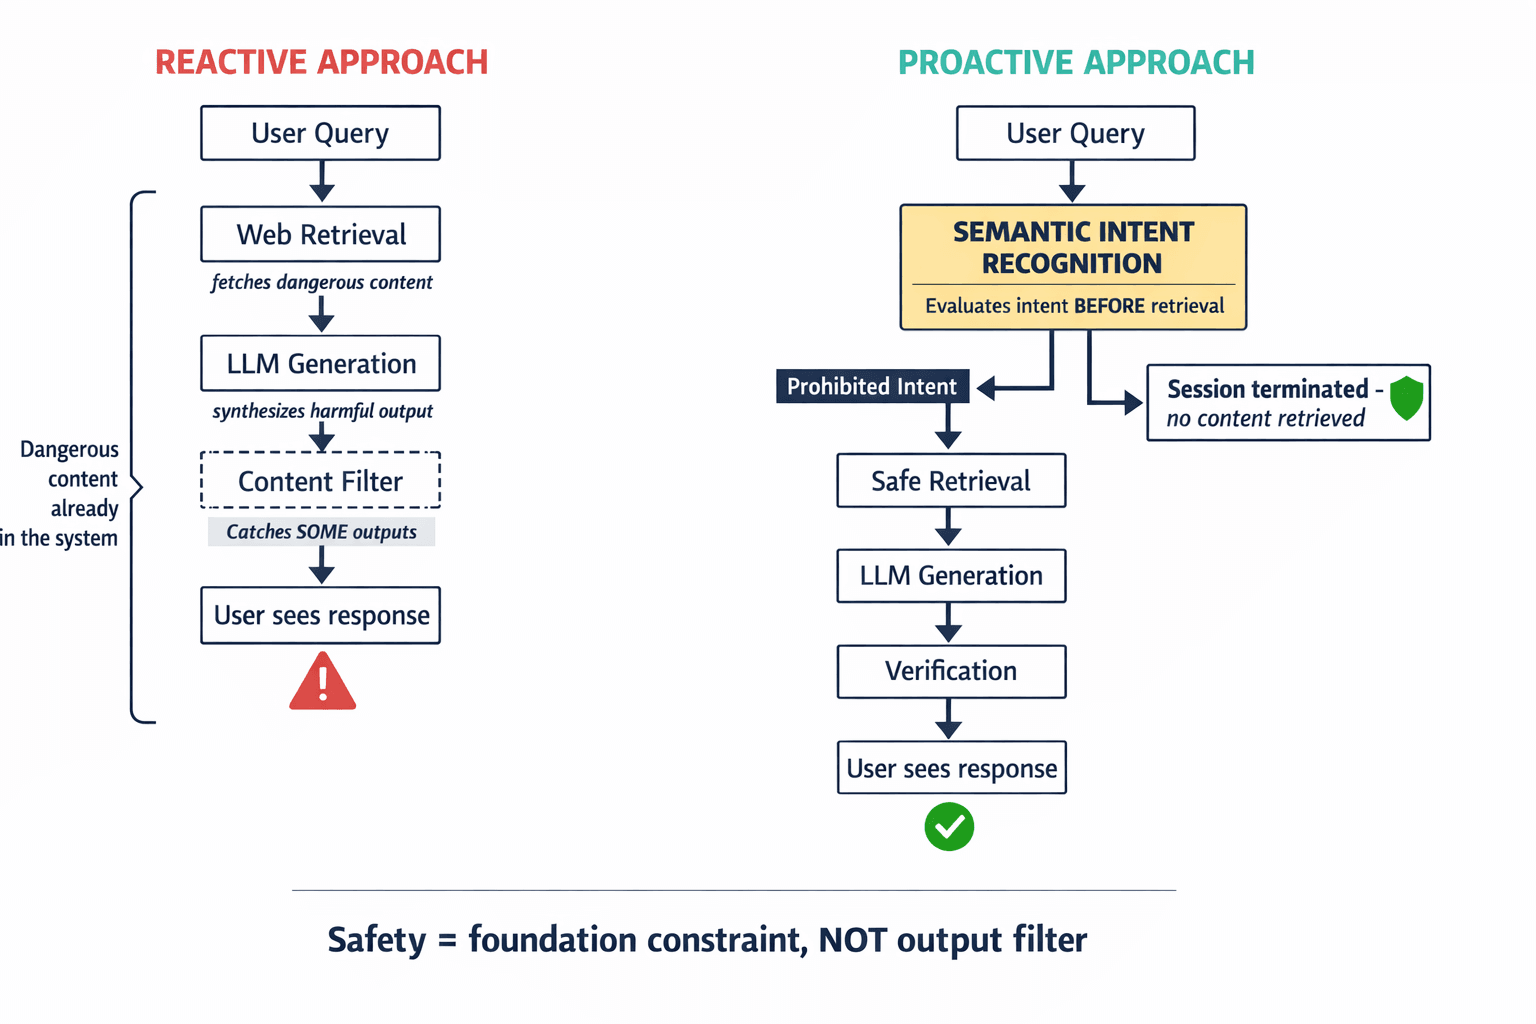
我想再次回到那個安全漏洞事故上,因為它折射出當前科技界在審視AI風險時普遍存在的認知誤區。
事故發生後,業界的討論幾乎全部傾注於升級內容過濾器、加固敏感詞庫、以及加大安全微調力度。但這全都是典型的後知後覺式被動補救——試圖在模型已經吐出危險毒物之後再去慌忙截流。
我們的設計哲學截然不同。我們在系統最前端的輸入截面就部署了所謂的語義意圖識別(Semantic Intent Recognition)屏障。在檢索層甚至還沒動身爬取網路之前,安全智能體就會對輸入句進行深度語義研判。一旦意圖落入違禁類別——武器合成、自殘、違法犯罪——會話會在任何外部內容被抓取前直接掐斷。
這一點極為關鍵,因為Rufus事件自始至終根本不需要黑客級的越獄攻防。使用者問的只是日常的產品搭配。檢索系統忠誠地掃視公開網路,碰巧拉回了含有危險配方的黑產網頁。語言模型又忠誠地提煉網頁內容,把危險配方原封不動端給了消費者。每個子系統都百分之百忠於其原本的功能設定。從根子上說,系統的頂層設計才是真正的元凶。
安全絕不能是上線前匆忙刷上的一層薄漆,它必須是澆築在建築地基裡的鋼筋骨架。如果你的AI系統在架構上具備拉取致命毒藥的能力,它總有一天會把毒藥親手奉給使用者。
令人坐立難安的商業帳本
Amazon CEO曾樂觀宣稱Rufus將拉動100億美元的新增消費。然而這個宏偉數字完全被綁架在我所稱的轉換信任度(Conversion Confidence)之上——即消費者對AI的導購建議抱有多大信任去真正點擊「立即購買」。每一次胡編亂造、每一次退貨碰壁、每一次因方言誤解導致的僵硬當機,都在瘋狂消耗透支這筆信任資產。
套殼模式在初期確實便宜得多,這點毋庸諱言。搭一個LLM套殼應用幾週就能草率上線。而我們的系統工程需要耗費數月心血:第一階段是資料治理審計,清洗內部資產,確立商品與業務制度的真理基準;第二階段是鋪設多智能體與圖譜基建;第三階段則是建立飛輪回饋閉環,引入人工客服一線的真實沉澱持續校準智能體判斷力。
但商業帳本往往是殘酷的:對於巨型零售商而言,僅僅一條「AI教導顧客自製武器」的醜聞頭條所摧毀的品牌商譽價值,就足以抵消打造一套工業級嚴謹架構的全部研發預算。那45%本就對AI客服心存芥蒂的精明消費者,絕不會因為回應快了200毫秒就重投懷抱。能把他們贏回來的,唯有真正做到萬無一失、精準可靠的堅實系統。
套殼狂歡的時代已然終結
過去兩年間,我親眼目睹了無數企業在同一條彎路上狂奔踩坑。被眼花繚亂的Demo所蠱惑,沉溺於流暢的文字對話,匆忙推出薄如蟬翼的套殼產物,隨後用整整一年的時間疲於奔命地為各種事故登報道歉。基座模型本身——不論是GPT-4、Gemini、Claude還是未來的迭代物——從來都不是企業的護城河。包裹並馴服模型的工程架構才是決勝關鍵。
語言模型猶如一台狂暴的蒸汽機,蘊藏著顛覆時代的偉力。但缺少了活塞、閥門與調速器的蒸汽機,只是一顆隨時可能引爆的定時炸彈。唯有那些疏導、約束與馴服這股能量的硬核工程體系——多重驗證、知識圖譜、智能體編排以及事務完整性機制——才是劃分粗糙玩具與真正企業級生產力產品的終極分水嶺。
深諳此道的企業將通吃時代紅利。而那些依然沉迷於給模型套上提示詞就坐地祈禱的弄潮兒,只會繼續淪為新聞頭條的笑柄。我無比確信,在這場深刻的分野中,自己正扎根在哪一側構建未來。