L'audit d'évaluation des locataires est passé au rouge. Ma réalisation était encore inachevée.

Le résultat rouge qui n'a pas répondu à suffisamment de questions
Je ne pouvais pas ignorer le $2.275 million settlement in Louis et al. v. SafeRent Solutions lorsque j'ai commencé à examiner la question d'ingénierie sous-jacente aux audits d'IA dans le domaine du logement. Un tribunal fédéral a accordé l'approbation finale du règlement en novembre 2024, sans admission d'actes répréhensibles. L'affaire a rendu un risque lisible, mais la réalisation m'a poussé vers une question opérationnelle plus difficile : une fois qu'un audit de modèle révèle une disparité, que doit exactement faire l'équipe ensuite ?
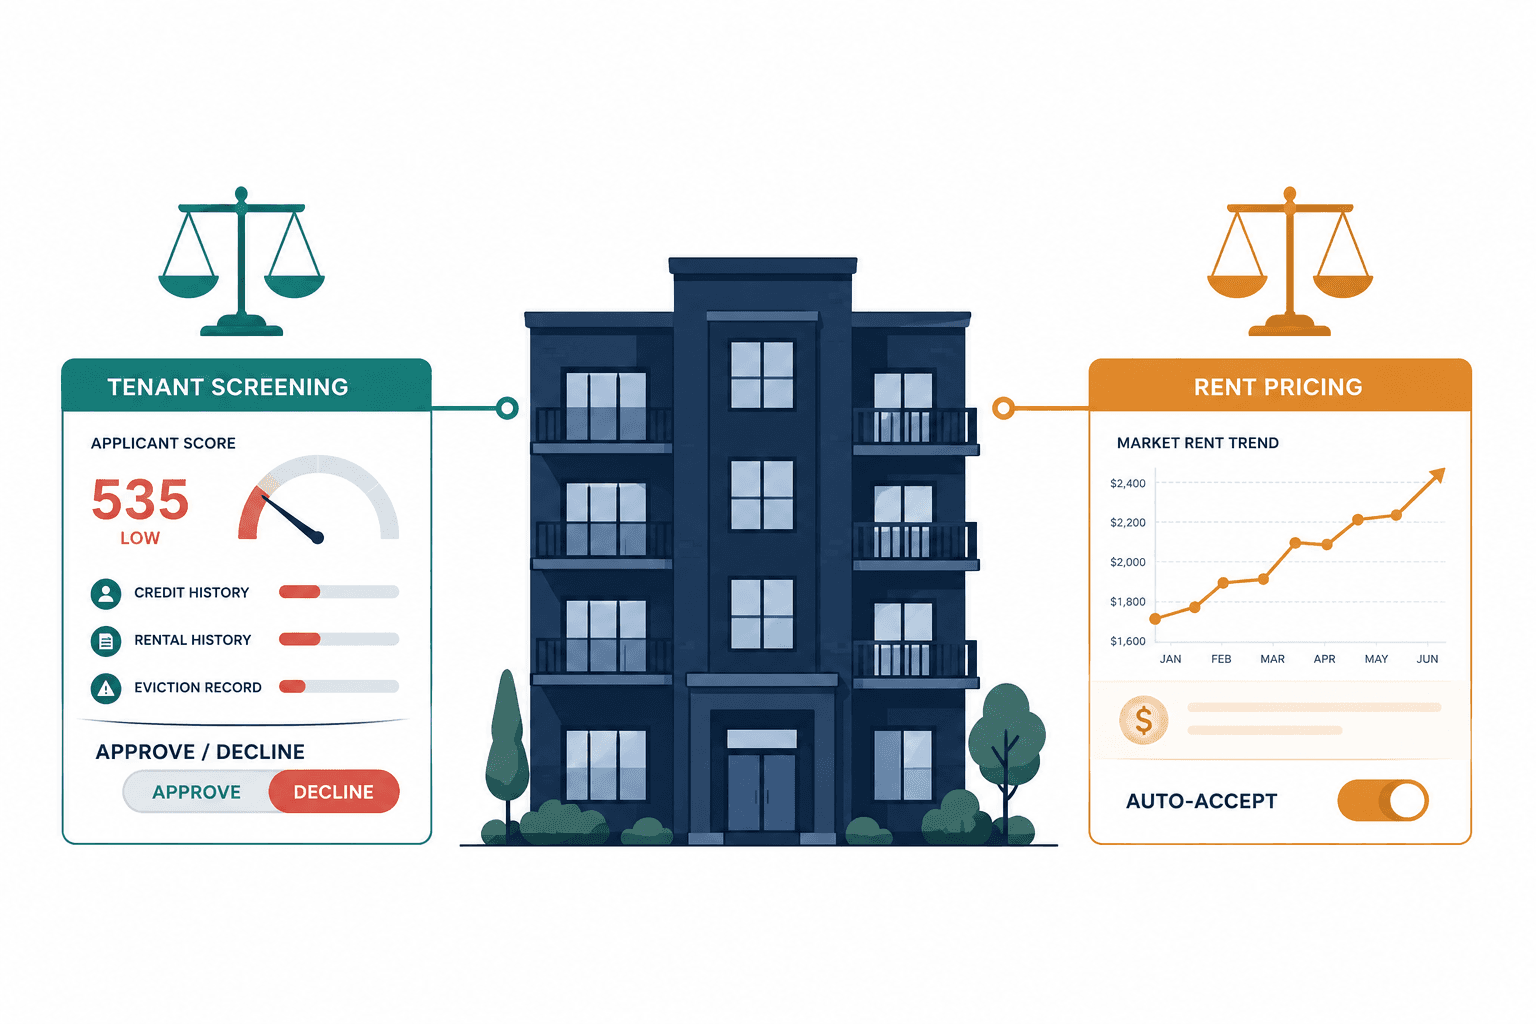
J'ai testé Equora sur un bassin de candidats synthétiques de 9 000 dossiers pour l'évaluation des locataires. ScreenScore v3, le modèle de référence axé sur le crédit dans la démonstration, a produit un AUC de 0,7823. Le ratio d'impact disparate minimal, ou DIR, s'est établi à 0,694 pour les candidats noirs. Le seuil de la règle des quatre cinquièmes configuré pour la démo est de 0,80. Ce seuil est un choix de conception pour la démonstration, pas une conclusion juridique ni un test automatique du Fair Housing Act.
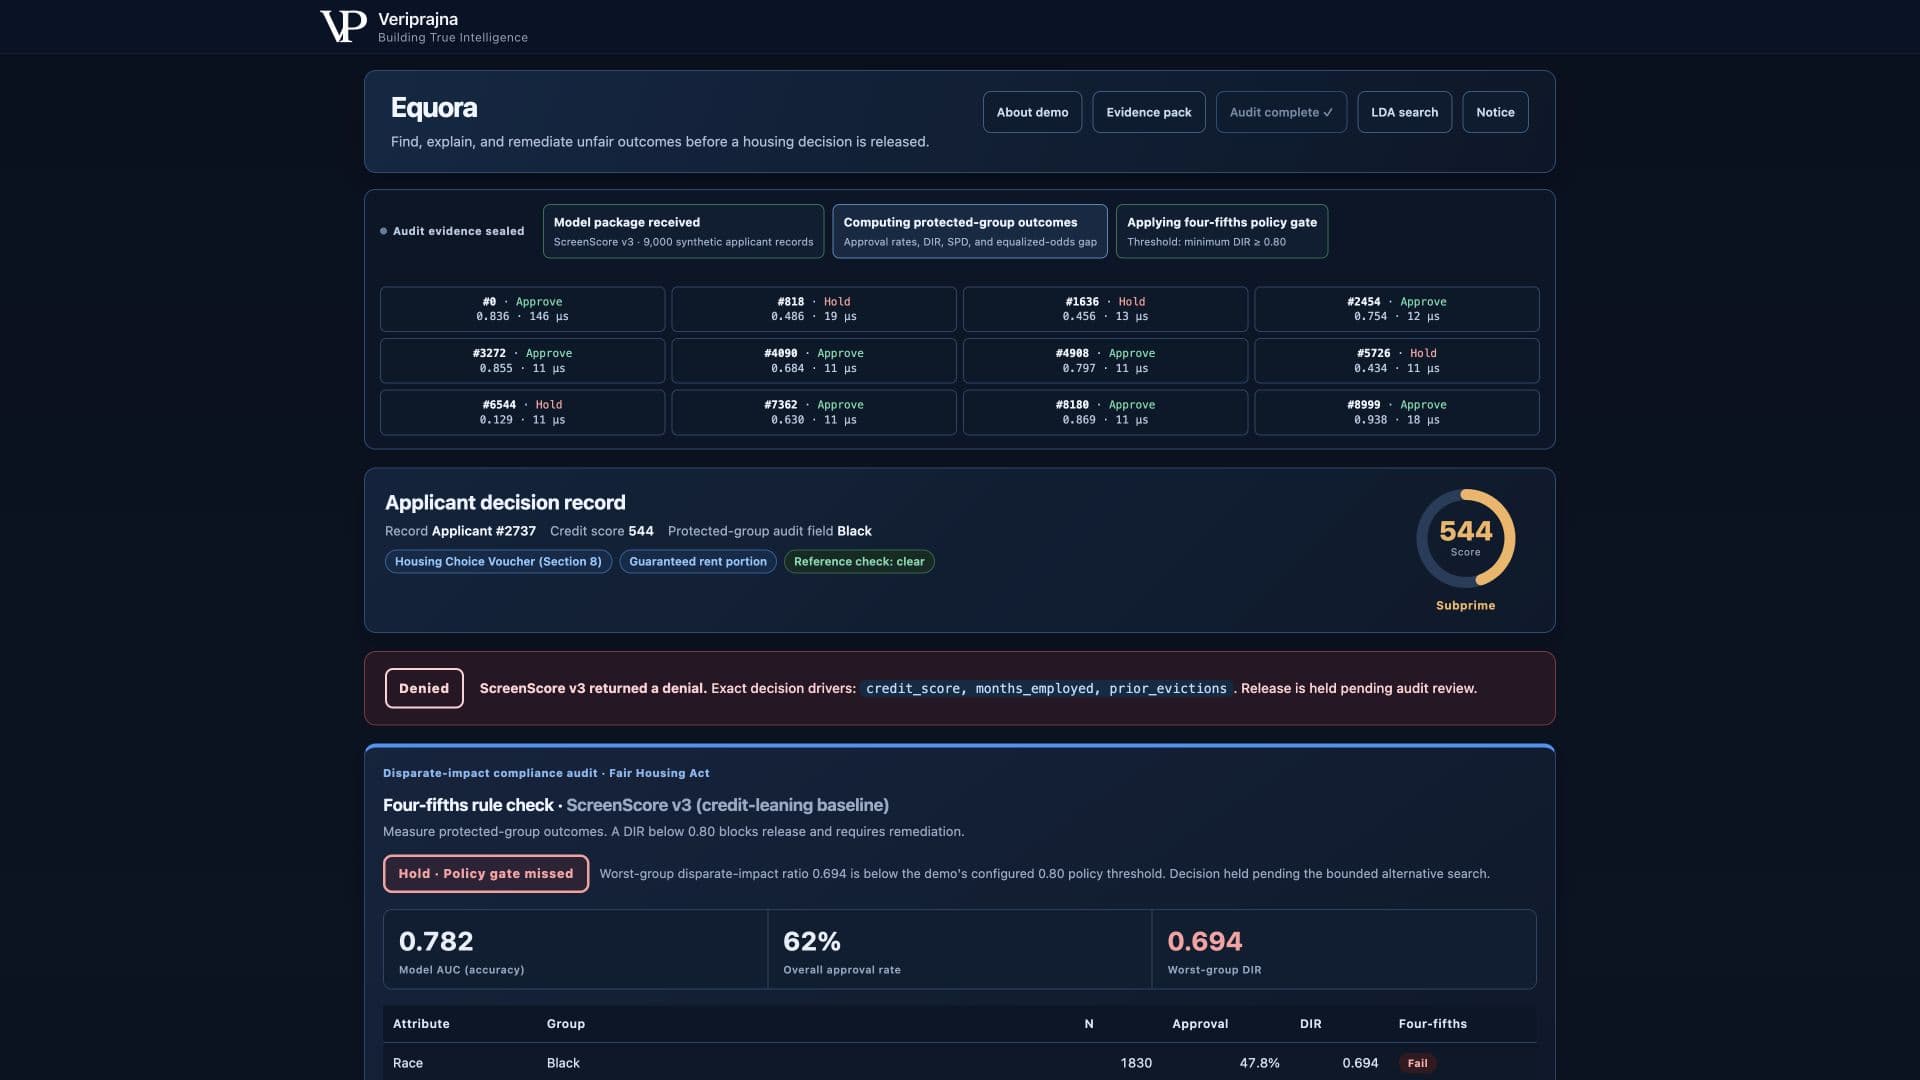
Ma première version aurait pu s'arrêter là. Elle aurait pu afficher le résultat en rouge, générer un rapport, et sembler complète lors d'une réunion de révision. Au lieu de cela, j'avais le sentiment d'avoir construit une meilleure alarme sans plan de réponse. La métrique pouvait indiquer à l'équipe où le modèle de référence avait échoué à son seuil configuré. Elle ne pouvait pas montrer si une alternative moins discriminatoire existait, quelle utilité cette alternative sacrifierait, ni comment quiconque pourrait reproduire le choix ultérieurement.
La présentation initiale reste utile sur l'analyse de conformité de l'IA dans le logement d'Equora, mais la réalisation n'est devenue vraiment intéressante que lorsque l'audit rouge est devenu la ligne de départ.
Ce que la métrique a laissé sans réponse
Je revenais constamment au même espace vide sous le tableau d'audit : quel changement défendrais-je, et sur la base de quelles preuves ? Il existe des moyens faciles de faire bouger un indicateur d'équité. Modifier le seuil d'approbation. Supprimer une variable. Ajouter une variable. Modifier la régularisation. Le score bouge, mais un mouvement sans espace de recherche défini et sans règle de sélection stable est difficile à gouverner.
J'ai essayé d'aborder le problème comme une modification unique du modèle. Cela a rapidement échoué. Si j'avais plafonné l'influence du score de crédit et que le résultat s'améliorait, je n'avais toujours aucune raison de croire que ce plafond était préférable à un autre. Si j'avais crédité un revenu garanti sur bon d'achat, j'avais quand même besoin de voir son coût en termes d'utilité au même taux de sélection. Chaque modification isolée créait une nouvelle question sur les alternatives que je n'avais pas évaluées.
J'ai noté ces questions à côté du résultat et j'ai réalisé que mon prototype n'avait pas de réponse stable à l'une d'entre elles. Un deuxième essai pourrait refléter une intuition différente. Un troisième pourrait modifier l'ensemble de comparaison sans documenter le changement. Même si chaque choix était sensé de façon isolée, la séquence serait difficile à reconstituer. C'était l'expérience échouée : J'avais traité la remédiation comme une série de choix d'ajustement du modèle alors qu'elle devait être une procédure de recherche déclarée. La distinction semble subtile jusqu'à ce que quelqu'un demande pourquoi un candidat acceptable a été sélectionné plutôt qu'un autre.
La solution consistait à faire de la recherche elle-même un artefact. Equora évalue 480 configurations explicites et neutres en apparence à sélectivité égale. La grille fait varier des sous-ensembles de quatre variables optionnelles à haut risque, des plafonds de score de crédit sans plafond, 720, 680 ou 640, si le revenu garanti sur bon d'achat est crédité, et six valeurs L2 de 0,1 à 30,0. Le ratio dette-revenu, les mois d'emploi et le revenu déclaré restent inclus.
Cette limite est importante car je peux la décrire. Je peux la réexécuter. Je peux également dire ce qu'elle ne couvre pas. La recherche ne prétend pas couvrir tous les modèles, toutes les politiques ou toutes les transformations de variables possibles. C'est une démonstration d'ingénierie bornée avec une grille connue et un budget de précision déclaré.
Une métrique rouge enregistre le problème. Une recherche gouvernée enregistre la réponse disponible.
Je devais rendre la recherche inspectable
Je me souviens d'avoir atteint l'étape où la recherche fonctionnait correctement mais semblait encore opaque. Une recommandation apparaissait à la fin, pourtant le chemin qui y menait était largement dissimulé dans le code. Ce résultat était mathématiquement défendable et opérationnellement faible. Un conseiller juridique ou un évaluateur du risque de modèle ne devrait pas avoir à faire confiance à ma mémoire des combinaisons testées.
J'ai déplacé l'espace de recherche dans l'interface et rendu la progression visible. Le système teste chaque configuration par rapport au même jeu de données synthétiques fixes et à la même contrainte de sélectivité. Il enregistre l'AUC et le DIR minimal du candidat, puis trace la frontière de Pareto précision/équité. Si aucun candidat ne franchit le seuil configuré dans le budget AUC de 0,03, le moteur ne renvoie aucune alternative sûre au lieu de fabriquer une recommandation.
Je voulais qu'un évaluateur puisse poser des questions concrètes. Les plafonds de crédit ont-ils été évalués ? Le revenu garanti a-t-il été crédité ? Chaque candidat a-t-il maintenu une sélectivité constante ? Combien de candidats ont été qualifiés selon la règle configurée ? Ces questions trouvent une réponse dans le dossier. La procédure de décision reste en dehors du modèle de langage : un code déterministe calcule les métriques, applique le seuil et sélectionne le candidat qualifié ayant la plus faible perte d'AUC mesurée.
Je devais également résister à la tentation d'effacer les candidats non retenus. Un écran produit veut naturellement mettre en avant une seule réponse, mais les autres points testés donnent du contexte à la recommandation. La frontière permet à un évaluateur de comparer l'AUC et le DIR minimal sur l'ensemble des configurations évaluées, plutôt que de ne voir que la coordonnée sélectionnée. Les candidats éliminés font partie des preuves, car ils montrent ce que la règle de sélection a comparé avant de retenir le résultat qualifié.
C'est à ce moment que mon propre cadrage a changé. J'avais commencé avec un tableau de bord d'équité en tête. Ce que je construisais réellement était un processus de décision reproductible. Le graphique était utile parce que chaque point représentait une configuration testée, pas parce qu'une frontière est visuellement convaincante.
Le compromis que je pouvais enfin voir
J'ai regardé l'exécution complète évaluer toutes les 480 configurations et retourner 240 qui ont franchi le seuil de 0,80 de la démo dans le cadre de son budget de précision configuré. La configuration recommandée a conservé les variables de référence, ajouté le crédit de revenu garanti, plafonné l'influence du score de crédit à 640 et utilisé une régularisation L2 de 10,0.
Je pouvais alors lire le résultat comme un compromis plutôt que comme une affirmation de perfection. Sur ce jeu de données synthétiques fixes, le DIR minimal est passé de 0,694 à 0,875. L'AUC est passé de 0,7823 à 0,7788, une perte mesurée de 0,0036 que l'interface affiche comme 0,36 %. Pour l'intersection des détenteurs de bons d'achat noirs dans le jeu de données, le DIR est passé de 0,701 à 1,029.
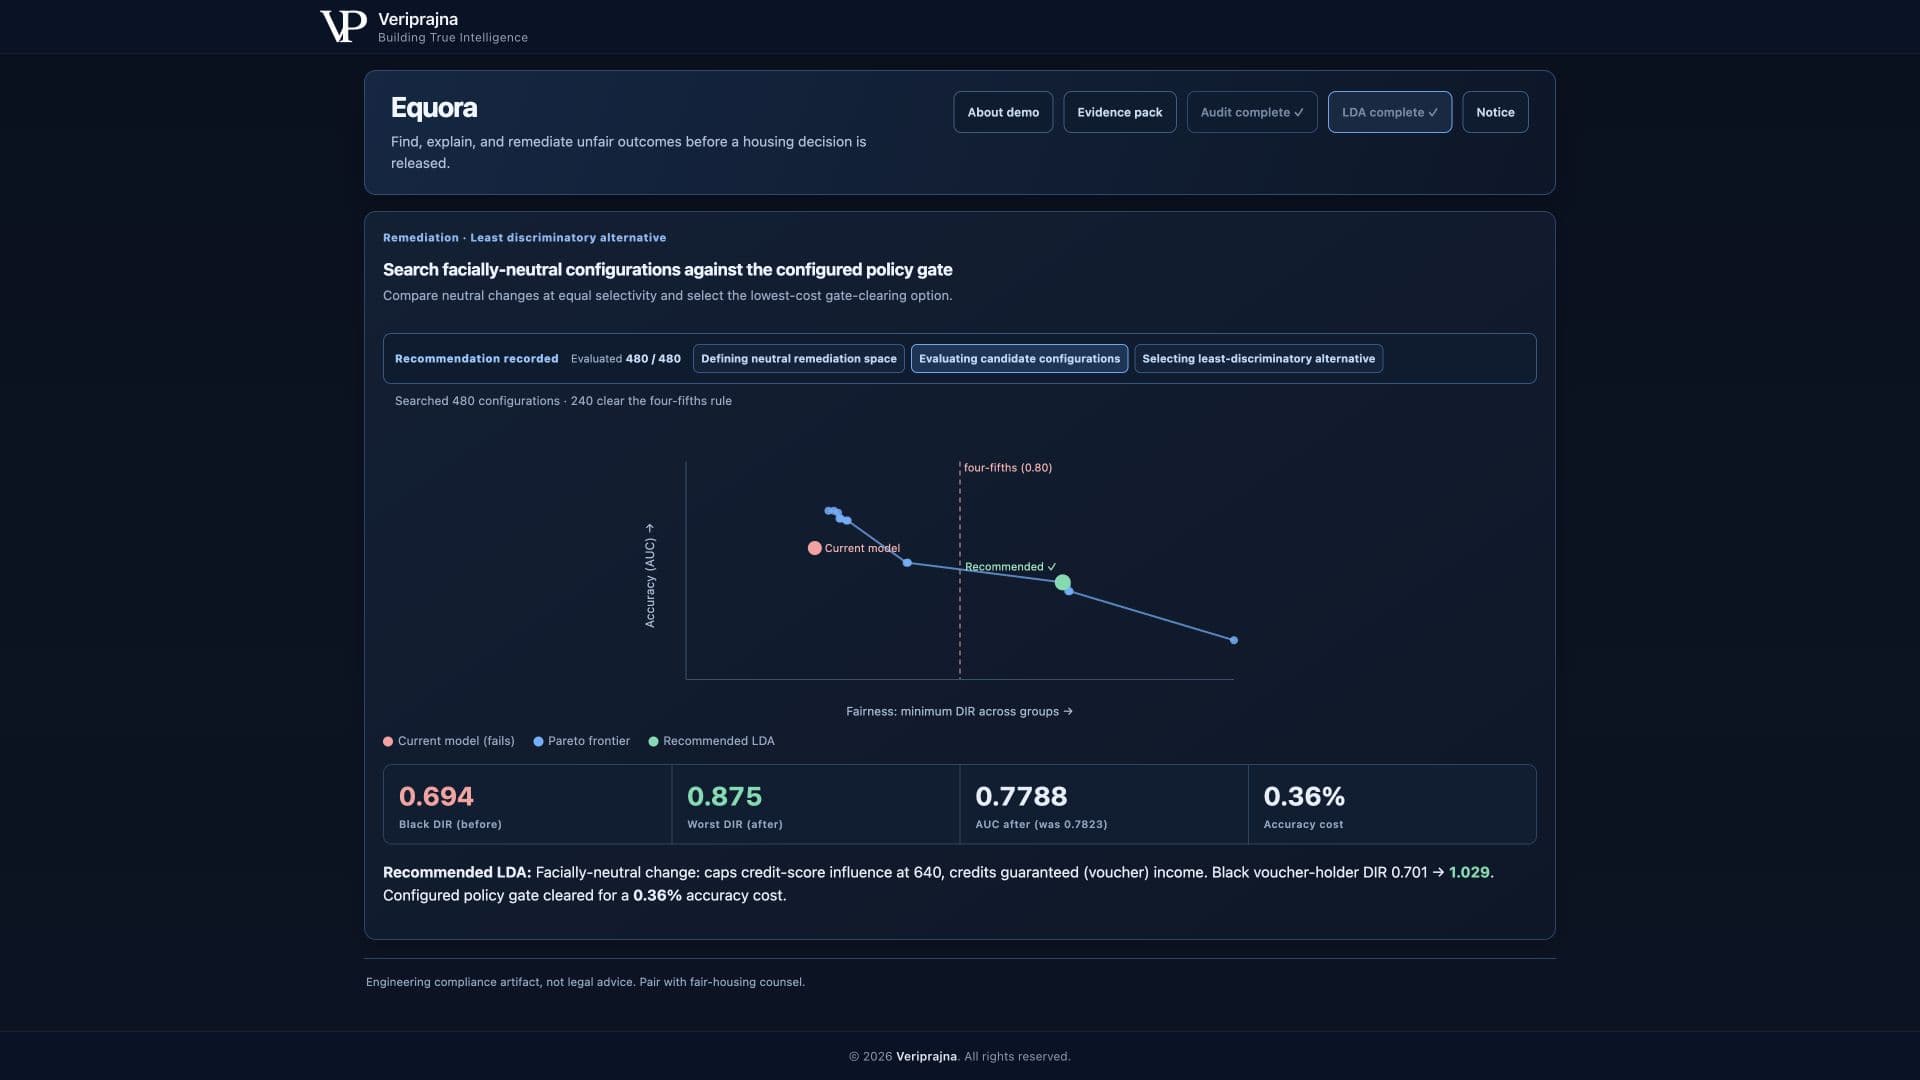
Je suis prudent avec le mot recommandé. Ce candidat est l'option dont le coût en AUC mesuré est le plus faible et qui est qualifiée dans cette grille spécifique. Ce n'est ni un optimum universel, ni une certification juridique, ni la preuve d'un modèle sans biais. Les chiffres décrivent un modèle de référence ajusté et une recherche bornée sur des données synthétiques. Ils ne décrivent pas un vrai propriétaire, un prestataire d'évaluation, un bassin de candidats ou un marché immobilier.
J'ai trouvé cette phrase plus difficile à rédiger que le chiffre d'amélioration. Le langage produit récompense la certitude, tandis que le travail de gouvernance dépend du maintien de la portée. L'affirmation bornée est précisément plus solide parce qu'un autre évaluateur peut voir où elle s'arrête. Si l'organisation élargit la grille, modifie le budget ou adopte un seuil de politique différent, elle devrait s'attendre à un dossier différent et peut-être à une recommandation différente. La méthode reste reproductible même lorsque les hypothèses changent.
Cette limitation n'affaiblit pas la démonstration. Elle rend la limite d'examen explicite. Un évaluateur peut contester le budget de 0,03, le seuil de la règle des quatre cinquièmes, les variables disponibles, la contrainte de sélectivité ou la grille elle-même. Ces désaccords deviennent des entrées d'un processus qui peut être réexécuté, plutôt que des commentaires attachés à un score rouge statique.
Pourquoi j'ai conservé les preuves en dehors de la prose
J'étais tenté de laisser le texte généré porter davantage l'explication parce que la prose donne l'impression qu'une interface est terminée. Je m'en suis écarté. Un paragraphe fluide ne peut pas établir quelles configurations ont été testées, calculer le DIR, ni décider si un candidat passe un seuil. Ce sont des affirmations computationnelles, et je voulais que le dossier survive même si chaque phrase générée était supprimée.
J'ai séparé les rôles. Un code déterministe calcule l'audit, recherche les alternatives, applique le seuil configuré et préserve le résultat. Un modèle de langage, lorsqu'il est activé, se limite à la rédaction de texte. Le mode hors ligne utilise un modèle déterministe. Les preuves ne dépendent pas de la formulation.
J'ai appliqué la même limite à une justification destinée au candidat. Pour un dossier synthétique refusé, l'attribution exacte des variables du modèle linéaire identifie les trois principaux facteurs négatifs. Le rédacteur de l'avis doit citer ces variables. Un avis de recours fondé réussit cette vérification restreinte, tandis qu'un code de motif générique qui ne cite aucune variable échoue et est orienté vers un examen humain. Le critique vérifie uniquement le fondement des variables. Il n'établit pas la pleine conformité au FCRA ni la suffisance juridique.
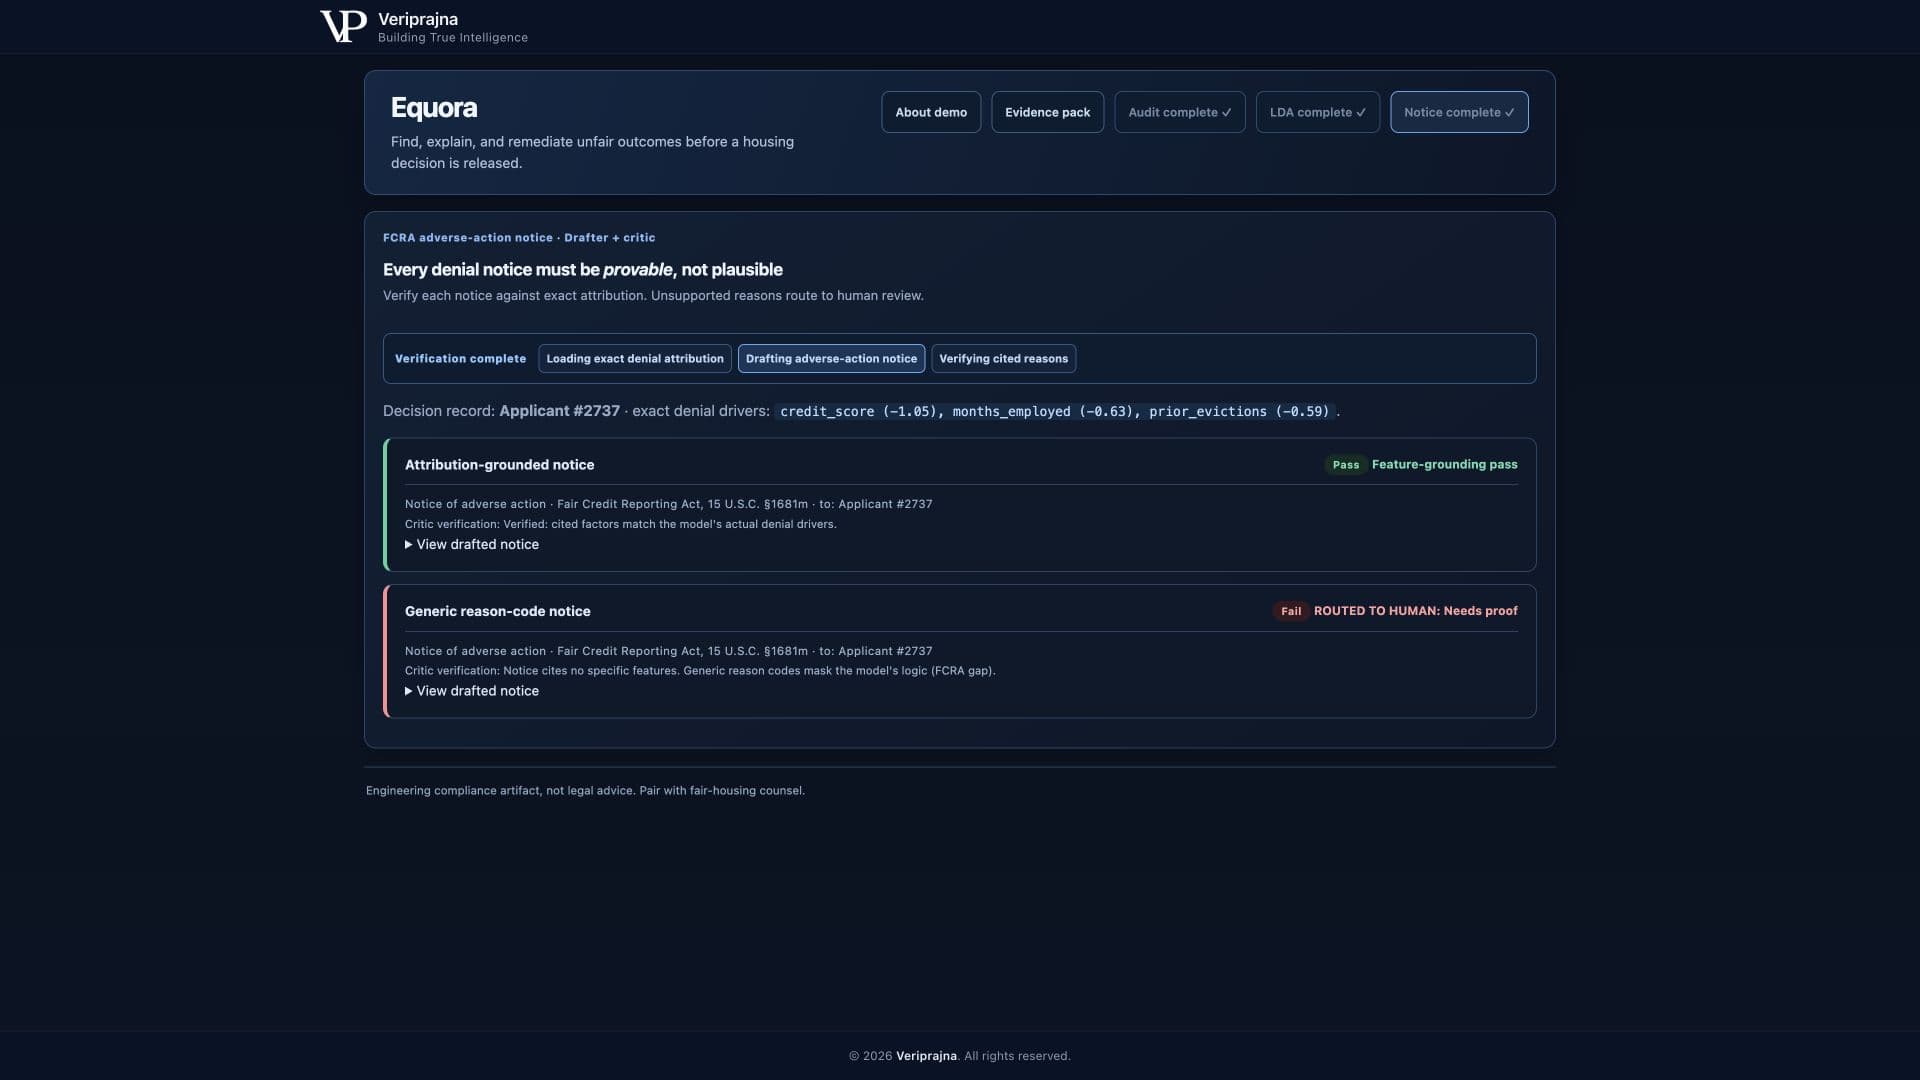
Cela est adjacent à la recherche plutôt qu'une seconde thèse. Une fois qu'une équipe choisit une alternative, les preuves doivent toujours être intégrées dans le dossier de décision et dans toute explication qui en est extraite. Une recherche reproductible perd sa valeur de gouvernance si le dernier kilomètre peut inventer une raison.
L'artefact que je voudrais avoir en salle de réunion
Je visualise désormais la réunion de révision différemment. Je n'imagine pas quelqu'un présentant un score rouge et demandant à l'assemblée d'accepter une promesse générale d'améliorer le modèle. J'imagine un évaluateur ouvrant la grille bornée, voyant chaque candidat à sélectivité égale, vérifiant la frontière de Pareto et remontant le résultat sélectionné jusqu'à la règle configurée.
Je voudrais que le dossier montre à la fois le gain et le coût. Ici, cela signifie un DIR minimal de 0,875 et un AUC de 0,7788 après la recherche, avec les valeurs de référence à côté. Je voudrais également que le système conserve les alternatives qu'il a rejetées et qu'il retourne aucune alternative sûre lorsque aucune n'est qualifiée. Une recommandation forcée effacerait le résultat le plus important possible.
La présentation complète est disponible sur l'analyse de conformité de l'IA dans le logement d'Equora. Elle montre l'audit, la recherche d'Alternative la Moins Discriminatoire bornée, la vue des compromis et le transfert des preuves. Elle reste une démonstration d'ingénierie construite sur des données synthétiques, pas un système de prise de décision en production ni un conseil juridique.
Et si vous préférez voir le flux de travail plutôt que me lire le décrire, voici la présentation du fondateur de bout en bout.
J'ai commencé avec une métrique rouge parce que c'était la chose évidente à afficher. J'ai fini convaincu que l'artefact le plus précieux est le chemin reproductible du résultat rouge vers un choix borné, y compris la possibilité que le chemin se termine sans aucun choix qualifié. Un audit peut dire à une équipe de s'arrêter. Un dossier de recherche peut montrer ce qu'elle a examiné avant de décider comment procéder.