テナントスクリーニング監査は赤を示した。しかし私の構築はまだ未完成だった。

不十分な回答しか返さなかった赤い結果
私は見過ごすことができなかった $2.275 million settlement in Louis et al. v. SafeRent Solutions。住宅AIの監査に潜むエンジニアリング上の問いを追い始めたとき、この訴訟が目に入った。連邦裁判所は2024年11月に和解を最終承認したが、不正行為の認定はなかった。この訴訟は一つのリスクを可視化した。だが構築を進めるうちに、より厳しい運用上の問いに向き合わざるを得なくなった。モデル監査で格差が明らかになった後、チームは次に何をすべきか?
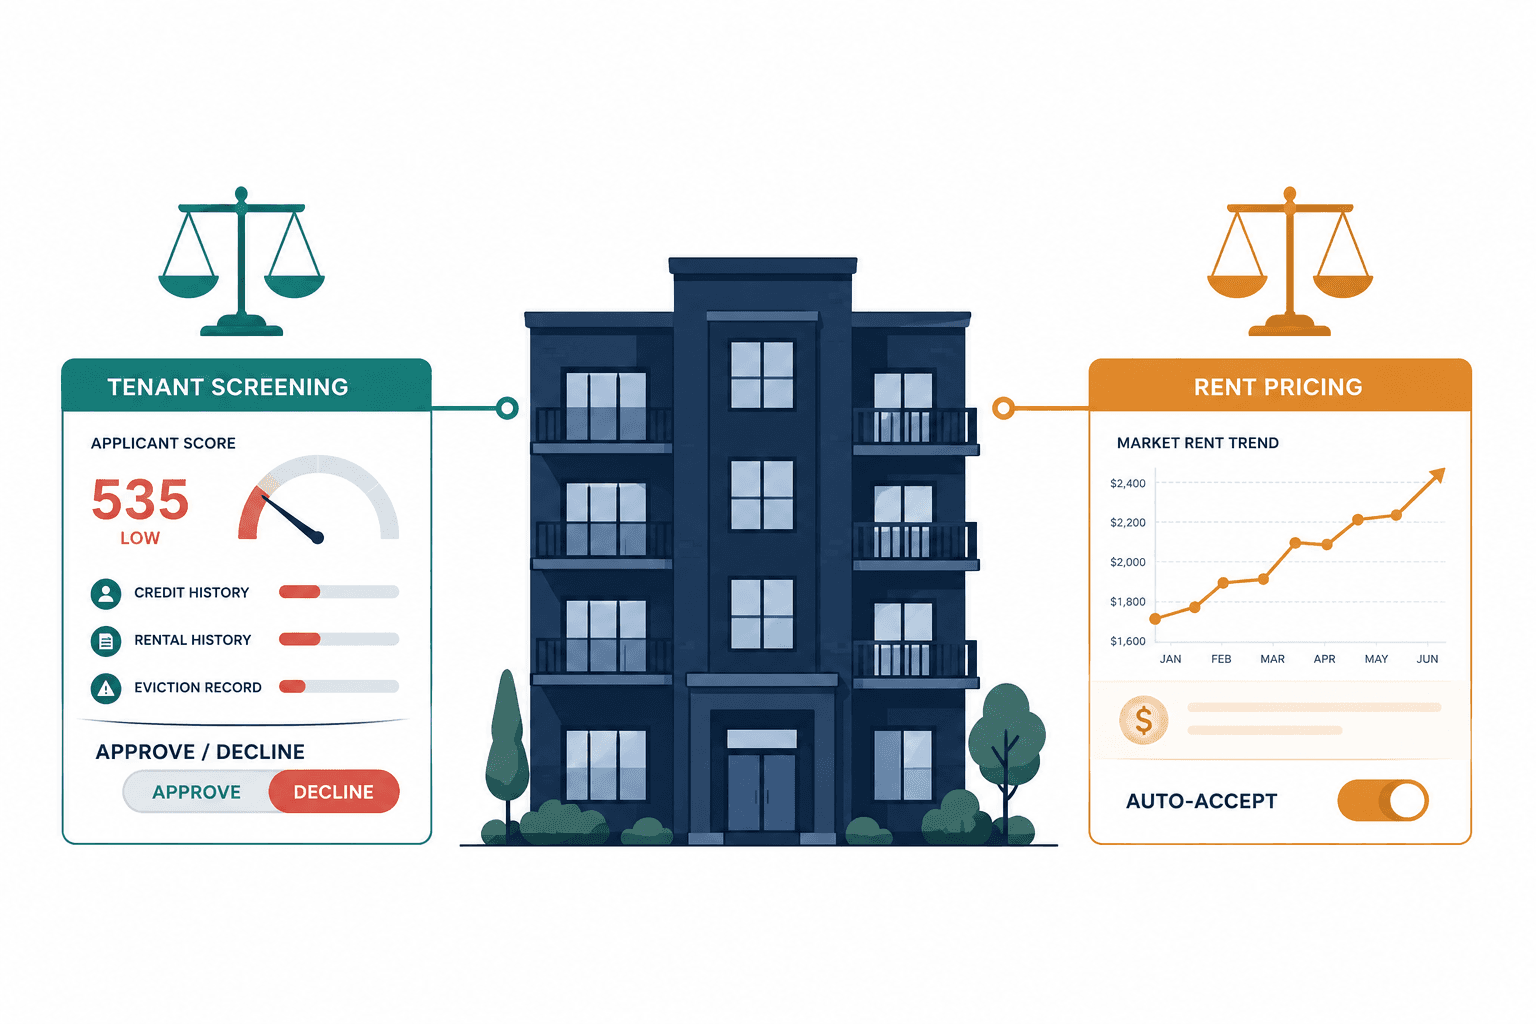
私はEquoraを固定された 9,000件の合成テナントスクリーニング申請者プールに対して実行した。クレジットスコアを重視するベースラインであるScreenScore v3のAUCは0.7823だった。格差影響比(DIR)の最小値は、Black申請者で0.694となった。このデモで設定された4/5ルールのポリシーゲートは0.80だ。この閾値はデモのための設計上の選択であり、法的結論でも公正住宅法(Fair Housing Act)の自動テストでもない。
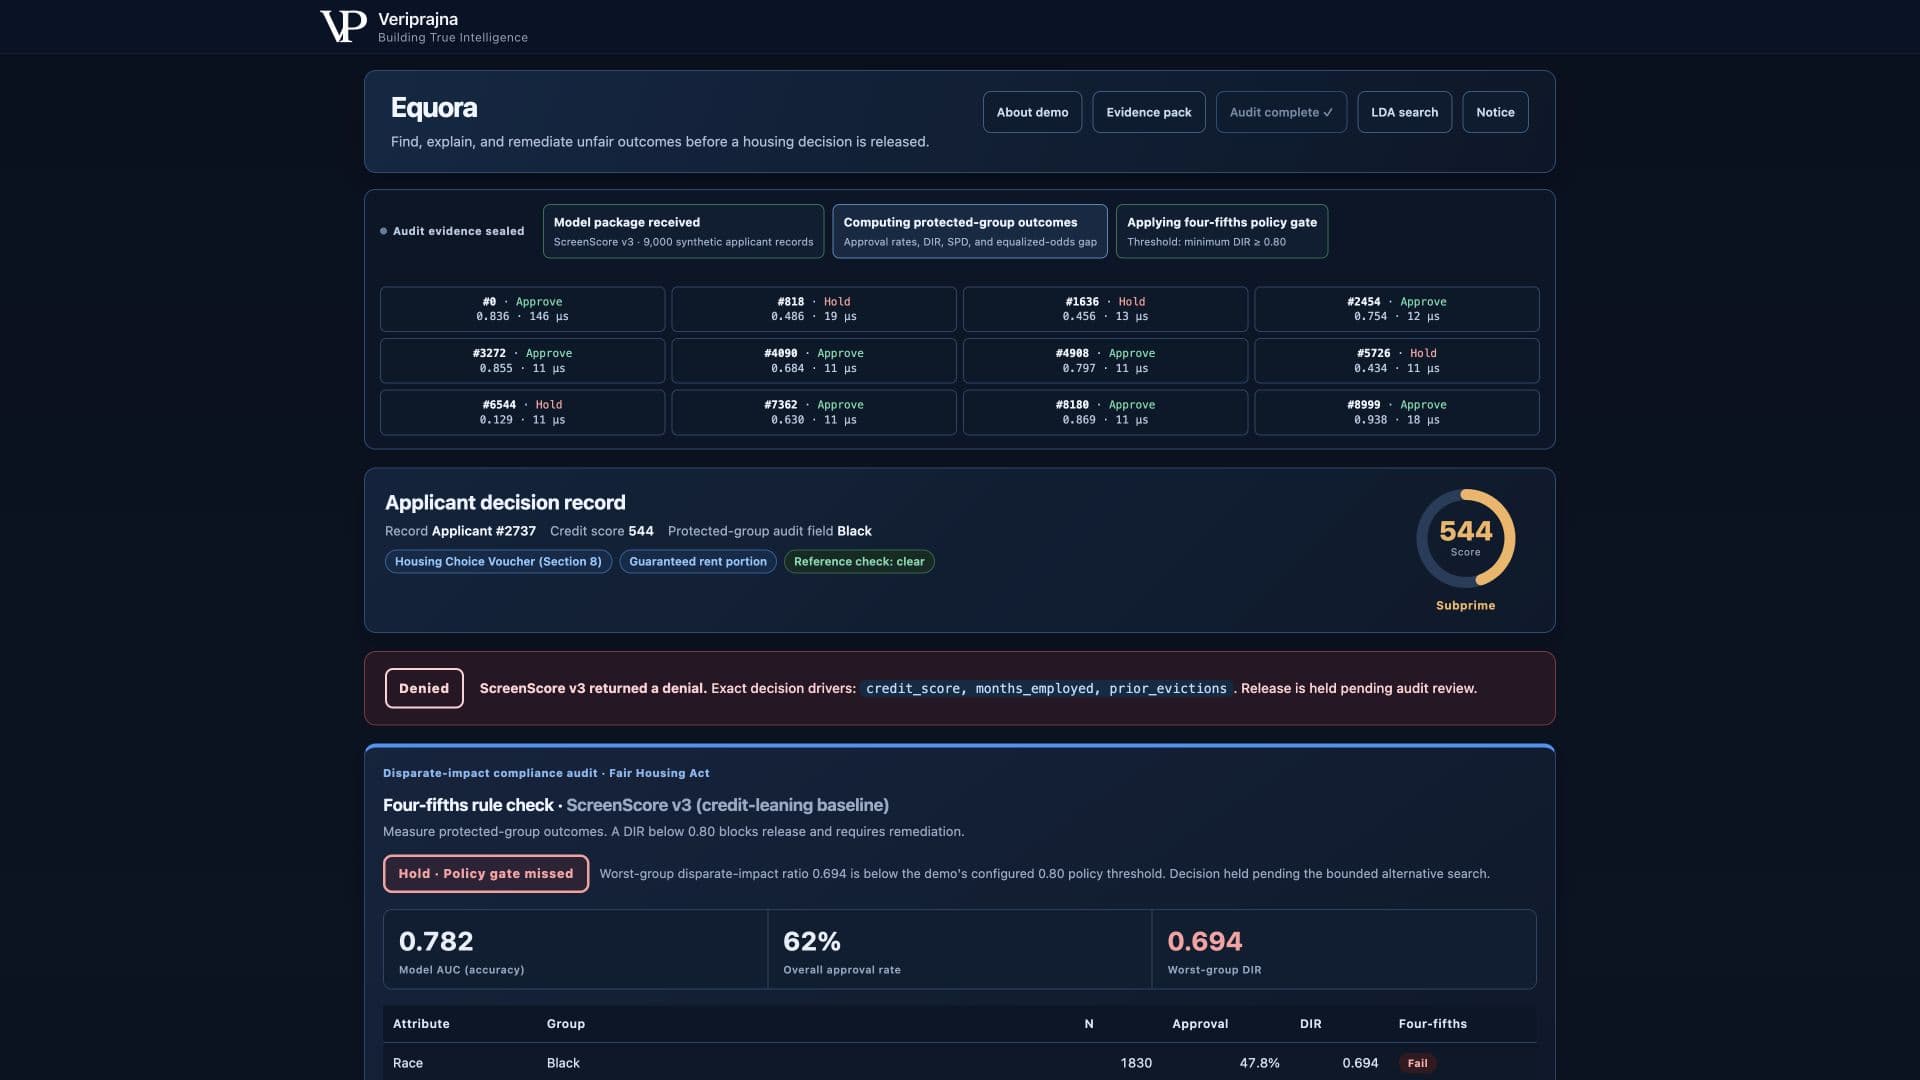
私の最初のバージョンはそこで止まることができた。結果を赤く表示し、レポートを生成し、レビュー会議では完結して見えただろう。しかし私は、自分が 対応計画のない優れたアラームを作ってしまったと感じた。この指標は、ベースラインが設定されたゲートでどこに失敗したかをチームに示すことができた。しかし、格差の少ない代替案が存在するかどうか、その代替案がどれだけのユーティリティを犠牲にするか、あるいは後からその選択を再現できるかどうかは示せなかった。
初期のウォークスルーは今も the Equora housing AI compliance breakdownで役に立つが、赤い監査が出発点になったときに初めて、この構築は興味深いものになった。
指標が未回答のまま残したもの
私は何度も監査テーブルの下の同じ空白に立ち戻った: どの変更を私は弁明できるか、そしてどんな証拠に基づいて?公平性の数値を動かす簡単な方法はある。承認閾値を変える。特徴量を削除する。特徴量を追加する。正則化を変更する。スコアは動くが、定義された探索空間と安定した選択ルールなしの変化は、ガバナンスするのが難しい。
私はこの問題を単一のモデル編集として考えようとした。それはすぐに失敗した。クレジットスコアの影響に上限を設けて結果が改善したとしても、その上限が別のものより望ましいと信じる理由はまだなかった。保証バウチャー収入をクレジットしても、同じ選択率でのユーティリティコストを確認する必要があった。個々の変更がそれぞれ、評価していない代替案についての新たな問いを生んだ。
それらの問いを結果の横に書き出すと、自分のプロトタイプにはどれに対しても安定した答えがないことに気づいた。2回目の実行は別の直感を反映するかもしれない。3回目は変更を文書化せずに比較セットを変えるかもしれない。個々の選択がそれぞれ合理的だとしても、その連鎖を再構成するのは難しいだろう。 それが失敗した実験だった:修復作業を宣言された探索手順として扱う必要があったのに、一連のモデルチューニングの選択として扱っていたのだ。この区別は、なぜある許容可能な候補が別の候補よりも選ばれたのかと誰かが問うまでは微妙に聞こえる。
解決策は、探索自体をアーティファクトにすることだった。Equoraは 等しい選択率で480件の明示的かつ表面上中立な構成を評価する。グリッドは、4つのオプションの高リスク特徴量のサブセット、上限なし・720・680・640のクレジットスコア上限、保証バウチャー収入のクレジット有無、0.1から30.0までの6つのL2値を変化させる。負債対収入比(DTI)、雇用月数、申告収入は含まれたまま維持される。
その境界が重要なのは、私が説明できるからだ。再実行もできる。また、それがカバーしていないことも言える。この探索は、あらゆる可能なモデル、ポリシー、特徴量変換を網羅すると主張しない。既知のグリッドと宣言された精度予算を持つ、有界なエンジニアリングデモンストレーションである。
赤い指標は問題を記録する。ガバナンスされた探索は、利用可能な対応を記録する。
探索をインスペクタブルにしなければならなかった
探索が正しく動作したが、依然として不透明に感じられた段階に達したことを覚えている。最終的に推奨が現れたが、そこへの道筋はコードの中に大部分隠されていた。その出力は数学的に擁護可能だったが、運用上は脆弱だった。法律顧問やモデルリスクレビュアーが、どの組み合わせがテストされたかについての私の記憶を信頼しなければならないべきではなかった。
私は探索空間をインターフェースに移し、進捗を可視化した。システムは各構成を同じ固定合成フィクスチャと同じ選択率制約に対してテストする。候補のAUCと最小DIRを記録し、その後 精度/公平性パレートフロンティアをプロットする。設定されたゲートを0.03のAUC予算内でクリアする候補がない場合、エンジンは推奨を作り出す代わりに安全な代替案なしを返す。
私はレビュアーが具体的な質問をできるようにしたかった。クレジット上限は評価されたか?保証収入はクレジットされたか?すべての候補で選択率は一定に保たれたか?設定されたルールの下でいくつの候補が適格となったか?これらはレコードから答えられる。 意思決定手順は言語モデルの外に留まる:決定論的コードが指標を計算し、ゲートを適用し、測定されたAUC損失が最小の適格候補を選択する。
私はまた、不合格候補を洗練して消し去ることへの誘惑にも抵抗しなければならなかった。製品画面は自然と一つの答えを前景に出したがるが、他のテスト済みポイントが推奨に文脈を与える。フロンティアにより、レビュアーは選択された座標だけを見る代わりに、評価された構成全体でAUCと最小DIRを比較できる。 負けた候補は証拠の一部だ。なぜなら、選択ルールが適格な結果に落ち着く前に何を比較したかを示しているからだ。
これが自分のフレーミングが変わった瞬間だった。私は公平性ダッシュボードを念頭に始めた。実際に構築していたのは、再実行可能な意思決定プロセスだった。グラフが有用だったのは、すべてのポイントがテスト済みの構成を表していたからであり、フロンティアが視覚的に説得力があるからではない。
ついに見えたトレードオフ
私は完了した実行がすべての 480件の構成を評価し、設定された精度予算内でデモの0.80ゲートをクリアした240件を返すのを見た。推奨された構成はベースラインの特徴量を維持し、保証収入クレジットを追加し、クレジットスコアの影響を640に上限設定し、L2正則化10.0を使用した。
次に、その結果を完璧さの主張としてではなくトレードオフとして読むことができた。この固定合成フィクスチャ上で、最小DIRは0.694から0.875に上昇した。AUCは0.7823から0.7788に移動し、インターフェースが 0.36%。フィクスチャ内のBlackバウチャー保有者の交差点では、DIRが0.701から1.029に移動した。
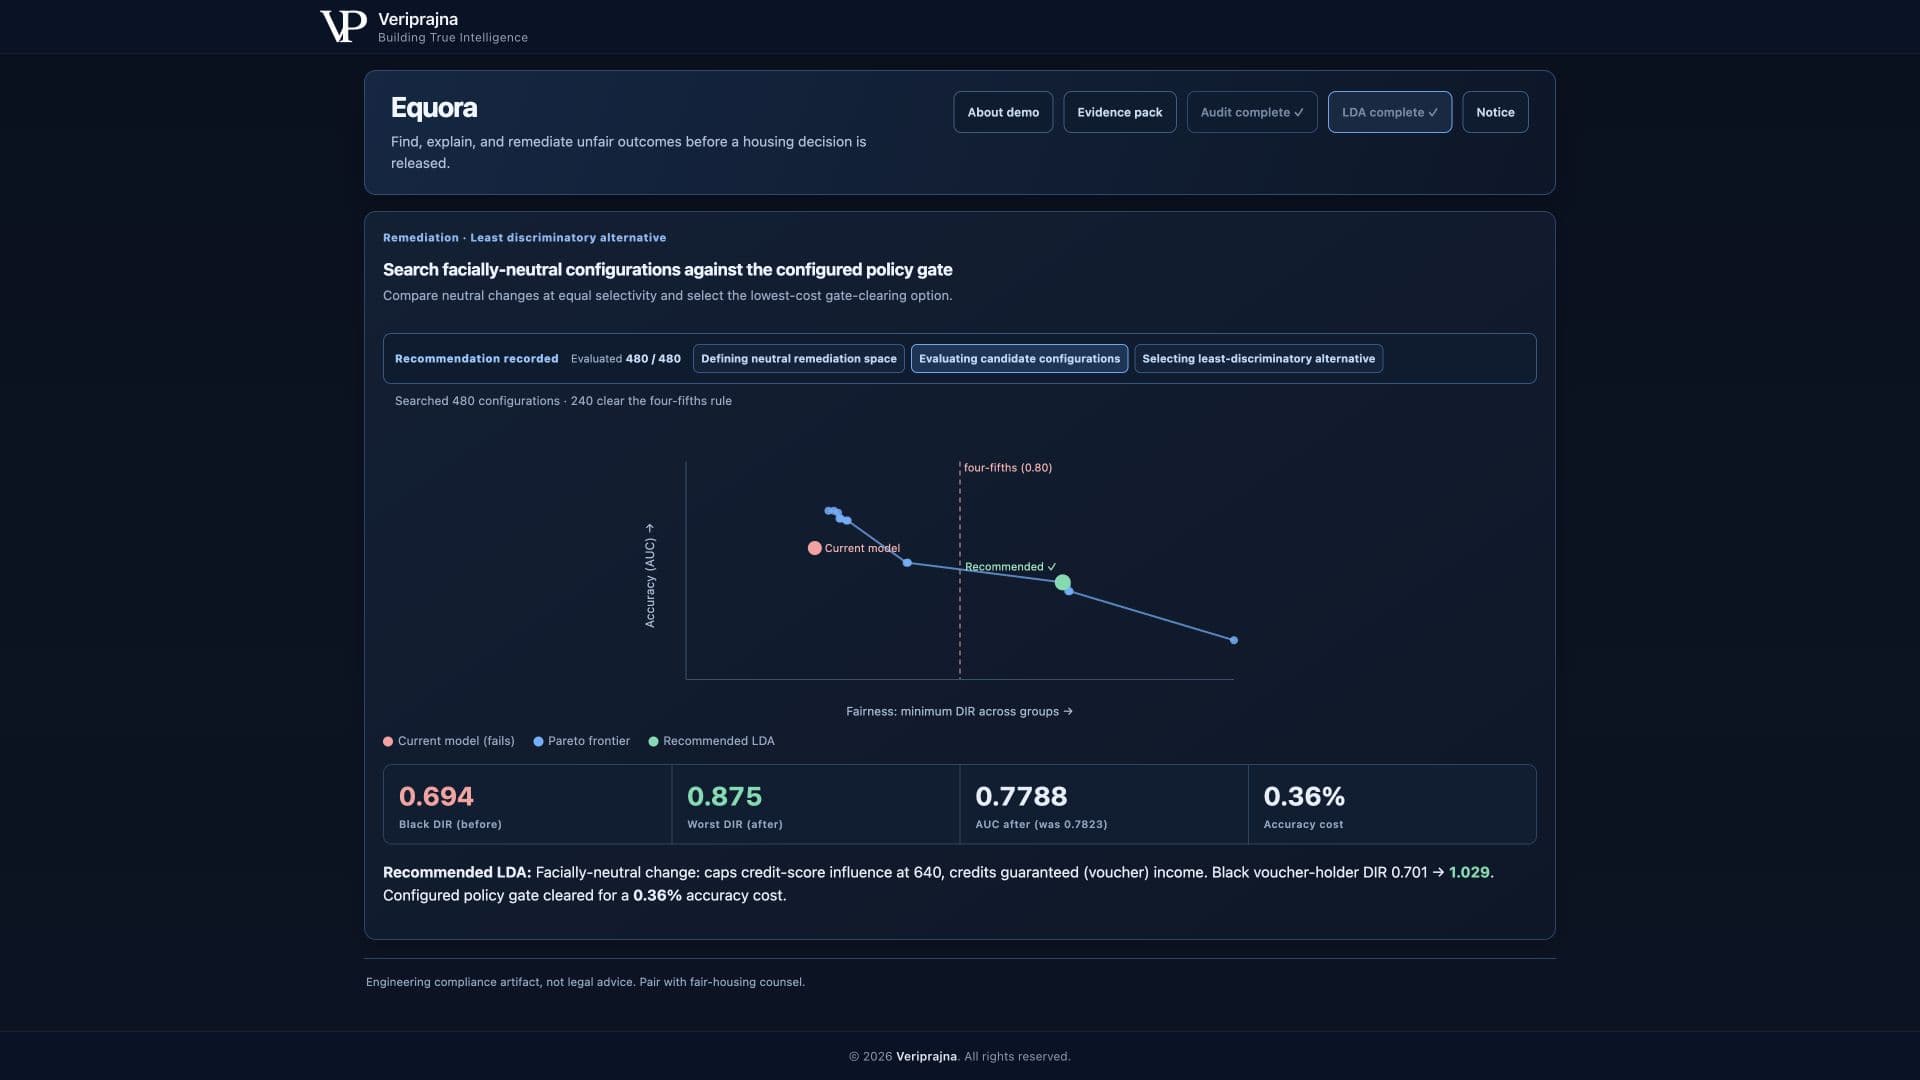
私は「推奨」という言葉に慎重だ。この候補は、この特定のグリッド内で適格となる、測定されたAUCコストが最小のオプションだ。これは 普遍的な最適解、法的認証、あるいはバイアスのないモデルの証明ではない。数値は、合成データ上の一つのフィッティングされたベースラインと一つの有界探索を記述している。実際の家主、スクリーニングベンダー、申請者プール、または住宅市場を記述するものではない。
その文章を書くのは、改善数値を書くよりも難しかった。製品言語は確実性を求めるが、ガバナンス業務はスコープの維持に依存する。有界な主張が正確に強いのは、別のレビュアーがどこで主張が終わるかを見ることができるからだ。組織がグリッドを拡張したり、予算を変更したり、異なるポリシーゲートを採用したりすれば、異なるレコードとおそらく異なる推奨が得られると予想すべきだ。仮定が変わっても、この手法は再実行可能なままだ。
この制限はデモンストレーションを弱めない。それはレビュー境界を明示する。レビュアーは0.03予算、4/5ポリシーゲート、利用可能な特徴量、選択率制約、またはグリッド自体に異議を唱えることができる。それらの意見の相違は、静的な赤いスコアに添付されたコメントではなく、再実行できるプロセスへの入力となる。
なぜ証拠を本文の外に置き続けたのか
本文はインターフェースを完成したように見せるため、生成されたテキストにより多くの説明を担わせたいと思ったが、思い留まった。流暢なパラグラフは、どの構成がテストされたかを確立したり、DIRを計算したり、候補が閾値を通過するかどうかを決定したりすることはできない。それらは計算上の主張であり、たとえすべての生成された文が削除されてもレコードが残るようにしたかった。
私は役割を分離した。決定論的コードが監査を計算し、代替案を探索し、設定されたゲートを適用し、結果を保存する。言語モデルは、有効な場合にはテキストの草稿作成に限定される。オフラインモードは決定論的テンプレートを使用する。 証拠は文言に依存しない。
私は同じ境界を申請者向けの理由通知にも適用した。否決された合成レコードに対して、正確な線形モデルの特徴量帰属が上位3つのネガティブな寄与因子を特定する。通知の草案者はそれらの特徴量を引用しなければならない。根拠のあるフォールバック通知はその狭いチェックを通過するが、特徴量を名指ししない汎用の理由コードは失敗し、人間によるレビューにルーティングされる。批評器は特徴量の根拠のみを検証する。完全なFCRAへの準拠や法的十分性を確立するものではない。
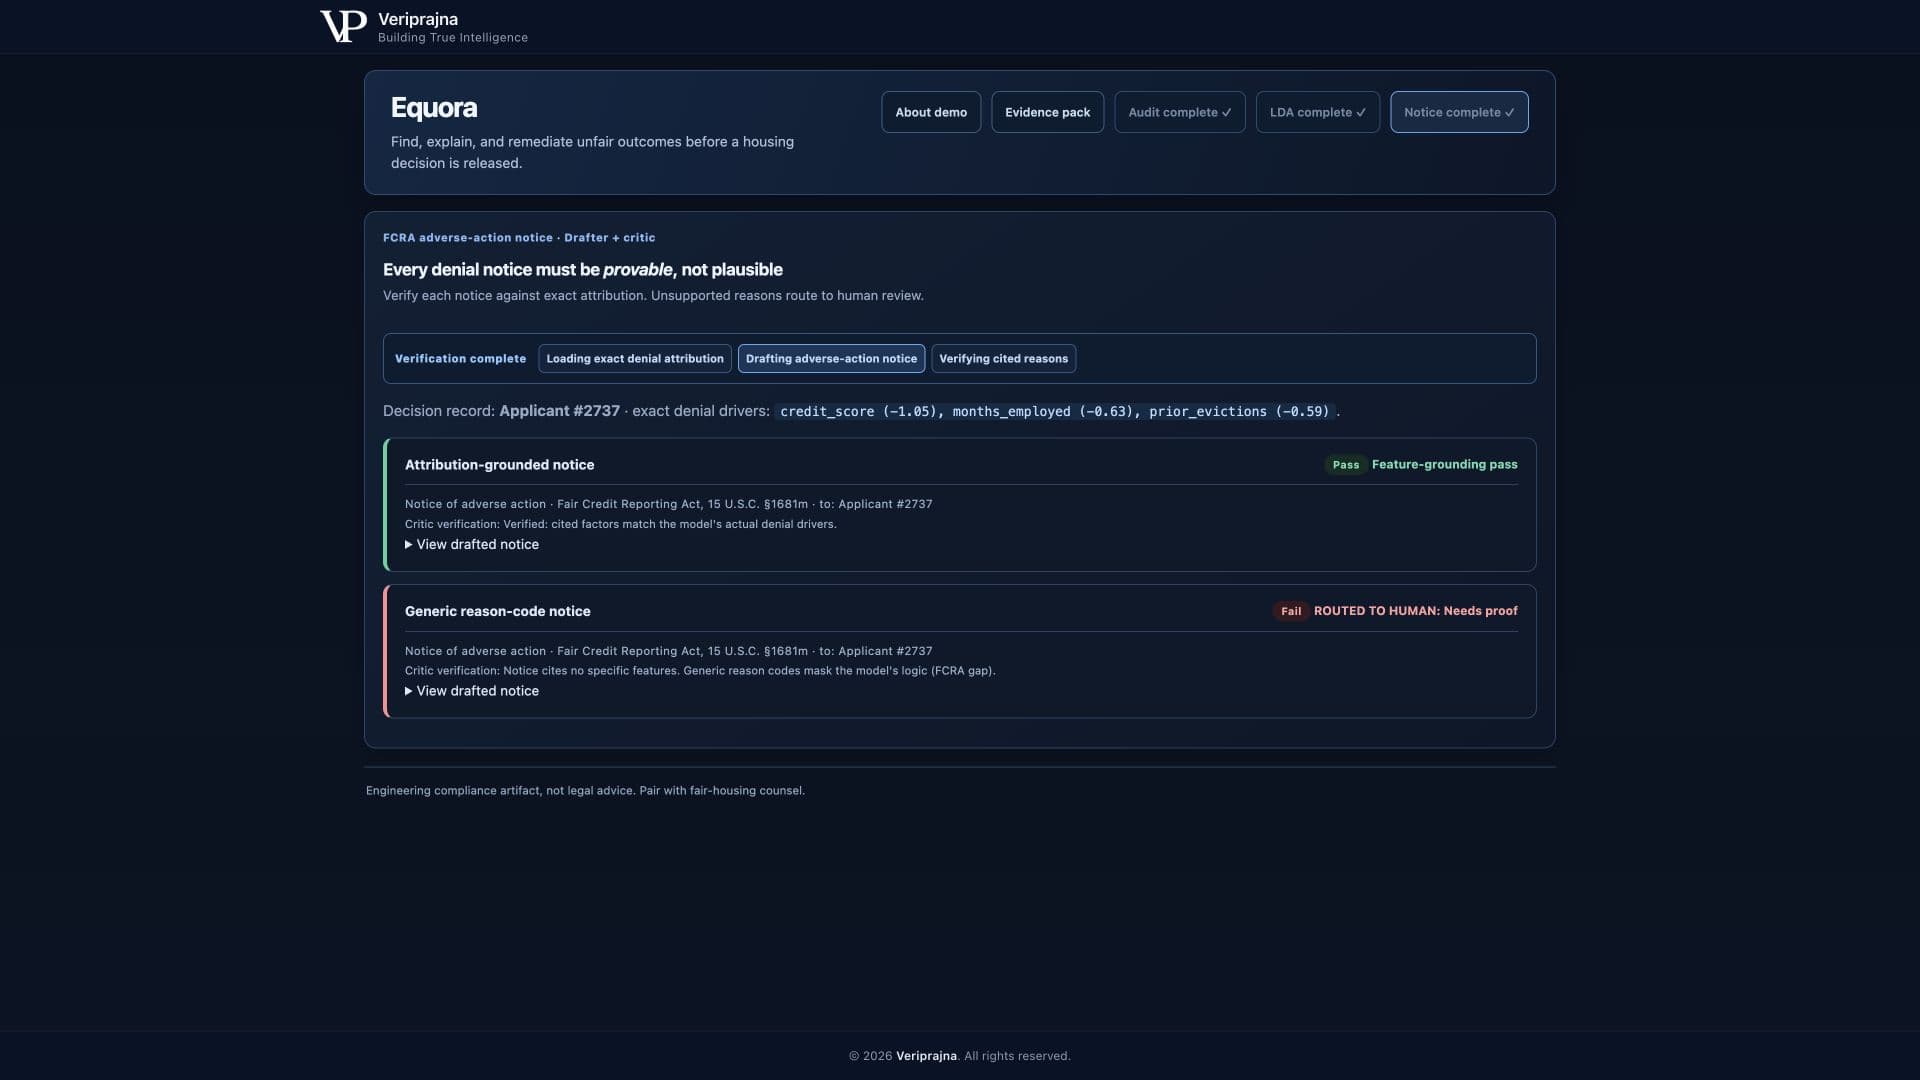
これは第二のテーゼではなく探索に隣接するものだ。チームが代替案を選択したら、証拠はまだ意思決定レコードとそこから公開されるあらゆる説明の中に組み込まれなければならない。 再現可能な探索は、最後の一マイルが理由を発明できる場合にガバナンス価値を失う。
会議室に持ち込みたいアーティファクト
私は今、レビュー会議を違ったように思い描く。誰かが赤いスコアを提示し、モデルを改善するという漠然とした約束を受け入れるよう求める場面は想像しない。レビュアーが有界グリッドを開き、等しい選択率ですべての候補を確認し、パレートフロンティアをチェックし、選択された結果を設定されたルールに遡って追跡する場面を想像する。
私はレコードがゲインとコストの両方を示してほしい。ここでは、探索後の最小DIRが0.875、AUCが0.7788であり、その隣にベースライン値がある。また、システムが却下した代替案を保持し、 適格なものがない場合は安全な代替案なしを返してほしい。強制された推奨は、最も重要なあり得る結果を消し去るだろう。
完全なウォークスルーは the Equora housing AI compliance breakdownで入手できる。それは監査、有界な最小差別的代替案探索、トレードオフビュー、および証拠の引き渡しを示している。これは合成データで構築されたエンジニアリングデモンストレーションであり、本番の意思決定システムや法的アドバイスではない。
ワークフローを私の説明で読むよりも実際に見たいという方は、創業者のウォークスルーがエンドツーエンドで実行されているものがここにある。
私は赤い指標から始めた。それが表示すべき明白なものだったからだ。私が確信して終えたのは、より価値あるアーティファクトとは、赤い結果から有界な選択に至る再実行可能な道筋であり、その道筋が適格な選択なしで終わる可能性も含むということだ。 監査はチームに立ち止まるよう伝えることができる。探索レコードは、どのように進めるかを決める前に何を検討したかを示すことができる。