Medicare Advantage模型給出0.985拒賠高分,門控機制為何仍保留待醫師審查

我在CertaRoute中打開了一個合成的Medicare Advantage預先授權案例,發現初始拒賠判定的 模型置信度為0.985。患者特異性指標確實存在,但在模型的 絕對歸因中僅佔22.06%。決策治理層將該案例保留以待醫師審查,而不是將置信度視為最終敲定拒賠的許可。
這正是我希望展示的系統設計決策。模型並不僅僅因為輸出了一個高分就是有缺陷的。關鍵在於該評分是否包含了足夠多的該特定當事人的具體情況,足以承載後續決定。 完整演示流程 展示了應用的路由、影響因素及本地記錄。這是一篇附帶視頻和截圖的解說文檔,而非交互式支付方系統。
在打開案卷之前,拒賠看起來已成定局
我經常回看A-4471,這是我們初始合成數據集中一個按腳本運行的急性期後專業護理延期案例。在工作列表中,初始模型評估顯示為 DENY。這正是倉促的審查流程容易誤以為是最終判定的明確輸出。在案卷內部,個體臨床因素與群體加權因素並列顯示。同一屏幕顯示 待醫師審查,且其技術記錄狀態為 NEEDS_PROOF。
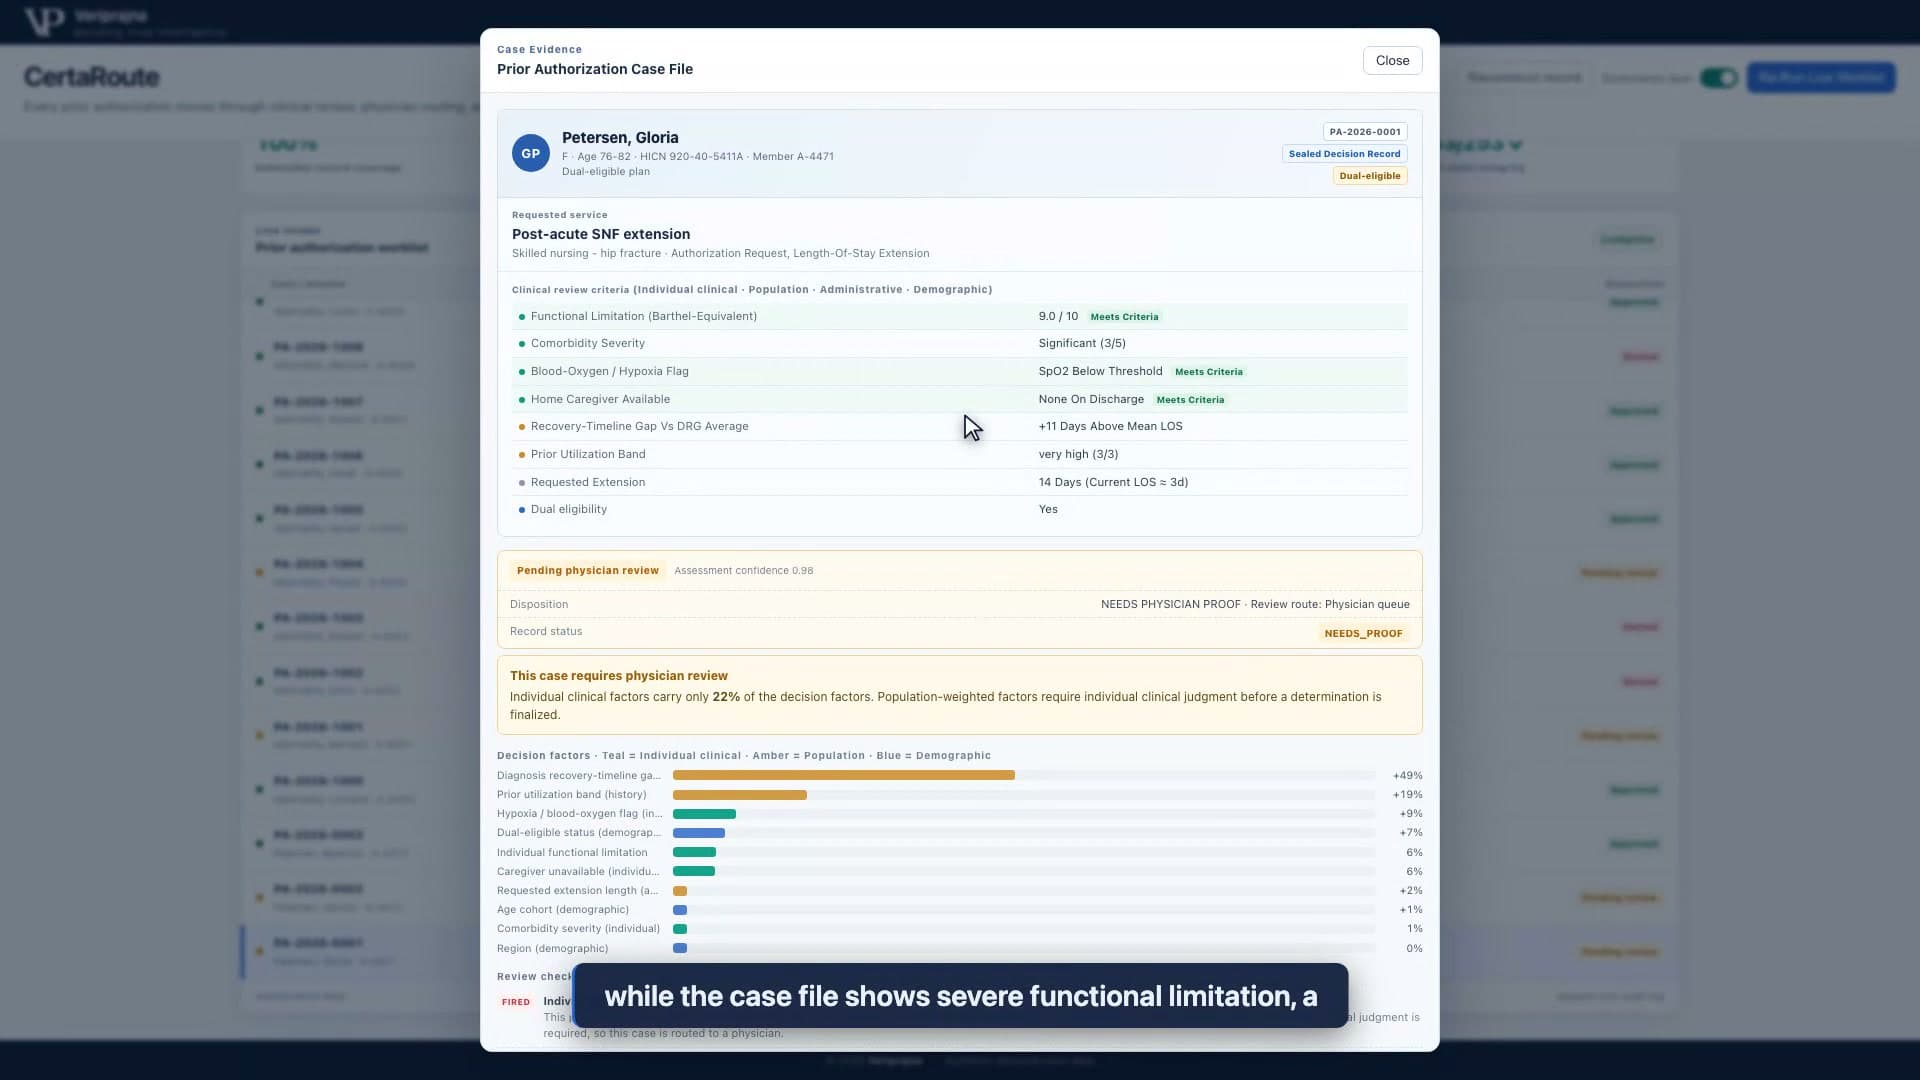
我不希望讀者將這些臨床觀察誤認為是真實參保人的病歷。姓名、會員標識符和案例均為虛構。QNXT來源標籤僅是一個替代標識。該視圖背後沒有真實的索賠處理、承保裁定或在職醫師隊列。我採用合成案例,是為了能夠在無需借用我們並不擁有的真實患者故事來獲取公信力的情況下,深入剖析系統機制。
首要的分歧十分明確:案卷中包含個性化事實,但一個高置信度的拒賠決定仍可能主要由聚合歷史數據決定。在輸入中看到患者字段並不等同於看到它在結果中起到了決定性作用。當界面將模型的輸出壓縮為單一的綠色或紅色徽章時,這種區分很容易被忽略。我想要的恰恰相反:一個能夠將初始結論與其所依據的證據放在一起對照閱讀的案例視圖。
CMS在其 2024年2月承保標準與利用度管理常見問題解答 中明確了根本責任。Medicare Advantage的承保決策必須考量個別患者的具體情況;基於更大規模數據集的算法無法替代這種審查。我將其理解為一項設計約束,而不是聲稱本演示已經滿足了Medicare Advantage的要求。實際的承保標準、臨床判斷和計劃運營必須在真實的實施環境中予以評估。
0.985拒賠背後的22.06%
起初,人們很容易把0.985視為定心丸。但隨後我審視了歸因柱狀圖。在A-4471中,康復時間線差距約佔絕對歸因的 49%,既往醫療利用情況約佔 19%。各項個體臨床因素合計僅貢獻 22.06%。案例文件在頁面上為這些因素留出了展示空間,但模型在拒賠判定中賦予它們的權重卻微乎其微。
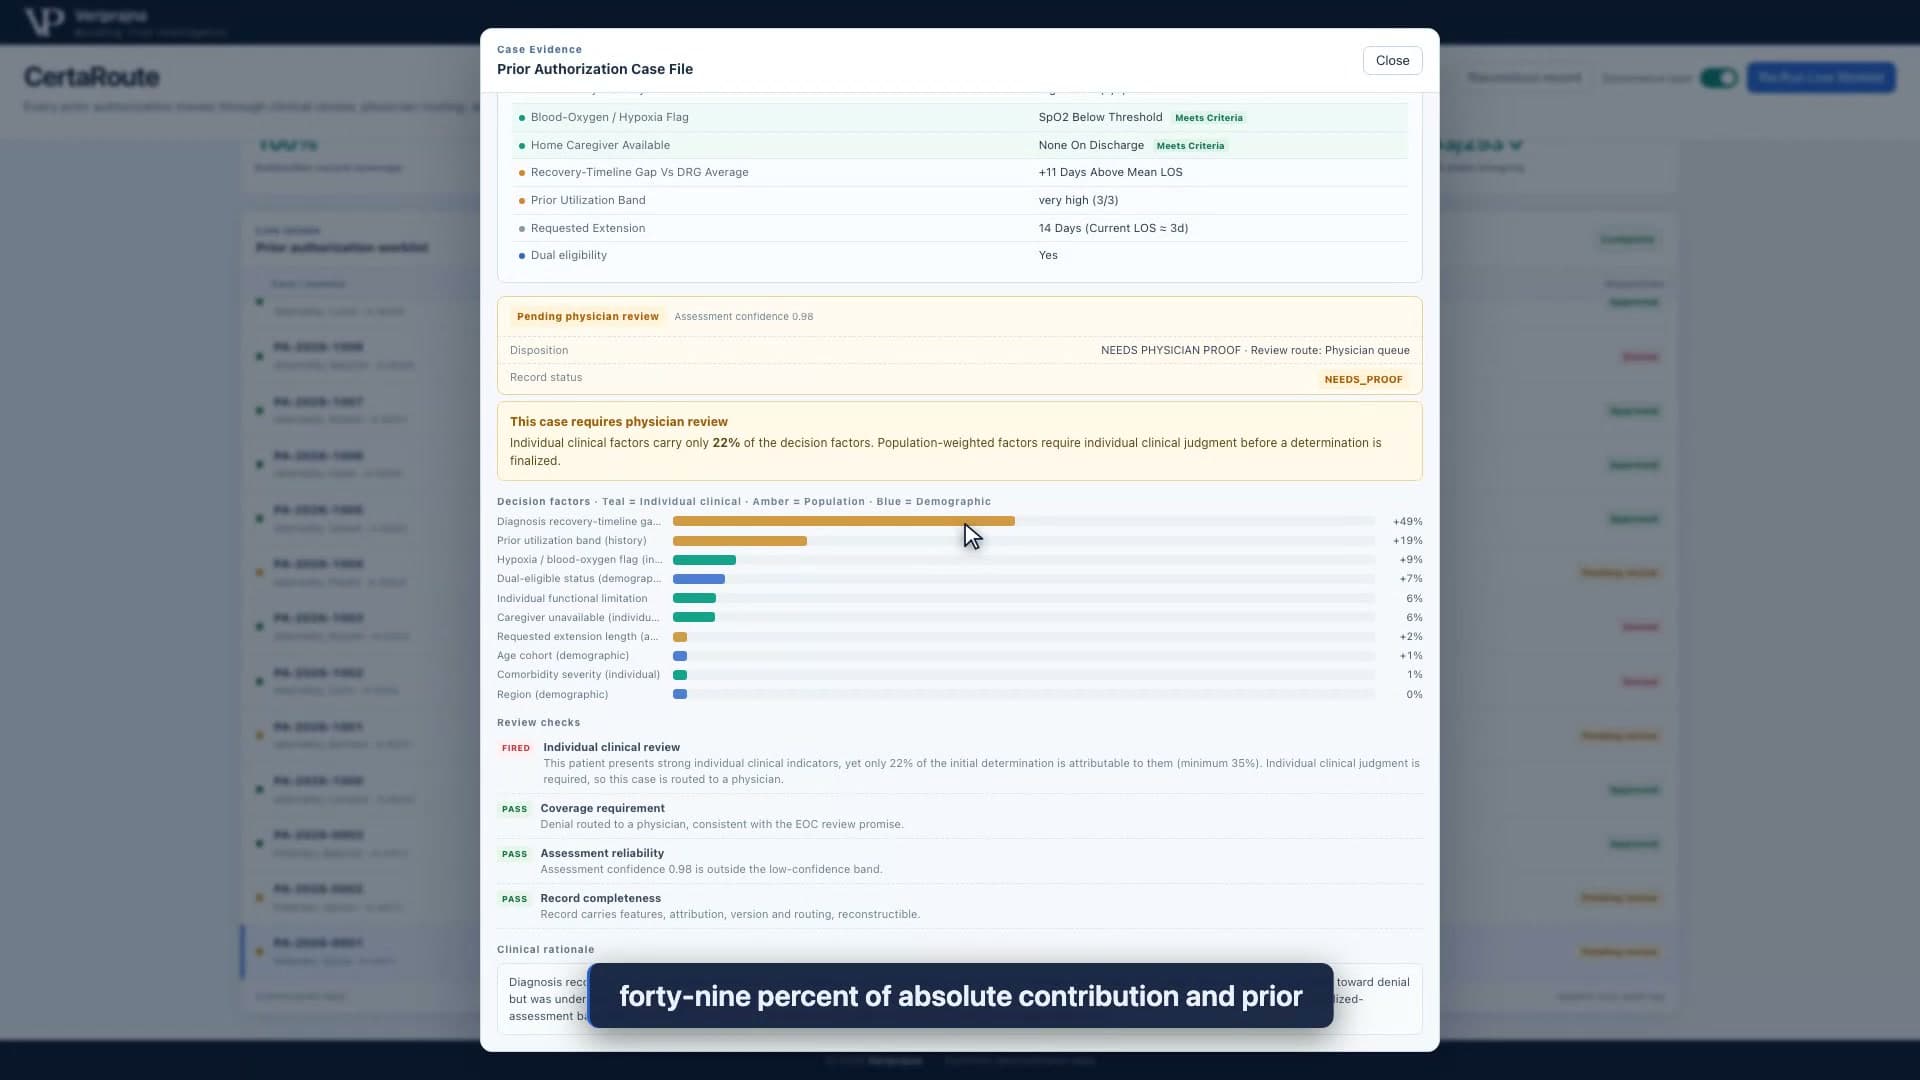
我必須抵制對該圖表進行簡單化、片面的解讀。Shapley歸因解釋了這個特定的訓練替代模型如何在十個特徵之間分配貢獻。它並不能證明某個個體因素具有醫學決定性,也不能證明正確的承保結果應當是批准。患者可能存在模型未能良好呈現的重要臨床事實,單憑圖表無法對其作出裁決。真正有價值的推論更為嚴謹且有力:模型的置信度並未告訴我個體證據是否具備足夠的分量。
這就是為什麼本演示中的底線是一個路由閾值,而不是醫療必要性閾值。在可配置的 35% 份額下,個體因素歸因過低的顯著拒賠將被攔截保留。它將被發送到標記為 NEEDS_PHYSICIAN_PROOF 的醫師審查路由中。系統不會自動逆轉結果,也不會將模型的初始拒賠悄然轉換為最終的保險計劃拒賠。該核查的意義在於防止這兩類性質不同的事件被混為一談。
我認為這種區分比探討AI是否適用於利用度管理這一宏泛爭論更為有益。模型有助於整理和評估信息。但如果操作業務系統無法向審查員說明為何某項拒賠能夠從模型輸出轉化為正式授權的決定,那麼高置信度數值就獲得了超出其應得的權威。在A-4471中,模型陳述了一套結果,而治理路由則實際上表明該證據仍需臨床醫生介入。
對觸發器的解讀必須結合其適用範圍。同一演示中包含一個批准案例,其個體因素歸因低於配置的底線。由於該底線僅適用於顯著拒賠,因此該批准案例不會被此項核查改道。這種不對稱性在代碼中是刻意設計的。將該底線描述為通用的臨床質量檢驗是錯誤的,這會掩蓋本示例真正提出的具體操作問題。
我將判定權從解釋文本中剝離
撰寫一段具有說服力的建議性文字並不困難。但我不能僅僅因為要求語言模型編寫了一段文本,就將散文視為安全的路由權威。在CertaRoute中,確定性治理門控 根據案例輸入和模型輸出計算路由。解釋性文本隨後生成。在無API密鑰的默認路徑下,它是一個確定性模板;可選的服務商接口或本地橋接可以提供模型生成的措辭。但無論哪種版本,都不具備最終決定處置的授權。
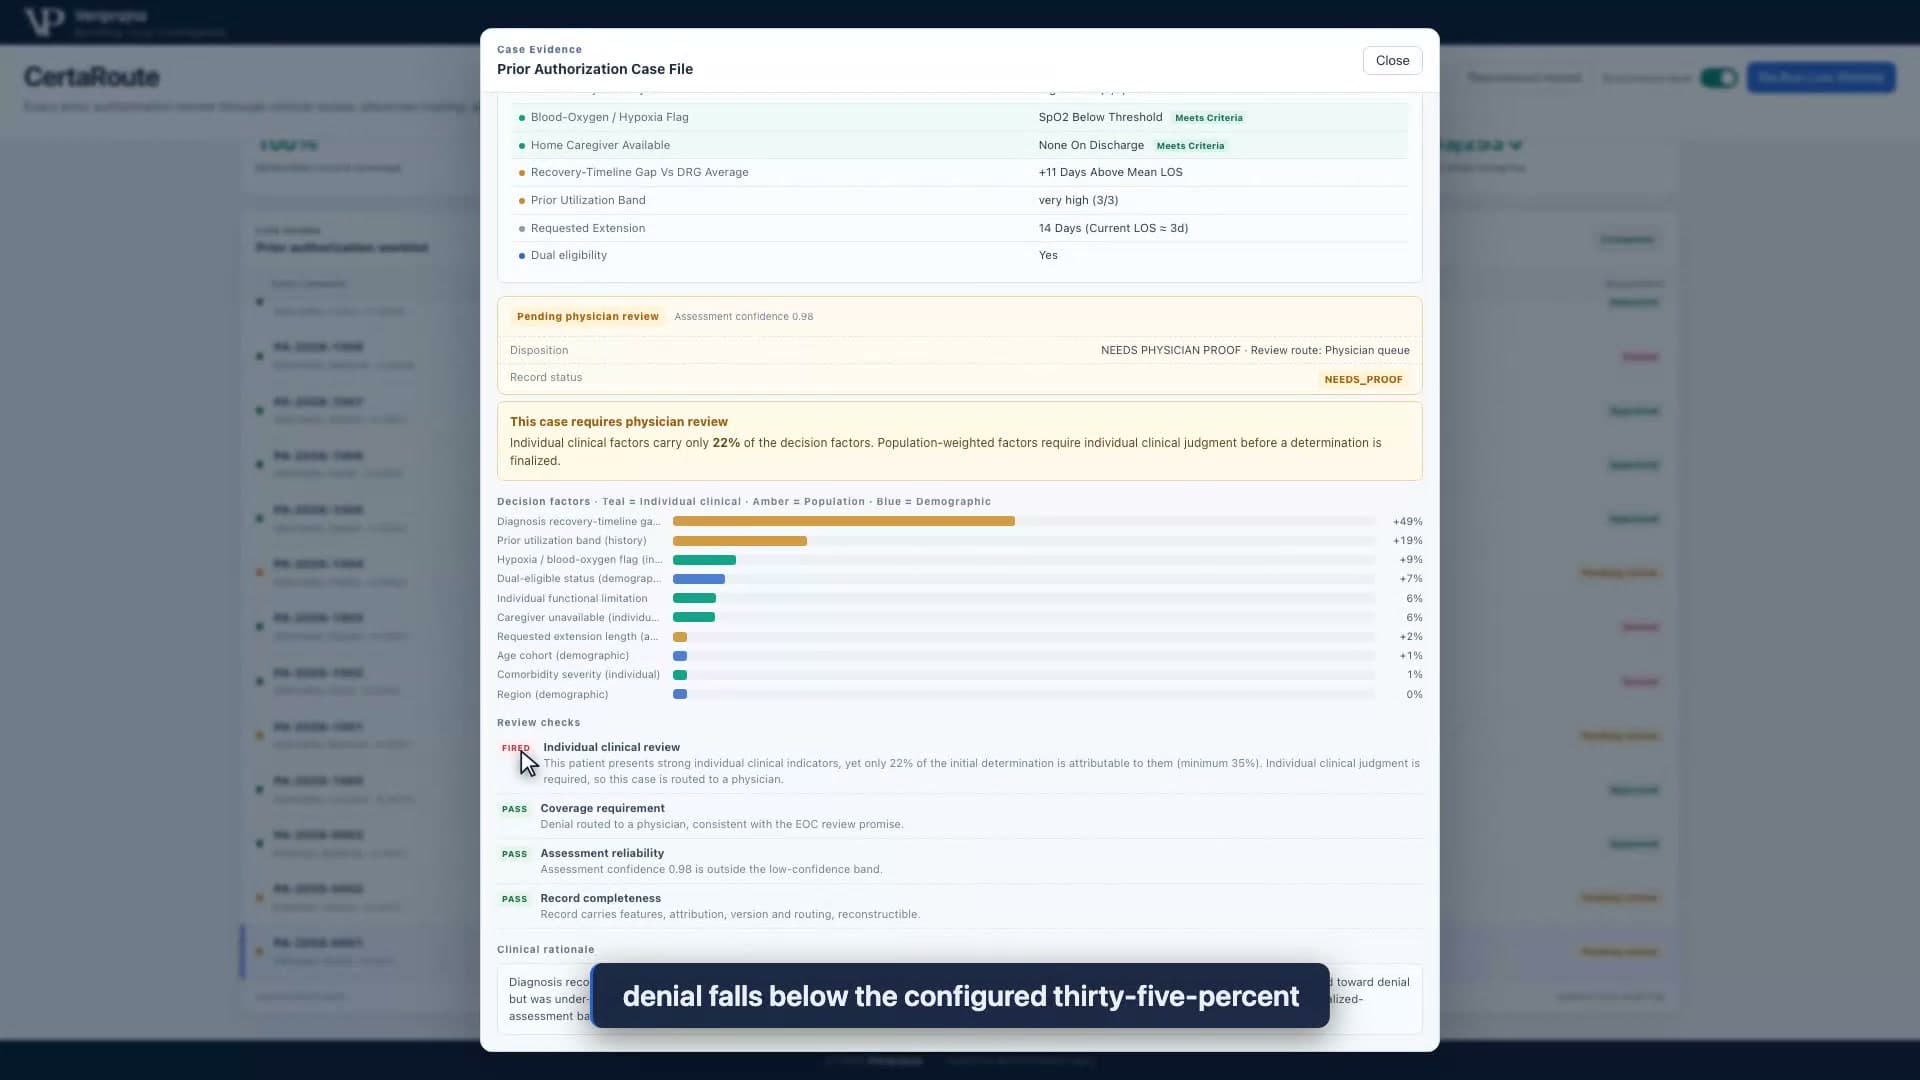
我認為這是界面超越傳統模型演示的關鍵節點。書面理由闡述能夠使結果清晰易懂,但規則本身是完全獨立可查的。我可以指出輸入、歸因、設定的底線和路由,而無需任何人盲信某段生成文本的行文風格。即使未來的解釋誇大了證據表明的內容,門控依然保持相同的結果。這種分離賦予了審查員一個更具深度的問題:代碼是否出於正確的理由、在正確的政策下、保留了正確的臨床背景而對本案例進行了路由?
本演示中的響應能力是有限的。其承保要求核查只是基於路由的合規確認,並未將案例與真實的承保範圍證據(Evidence of Coverage)文檔進行對比。完整性核查包含字段存在性標誌,但該流水線目前直接將該標誌傳遞為 True ,而非獨立檢查每個字段。我不希望這兩項檢查所顯示的友好 PASS 標籤在營銷中被宣稱為完整記錄或計劃合規的證明。 一項直觀可見的核查,唯有在其適用範圍同樣清晰可見時才具備真正價值。
低置信度區間和預設的罕見合併症組合在固定的運行中提供了其他審查路徑,但它們並不是A-4471對我而言如此重要的原因。該案例測試了更為嚴峻的考驗:模型可能非常篤定,但仍將特定個體的諸多具體情況邊緣化。系統設計的核心在於誰在這一邊界上擁有最終裁決權。在本次演示中,代碼攔截了拒賠決定,而在真實工作流中醫師仍需進行個體化評估。所展示的隊列本身僅僅是演示狀態。
我曾聽聞“人機協同(human in the loop)”一詞被用來涵蓋各種截然不同的機制。它可能意味著真實的臨床醫生在作出判定前全面審視完整背景,也可能僅僅意味著在決定實質上已經作出後貼上一個隊列標籤。在我們的應用中,隊列標籤是模擬過程的直觀終點。在其之外更繁重的工作包括流程歸屬、資質審查、訪問控制、實際計劃準則以及審查切實發生的證據。我寧願清晰標明這一邊界,也不願暗示一個標籤就足以證明上述流程已經發生。
真實記錄讓我更難忽視自身的局限
接下來我檢查案例重建過程。應用程序寫入一條本地SQLite記錄,其哈希值融合了前一條記錄的哈希值,並在驗證期間重新計算整條鏈。在固定合成運行中,篡改前有 253條中的253條 記錄通過了驗證。演示控制項可以在不重新計算哈希值的情況下修改已存儲的記錄;隨後驗證器將準確報告鏈條斷裂。A-4471的記錄可以被重新構建並輸出為HTML格式。
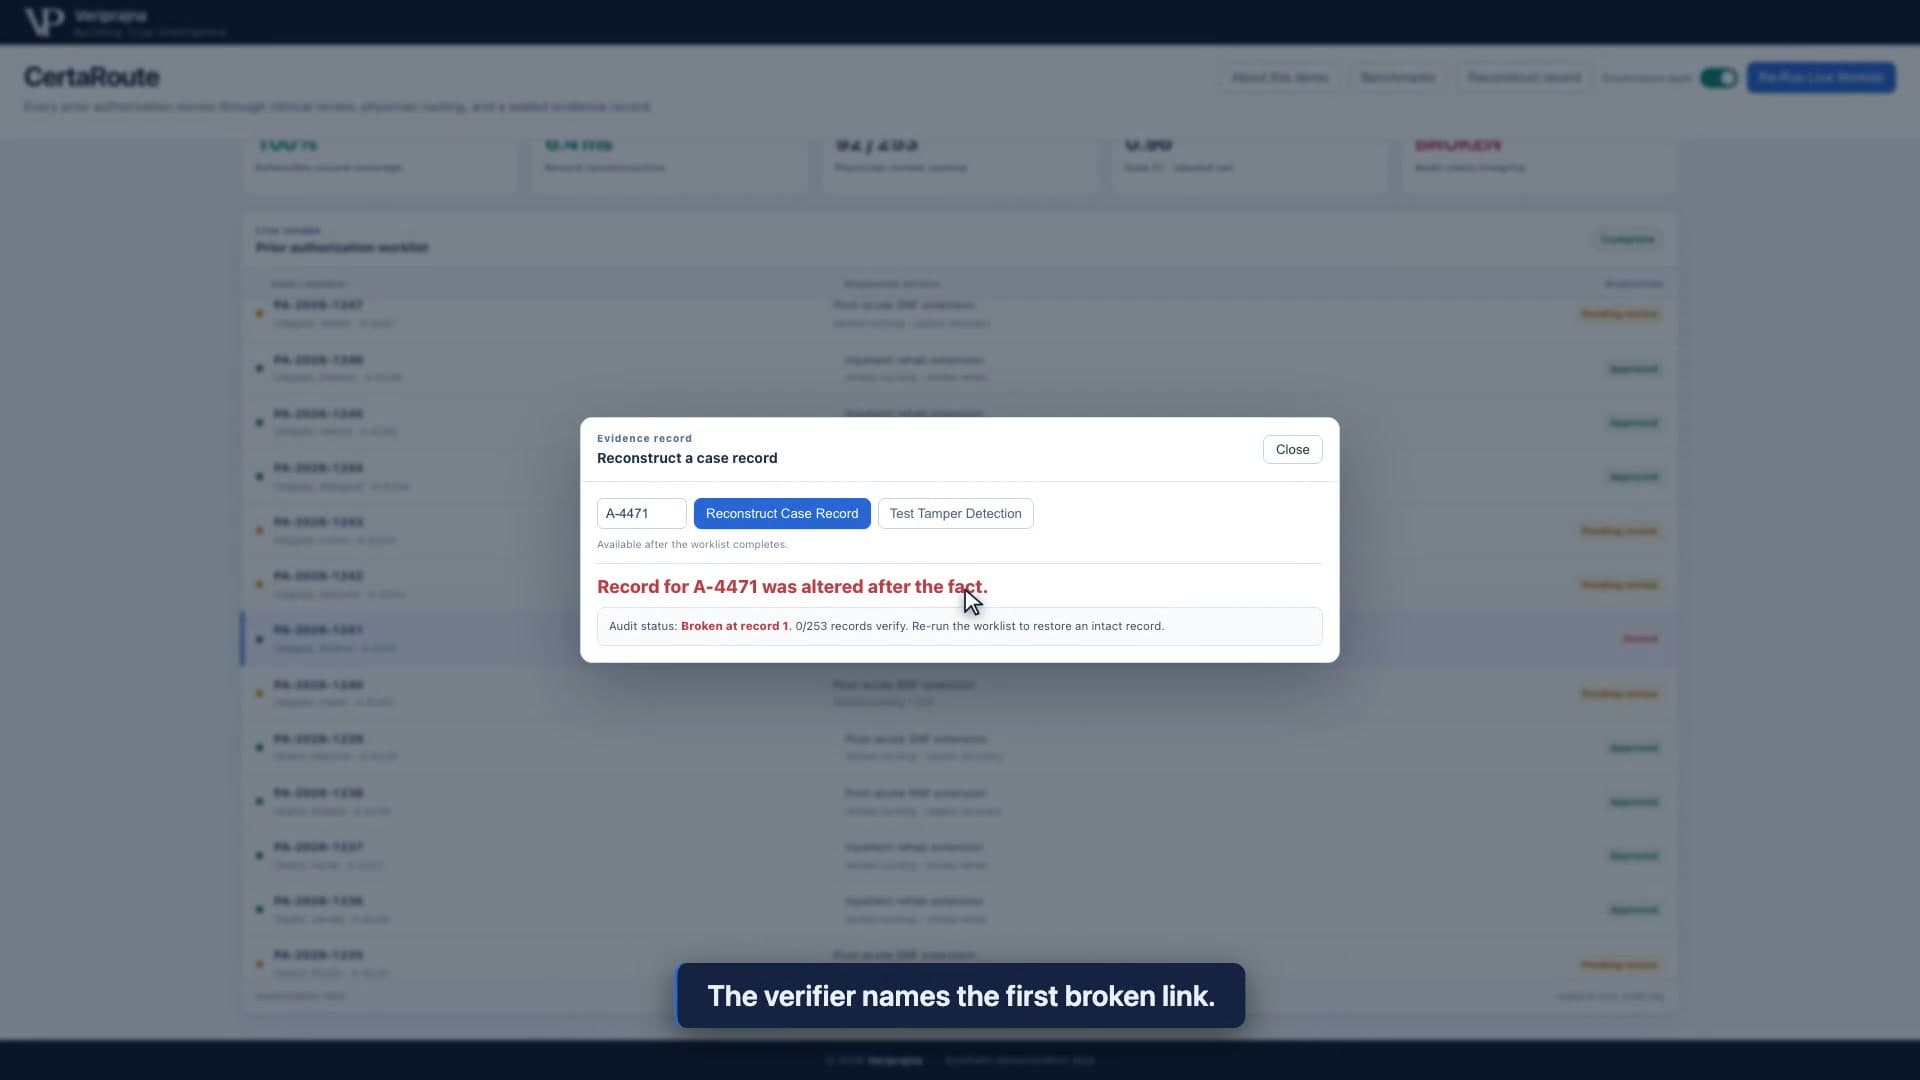
我很欣慰該記錄提供了比“保留證據”這一空洞承諾更具實質性的保障。它保存了案例輸入、歸因和路由狀態,使他人能夠核驗系統究竟執行了何種操作。然而在審視重構輸出時,我也看到了它所無法提供的內容:合格醫師完成的評估、經過驗證的臨床背景以及獨立受控的證據保管鏈。技術上完好無損的鏈條無法證明上述任何缺失要素。它可以揭示本地記錄的變動;但單憑自身,無法證明底層數據是否真實,也無法證明最終的承保決策是否合法合規。
應用將部分記錄稱為 DEFENSIBLE。我將其視為 演示狀態標籤,而非法律結論。在固定運行中,253例中的92例 走了醫師審查路徑並獲得 NEEDS_PROOF ;這些屬於待決拒賠,而非已完成的具有可辯護性的拒賠。其餘161例被演示邏輯標記為 DEFENSIBLE,但該邏輯並未獨立驗證字段內容。即使在分層對比中達到100%的記錄覆蓋率,在本次固定運行中也僅意味著可重構的技術記錄。它既不能代表已實際落地的計劃,也無法確立法律辯護效力。
這是探討審計追蹤的一種更為嚴謹的方式。我能夠展示保留和檢驗技術事實的機制,同時明確指出其所未包含的臨床和運營事實。如果一條遭到篡改的本地行能夠被及時檢出,那是極具價值的。如果在同一時刻指出醫師臨床判斷的缺位,該記錄就更不容易淪為製造虛假安全感的遮羞布。
我希望審查人員看到之處
我再次回到最初的拒賠案例,因為在大量的匯總結果堆疊下,個案往往極易被湮沒。基準面板包含了種子數據中預設的雙重資格者拒賠率差距以及合成路由評分。這些視圖可以引發關於整體人群特徵的探討,但它們無法告訴我A-4471是否獲得了因人而異的個體化評估。人群群組信號與個案層級的路由服務於不同目標;本文的核心始終緊扣個案本身。
我希望合規或醫療管理負責人審視此演示時,能夠清晰把握整條邏輯鏈條:首先存在一個關於急性期後專業護理延期的合成申請;經過訓練的替代模型最初以高置信度予以拒賠;精確的Shapley歸因展示了促成該評估的具體特徵;個體臨床佔比低於顯著拒賠所設定的底線;代碼門控攔截了該案例以交由醫師審查;本地記錄完整保存了應用的操作過程,同時將真實的醫師工作和實際計劃整合保留在演示之外。
以下是創始人對合成案例及審查門控的演練解析。
這一流程可在 CertaRoute完整解析 中查看。它絕非聲稱具備臨床驗證有效性、真實的支付方集成或合規認證。對我而言,其實際價值在於自信的模型輸出與據此採取行動的法定權限之間那段發人深省的審慎停頓。如果患者的具體情況無法直觀改變該決策路徑,那麼該置信度評分從一開始就回答錯了問題。