租戶篩選審計亮起紅燈,我的建構仍未完成。

紅燈結果並未提供足夠的答案
我無法忽視$2.275 million settlement in Louis et al. v. SafeRent Solutions,當我開始深入研究住房 AI 審計背後的工程問題時。聯邦法院於 2024 年 11 月給予該和解最終批准,且未承認任何不當行為。此案讓一項風險變得清晰可辨,但這次建構卻迫使我面對一個更棘手的操作問題:一旦模型審計顯示出差異,團隊究竟應該採取什麼行動?
我將 Equora 運行於一組固定的9,000 筆記錄的合成租戶篩選申請人樣本池。示範中以信用為導向的基準模型 ScreenScore v3 產生了 0.7823 的 AUC。最低差異影響比率(即 DIR)對黑人申請人為 0.694。示範中配置的五分之四政策門檻為 0.80。該門檻是示範的設計選擇,並非法律結論,也非自動化的《公平住房法》測試。
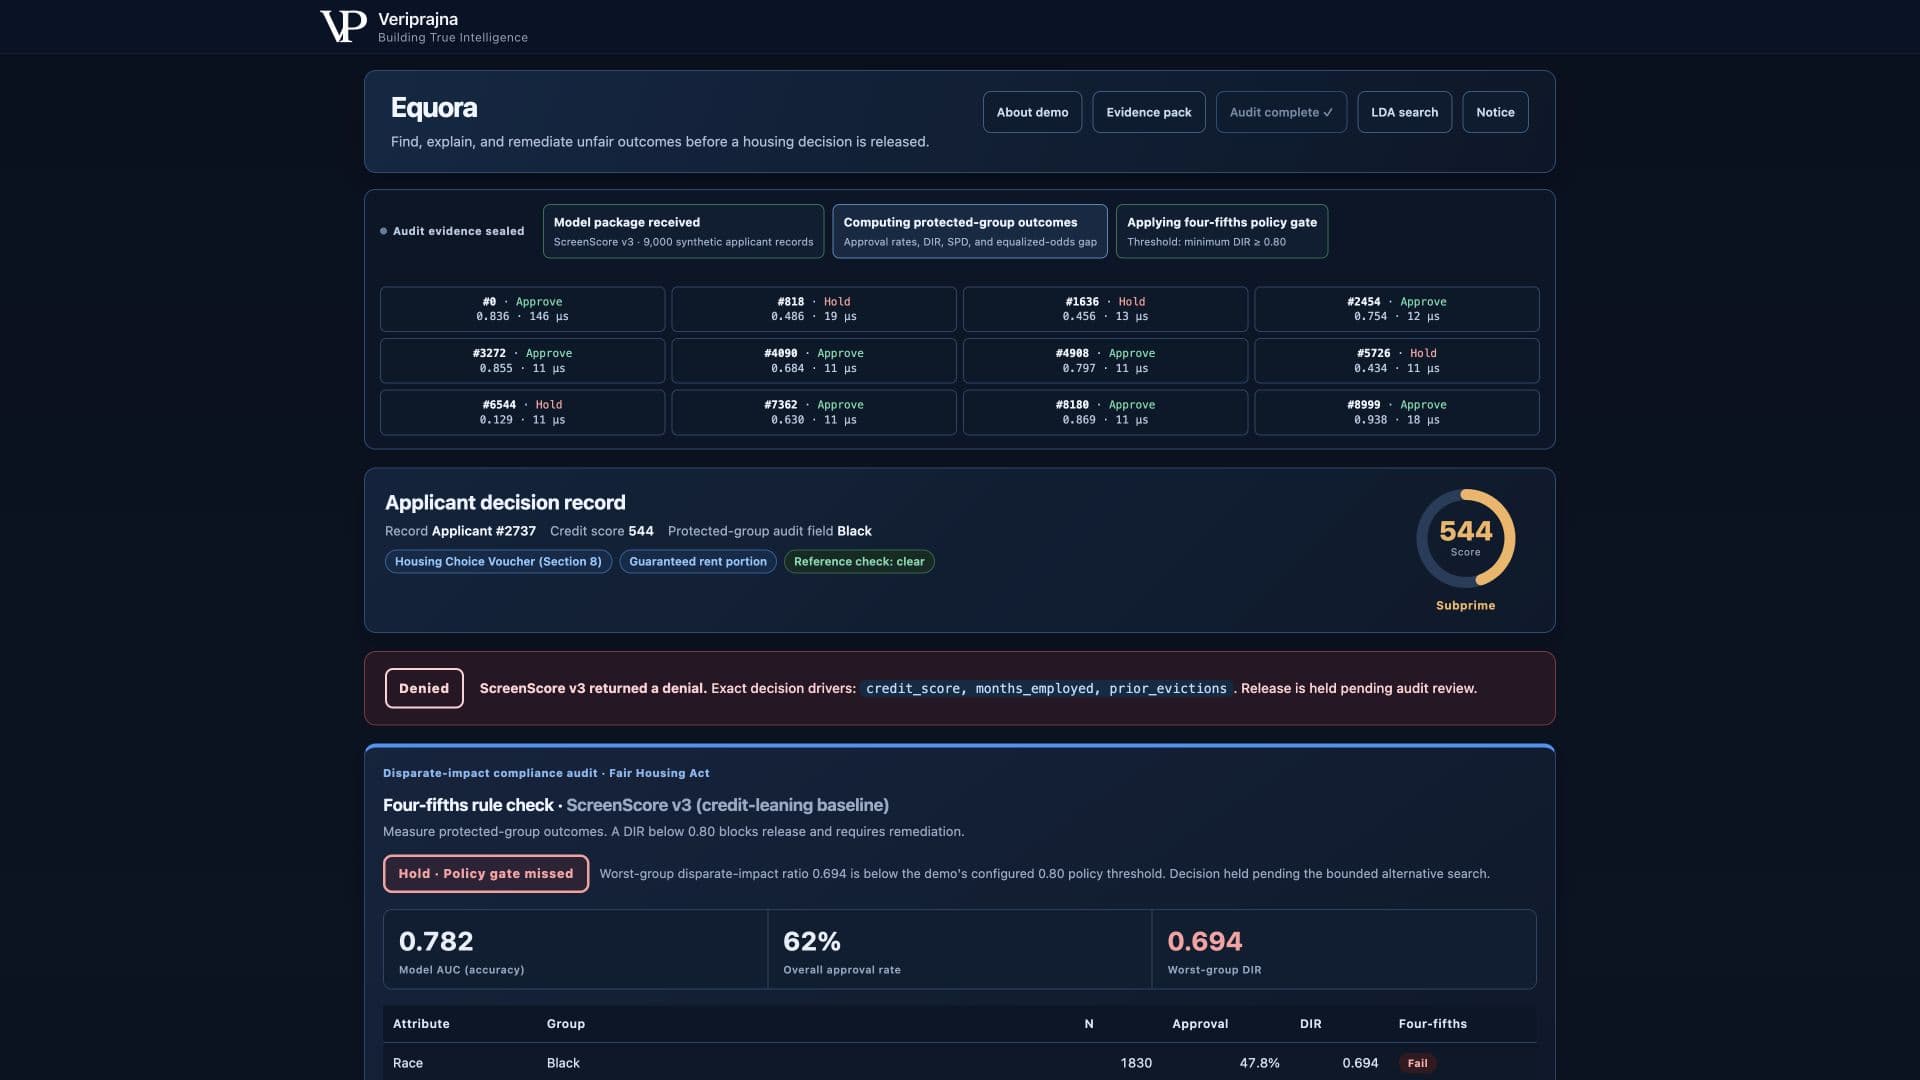
我的第一個版本本可以止步於此。它可以將結果標為紅色、生成報告,並在審查會議中看起來完整無缺。然而,我感覺自己建構的是一個有更好警報卻沒有應對方案的系統。該指標可以向團隊顯示基準在哪裡未通過配置的門檻,卻無法顯示是否存在差異性更低的替代方案、該替代方案將犧牲何種效用,或任何人日後如何能重現該選擇。
早期的操作說明仍可在Equora 住房 AI 合規詳解中找到,但只有當紅色審計成為起跑線時,這項建構才變得真正有趣。
指標未能回答的問題
我不斷回到審計表格下方同一片空白處:我會為哪項變更進行辯護,依據什麼證據?讓公平性數字移動有許多簡便方法:更改核准門檻、移除某項特徵、新增某項特徵、調整正規化。分數會移動,但缺乏明確搜尋空間和穩定篩選規則的移動,將難以進行治理。
我嘗試將問題視為單一模型修改來思考,但很快就失敗了。如果我限制了信用分數的影響力並使結果有所改善,我仍然沒有理由相信該限制優於其他限制。如果我將有保障的住房補貼券收入納入信用,我仍需要查看在相同篩選率下其效用成本。每一個孤立的變更都引發了關於我未曾評估的替代方案的新問題。
我將那些問題記錄在結果旁邊,並意識到我的原型對其中任何一個問題都沒有穩定的答案。第二次運行可能反映不同的直覺。第三次可能在未記錄更改的情況下改變比較集合。即使每個選擇單獨來看都是合理的,整個序列也將難以重建。那是失敗的實驗:我將補救措施視為一系列模型調整選擇,而它實際上需要成為一套已宣告的搜尋程序。這種區別聽起來很微妙,直到有人問及為何選擇某個合格候選方案而非另一個。
解決方案是使搜尋本身成為一個人工製品。Equora 評估480 個明確的、表面中性的在相同篩選率下的配置。網格在四個可選高風險特徵的子集、無上限、720、680 或 640 的信用分數上限、是否納入有保障的住房補貼券收入信用,以及從 0.1 到 30.0 的六個 L2 值之間進行變化。負債收入比、就業月數和申報收入保持包含在內。
這個邊界之所以重要,是因為我可以描述它。我可以重新運行它。我也可以說明它不涵蓋的範圍。此搜尋並不聲稱能涵蓋所有可能的模型、政策或特徵轉換。它是一個具有已知網格和已宣告精確度預算的有界工程示範。
紅色指標記錄問題。受治理的搜尋記錄可用的回應。
我必須使搜尋過程可被審查
我記得達到搜尋正確運行但仍感覺不透明的階段。最終出現了一項建議,然而通往建議的路徑大多隱藏在程式碼中。該輸出在數學上可辯護,但在操作上卻很薄弱。法律顧問或模型風險審查員不應該必須信任我對哪些組合進行過測試的記憶。
我將搜尋空間移入介面並使進度可見。系統針對相同的固定合成樣本和相同的篩選率約束,對每個配置進行測試。它記錄候選方案的 AUC 和最低 DIR,然後繪製精確度/公平性 Pareto 前沿。若在 0.03 AUC 預算內沒有候選方案通過配置的門檻,引擎將返回無安全替代方案,而非生成一個建議。
我希望審查員能夠提出具體問題。信用上限是否經過評估?有保障的收入是否被納入信用?每個候選方案是否保持了篩選率的一致性?有多少候選方案在配置規則下合格?這些問題都可從記錄中得到回答。決策程序保留在語言模型之外:確定性代碼計算指標、應用門檻,並選擇測量 AUC 損失最小的合格候選方案。
我也必須抵制剔除不成功候選方案的誘惑。產品展示自然傾向於突顯單一答案,但其他已測試的點為建議提供了背景。前沿讓審查員能夠比較所有已評估配置的 AUC 和最低 DIR,而非僅看到所選座標。落選的候選方案是證據的一部分,因為它們顯示了篩選規則在確定合格結果之前所比較的內容。
這是我自身框架發生改變的時刻。我最初以公平性儀表板為目標。而我實際建構的是一個可重現的決策過程。圖表之所以有用,是因為每個點代表一個已測試的配置,而非因為前沿在視覺上具有說服力。
我終於能看清的取捨
我觀察了已完成的運行,評估了所有480 個配置,並返回了 240 個在配置精確度預算內通過示範 0.80 門檻的配置。推薦配置保留了基準特徵,新增了有保障收入信用,將信用分數影響力上限設為 640,並使用了 L2 正規化值 10.0。
隨後我可以將結果視為取捨而非完美的聲稱。在此固定合成樣本上,最低 DIR 從 0.694 升至 0.875。AUC 從 0.7823 移動至 0.7788,測量損失為 0.0036,介面顯示為0.36%。對於樣本中黑人住房補貼券持有者的交叉群體,DIR 從 0.701 移動至 1.029。
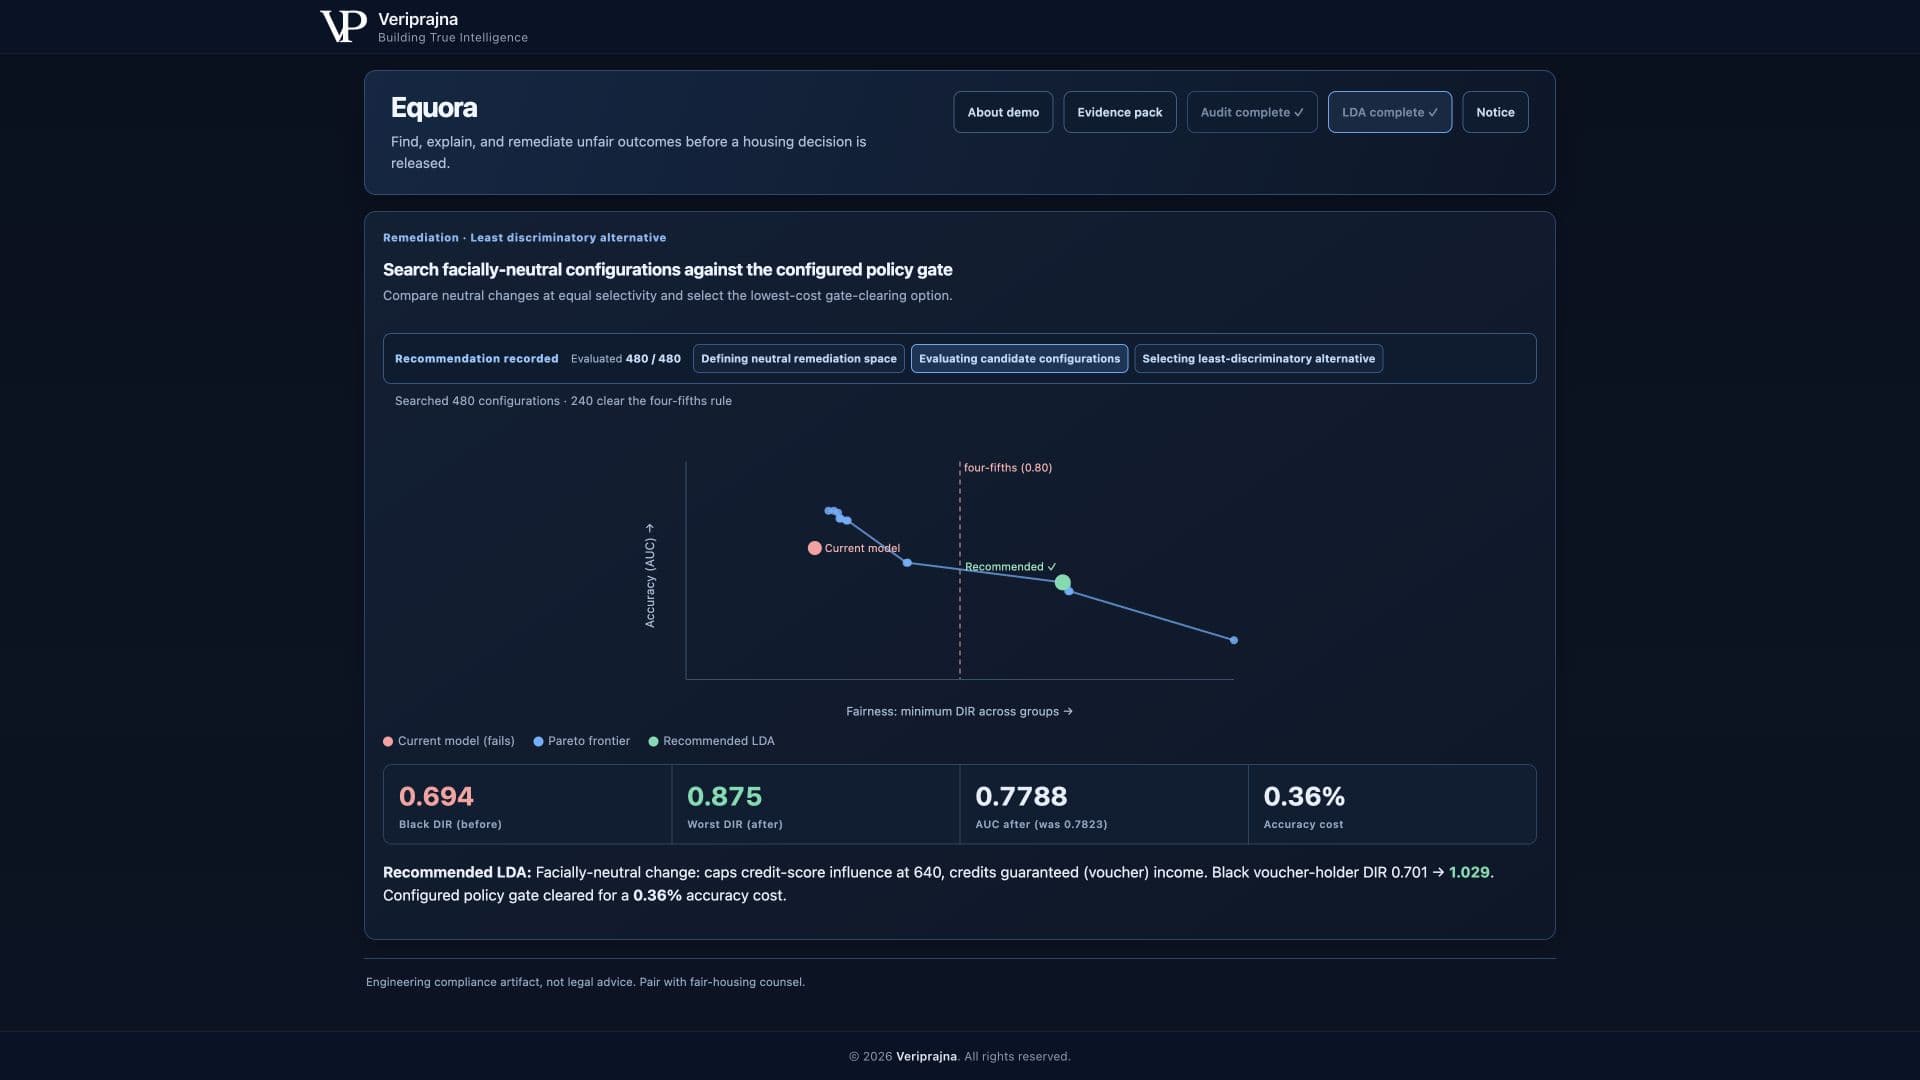
我在使用「推薦」一詞時十分謹慎。此候選方案是在此特定網格內合格且測量 AUC 成本最低的選項。它並非普遍最優解、法律認證或無偏見模型的證明。這些數字描述的是一個已擬合基準和合成數據上的一個有界搜尋。它們並不描述真實的房東、篩選供應商、申請人樣本池或住房市場。
我發現那句話比改進數字更難寫。產品語言獎勵確定性,而治理工作則依賴於保留範圍。有界聲明之所以更有力,恰恰是因為另一位審查員可以看到它止步之處。若組織擴大網格、更改預算或採用不同的政策門檻,應預期得到不同的記錄,也許還有不同的建議。即使假設發生變化,該方法仍可重現。
這一限制並不削弱示範的效果。它使審查邊界明確可見。審查員可以對 0.03 預算、五分之四政策門檻、可用特徵、篩選率約束或網格本身提出質疑。這些分歧將成為一個可重新運行的過程的輸入,而非附在靜態紅色分數上的評論。
為什麼我將證據保留在文字敘述之外
我曾考慮讓生成的文字承擔更多解釋工作,因為文字讓介面感覺更完整。但我退縮了。流暢的段落無法確定哪些配置被測試過、計算 DIR,或決定候選方案是否通過門檻。那些是計算性聲明,我希望即使所有生成的句子被移除,記錄也能保存下來。
我分離了各自的角色。確定性代碼計算審計、搜尋替代方案、應用配置的門檻並保存結果。語言模型在啟用時,僅限於起草文字。離線模式使用確定性範本。證據不依賴於措辭。
我將同樣的邊界應用於面向申請人的理由陳述。對於被拒絕的合成記錄,精確的線性模型特徵歸因識別出排名前三的負面貢獻因素。通知起草者必須引用這些特徵。有根據的備用通知通過了該狹窄的檢查,而未指明任何特徵的通用理由代碼則未通過並轉至人工審查。評審員僅驗證特徵的依據性,不確立完整的 FCRA 合規性或法律充分性。
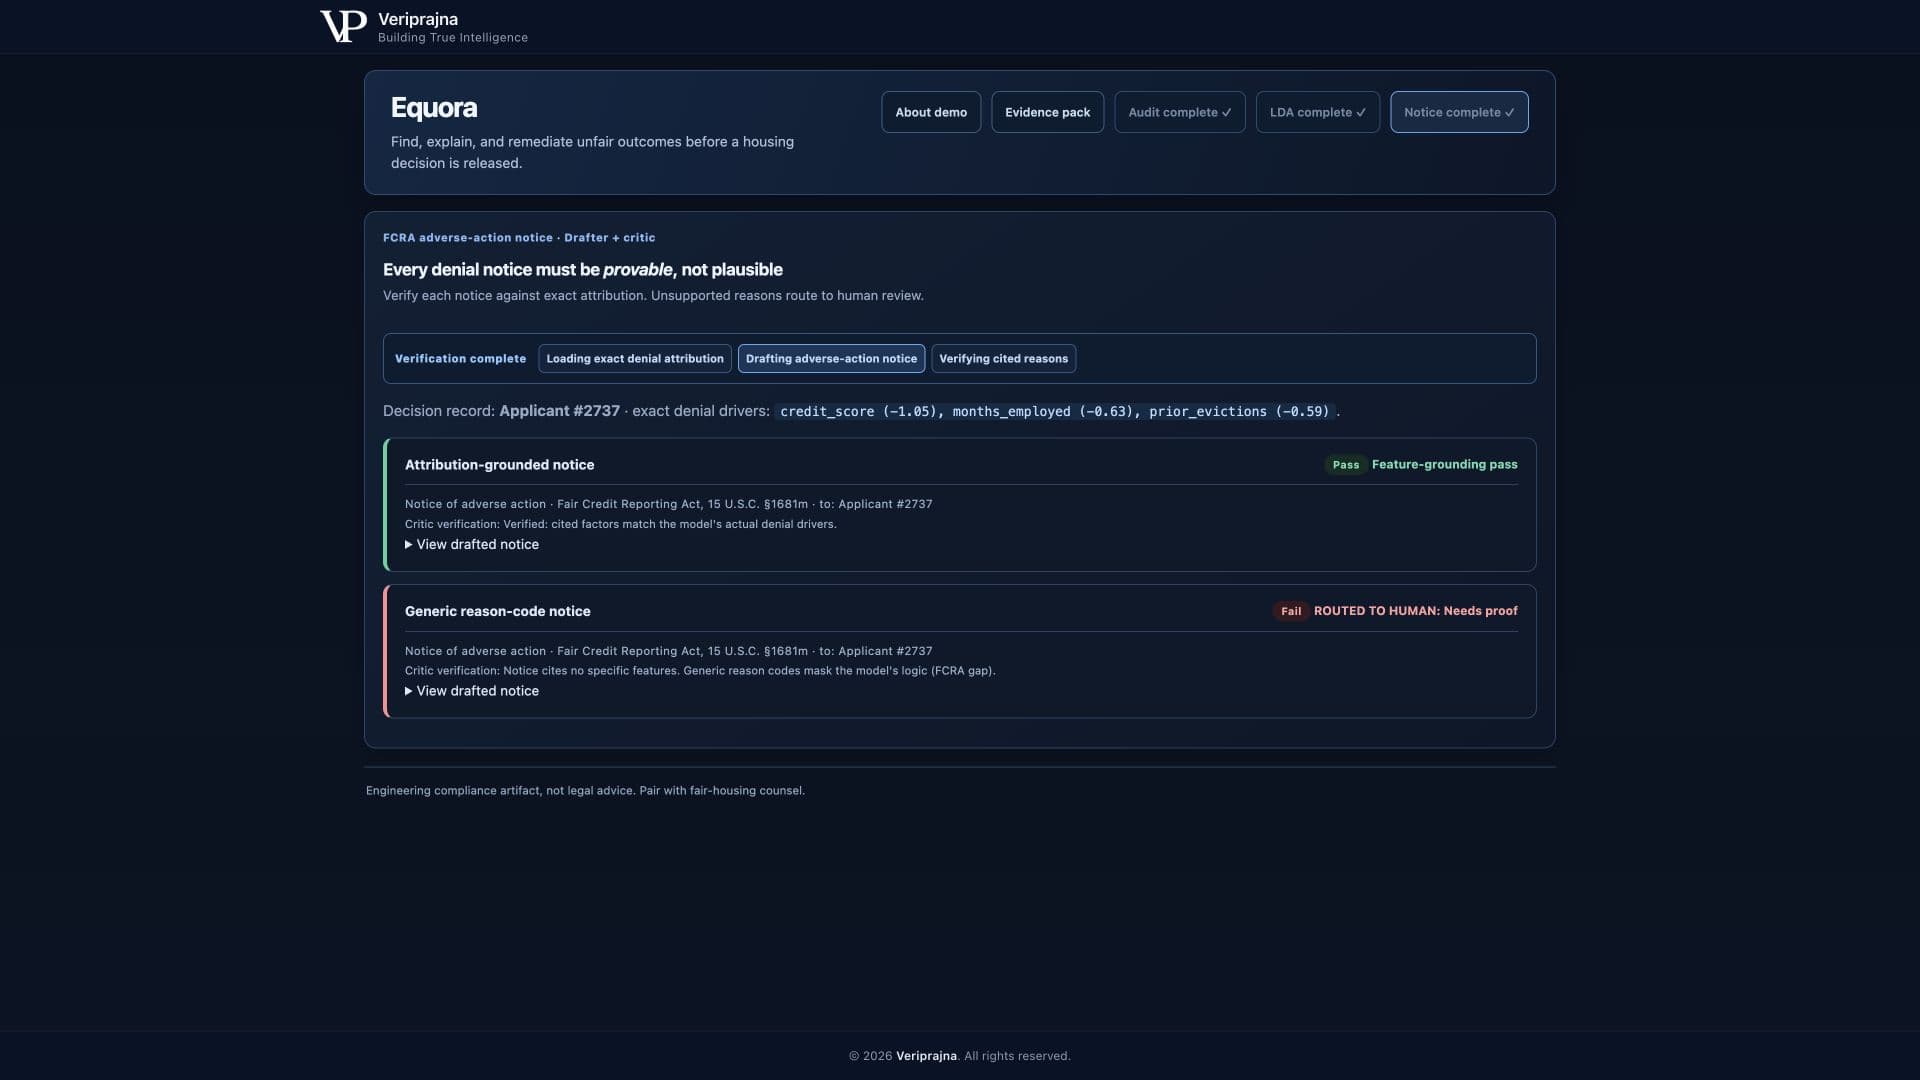
這與搜尋相鄰,而非第二個論點。一旦團隊選擇了替代方案,證據仍必須進入決策記錄和從中發佈的任何說明。若最後一哩路可以捏造理由,可重現的搜尋便失去其治理價值。
我希望在審查室中保留的人工製品
我現在以不同的方式想像審查會議。我不想像有人展示紅色分數並要求會議室接受改善模型的廣泛承諾。我想像一位審查員打開有界網格,查看在相同篩選率下的每個候選方案,檢查 Pareto 前沿,並追溯所選結果回到配置規則。
我希望記錄同時顯示收益和成本。在此,這意味著搜尋後最低 DIR 為 0.875,AUC 為 0.7788,並附有旁邊的基準值。我也希望系統保留被拒絕的替代方案,並在無合格方案時返回無安全替代方案。強制性建議將抹去最重要的可能結果。
完整的操作說明可在Equora 住房 AI 合規詳解中找到。它展示了審計、有界最低歧視性替代方案搜尋、取捨視圖和證據交接。它仍是建立在合成數據基礎上的工程示範,並非生產決策系統或法律建議。
如果您希望看到工作流程而非閱讀我的描述,這裡是創辦人從頭到尾的操作示範。
我從紅色指標開始,因為那是最顯而易見的顯示內容。最終我確信,更有價值的人工製品是從紅色結果到有界選擇的可重現路徑,包括路徑以無合格選擇告終的可能性。審計能告訴團隊停下來。搜尋記錄則能顯示他們在決定如何推進之前所審查的內容。