KI-Einstellungs-Compliance über sechs Rechtsregime

Ein einzelner Audit-Durchlauf, sechs auf Rechtsordnungen zugeschnittene Deliverables und ein Punkt, an dem zwei Rechtsregime nicht gleichzeitig erfüllt werden können.

Clarion ist ein Compliance-Overlay, das auf den KI-Einstellungstools aufsetzt, die ein Arbeitgeber bereits betreibt. Es liest einen einzigen Scoring-Export eines Anbieters ein, berechnet jede Adverse-Impact-Statistik in deterministischem Code und fächert dieses einzelne Audit in sechs Deliverables auf, die auf NYC, Colorado, Illinois, Texas, Kalifornien und die EU zugeschnitten sind. Wo zwei dieser Rechtsregime gegensätzliche Anforderungen an dasselbe Merkmal stellen, benennt es dies und quantifiziert beide Risiken, statt „vollständig konform“ auszugeben. Was folgt, ist eine Demonstration anhand eines initialisierten synthetischen Exports, keine bereitgestellte Pipeline.

6

Rechtsprechungs-Deliverables aus einem einzigen Audit-Lauf

NYC, Colorado, Illinois, Texas, Kalifornien, EU

9 von 13

Verpflichtungen an einen namentlich benannten Menschen weitergeleitet, nicht automatisch freigegeben

7 NEEDS PROOF plus 2 CONFLICT beim initialisierten Export der Demo

1

Konflikt, über den sich das Gate nicht hinwegtäuschen lässt

Illinois HB 3773 gegenüber EU AI Act Article 10(3)

Der Datensatz ist synthetisch: ein initialisierter Export von „Acme Logistics, Inc.“ mit 1,040 Kandidaten für die Stellenausschreibung REQ-2026-0412, bewertet von drei simulierten Tools. Die Scorer im Stil von Workday-Spotlight, HireVue und Eightfold sind Archetypen, die über Test-Fixture-Adapter bereitgestellt werden, keine Integrationen, und kein echter Arbeitgeber oder Kandidat taucht darin auf.

Sechs Regulierungsbehörden haben denselben Einstellungs-Stack geprüft und sechs strukturell unterschiedliche Fragen gestellt.

Ein CHRO, General Counsel oder Chief Risk Officer, der automatisierte Einstellungstools in zwei oder mehr Rechtsordnungen unter NYC, Colorado, Illinois, Texas, Kalifornien und der EU einsetzt, unterliegt mit einem einzigen Stack sechs separaten Rechtsregimen. Die Anbieter dieses Stacks übergeben ein einziges Audit mit dem Tenor „wir haben die Vier-Fünftel-Regel bestanden“, als ob damit alle sechs erledigt wären. Das ist nicht der Fall. Die NYC Local Law 144 verlangt intersektionale Impact-Ratios. Colorado SB 24-205 fordert ein dokumentiertes Reasonable-Care-Programm und spezifiziert keinerlei Methodik. Texas TRAIGA weist Disparate Impact als eigenständige Grundlage zurück und fragt nach der Absicht, was die genauen Statistiken des NYC-Deliverables für das texanische beweistechnisch irrelevant macht. Der EU AI Act fragt, ob Ihre Trainingsdaten repräsentativ sind, und stützt sich genau auf das geografische Merkmal, das Illinois als Proxy verbietet.

Die meisten Audits existieren überhaupt nicht

Forscher, die nach veröffentlichten Bias-Audits nach Local Law 144 suchten, fanden diese bei lediglich 4.6% von 391 NYC-Arbeitgebern – ein Befund, den sie als Null Compliance bezeichneten (Cornell / Data & Society / Consumer Reports, FAccT 2024). Die Veröffentlichung des Audits ist die sichtbare Hälfte der Pflicht, und der Großteil dieser Stichprobe hatte sie nicht erfüllt.

Die Durchsetzung verschärft sich zusehends

Der NY State Comptroller stellte in derselben Stichprobe von 32-company 17 potenzielle Verstöße gegen die Local Law 144 fest, in der das DCWP lediglich einen gefunden hatte, und das DCWP erklärte sich bereit, zu einer proaktiven Durchsetzung überzugehen (NY State Comptroller, December 2, 2025). Die Lücke zwischen einem bestandenen Anbieter-Audit und einem gerichtsfesten Nachweis ist genau der Punkt, an dem diese Durchsetzung ansetzt.

Ein Bias-Audit deckt nicht das gesamte rechtliche Risiko ab

Die Selbsteinstufung des Anwendungsbereichs, ADA-Barrierefreiheit bei Videointerviews und FCRA-Pflichten bei nachteiligen Maßnahmen sind separate Rechtstheorien, die ein bestandenes Bias-Audit nie geprüft hat. Mobley v. Workday, D.K. v. Intuit/HireVue und Kistler v. Eightfold werfen jeweils eine davon auf, und keine ist rechtskräftig entschieden.

Die Zahlen und Urteile sind in deterministischem Code festgelegt, und das Agententeam, das sie narrativ aufbereitet, hat auf keines von beiden Zugriff.

Die Pipeline ist kurz und die Arbeitsteilung darin strikt. Ein AEDT-Export eines Anbieters wird in ein kanonisches Datensatzschema normalisiert, eine deterministische Engine berechnet jede Statistik, sechs Regelpakete für die Rechtsregime und ein Policy-Gate entscheiden über jede Verpflichtung, ein Agententeam verfasst den Fließtext, und der Durchlauf versiegelt ein hash-verkettetes Pre-Audit-Paket. Agenten beraten, Code entscheidet – was gewährleistet, dass die Ausgabe unabhängig von den Stärken oder Schwächen des zugrundeliegenden Modells einreichungsfähig bleibt.

01 / DER DETERMINISTISCHE VERTRAUENSKERN

Jede Statistik außerhalb des Agenten-Frameworks berechnet

Eine numpy-Engine berechnet marginale Vier-Fünftel-Impact-Ratios, intersektionale Verhältnisse nach Rasse und Geschlecht mit Benjamini-Hochberg-FDR-Kontrolle, Proxy-Erkennung für geschützte Klassen mittels Cramér's V, einen kontrafaktischen Flip geschützter Attribute über ein transparentes logistisches Regressionssurrogat, eine ASR-Wortfehlerraten-Disparität auf dem Video-Subset und ein FCRA-Trigger-Prädikat. Gleicher Input, gleicher Output, bei jedem Durchlauf.

02 / SECHS REGELPAKETE UND DAS POLICY-GATE

Vier Urteile, in reinem Code entschieden

Jedes Regime weist seine eigene Gesetzesstelle, sein Inkrafttretensdatum und das geforderte Deliverable-Format auf, und jede Verpflichtung löst sich in PASS, FAIL, NEEDS PROOF oder CONFLICT auf. Das Gate ist der einzige Bereich, auf den das Sprachmodell keinen Zugriff hat, sodass eine noch so gut argumentierte Narration eine Verpflichtung niemals von NEEDS PROOF auf Grün verschieben kann.

03 / DAS AGENTENTEAM

Sechs Berichterstatter, ein Reconciler und ein Skeptiker

Sechs Jurisdiktions-Agenten formulieren die Begründung für das Urteil jedes Regimes, ein Conflict-Reconciler wandelt einen harten Konflikt in ein rechtliches Strategie-Memo mit den Risiken jedes Pfads um, und ein adversarieller Skeptiker versucht jedes behauptete Pass zu widerlegen und leitet unklare Punkte an die menschliche Prüfung weiter. Das Team ist anbieterunabhängig austauschbar; ist kein Provider konfiguriert, greift es auf deterministische Vorlagen zurück und die Anwendung läuft vollkommen identisch.

04 / DAS PRE-AUDIT-PAKET

Ein Paket, geschaffen für die Unterzeichnung durch Dritte

Der Durchlauf versiegelt ein mit SHA-256 hash-verkettetes Bündel aus 17 nodes, von denen jeder seine Eingabedaten, seine Berechnung und sein Regelzitat sowie einen Link zum Hash des vorherigen Knotens enthält, sodass jede Änderung die Kette bricht. Es wird als JSON und als druckbares HTML-Auditoren-Paket exportiert, und die Kette wird bei jedem Durchlauf verifiziert und durch Unit-Tests auf Manipulationssicherheit geprüft.

Die Konsole besteht aus zwei Ansichten und interaktiven Klick-Dialogen statt aus einem einzelnen Dashboard. Manual Testing enthält die Phasenleiste, den Live-Trace der Audit Execution und das Kandidaten-Board. Run Benchmark, das deaktiviert bleibt, bis Run Audit abgeschlossen ist, schaltet um auf Benchmark Results: drei Kacheln mit den Angaben Jurisdiction Deliverables 6, Lowest Impact Ratio 0.65 und Items Requiring Human Action 9, die sechs Zeilen der Jurisdiction Deliverables, eine Schaltflächenleiste für Supporting Evidence und Export Pre-Audit Package in der Kopfzeile.

Alles darunter öffnet sich als Dialog. Selection-Rate Analysis, das Conflict Register und die Human Proof Queue sind die drei Schaltflächen für Supporting Evidence, und die Verpflichtungen sowie die Audit-Narration jedes Regimes öffnen sich aus der jeweiligen Deliverable-Zeile. Nichts wird zu einem einzigen Score zusammengefasst, da ein einzelner Score über sechs unterschiedlich formulierte Fragestellungen hinweg niemals zutreffen kann.

Das Audit des Anbieters besteht. Das Audit, das das Gesetz tatsächlich vorschreibt, scheitert – auf denselben Daten.

Die Demo auditiert einen initialisierten synthetischen Export von 1,040 Kandidaten für die Stellenausschreibung REQ-2026-0412, bewertet von drei simulierten Anbieter-Tools. Der darin enthaltene Verstoß ist gezielt platziert und reproduzierbar, damit die Engine ein konkretes Problem aufdecken kann. Hier ist, was der Durchlauf auf dem Bildschirm anzeigt, in der genauen Reihenfolge des Ablaufs.
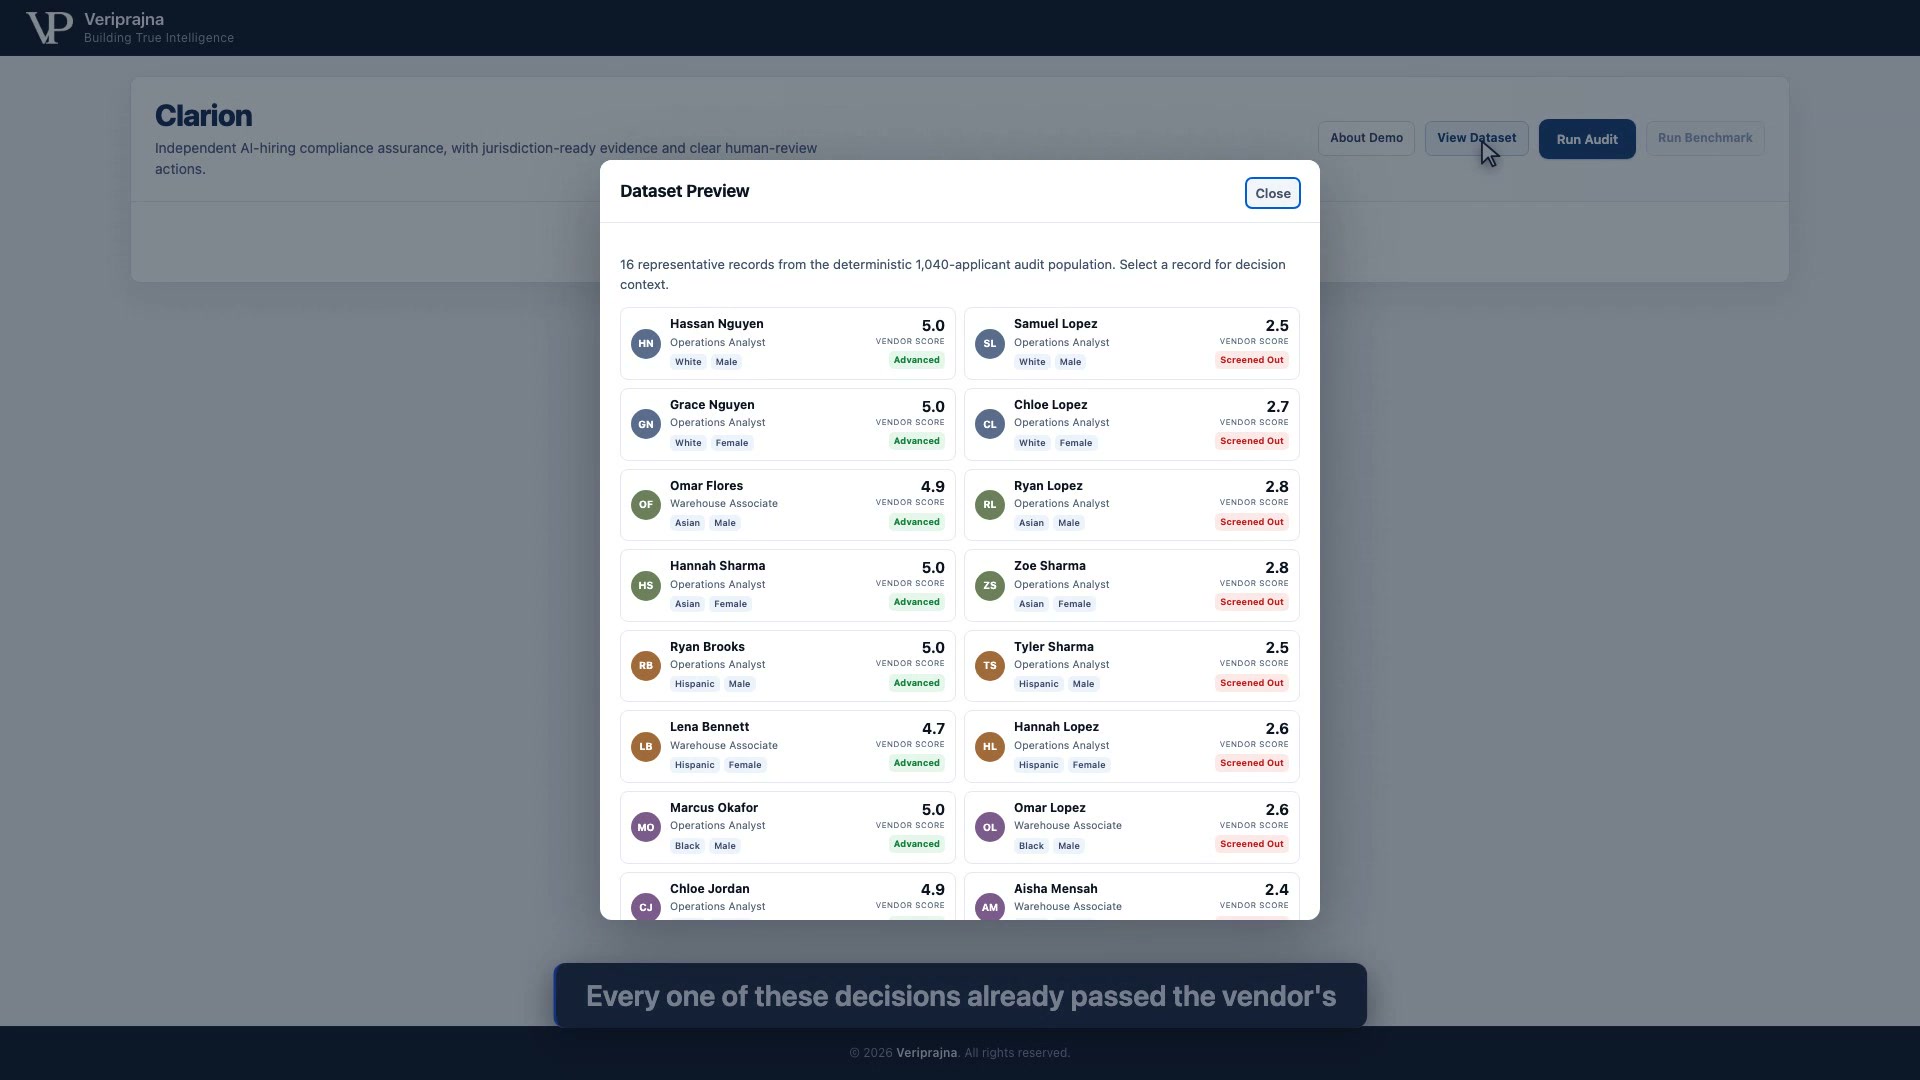
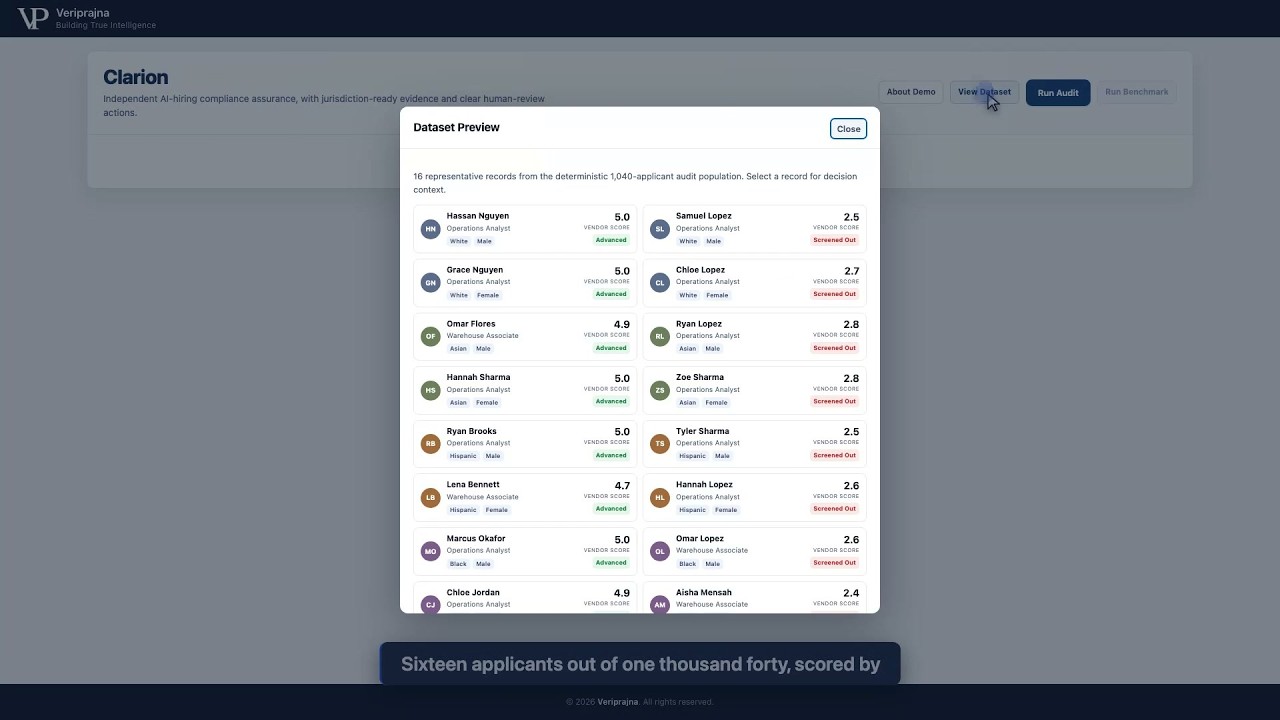
Die Clarion-Konsole mit geöffnetem Dataset Preview-Dialog über der Anwendungsleiste, der 16 repräsentative Datensätze aus der vom Dialog als deterministische 1,040-applicant audit population bezeichneten Gruppe auflistet, die initialisiert und synthetisch ist. Jede Karte zeigt einen Namen, eine Rolle wie Operations Analyst oder Warehouse Associate, Kohorten-Tags für Rasse und Geschlecht, einen Anbieter-Score und eine grüne Advanced- oder rote Screened Out-Entscheidung. Die Steuerelemente in der Kopfzeile lauten About Demo, View Dataset, Run Audit und ein ausgegrautes Run Benchmark.
Was angezeigt wird, bevor ein Audit startet. View Dataset öffnet 16 repräsentative synthetische Datensätze, die jeweils eine Entscheidung darstellen, die ein Anbieter-Tool bereits getroffen hat: einen Score sowie ein Weiterkommen oder eine Ablehnung. Hier erscheinen keine Impact-Ratios, da die Anwendung vor dem Durchlauf kein Selbst-Audit des Anbieters anzeigt. Das gesamte Audit operiert auf diesem einen normalisierten Export, und Clarion bewertet oder rangiert Kandidaten niemals selbst.
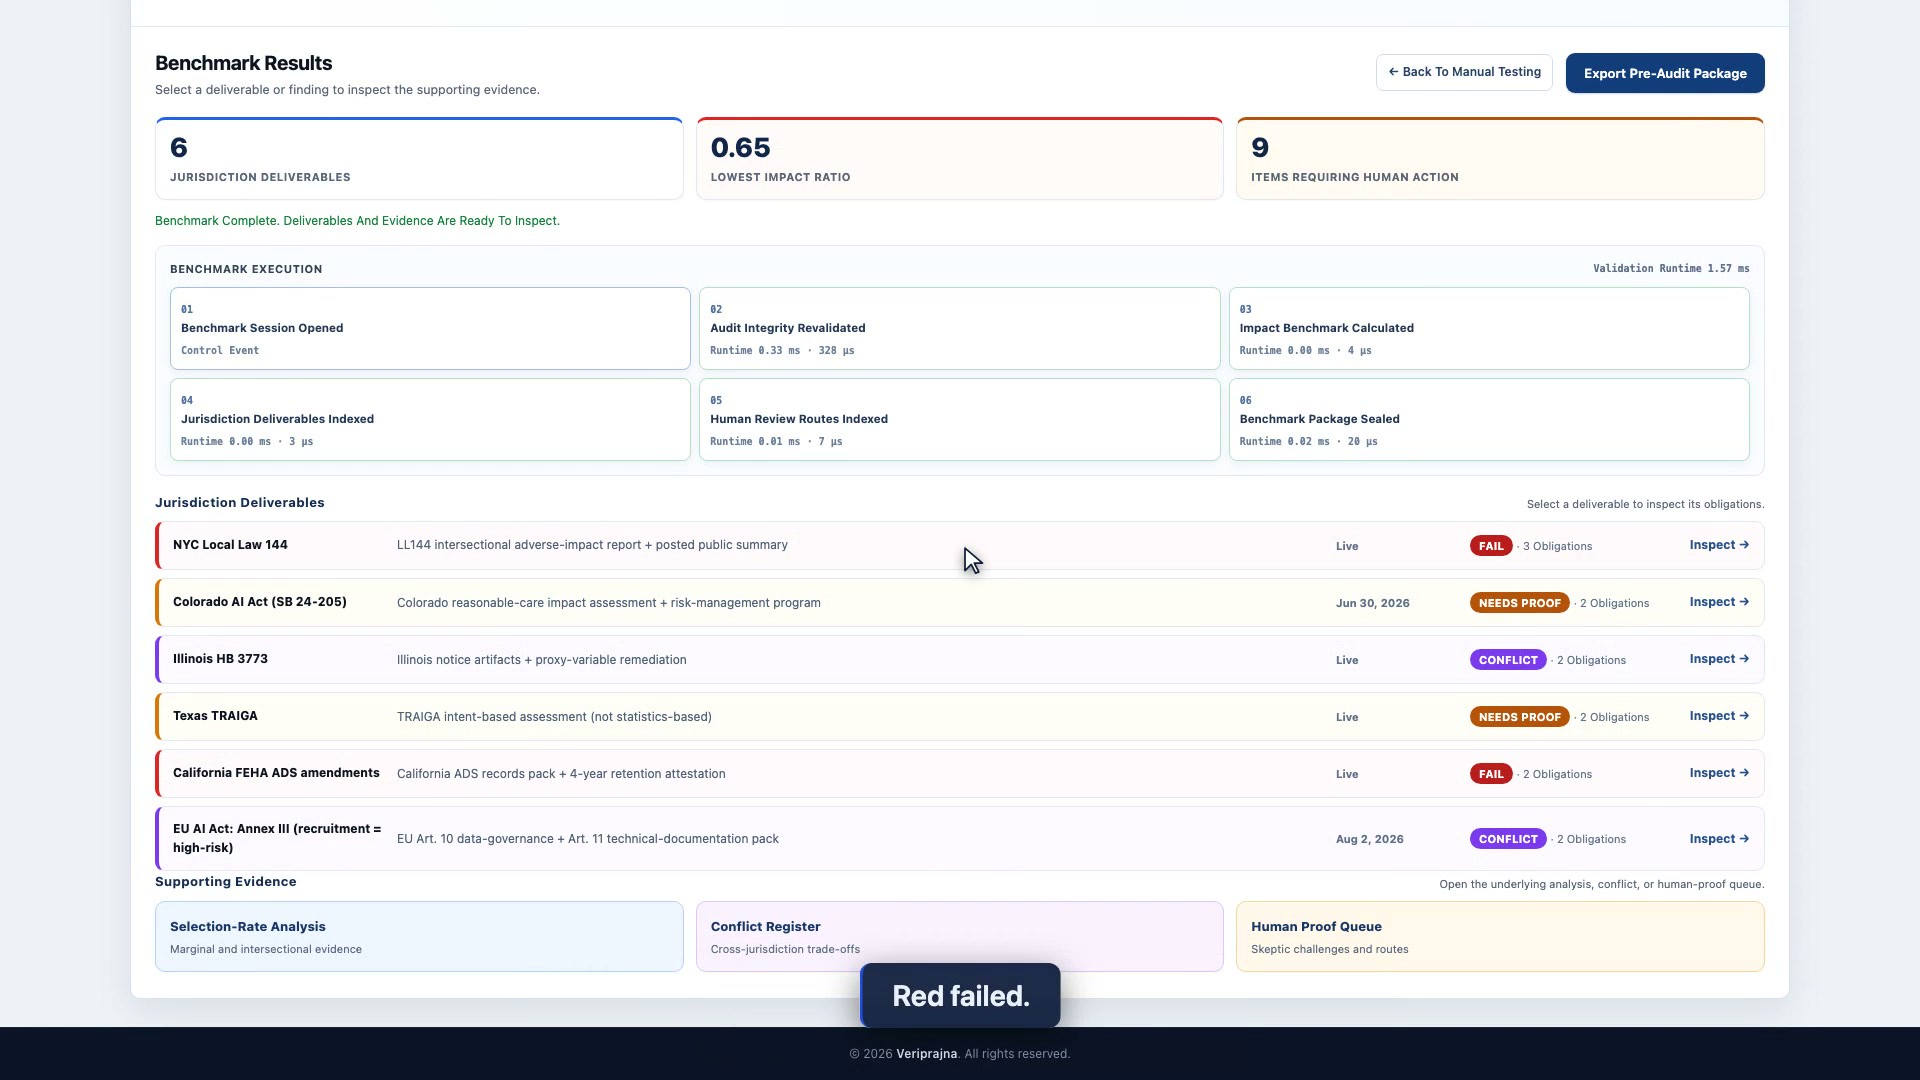
Clarions Ansicht Benchmark Results. Drei Kacheln zeigen Jurisdiction Deliverables 6, Lowest Impact Ratio 0.65 und Items Requiring Human Action 9. Unter einem sechsstufigen Trace der Benchmark Execution lauten sechs Zeilen für Jurisdiction Deliverables: NYC Local Law 144 Live FAIL mit 3 Verpflichtungen, Colorado AI Act SB 24-205 effective Jun 30 2026 NEEDS PROOF mit 2, Illinois HB 3773 Live CONFLICT mit 2, Texas TRAIGA Live NEEDS PROOF mit 2, California FEHA ADS amendments Live FAIL mit 2 und EU AI Act Annex III effective Aug 2 2026 CONFLICT mit 2. Eine darunter liegende Supporting Evidence-Zeile bietet Selection-Rate Analysis, Conflict Register und Human Proof Queue.
Ein Audit, sechs Formate, keine Reihe grüner Haken. Jede Zeile enthält ihr eigenes Gesetzeszitat, das Inkrafttretensdatum und das geforderte Deliverable-Format: einen Bericht über intersektionalen Adverse Impact für NYC, ein Reasonable-Care-Impact-Assessment für Colorado, Benachrichtigungsartefakte und Proxy-Remediation für Illinois, ein absichtsbasiertes Assessment für Texas, ein Datensatzpaket mit einer vierjährigen Aufbewahrungsbescheinigung für Kalifornien und ein Paket nach Article 10 und Article 11 für die EU. Über diese sechs Deliverables verteilen sich 13 Verpflichtungen: 2 PASS, 2 FAIL, 7 NEEDS PROOF und 2 CONFLICT.
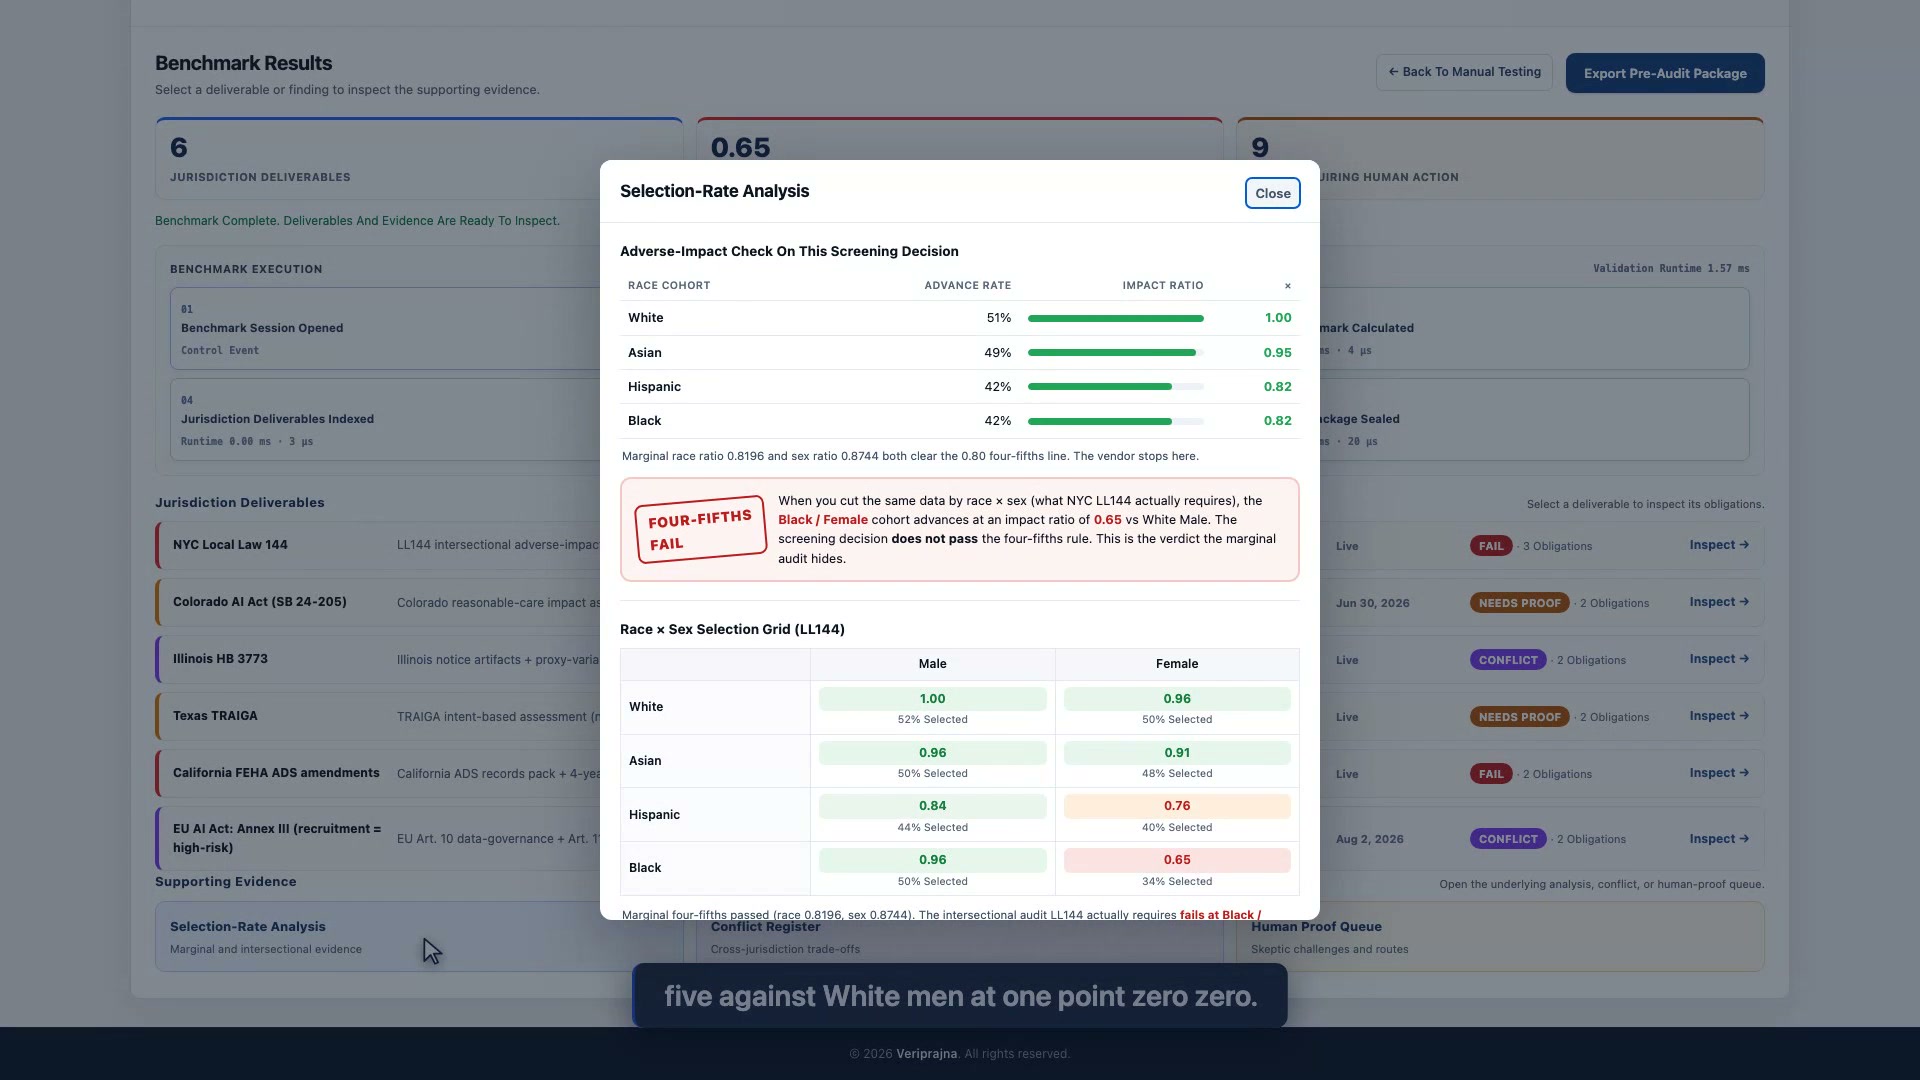
Clarions Dialog Selection-Rate Analysis. Eine Adverse-Impact-Rate-Card weist für White eine Weiterleitungsquote von 51% und eine Impact-Ratio von 1.00 aus, für Asian 49% und 0.95, für Hispanic 42% und 0.82 sowie für Black 42% und 0.82, begleitet von einer Zeile, die besagt, dass die marginale Rassen-Ratio 0.8196 und die Geschlechter-Ratio 0.8744 beide die 0.80-Vier-Fünftel-Grenze überschreiten und der Anbieter hier stoppt. Ein roter FOUR-FIFTHS FAIL-Stempel daneben erläutert, dass eine Aufteilung derselben Daten nach Rasse und Geschlecht die Kohorte Black / Female bei 0.65 gegenüber White Male einordnet. Das darunter liegende Race × Sex Selection Grid (LL144) zeigt White Male 1.00, White Female 0.96, Asian Male 0.96, Asian Female 0.91, Hispanic Male 0.84, Hispanic Female 0.76 in Gelb, Black Male 0.96 und Black Female 0.65 in Rot bei 34% Ausgewählten.
Der Wendepunkt. Der marginale Vier-Fünftel-Test besteht tatsächlich mit 0.8196 für Rasse und 0.8744 für Geschlecht. Das ist das Audit, das ein Selbstbericht des Anbieters liefert, und es besteht wirklich. Teilt man dieselben Zeilen nach Rasse und Geschlecht auf, wie es die Local Law 144 verlangt, so rücken in der Zelle Black / Female 44 of 130 mit einer Impact-Ratio von 0.6471 gegenüber der Referenzzelle White / Male vor. Unter Benjamini-Hochberg-FDR-Kontrolle bei alpha 0.05 ist nur diese Zelle bei q = 0.0185 statistisch robust; Hispanic / Female wird bei 0.7647 markiert, jedoch bei q = 0.1629 nicht als signifikant eingestuft. Die Disparität ist gezielt platziert und synthetisch, und die Fähigkeit der Engine, einen robusten Befund von einem Zufallstreffer zu unterscheiden, kann ein rein marginales Audit prinzipiell nicht leisten.
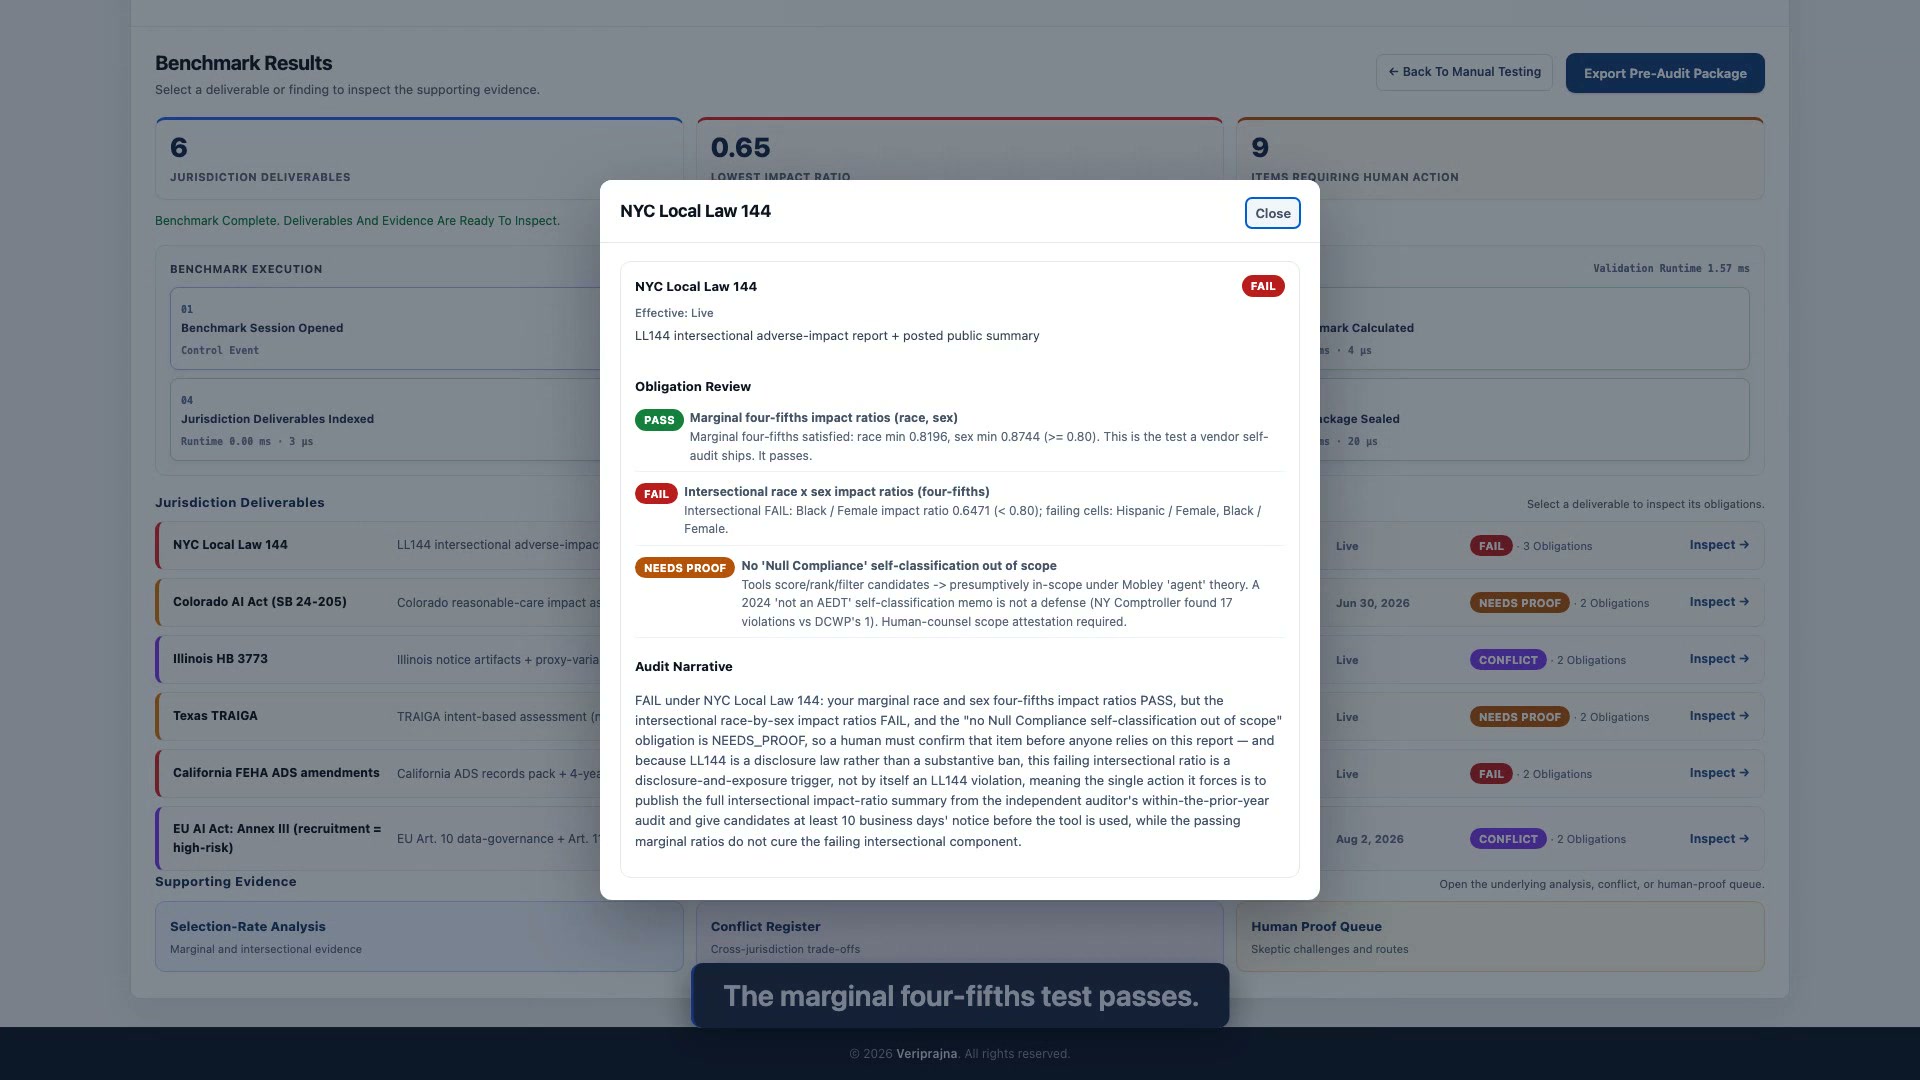
Clarions NYC Local Law 144-Dialog, als FAIL und Live gekennzeichnet, für das Deliverable des Berichts über intersektionalen LL144-Adverse-Impact nebst veröffentlichter öffentlicher Zusammenfassung. Dessen Obligation Review führt die marginalen Vier-Fünftel-Impact-Ratios als PASS mit einem Rassen-Minimum von 0.8196 und einem Geschlechter-Minimum von 0.8744 auf, die intersektionalen Rassen-nach-Geschlecht-Impact-Ratios als FAIL mit einer Black / Female-Impact-Ratio von 0.6471 und den durchfallenden Zellen Hispanic / Female sowie Black / Female, und einen NEEDS PROOF-Punkt zur Selbsteinstufung des Anwendungsbereichs, der eine anwaltliche Bescheinigung durch einen Menschen erfordert. Eine darunter stehende Audit-Narration erläutert die Zusammenfassung.
Jedes Urteil schlüsselt sich in seine Verpflichtungen auf. Die NYC-Zeile ist ein Deliverable, das drei Verpflichtungen mit drei unterschiedlichen Status umfasst: Die marginalen Ratios weisen PASS bei 0.8196 und 0.8744 auf, die intersektionalen Ratios FAIL bei 0.6471, und die Anwendungsbereichsfrage verbleibt auf NEEDS PROOF, bis ein namentlich benannter Mensch sie beantwortet. Die Zeile führt alle drei Status nebeneinander, anstatt sie zu einem einzigen zu verschmelzen, sodass ein PASS beim marginalen Test niemals den intersektionalen Test ersetzt, den LL144 tatsächlich verlangt.
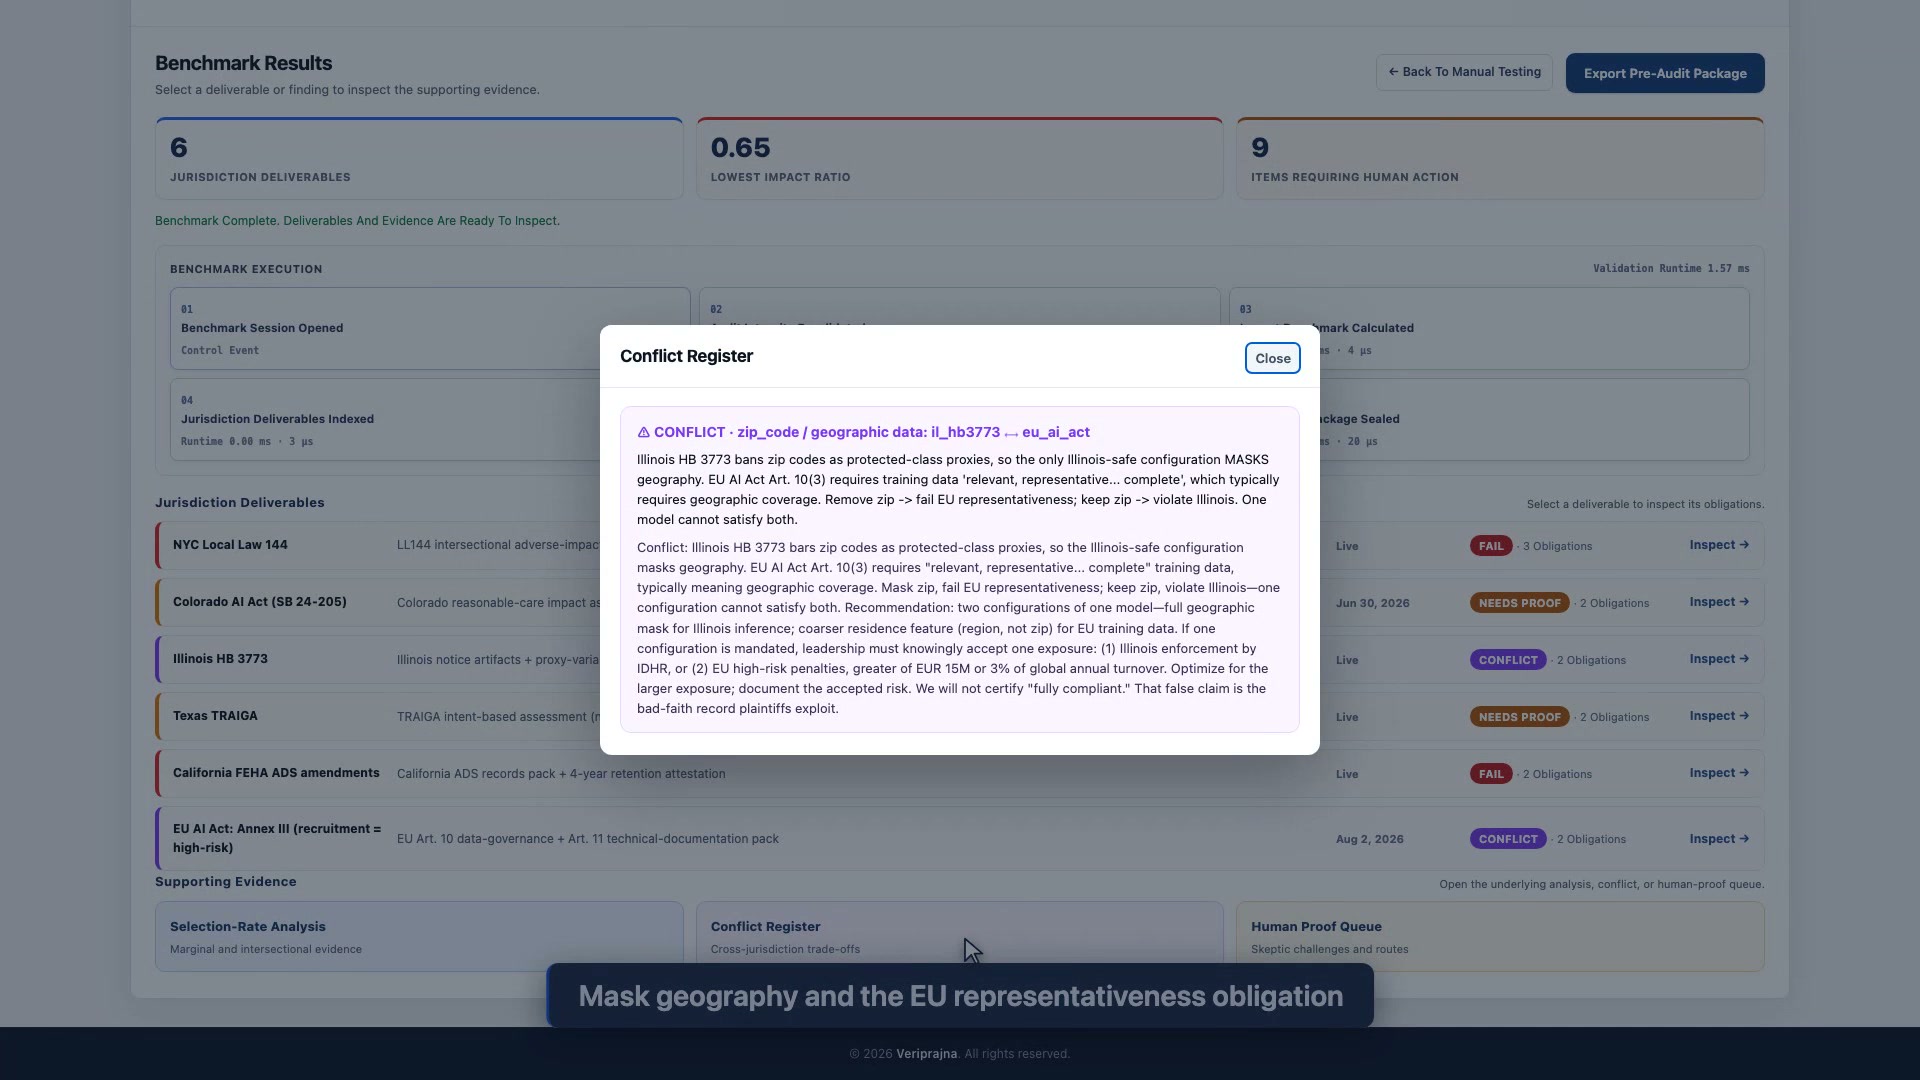
Clarions Conflict Register-Dialog, der CONFLICT für zip_code und geografische Daten zwischen il_hb3773 und eu_ai_act meldet. Der Text erläutert, dass Illinois HB 3773 Postleitzahlen als Proxys für geschützte Klassen verbietet, sodass die Illinois-konforme Konfiguration geografische Merkmale maskiert, während der EU AI Act Article 10(3) relevante, repräsentative und vollständige Trainingsdaten verlangt, was typischerweise eine geografische Abdeckung erfordert – das Entfernen der Postleitzahl verfehlt somit die EU-Repräsentativität, während ihre Beibehaltung gegen Illinois verstößt. Eine Empfehlung schlägt zwei Konfigurationen eines Modells vor oder das bewusste Akzeptieren und Dokumentieren eines Risikos, und stellt klar, dass das System keine Bestätigung als „fully compliant“ ausstellen wird.
Der Konflikt, über den es sich nicht hinwegtäuschen lässt. Die Engine ermittelte für zip_region, vom Conflict Register als zip_code / geographic data bezeichnet, im Verhältnis zur Rasse ein Cramér's V von 0.3321, was über dem Schwellenwert von 0.2 liegt, und stufte school_tier im selben Durchlauf mit 0.0711 als unbedenklich ein – sie schlägt also nicht bei jedem Merkmal blind Alarm. Illinois verbietet den Proxy; die EU-Repräsentativität verlangt dieselbe Geografie. Eine einzige Modellkonfiguration kann nicht beides erfüllen, weshalb das Gate CONFLICT ausgibt und der Reconciler stattdessen das Strategie-Memo verfasst: zwei Deployment-Konfigurationen oder ein wissentlich akzeptiertes und dokumentiertes Risiko, wobei die Strafen für EU-Hochrisikosysteme mit ihrem gesetzlichen Höchstmaß von bis zu 15 million euros oder 3% des weltweiten Jahresumsatzes beziffert werden (je nachdem, welcher Betrag höher ist).
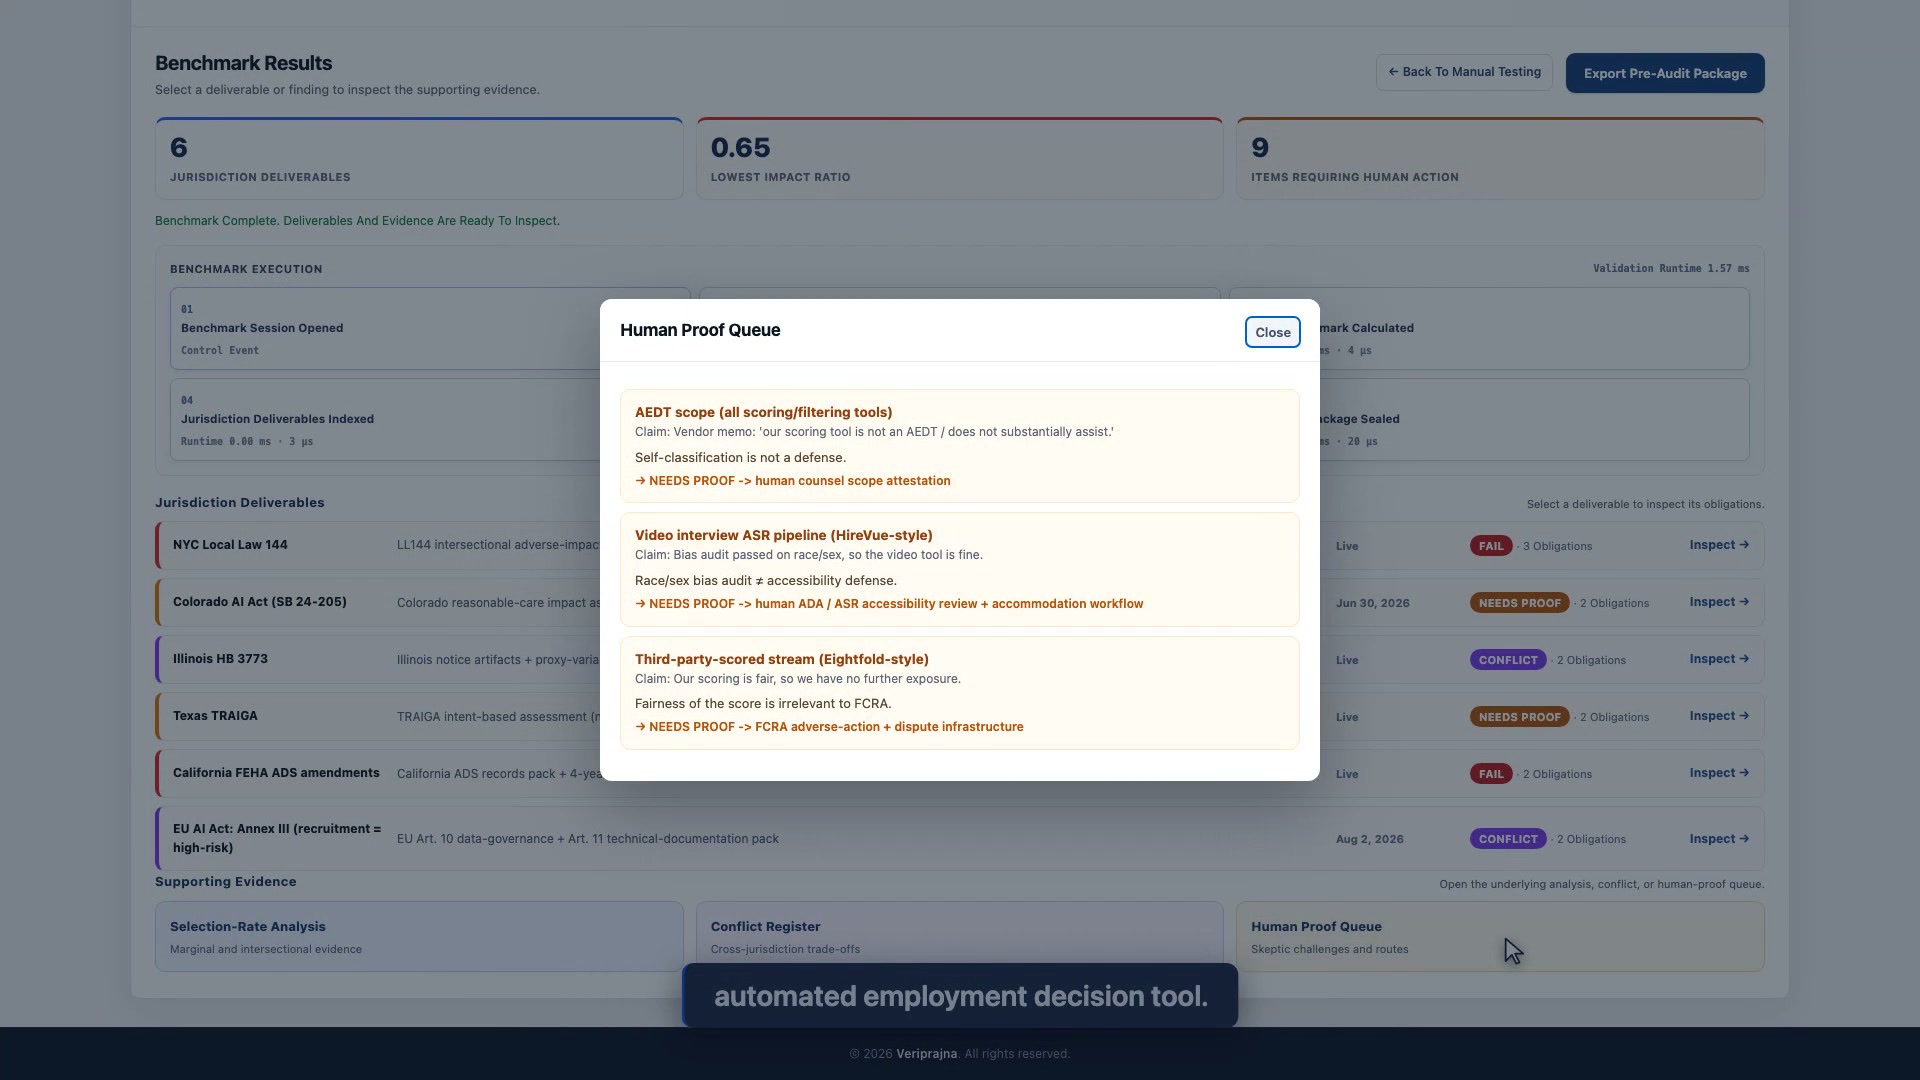
Clarions Human Proof Queue-Dialog, der drei Prüfherausforderungen des Skeptikers aufführt: Den AEDT-Geltungsbereich für alle Scoring- und Filter-Tools gegen das Memo eines Anbieters, der behauptet, das Tool sei kein AEDT – beantwortet mit „Selbsteinstufung ist keine Rechtsverteidigung“ und weitergeleitet an eine anwaltliche Geltungsbereichsbescheinigung durch einen Menschen. Eine Videointerview-ASR-Pipeline im HireVue-Stil gegen die Behauptung, ein bestandenes Rassen- und Geschlechter-Bias-Audit decke dies ab – beantwortet mit „Rassen- und Geschlechter-Bias-Audit ersetzt keine Barrierefreiheitsprüfung“ und weitergeleitet an eine menschliche ADA- und ASR-Barrierefreiheitsprüfung nebst Unterbringungs-Workflow. Einen von Dritten bewerteten Datenstrom im Eightfold-Stil gegen die Behauptung, es bestehe kein weiteres Risiko – beantwortet mit „Fairness des Scores ist für den FCRA unerheblich“ und weitergeleitet an die Infrastruktur für FCRA-Adverse-Action und Streitbeilegung.
Drei Zurückweisungen, jeweils an einen namentlich benannten Menschen weitergeleitet. Bei den 432 Kandidaten der Video-Runde im initialisierten synthetischen Export liegt die Wortfehlerrate bei 0.0794 für Standard-Aussprache gegenüber 0.3016 für die 104 Kandidaten mit nicht-standardisierter Aussprache – eine 3.8-fache Disparität, die von der Local Law 144 überhaupt nicht geprüft wird. Unabhängig davon wurden 510 Kandidaten anhand von durch Dritte gescrapten Daten bewertet und nach einem numerischen Score gefiltert, was das FCRA-Prädikat auslöst: Handelt es sich bei der Plattform um eine Kreditauskunftei (Consumer Reporting Agency), steht jedem bewerteten Kandidaten eine Mitteilung über nachteilige Maßnahmen (Adverse-Action-Notice) und ein Streitbeilegungsverfahren zu, ungeachtet dessen, wie fair der Score sein mag. Clarion erkennt und routet beides. Der Workflow für Nachteilsausgleiche und das an die Kandidaten gerichtete Streitbeilegungsportal, die in diesen Weiterleitungen genannt werden, verbleiben beim Arbeitgeber und werden hier nicht von uns erstellt, und diese drei Prüfpunkte sind ein separates Objekt von den 9 Verpflichtungen, die als NEEDS PROOF oder CONFLICT gewertet werden.
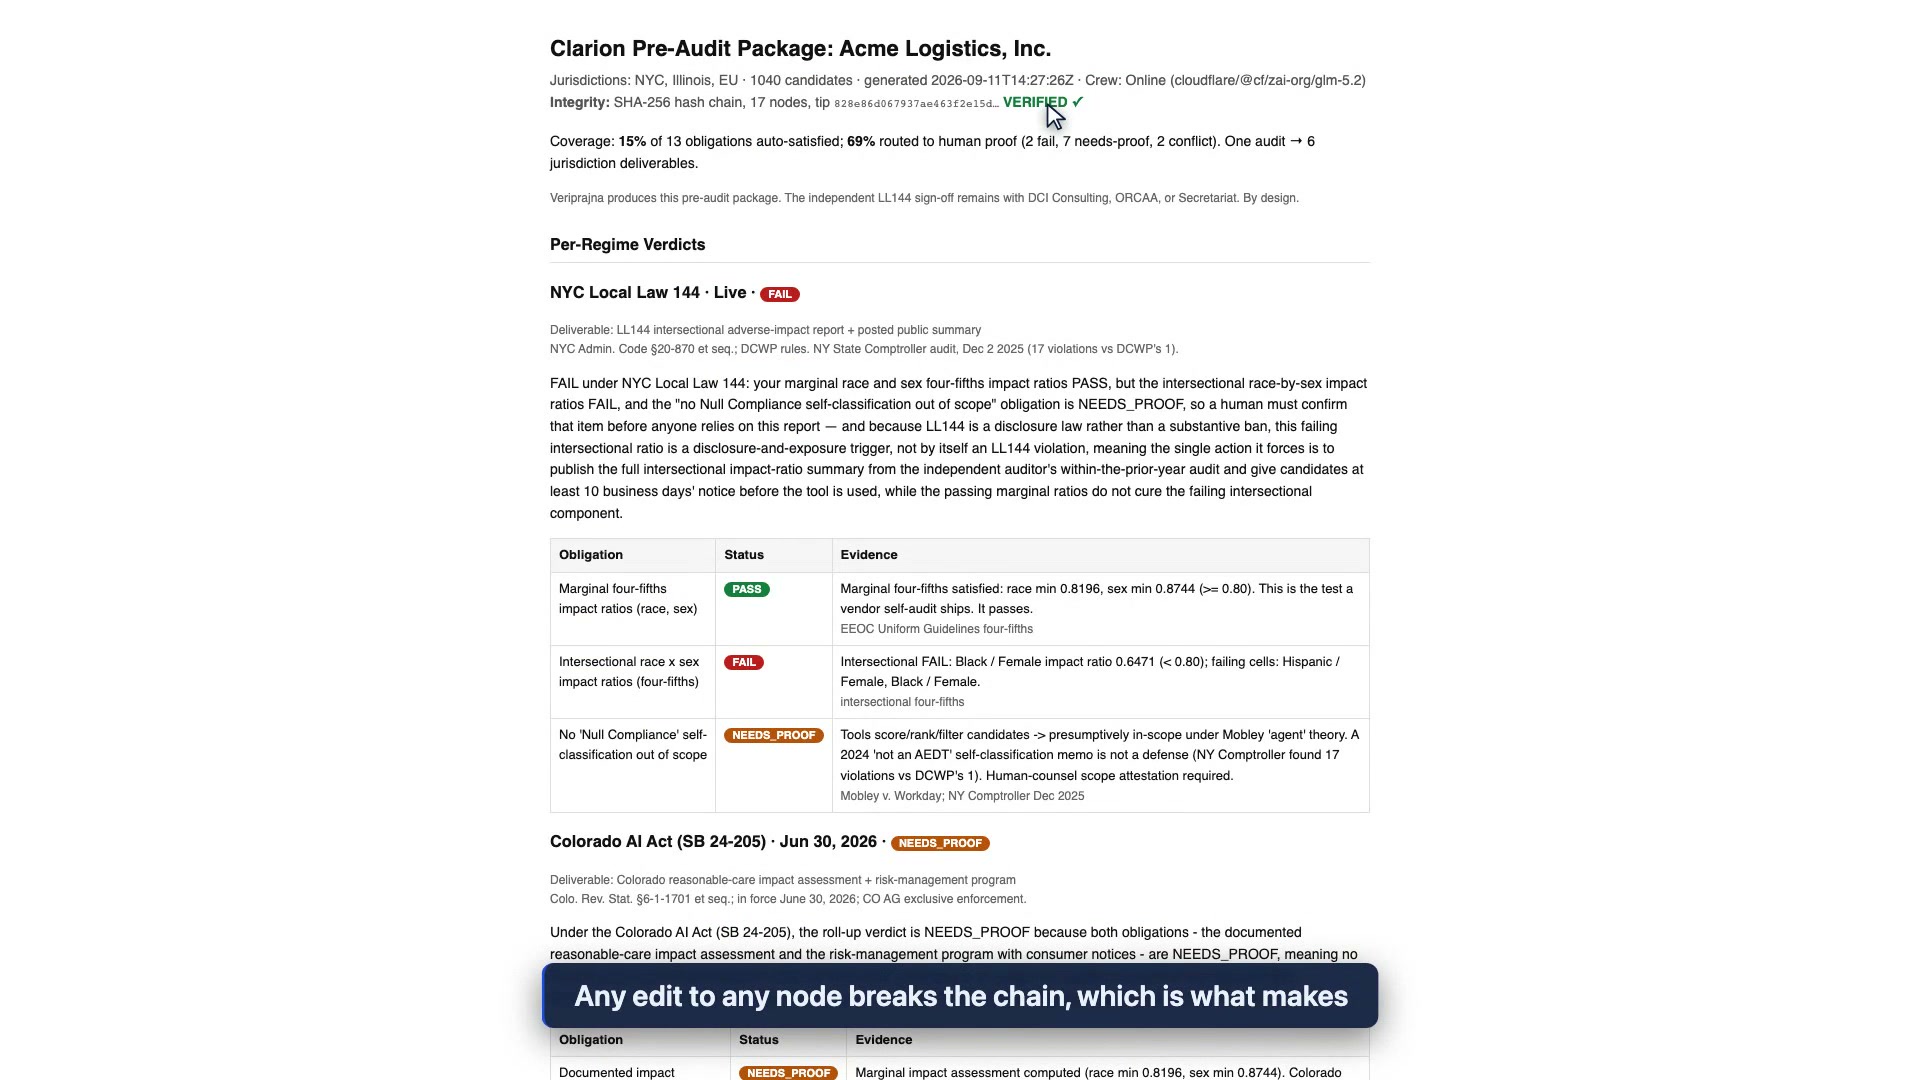
Das exportierte Clarion-Pre-Audit-Paket für Acme Logistics, Inc., das die Rechtsordnungen NYC, Illinois und EU über 1040 Kandidaten auflistet. Die Integritätszeile lautet SHA-256 hash chain, 17 nodes, mit einem Tip-Hash und einem grünen VERIFIED-Häkchen. Eine Abdeckungszeile besagt 15% of 13 obligations auto-satisfied und 69% routed to human proof, mit 2 fail, 7 needs-proof und 2 conflict, wobei ein einziges Audit 6 jurisdiction deliverables erzeugt. Ein Hinweis stellt klar, dass Veriprajna dieses Pre-Audit-Paket erstellt und die unabhängige LL144-Abnahme bei DCI Consulting, ORCAA oder Secretariat verbleibt. Darunter folgen Tabellen mit den Urteilen pro Rechtsregime.
Der Beleg. Export Pre-Audit Package gibt das Bündel als JSON und als dieses druckbare Auditoren-Paket aus: 17 hash-verkettete Knoten, deren Kette beim Durchlauf verifiziert wird, wobei jede Zahl ihre Berechnung und jedes Urteil sein Gesetzeszitat trägt. Die Abdeckungszeile weist 15% und 69% aus, was 2 automatisch erfüllten Verpflichtungen von 13 entspricht sowie den 9 von 13, die auf NEEDS PROOF oder CONFLICT stehen; die 2 FAIL-Verpflichtungen sind in keiner der beiden Zahlen enthalten. Das Paket hält bereits in seiner Kopfzeile fest, dass die unabhängige Abnahme nicht durch uns erfolgt.

Was diese Demo beansprucht – und was sie bewusst nicht beansprucht.

Jede Zahl auf dieser Seite beschreibt einen einzelnen, initialisierten synthetischen Export von 1,040 Kandidaten mit einem gezielt platzierten, reproduzierbaren Verstoß. Sie belegen, dass die Engine aufdeckt, was einem rein marginalen Audit entgeht. Sie stellen weder eine Genauigkeitsrate dar noch einen Benchmark gegenüber anderen Produkten und erheben keinen Anspruch bezüglich der Einstellungsdaten eines echten Arbeitgebers.

FrageWas Clarion in dieser Demo leistetWas außerhalb der Demo bleibt
AbdeckungEin einzelner Audit-Durchlauf erzeugt sechs auf die Rechtsordnungen zugeschnittene Deliverables über 13 Verpflichtungen hinweg, mit 2 PASS, 2 FAIL, 7 NEEDS PROOF und 2 CONFLICT.Ein Compliance-Zertifikat oder ein Fairness-Score. Das Gate ist so konzipiert, dass es ein solches verweigert.
Adverse ImpactMarginale und intersektionale Vier-Fünftel-Ratios mit Benjamini-Hochberg-FDR-Kontrolle, Proxy-Erkennung mittels Cramér's V und ein kontrafaktischer Flip, der die Weiterleitungswahrscheinlichkeit im Durchschnitt um 0.0574 und im Maximum um 0.1228 verschiebt.Jegliche Aussage über reale Einstellungsergebnisse. Die 1,040 Kandidaten, die Stellenausschreibung und die Disparität sind synthetisch und initialisiert.
AnbieterdatenLiest einen normalisierten AEDT-Export ein, der von Scorern im Workday-Spotlight-, HireVue- und Eightfold-Stil erzeugt und über Test-Fixture-Adapter bereitgestellt wird.Live-Konnektoren zu beliebigen ATS-, Assessment-Plattformen oder Match-Engines. Kein genannter Anbieter ist Kunde, Partner oder Referenzgeber.
Nachgelagerte MaßnahmenErkennt und routet den Befund zur ADA- und ASR-Barrierefreiheit sowie den FCRA-Adverse-Action-Trigger an einen namentlich benannten Menschen, inklusive beigefügter Beweise.Der CART-Unterbringungs-Workflow und das an die Kandidaten gerichtete Streitbeilegungsportal. Beide sind in der Demo simuliert und werden hier nicht von uns erstellt.
Formelle AbnahmeVersiegelt ein hash-verkettetes Pre-Audit-Paket mit 17 nodes, verifiziert beim Durchlauf und per Unit-Test auf Manipulationssicherheit geprüft, in JSON und druckbarem HTML.Das unabhängige Bias-Audit selbst. Diese Rolle obliegt Firmen wie DCI Consulting, ORCAA und Secretariat, nicht uns.

Was diese Demo NICHT leistet

Clarion zertifiziert keine Compliance – und diese Verweigerung ist beabsichtigtes Design. Es ist kein Einstellungsmodell und bewertet oder rangiert Kandidaten zu keinem Zeitpunkt. Der Datensatz ist synthetisch und initialisiert, die darin enthaltene Disparität bei Black / Female ist gezielt platziert, damit die Engine ein reales Problem aufdecken kann, und stellt keinen Befund über einen tatsächlichen Arbeitgeber dar; die dahinterliegenden Anbieter-Konnektoren sind Test-Fixture-Adapter, keine Live-Integrationen. Das Tool liefert Beweise für Unternehmensjuristen: Es erteilt keine Rechtsberatung und äußert sich nicht zur Haftung; Mobley v. Workday, D.K. v. Intuit/HireVue und Kistler v. Eightfold sind anhängige Klagen und Theorien, keine rechtskräftig entschiedenen Urteile. Gesetzliche Höchstgrenzen werden ausschließlich als Maxima zitiert, und es werden hier keine modellierten Haftungsbeträge ausgewiesen. Diese Seite ist eine Erläuterung mit Walkthrough-Video, echten Screenshots, der Funktionsweise und Antworten – keine Anwendung, die Sie von hier aus bedienen.

Was ein General Counsel fragt, bevor er eine Compliance-Schicht über den Einstellungs-Stack legt.

Unser Anbieter hat bereits ein Bias-Audit durchgeführt und bestanden. Warum sollten wir ein zweites benötigen?

Weil der Test, der bestanden wird, und der Test, den das Gesetz verlangt, nicht derselbe Test sind. Beim initialisierten synthetischen Export der Demo mit 1,040 Kandidaten besteht die marginale Vier-Fünftel-Prüfung mit einer minimalen Rassen-Impact-Ratio von 0.8196 und einer minimalen Geschlechter-Ratio von 0.8744 gegenüber der 0.80-Linie – und das ist das Audit, das ein Anbieter-Selbstbericht ausliefert. Die NYC Local Law 144 verlangt die intersektionalen Rassen-nach-Geschlecht-Ratios, und dort rücken in der Zelle Black / Female lediglich 44 of 130 bei einer Impact-Ratio von 0.6471 vor. Ein rein marginales Audit irrt sich bezüglich dieser Zelle nicht – es ist ihr gegenüber strukturell blind.

Sind Sie der Auditor? Können Sie unser Audit nach Local Law 144 offiziell abnehmen?

Nein. Veriprajna ist nicht der unabhängige Auditor – diese Rolle gehört Firmen wie DCI Consulting, ORCAA oder Secretariat. Clarion erstellt das Pre-Audit-Paket, ein hash-verkettetes Bündel, in dem jede Zahl ihre Berechnung und jedes Urteil sein Gesetzeszitat trägt, so aufgebaut, dass ein unabhängiger Auditor es ohne Umschreiben unterzeichnen kann. Das Ziel besteht darin, das System in einen Zustand zu versetzen, in dem das Audit nichts Beanstandenswertes mehr vorfindet.

Verbindet sich dies mit Workday oder HireVue? Wir ersetzen unseren Einstellungs-Stack nicht.

Es verbindet sich mit keinem von beiden, und Clarion bewertet oder stuft Kandidaten niemals selbst ein. Nichts in Ihrem Stack wird ersetzt. Es liest einen AEDT-Export des Anbieters ein und normalisiert ihn in ein kanonisches Datensatzschema. In dieser Demo sind die Anbieter-Konnektoren Test-Fixture-Adapter auf synthetischen Daten, und der Scorer im Workday-Spotlight-Stil, die Videorunde im HireVue-Stil und die Match-Engine im Eightfold-Stil sind Archetypen, keine Integrationen.

Hier ist ein LLM im Einsatz. Wie soll ich das einer Regulierungsbehörde vorlegen?

Jede Statistik, jeder Schwellenwertvergleich, jede Konfliktkante und das Hashing des Datenbündels befinden sich in deterministischem Code außerhalb des Agenten-Frameworks. Die sechs Jurisdiktions-Agenten, der Conflict-Reconciler und der adversarielle Skeptiker verfassen Fließtext; sie berechnen niemals eine Zahl und können das Policy-Gate nicht überstimmen. Wenn kein Modell-Provider konfiguriert ist, greift das Team auf deterministische Vorlagen zurück und die Anwendung liefert dieselben Urteile – denn diese Urteile oblagen ohnehin nie dem Modell.

Was passiert, wenn zwei Regime gegensätzliche Anforderungen stellen? Wir brauchen eine Entscheidung, kein Achselzucken.

Sie erhalten den Zielkonflikt quantifiziert und schriftlich niedergelegt. In der Demo korreliert das Merkmal zip_region mit Rasse bei einem Cramér's V von 0.3321, was über der 0.2-Schwelle liegt, sodass Illinois HB 3773 es als verbotenen Proxy behandelt, während die Repräsentativitätsanforderung nach EU AI Act Article 10(3) dieselbe geografische Abdeckung verlangt. Das Gate gibt CONFLICT anstelle eines Passes aus, und der Reconciler verfasst ein Strategie-Memo: Nutzen Sie zwei Deployment-Konfigurationen oder akzeptieren und dokumentieren Sie wissentlich ein Risiko – unter dem Hinweis, dass die Strafen für EU-Hochrisikosysteme ein gesetzliches Höchstmaß von bis zu 15 million euros oder 3% des weltweiten Jahresumsatzes erreichen (je nachdem, welcher Betrag höher ist).

Neun von dreizehn Verpflichtungen erfordern einen Menschen. Bringt uns das tatsächlich eine Ersparnis?

Es automatisiert den Teil, dessen Automatisierung redlich ist. Beim synthetischen Export der Demo sind 2 of 13 Verpflichtungen automatisch erfüllt, 2 fallen glatt durch, und 9 werden als NEEDS PROOF oder CONFLICT an einen namentlich benannten Menschen weitergeleitet – mit bereits zusammengestellten Beweisen und beigefügtem Gesetzeszitat. Kein redliches System gibt bei diesen Daten alle dreizehn frei. Ein Dashboard, das dreizehn grüne Haken anzeigen würde, gäbe sie ohne Beweis frei – und genau dieses Dashboard ist das Beweisstück, das ein Kläger Ihnen vor Gericht vorhalten wird. Die Engine stuft zudem school_tier bei einem Cramér's V von 0.0711 als Nicht-Proxy ein, sie schlägt also keineswegs bei allem Alarm, was sie vorfindet.

Was übergeben wir dem Auditor am Ende tatsächlich?

Ein einziger Export erzeugt ein Pre-Audit-Paket als JSON und als druckbares HTML-Auditoren-Paket der Version 1 des veriprajna-pre-audit-package-Formats mit 17 nodes, deren Kette beim Durchlauf verifiziert wird. Jeder Knoten enthält seine Eingabedaten, seine Berechnung und sein Regelzitat sowie einen SHA-256-Link zum vorhergehenden Knoten, sodass jede Bearbeitung eines Knotens die Kette bricht. Daneben liegen die sechs Deliverables für die Rechtsordnungen, jeweils zugeschnitten auf das Gesetzeszitat, das Inkrafttretensdatum und das geforderte Format des jeweiligen Regimes.

Technische Forschung

Die Forschung hinter dieser Demo – die Architektur, das Verifizierungsdesign und die Enterprise-Blaupause.

Social

Auch veröffentlicht auf

Beginnen Sie mit den zwei Rechtsregimen, die Ihr Einstellungs-Stack möglicherweise nicht gleichzeitig erfüllen kann.

Wir sind ein KI-Engineering-Team, keine Zertifizierungsstelle für Compliance. Wir entwickeln die deterministische Schicht, die Statistiken berechnet, die von den einzelnen Regulierungsbehörden geforderten Deliverables erstellt und Widersprüche offen benennt, damit Unternehmensjuristen in voller Kenntnis der Risiken entscheiden können.

Ein sinnvolles erstes Gespräch ist konkret: Welche AEDT-Anbieter befinden sich in Ihrem Trichter, welchen der sechs Rechtsregime sind Sie tatsächlich ausgesetzt und welche Merkmale in diesen Modellen würden unter einem dieser Regime als Proxys für geschützte Klassen gelten. Wir können die Engine, die Regelpakete und das Pre-Audit-Paketformat gemeinsam mit Ihren HR-, Rechts- und Datenteams durchgehen.

AEDT-Expositionsbewertung

  • ✓ Anbieter-Tools, die Kandidaten bewerten oder filtern
  • ✓ Welche der sechs Rechtsregime Ihren Trichter betreffen
  • ✓ Merkmale, die sich wie Proxys für geschützte Klassen verhalten
  • ✓ Anwendungsbereichs-, ADA- und FCRA-Theorien, die ein Bias-Audit übersieht

Compliance-Overlay aufbauen

  • ✓ Deterministische Adverse-Impact-Engine
  • ✓ Regelpakete pro Regime und das Policy-Gate
  • ✓ Konfliktbeilegung und Weiterleitung zur menschlichen Prüfung
  • ✓ Hash-verkettetes Pre-Audit-Paketformat