La référence naïve de mon détecteur de chutes radar a atteint le même rappel de 1.0. Elle a aussi déclenché sept fausses alertes en une nuit.

Lors de la garde de nuit synthétique que j'ai conçue pour Vigil, la méthode de référence du commerce déclenche neuf alertes entre 02:00 et 06:00, et sept d'entre elles sont erronées. Un ventilateur de plafond, capté à une vitesse de pointe de 5.0 m/s. Un chien de thérapie, surface équivalente radar de 0.27. Un résident s'asseyant lourdement sur un siège à 2.92 m/s. Deux de ces neuf alertes sont de véritables chutes, et l'une d'entre elles se produit dans une salle de bains : un tracé de centroïde allant de 1.53 m debout, descendant par 1.07, 0.84, 0.625 et 0.344 avant de se stabiliser à 0.119 m, au niveau du sol, respiration présente, sans récupération.
Chaque événement de ce quart de travail est synthétique, étiqueté et ancré dans la physique, généré à partir d'une graine fixe, et j'ai écrit les deux détecteurs. C'est pourquoi je peux énoncer la vérité qui dérange en toute franchise. La méthode de référence a elle aussi détecté cette chute dans la salle de bains.
Vigil est la couche d'intelligence que j'ai conçue pour s'intercaler entre un flux de caractéristiques radar et un système d'appel infirmière en résidence pour personnes âgées. Elle renvoie ALERT, SUPPRESS ou ROUTE TO HUMAN, avec un motif associé à chaque décision qu'un établissement peut archiver. La route de démonstration est https://veriprajna.com/demos/smart-facility-fall-detection. J'ai commencé le développement en supposant que la difficulté consistait à voir la chute. Le banc d'essai m'a contredit dès la première exécution.
Le rappel était le chiffre que je voulais mettre en avant
J'ai exécuté le banc d'essai en m'attendant à ce que la sensibilité aux chutes fasse la une, et c'est un bon chiffre : un rappel de 1.0 pour la cascade sur un ensemble fixe de 360 événements synthétiques bruités et étiquetés. La colonne d'à côté est ce qui a changé l'article que je pensais écrire. La référence naïve repose sur deux clauses arithmétiques, tout mouvement rapide ou bas étant une chute (peak_v > 2.0 OR min_cz < 0.45), et sur ce même ensemble, elle atteint également un rappel de 1.0. La sensibilité est le terrain de jeu du marketing de la détection de chutes, et les deux détecteurs sont cloués à son sommet.
La démarcation se trouve entièrement dans la ligne que personne ne met sur une diapositive. La spécificité sur les facteurs de confusion est de 1.0 pour la cascade et de 0.167 pour la référence, soit un taux de fausses alertes de 0.833 par événement bénin. Projetez cela aux 30 déclenchements de mouvements bénins par chambre et par jour que suppose le banc d'essai, et la référence aboutit à 25.0 fausses alertes par chambre et par jour. La fourchette publiée pour les capteurs du commerce existants est de 5 à 15 fausses alertes par chambre et par jour, et la fatigue d'alarme, plutôt que la sensibilité des capteurs, est documentée comme la principale raison de l'échec de ces déploiements.
Je dois préciser ceci avant qu'un lecteur technique ne le fasse à ma place. Les poids de fusion dans data/fall_model.json ont été ajustés par tools/fit_fall_classifier.py sur les générateurs de scénarios propres à la démonstration, ces mêmes générateurs qui produisent l'ensemble de 360 événements. C'est l'objection la plus solide que l'on puisse opposer à mes deux 1.0, et c'est aussi pourquoi je me soucie davantage du 0.167 que de l'un ou l'autre d'entre eux. L'échec de la référence n'est pas un artefact de ma configuration d'entraînement. C'est ce qu'un seuil produit lorsque le monde contient des ventilateurs de plafond.
Les sept fausses alertes déterminent si quelqu'un écoute encore lorsque la véritable alerte survient.
Les facteurs de confusion ont été conçus pour mettre en échec une caractéristique unique
Mon premier réflexe a été d'améliorer le classifieur, et c'était le mauvais réflexe. Au début du développement, j'ai abordé cela comme un problème de discrimination : trouver la caractéristique qui sépare une chute d'une non-chute, lui donner un poids élevé, et passer à autre chose. Les générateurs de scénarios que j'avais déjà écrits rendaient cela délibérément impossible.
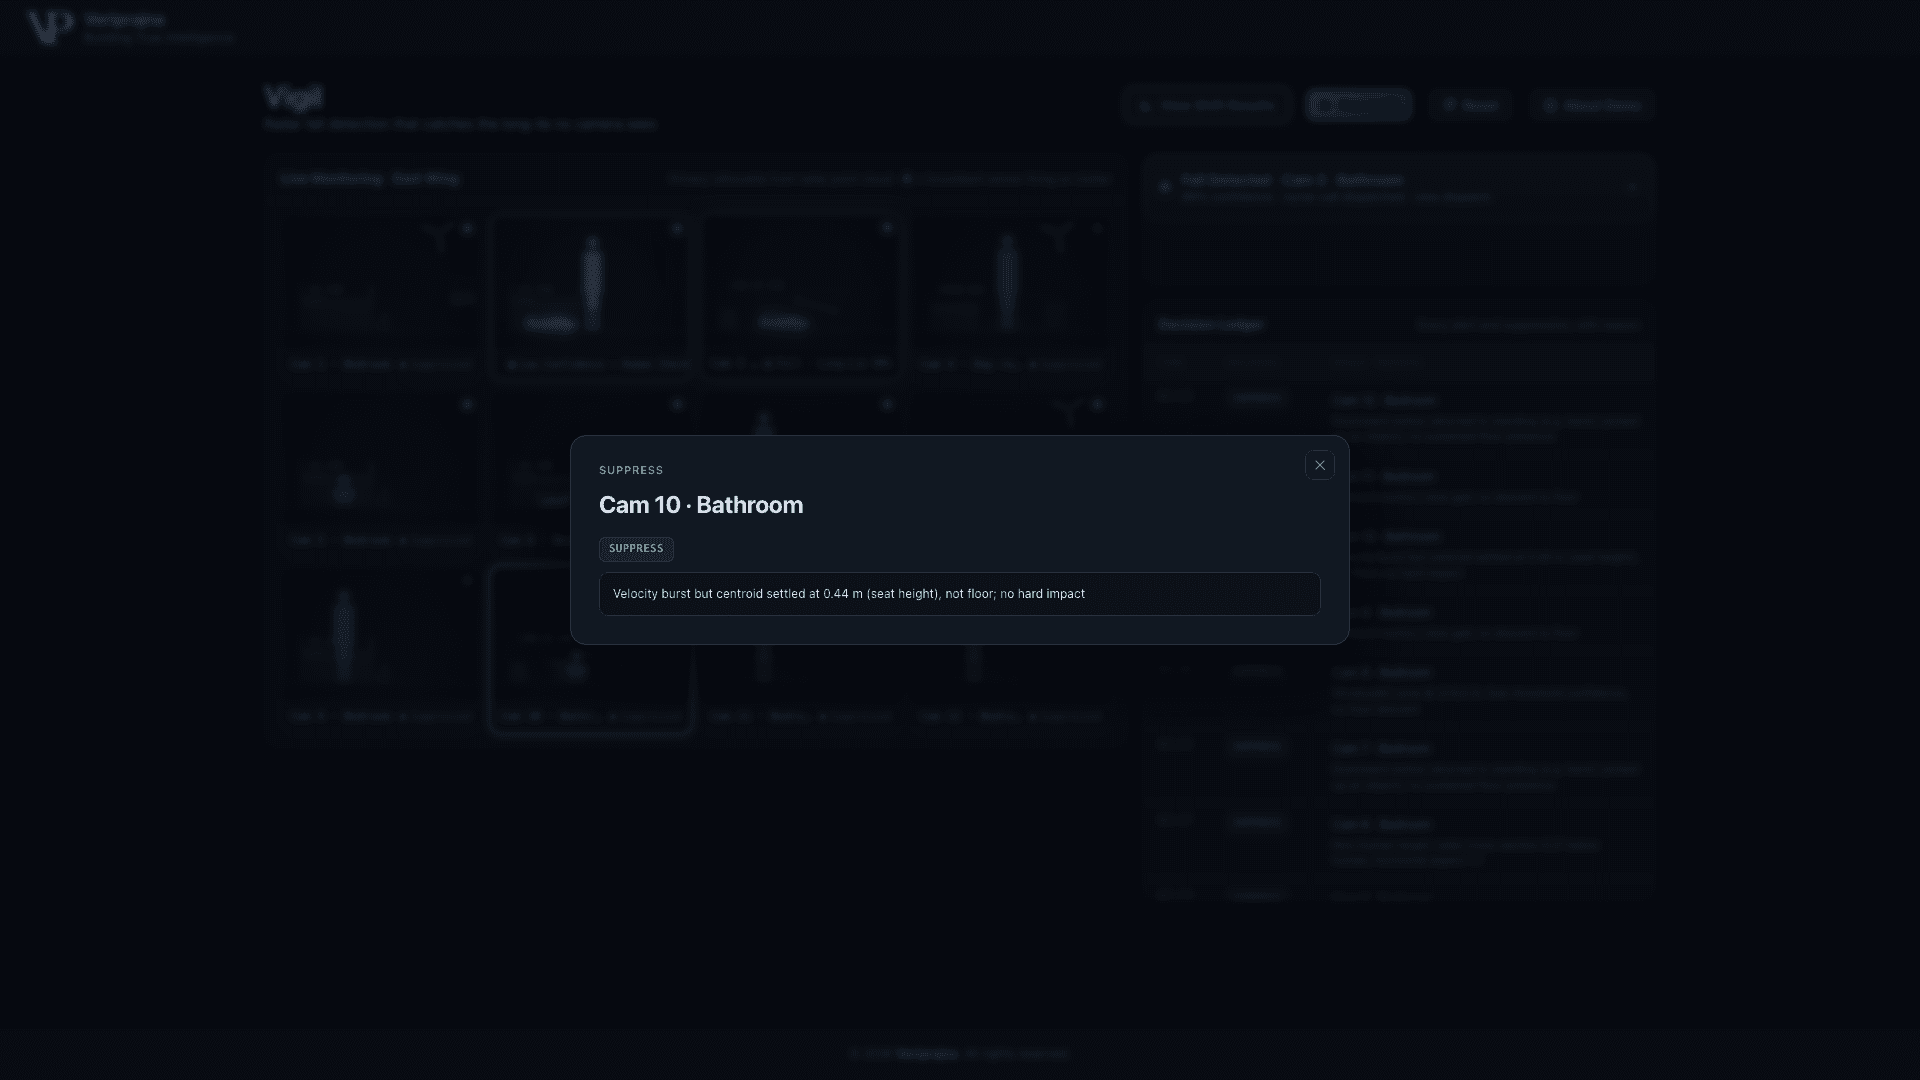
Chaque facteur de confusion est généré pour chevaucher une vraie chute sur une caractéristique individuelle. L'assise brutale à Cam 5 produit une pointe de vitesse de 2.92 m/s, de l'ordre de grandeur d'une chute, et se stabilise à 0.46 m. Son équivalent dans la salle de bains à Cam 10 culmine à 3.31 m/s et se stabilise à 0.44 m. Le chien de thérapie et le fait de se pencher pour ramasser une serviette abaissent tous deux le centroïde, ce qui correspond à l'autre moitié de la règle de référence. Tout test individuel que je pouvais écrire était mis en échec par construction, c'est pourquoi la référence est véritablement trompée à 0.167 plutôt que prise au piège d'un épouvantail conçu pour échouer.
La vitesse était la caractéristique dont j'étais le plus certain, et c'est celle qui n'a pas survécu dans le classifieur. Ce qui a survécu est un modèle logistique sur quatre caractéristiques : la proximité du sol, l'énergie d'impact, la baisse de descente et un indicateur de surface équivalente radar, fusionnés en un P(fall) calibré. Aucun terme de vitesse n'atteint P(fall). Une ligne obsolète subsiste encore dans la docstring du module, vestige de l'époque où je pensais qu'elle y figurerait. C'est du simple numpy, suffisamment concis pour que l'on puisse ouvrir classifier.py et en garder l'intégralité en tête, ce qui, sur un chemin critique pour la sécurité des personnes, a plus de valeur à mes yeux qu'un point d'AUC supplémentaire.
Je présente en premier la suppression de Cam 10, car le panneau expose l'ensemble du désaccord en une seule ligne.
Quatre conditions, une fenêtre unique de 8 secondes
J'ai écrit le vérificateur narratif temporel comme la pièce que j'aimerais lire en tant qu'observateur extérieur. temporal.py exige quatre conditions au sein d'une même fenêtre de 8 secondes, la position debout étant établie dans son premier cinquième : un centroïde médian supérieur à 1.2 m, une descente supérieure à 0.6 m combinée à une vitesse de pointe supérieure à 1.8 m/s quelque part dans la fenêtre, un impact large bande soutenu dont la moyenne mobile sur 3 trames dépasse 0.50, et le centroïde descendant effectivement en dessous de 0.30 m. Le test d'impact soutenu existe parce qu'un pic sur une seule trame est anodin, alors qu'un corps heurtant le sol ne l'est pas.
La chaîne de motif émise par l'application indique "standing → descent → impact → floor", ce qui correspond à la façon dont un infirmier lit un incident, mais l'implémentation applique un ET logique à ces conditions sur l'ensemble de la fenêtre au lieu d'imposer un ordre strict. Ce n'est pas une machine à états, et je préfère l'écrire moi-même plutôt qu'un ingénieur ne le découvre dans le code source en se demandant ce que le texte a pu éluder d'autre.
Ce n'est qu'ensuite que la porte logique ajoute la confirmation respiratoire supérieure à 0.20 et un indice de confiance de chute d'au moins 0.70. Ces trois valeurs, niveau du sol à 0.30 m, respiration à 0.20 et plancher de confiance de 0.70, résident en code brut en dehors de tout modèle. C'est l'ordre de priorité qui compte : les conditions déterministes doivent être réunies avant même de consulter le score du modèle, de sorte qu'un indice de confiance ne peut jamais fabriquer une alerte à lui seul. Un P(fall) plus faible peut toujours transformer un ALERT en un SUPPRESS, ce qui constitue la bonne asymétrie pour une couche autorisée à garder le silence mais pas à inventer. Un seuil déterminant supplémentaire se trouve en dehors de ce bloc documenté, une valeur codée en dur p_fall >= 0.40 dans gate.py capable de diriger un événement multi-occupant vers une vérification humaine sur la base du seul score du modèle. Je le mentionne car affirmer qu'il n'y a que « trois seuils documentés » serait trompeur.
Les suppressions constituent le registre qu'une inspection d'État exige réellement
J'ai construit le registre des décisions (Decision Ledger) avant de concevoir quoi que ce soit qui ressemble à un produit, car la question à laquelle je ne pouvais pas répondre n'a jamais été « l'avez-vous détectée ? ». C'était « pourquoi aucune alerte n'a-t-elle été déclenchée dans la chambre 203 à 2h13 ? », et la réponse doit déjà figurer dans un rapport écrit dès qu'on la pose. Dix des douze événements du quart de travail sont des suppressions, et chacun porte la valeur de caractéristique enregistrée correspondante : la cible non humaine de Cam 6 avec une surface équivalente radar de 0.27 contre un minimum humain de 0.55, les flexions de Cam 7 et Cam 12 où le centroïde s'arrête à 0.60 m et 0.59 m avec une énergie d'impact de 0.07 par rapport à un seuil de 0.50.
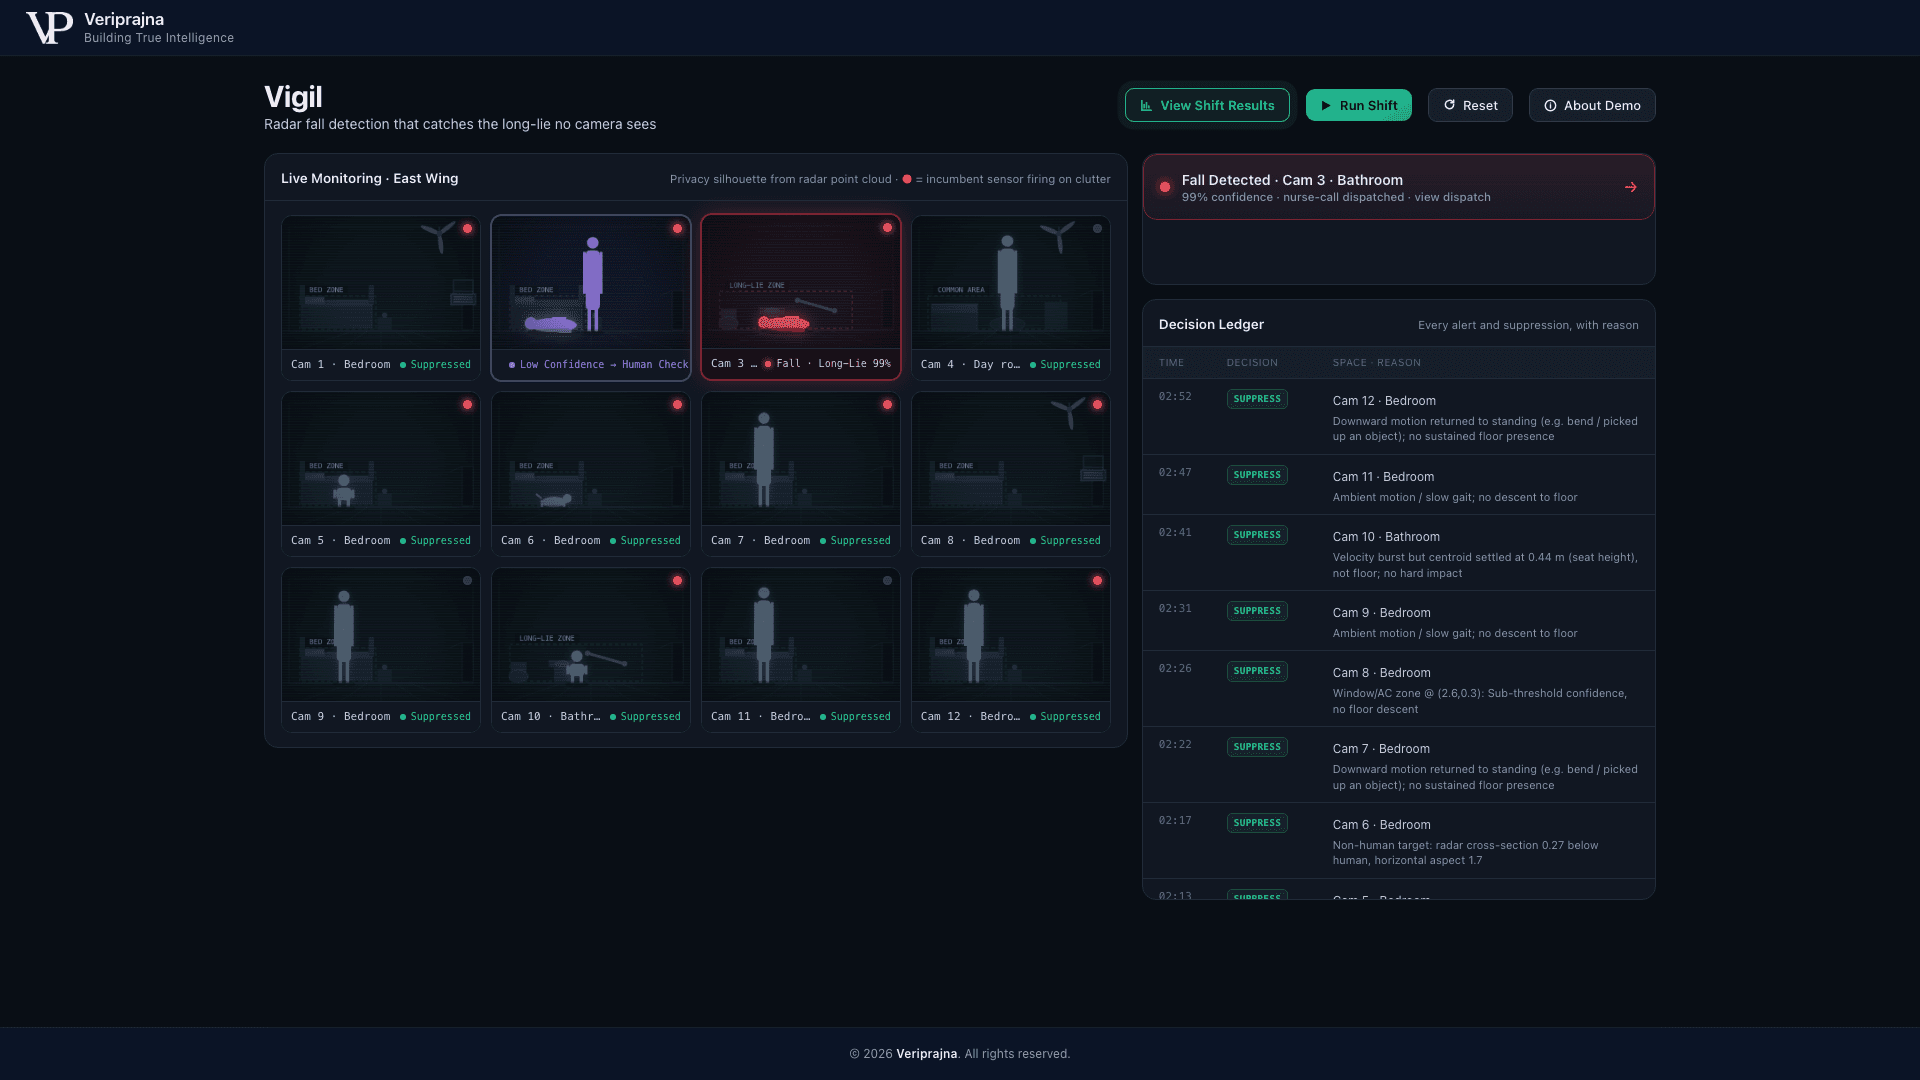
Ces dix lignes supprimées sont précisément ce sur quoi un inspecteur s'interroge, car ce sont les événements où rien ne s'est produit et où quelqu'un doit malgré tout expliquer pourquoi.
Seule une partie de l'étalonnage par chambre est réellement câblée dans une décision. Le ventilateur de plafond de Cam 1 est supprimé parce que la carte de fouillis de la chambre 214 comporte une entrée Doppler à emplacement fixe à (1.5, 1.5, 2.45 m) et check_clutter le masque au niveau de ce voxel. Ce cheminement est bien réel. Les hauteurs de siège et de lit par chambre dans rooms.json, 0.42 m dans la salle de bains de la chambre 118 et 0.45 m dans la chambre 203, ainsi que les indications de barres d'appui à côté, sont des données d'étalonnage qu'aucun chemin de code V1 ne lit ; la plage d'assise que j'utilise pour qualifier une assise brutale est un test global unique de 0.38 à 0.60 m. Il y a même la mention long_lie_sec: 180.0 comme clé dans ce fichier que rien ne consomme. L'étalonnage par chambre est le travail d'intégration facturé lors d'un déploiement réel, et dans cette version, seuls les masques Doppler sont reliés à une décision.
L'exportation est un JSON d'audit de quart de travail couvrant chaque alerte, acheminement et suppression avec ses valeurs de caractéristiques déterminantes et son motif de politique, ce qui correspond exactement aux attentes d'un classeur CMS F689 ou QAPI. La note clinique d'incident est rédigée séparément à partir de ces preuves structurées et affichée dans le panneau d'incident, et non au sein du JSON.
L'alerte que je l'ai laissé déclencher, et la chute que j'ai refusé de le laisser affirmer
J'ai délibérément situé le point culminant du quart de travail dans une salle de bains. C'est la pièce la plus à risque et le seul endroit où une caméra n'est pas une option envisageable : dix-neuf États américains ont promulgué des lois régissant les caméras dans les chambres d'établissements de soins pour personnes âgées, les autorisant généralement dans la chambre d'un résident avec son consentement, tandis que les salles de bains restent exclues dans la pratique pour des raisons de confidentialité. Les caractéristiques radar ne véhiculent aucune image, et c'est précisément la raison pour laquelle elles peuvent être déployées là où une caméra est exclue.
Cam 3 correspond à cet événement, et Vigil renvoie ALERT, catégorie long_lie, confiance 0.99, temps au sol 4.8 s, avec l'échelle d'escalade armée sur aide-soignant (CNA) immédiatement, infirmière référente à 90 s et directrice des soins (DON) à 180 s. Le texte du badge d'appel infirmière indique "Room 118B Bathroom: Fall Detected, 99% confidence. Resident on floor 5s. Breathing confirmed.". La transmission émet à la fois un signal traditionnel à contact sec Rauland et une charge utile MQTT/REST Ascom/Austco, tous deux transitant par un adaptateur journalisé fictif. Aucun matériel d'appel infirmière n'est raccordé à tout cela. La raison pour laquelle cela vaut malgré tout la peine d'être développé est la station prolongée au sol (long lie) : la moitié des personnes âgées qui restent au sol plus d'une heure décèdent dans les six mois.
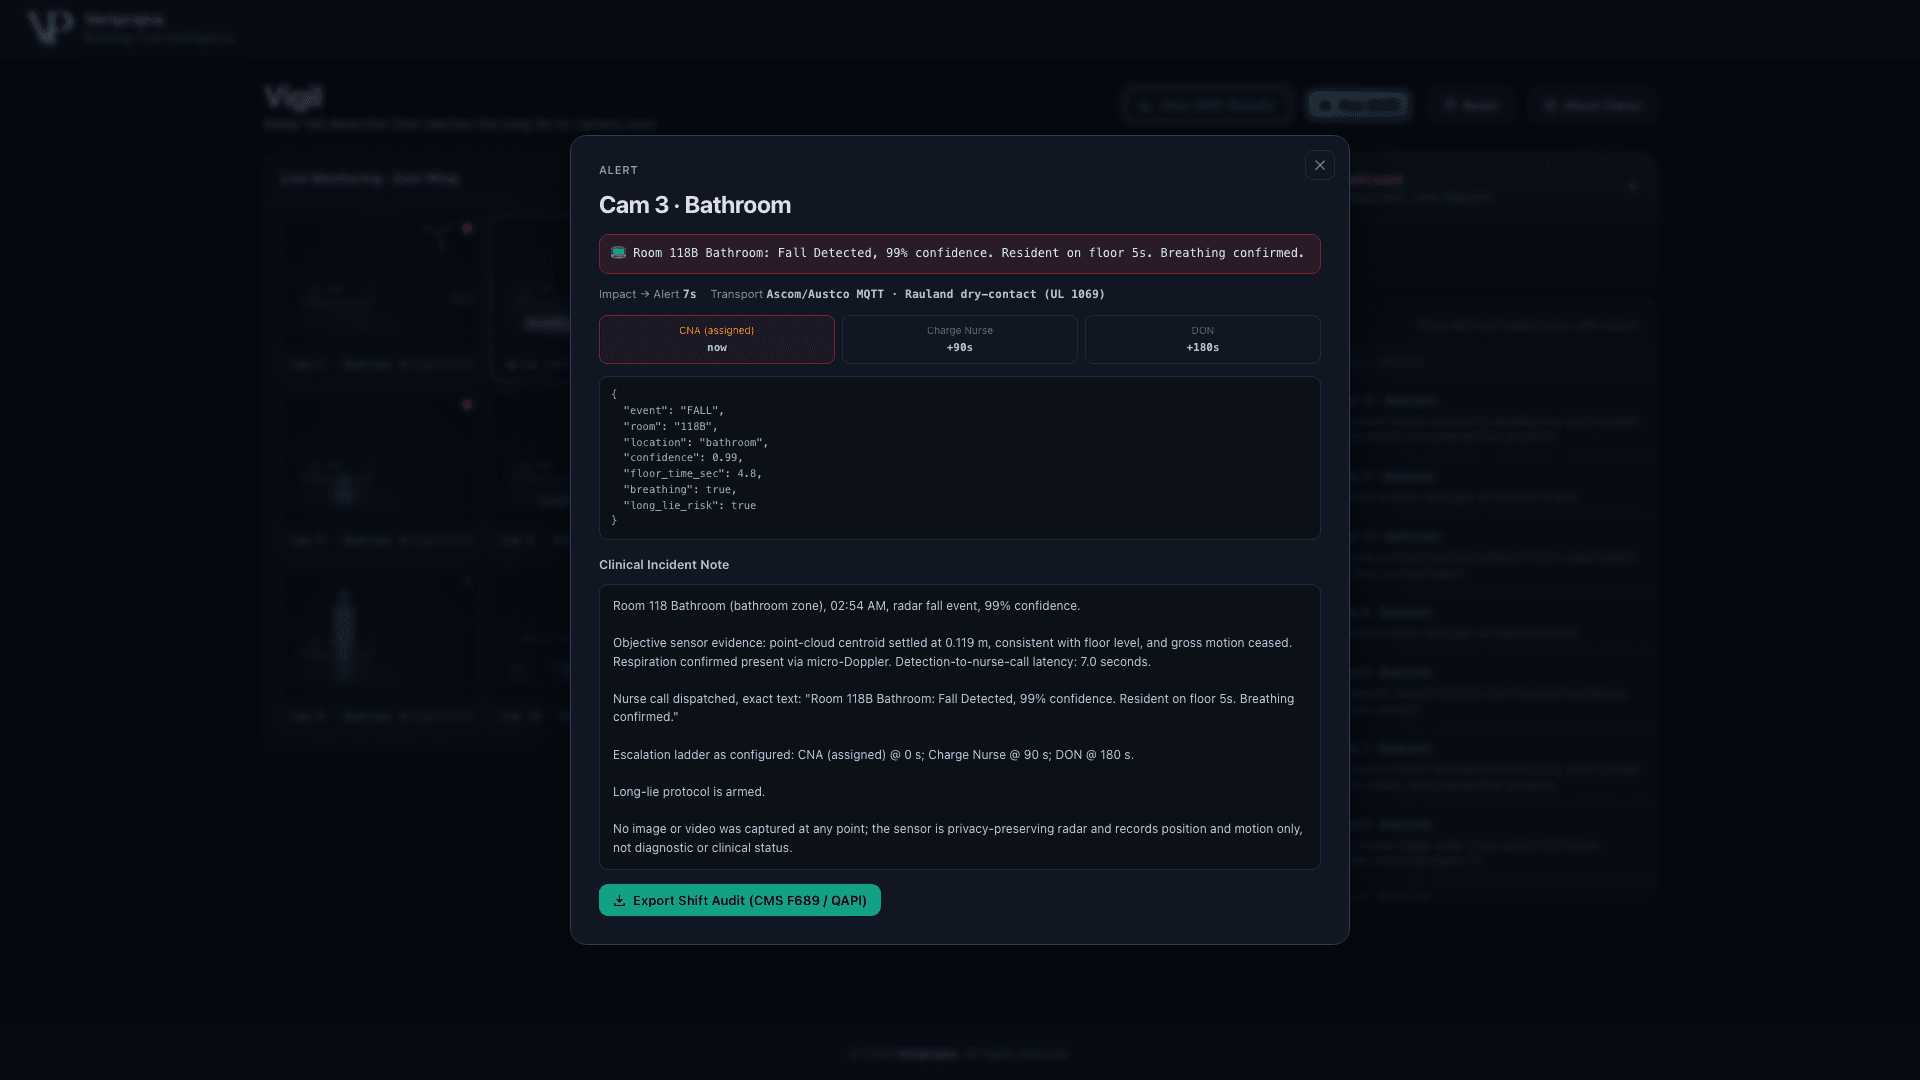
Il y a un chiffre sur ce panneau que je refuse de survendre. Le délai impact-alerte de 7.0 secondes est calculé dans gate.py comme le temporisateur de maintien plus trois secondes, une constante. L'application l'affiche, et je citerai cet affichage, mais il s'agit d'une arithmétique plutôt que d'une vitesse système mesurée, et qualifier cela de latence de référence serait le genre de petit mensonge qui vous coûte la crédibilité des vérités majeures situées juste à côté.
L'événement dont je suis le plus fier est celui que Vigil refuse. Cam 2 est une véritable chute dans la vérité terrain et P(fall) atteint 0.99, mais Vigil refuse malgré tout de l'affirmer : la chambre abrite deux cibles, le suivi d'une personne isolée ne fait pas partie du périmètre de la V1, et la porte logique renvoie ROUTE TO HUMAN à faible confiance. La référence naïve se déclenche automatiquement et s'attribue le mérite d'une détection qu'elle n'a pas gagnée. Deux chutes réelles se sont produites pendant ce quart de travail. Vigil a alerté sur l'une et envoyé l'autre à une vérification par le personnel, et je ne décrirai pas cela comme la détection de chaque chute, car ce n'est pas le cas. Sur l'ensemble du banc d'essai, 40 chutes multi-occupants sur 40 sont acheminées vers un humain, sans fausse alerte superflue et sans aucun oubli.
Ce que le tableau de bord est autorisé à revendiquer
La ligne d'avertissement sous la fenêtre modale des résultats de quart est la première partie de ce panneau que j'ai rédigée. La modale rapporte 0 fausse alerte pour le moteur contre 7 pour la solution existante sur ce quart, 1 chute réelle sur 2 détectée, 1 acheminée vers un humain, 100 % de spécificité sur les facteurs de confusion sur 360 événements étiquetés, et 0.0 contre 25 fausses alertes projetées par chambre et par jour.
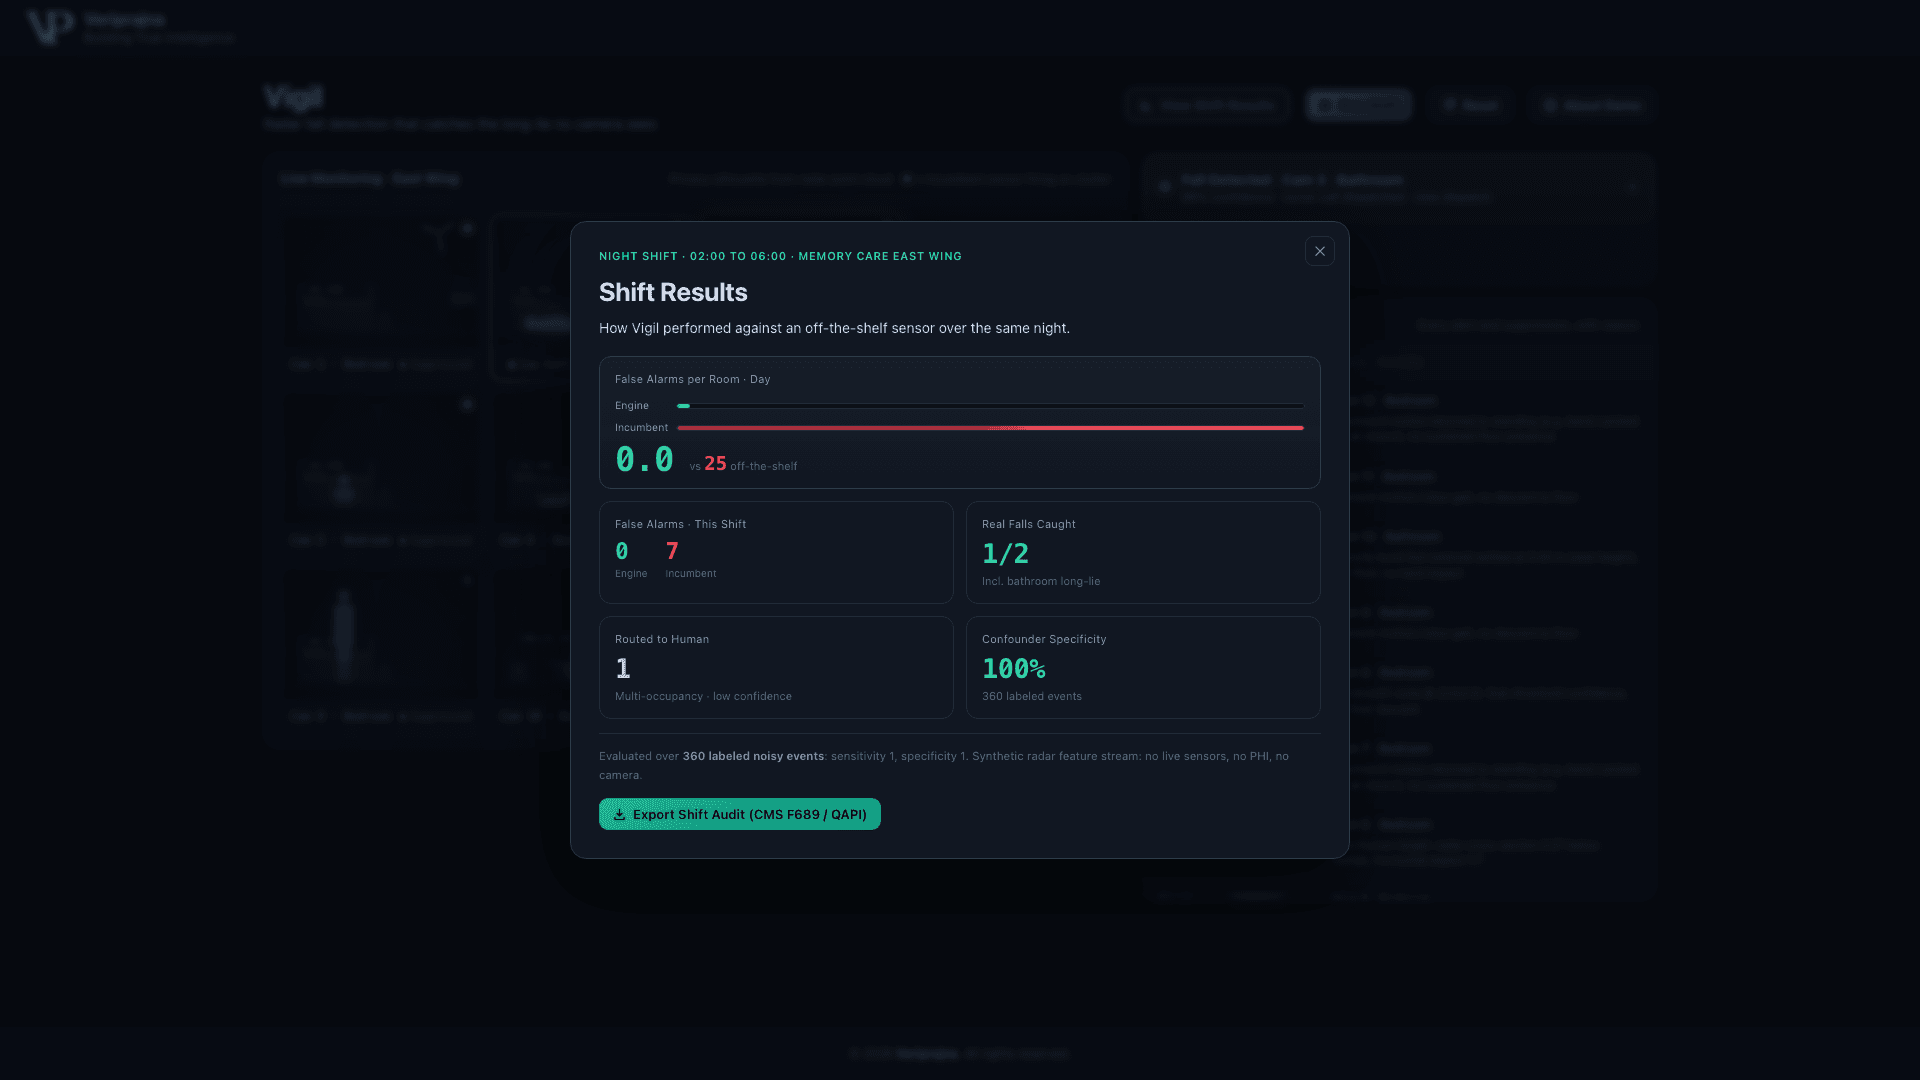
Ces chiffres décrivent un jeu de référence synthétique fixe et rien d'autre. Pas une précision en production, pas un résultat clinique, pas une allégation médicale validée, et en aucun cas une garantie offerte à un établissement. Un déploiement pilote réel vise moins de 2 fausses alertes par chambre et par jour après étalonnage en mode fantôme, et c'est le chiffre que je présenterais à une directrice des soins, car c'est celui sur lequel je pourrais être tenu pour responsable. Ce 0.0 est la preuve que le mécanisme sépare les chutes des facteurs de confusion sur un ensemble que je peux vous transmettre ; ce n'est pas une promesse concernant un bâtiment où je n'ai jamais mis les pieds.
Le standard auquel j'assujettis désormais une alerte de sécurité des personnes
Je suis ressorti de ce projet avec une vision bien plus resserrée de ce en quoi la détection de chutes doit exceller. La détection est un seuil, et un seuil atteint déjà un rappel de 1.0 sur mon propre jeu de test. Le travail qui mérite l'attention d'une infirmière, c'est le refus : la carte de fouillis qui sait quel voxel occupe le ventilateur, le test d'impact qui refuse de se fier à une seule trame, la condition d'atteinte du sol qui sépare une assise brutale d'une chute, et une porte logique rédigée de sorte qu'un inspecteur d'État, plutôt qu'un modèle, puisse lire pourquoi le système a agi comme il l'a fait.
La présentation complète est disponible sur https://veriprajna.com/demos/smart-facility-fall-detection, et les dix lignes supprimées dans le registre constituent le lieu où le quart de travail se joue réellement.
Et si vous préférez observer le quart de travail plutôt que de me lire le décrire, voici la nuit complète s'exécutant de bout en bout.
Un système qui déclenche une alarme sur un ventilateur de plafond se fait couper le son en moins d'une semaine, et un système mis en sourdine ne détecte plus rien du tout. Le comportement le plus élaboré que je pouvais conférer à cette couche était la capacité de refuser, de manière traçable, avec la métrique déterminante à l'appui. Sur Cam 2, ce chiffre était de 0.99, et la bonne décision restait malgré tout de confier l'événement à un humain.