Le cas pratique : expliquer l'exclusion, préserver l'autorité d'examen
Suivez un événement d'approvisionnement synthétique, depuis les données brutes non évaluées jusqu'à une mise en attente expliquée. Les cas comparatifs montrent ensuite pourquoi modifier l'éligibilité à la présélection, réussir un diagnostic de catégorie et autoriser une attribution constituent des résultats distincts. L'ensemble des noms de fournisseurs, certifications, historiques et attributions présentés ici font partie intégrante de la démonstration locale.
Commencer par les éléments probants sous-tendant le score
L'espace de travail affiche initialement les données des fournisseurs, les scores et les décisions de présélection étant en attente. L'inspection de Bridgepoint expose les entrées de livraison, de qualité, d'historique de transactions, d'historique d'audits et de données financières avant toute évaluation. Cette distinction est capitale : un label de fournisseur ou un taux de livraison en apparence élevé ne peut expliquer le score sans la formule qui le traite.
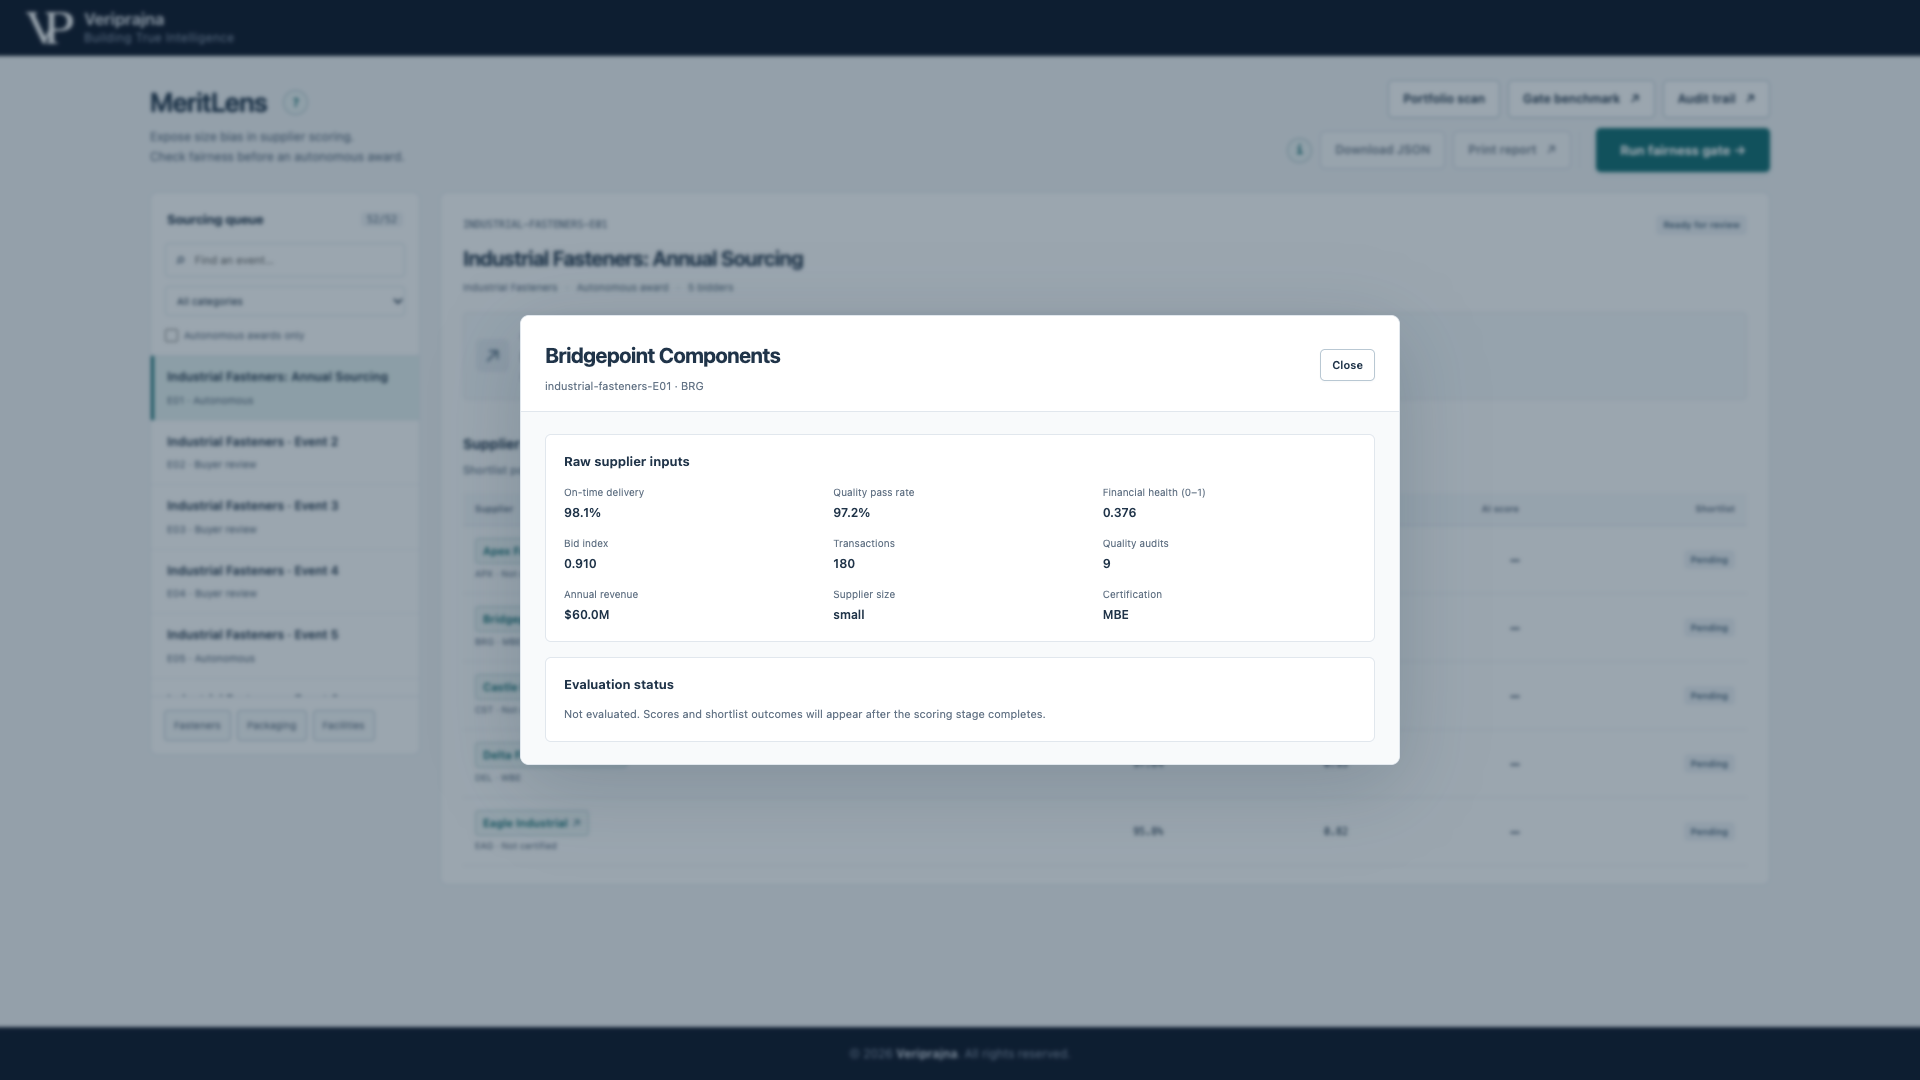
| Donnée synthétique | Apex | Bridgepoint |
|---|---|---|
| Livraison dans les délais | 97.2% | 98.1% |
| Taux de conformité qualité | 96.5% | 97.2% |
| Transactions | 4,200 | 180 |
| Audits | 140 | 9 |
| Chiffre d'affaires | USD 820 million | USD 60 million |
Le système de notation simulé pondère les facteurs de livraison, de qualité, financiers et de prix à 25% chacun. L'historique des transactions et des audits influe sur le niveau de confiance accordé aux taux bruts de livraison et de qualité ; le chiffre d'affaires influe sur le score financier. Ces choix peuvent pénaliser un fournisseur plus modeste, même si les labels de certification sont exclus du calcul. L'acheteur doit donc évaluer la justification de ces hypothèses, plutôt que de présumer la neutralité du fait de l'omission des labels.
Lire la présélection initiale et la suspension enregistrée
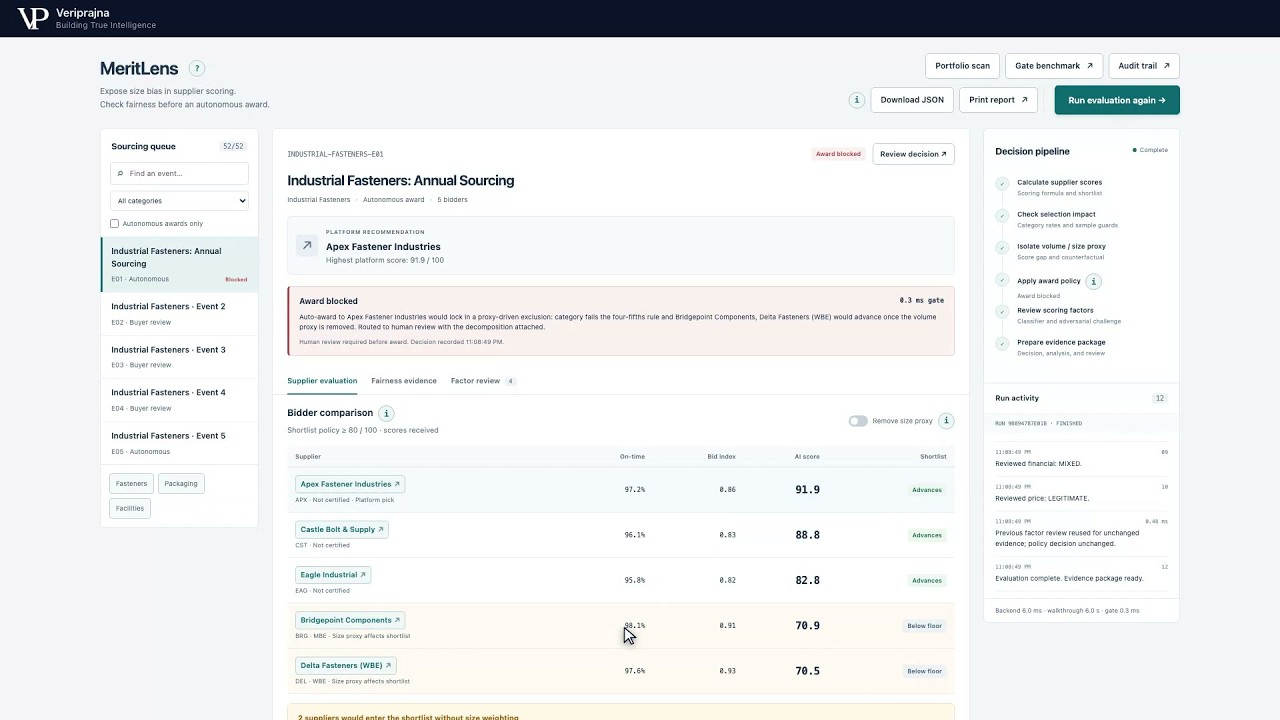
Après évaluation, Apex est le premier de la notation initiale à 91.9. Bridgepoint obtient 70.9 et Delta 70.5, soit en dessous du seuil de présélection configuré de 80. Bridgepoint présente le meilleur taux de livraison, mais cette seule mesure n'établit pas de supériorité sur le plan de la santé financière, du prix ou de tout autre critère légitime.
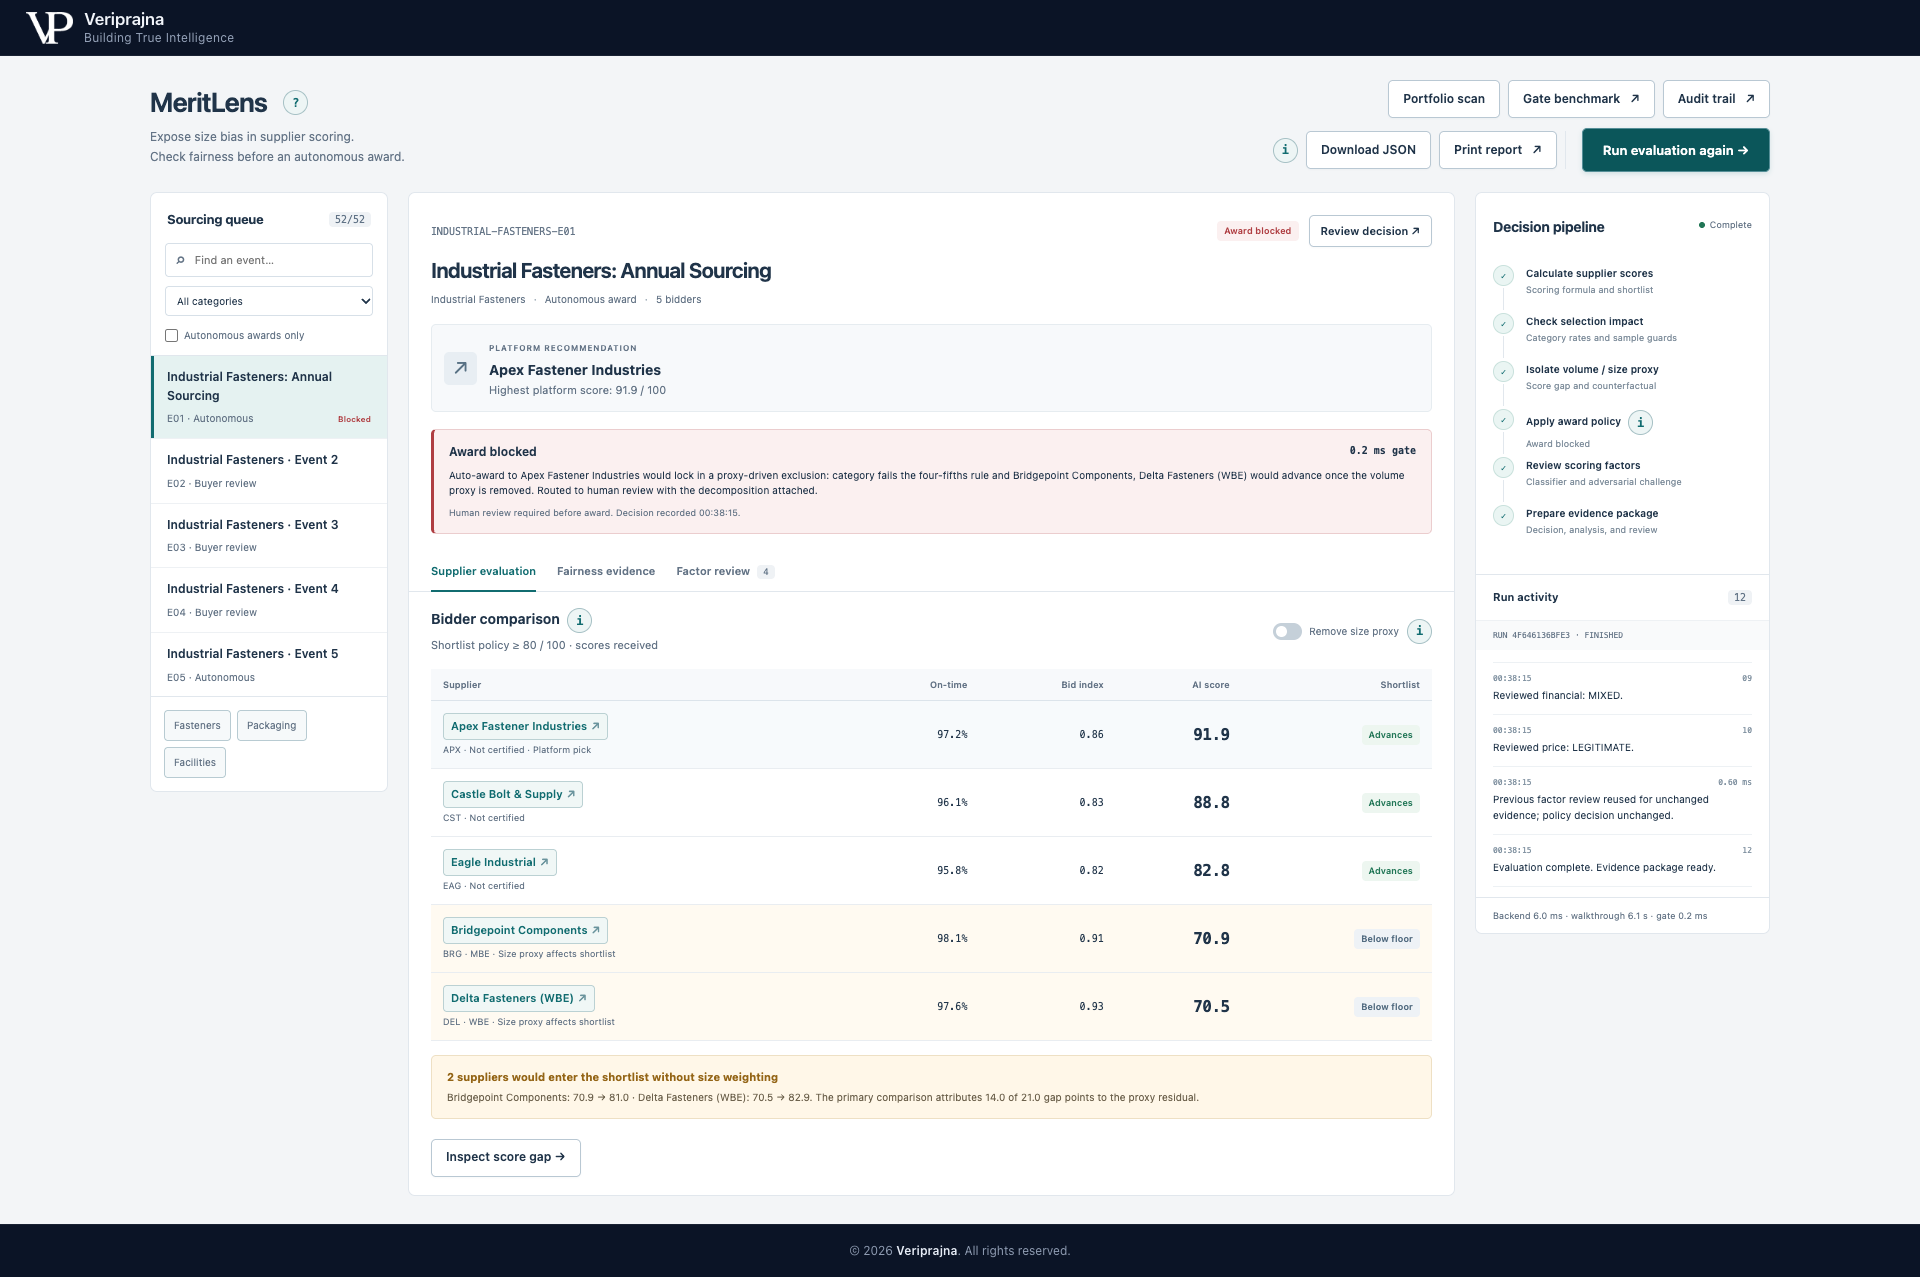
Le verdict BLOCK requiert les trois conditions configurées : un constat d'impact négatif (adverse impact) dans la catégorie, un premier classé initial non diversifié et un challenger diversifié sous le seuil initial qui l'atteint dans la formule alternative. L'événement d'achat d'éléments de fixation réunit cette combinaison. La décision est enregistrée avant le début de l'examen consultatif des facteurs, préservant ainsi la base chiffrée et l'autorité de la suspension.
Inspecter les décomptes de la catégorie et la source de l'écart
Le diagnostic de catégorie regroupe les lignes fournisseur-événement, y compris les fournisseurs récurrents. Les lignes d'entreprises détenues par des minorités comptent 7 sélections sur 26 examinées, contre 25 sur 37 pour la référence non diverse. Le ratio de taux de sélection est d'environ 0.40, inférieur au seuil diagnostique configuré de 0.80. La métadonnée d'historique de catégorie de 312 constitue une garde d'échantillonnage distincte ; elle ne constitue pas le dénominateur de cette comparaison.
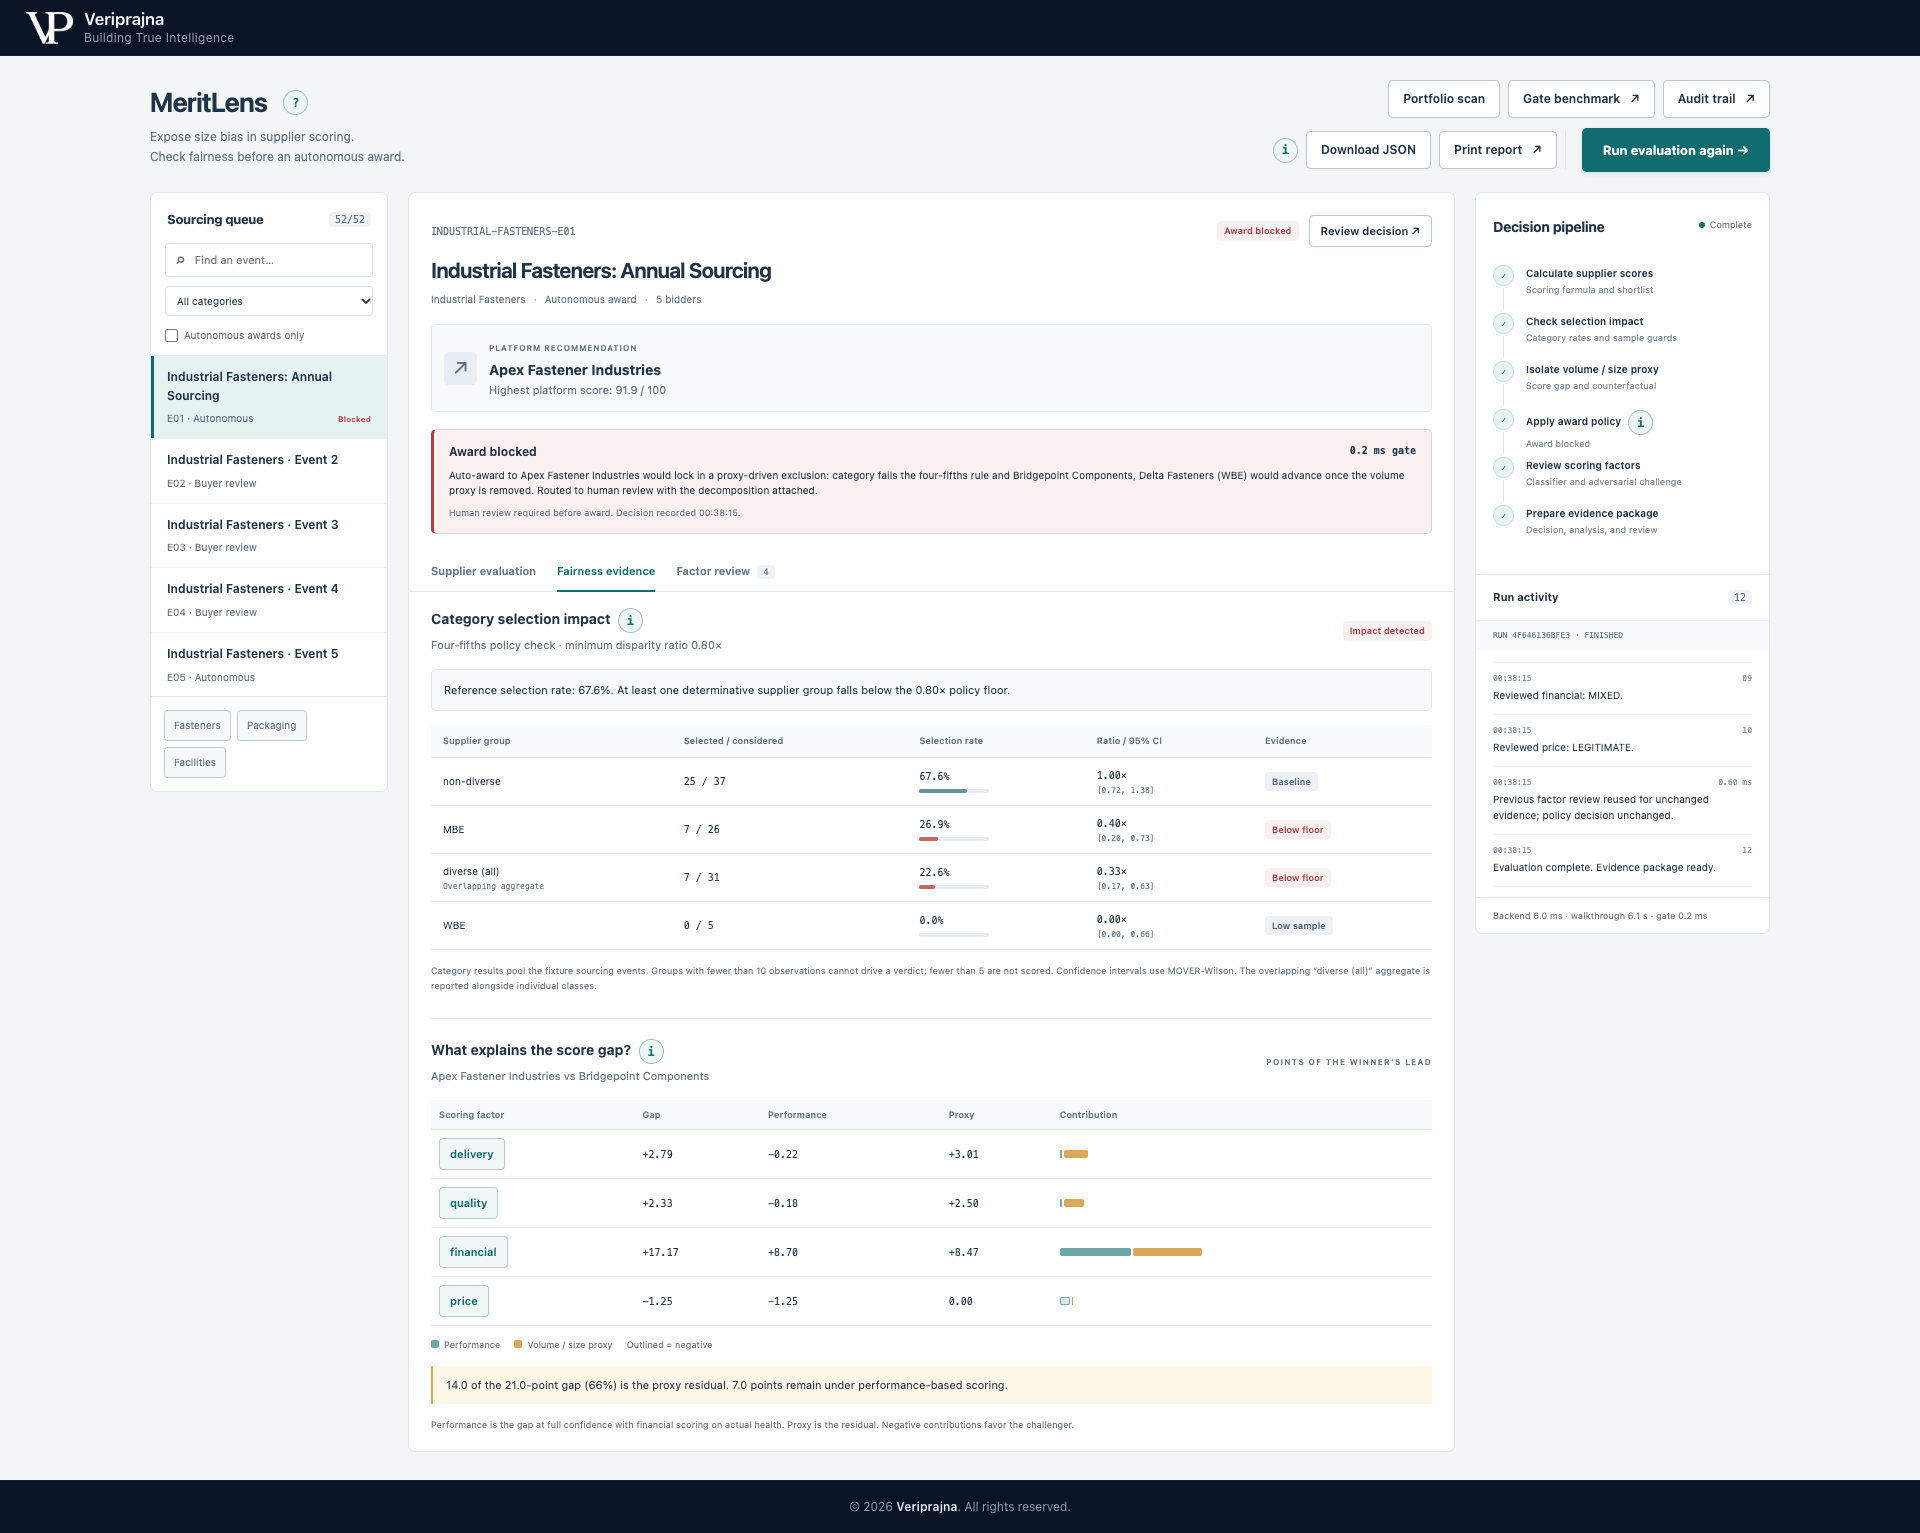
| Hypothèse modifiée | Contribution de la variable de substitution (proxy) à l'écart |
|---|---|
| Confiance de livraison issue de l'historique des transactions | 3.01 points |
| Confiance de qualité issue de l'historique des audits | 2.50 points |
| Évaluation financière fondée sur le chiffre d'affaires | 8.47 points |
| Évaluation du prix, inchangée | 0.00 points |
La décomposition de type Oaxaca-Blinder compare des formules explicites. L'alternative utilise les taux bruts de livraison et de qualité ainsi que la santé financière réelle, maintenant le prix et les pondérations inchangés. Environ deux tiers de l'écart initial sont attribués aux hypothèses modifiées dans cette comparaison ; l'écart résiduel continue de favoriser Apex. Ce résidu dépend de l'alternative retenue et ne constitue pas une preuve causale indépendante de discrimination.
Modifier l'aperçu sans réécrire la décision
| Fournisseur | Score initial | Score alternatif | Résultat de l'aperçu |
|---|---|---|---|
| Apex Fastener Industries | 91.9 | 88.0 | Reste premier au score |
| Bridgepoint Components | 70.9 | 81.0 | Devient éligible |
| Delta Fasteners | 70.5 | 82.9 | Devient éligible |
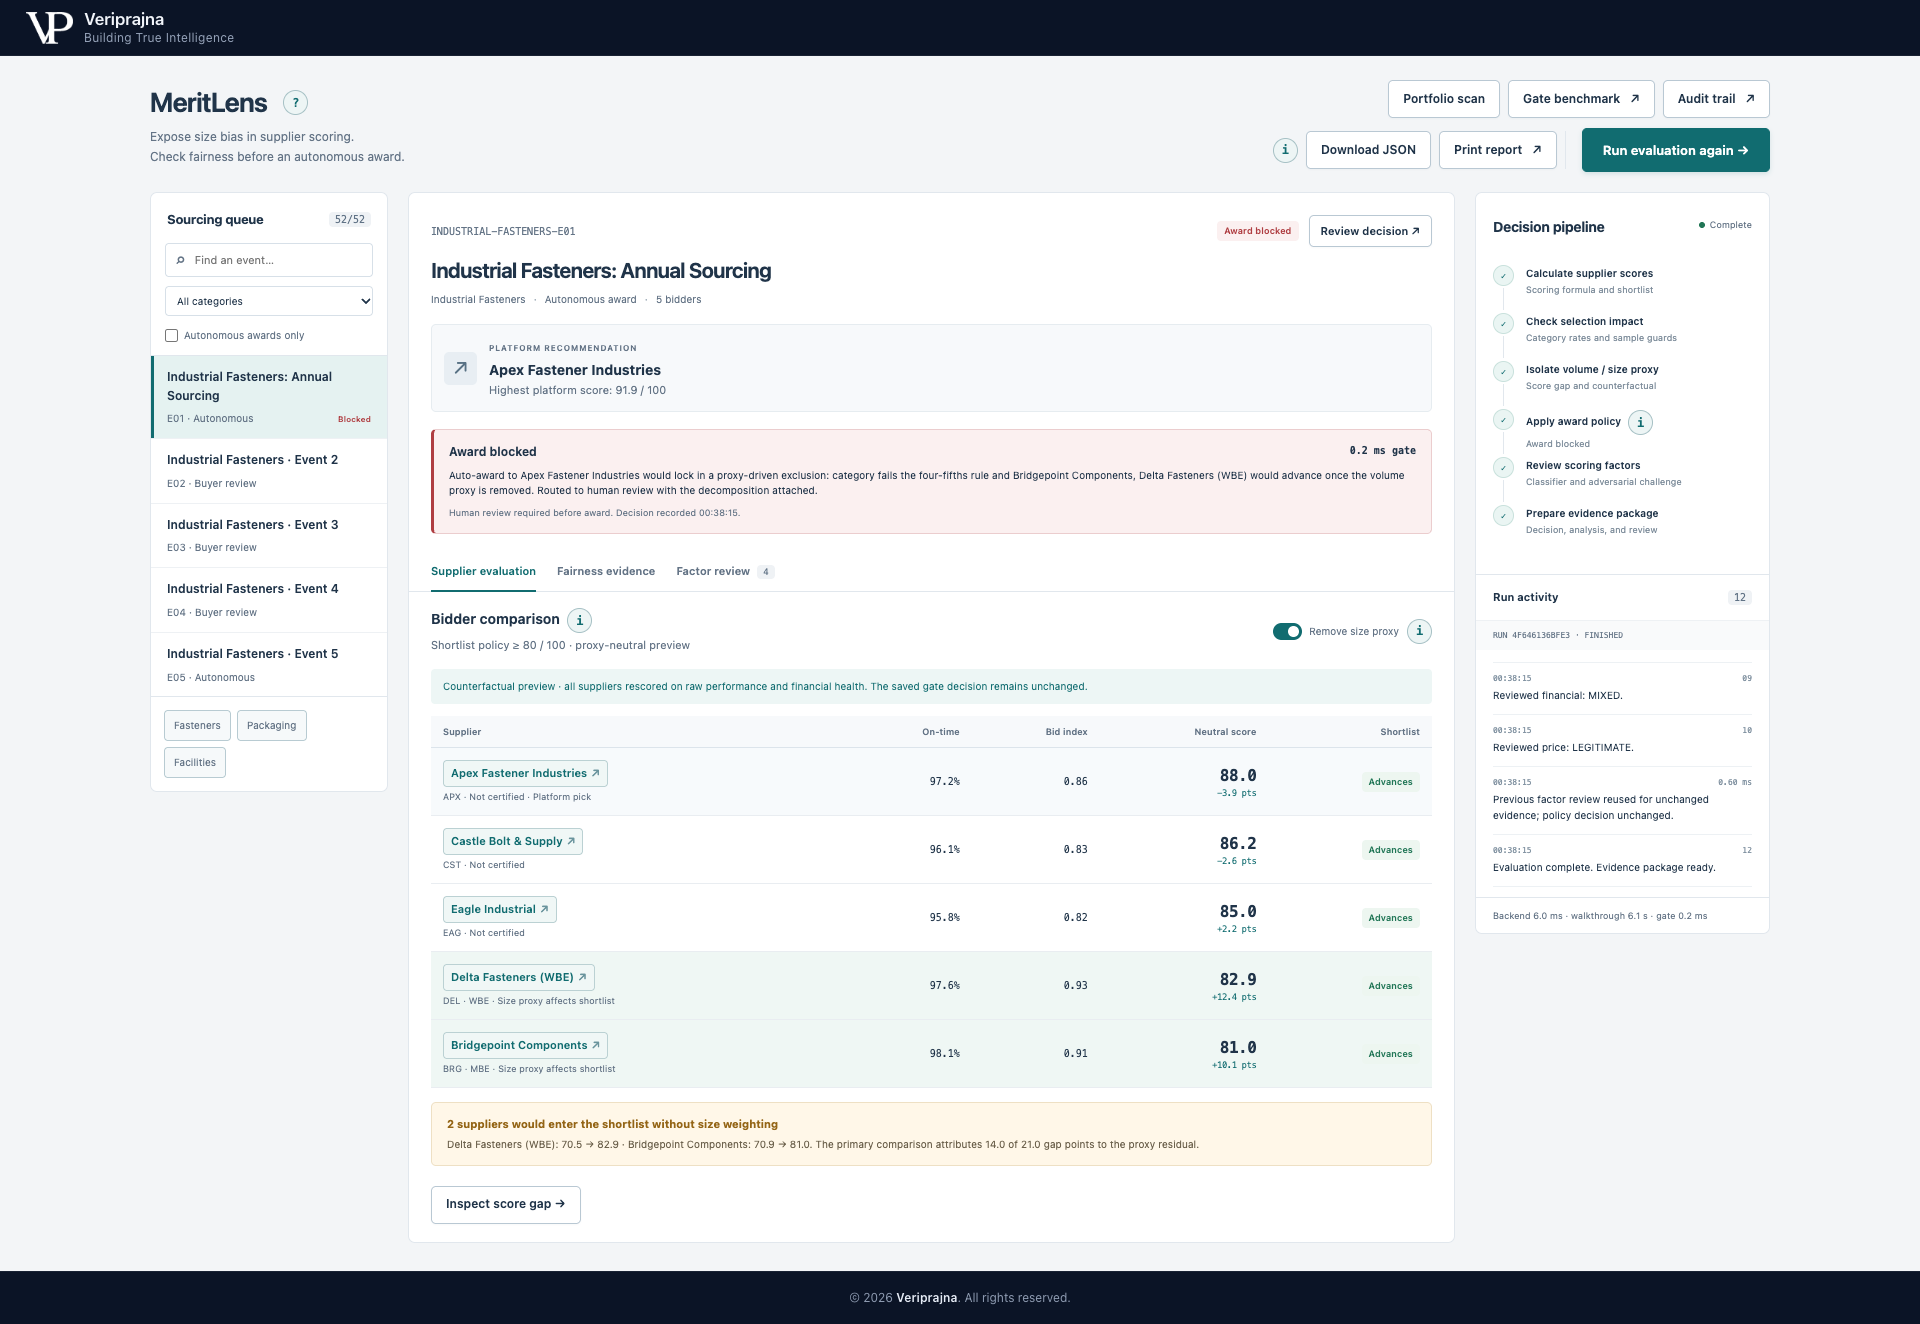
Cet aperçu pose aux examinateurs des achats une question ciblée : ces fournisseurs auraient-ils été exclus selon des hypothèses de notation que l'organisation peut défendre ? Il ne désigne pas Bridgepoint comme vainqueur, n'exécute aucune attribution, ne recalcule pas l'évaluation enregistrée pour la catégorie et ne remplace pas le système de notation initial. Un évaluateur humain doit toujours prendre en compte le contexte des achats et décider de la manière de traiter les hypothèses identifiées.
Pourquoi ALLOW ne signifie pas que toutes les catégories de fournisseurs ont réussi
Dans l'exemple des matériaux d'emballage (Packaging Materials), la recommandation initiale est Beacon à 91.7, le diagnostic de catégorie indique PASS et la porte configurée renvoie ALLOW. Pourtant, Ironclad, un fournisseur synthétique HUBZone, passe de 72.4 à 81.4 avec la formule alternative. Une autorisation de politique peut donc coexister avec une exclusion de présélection sensible aux variables de substitution (proxys).
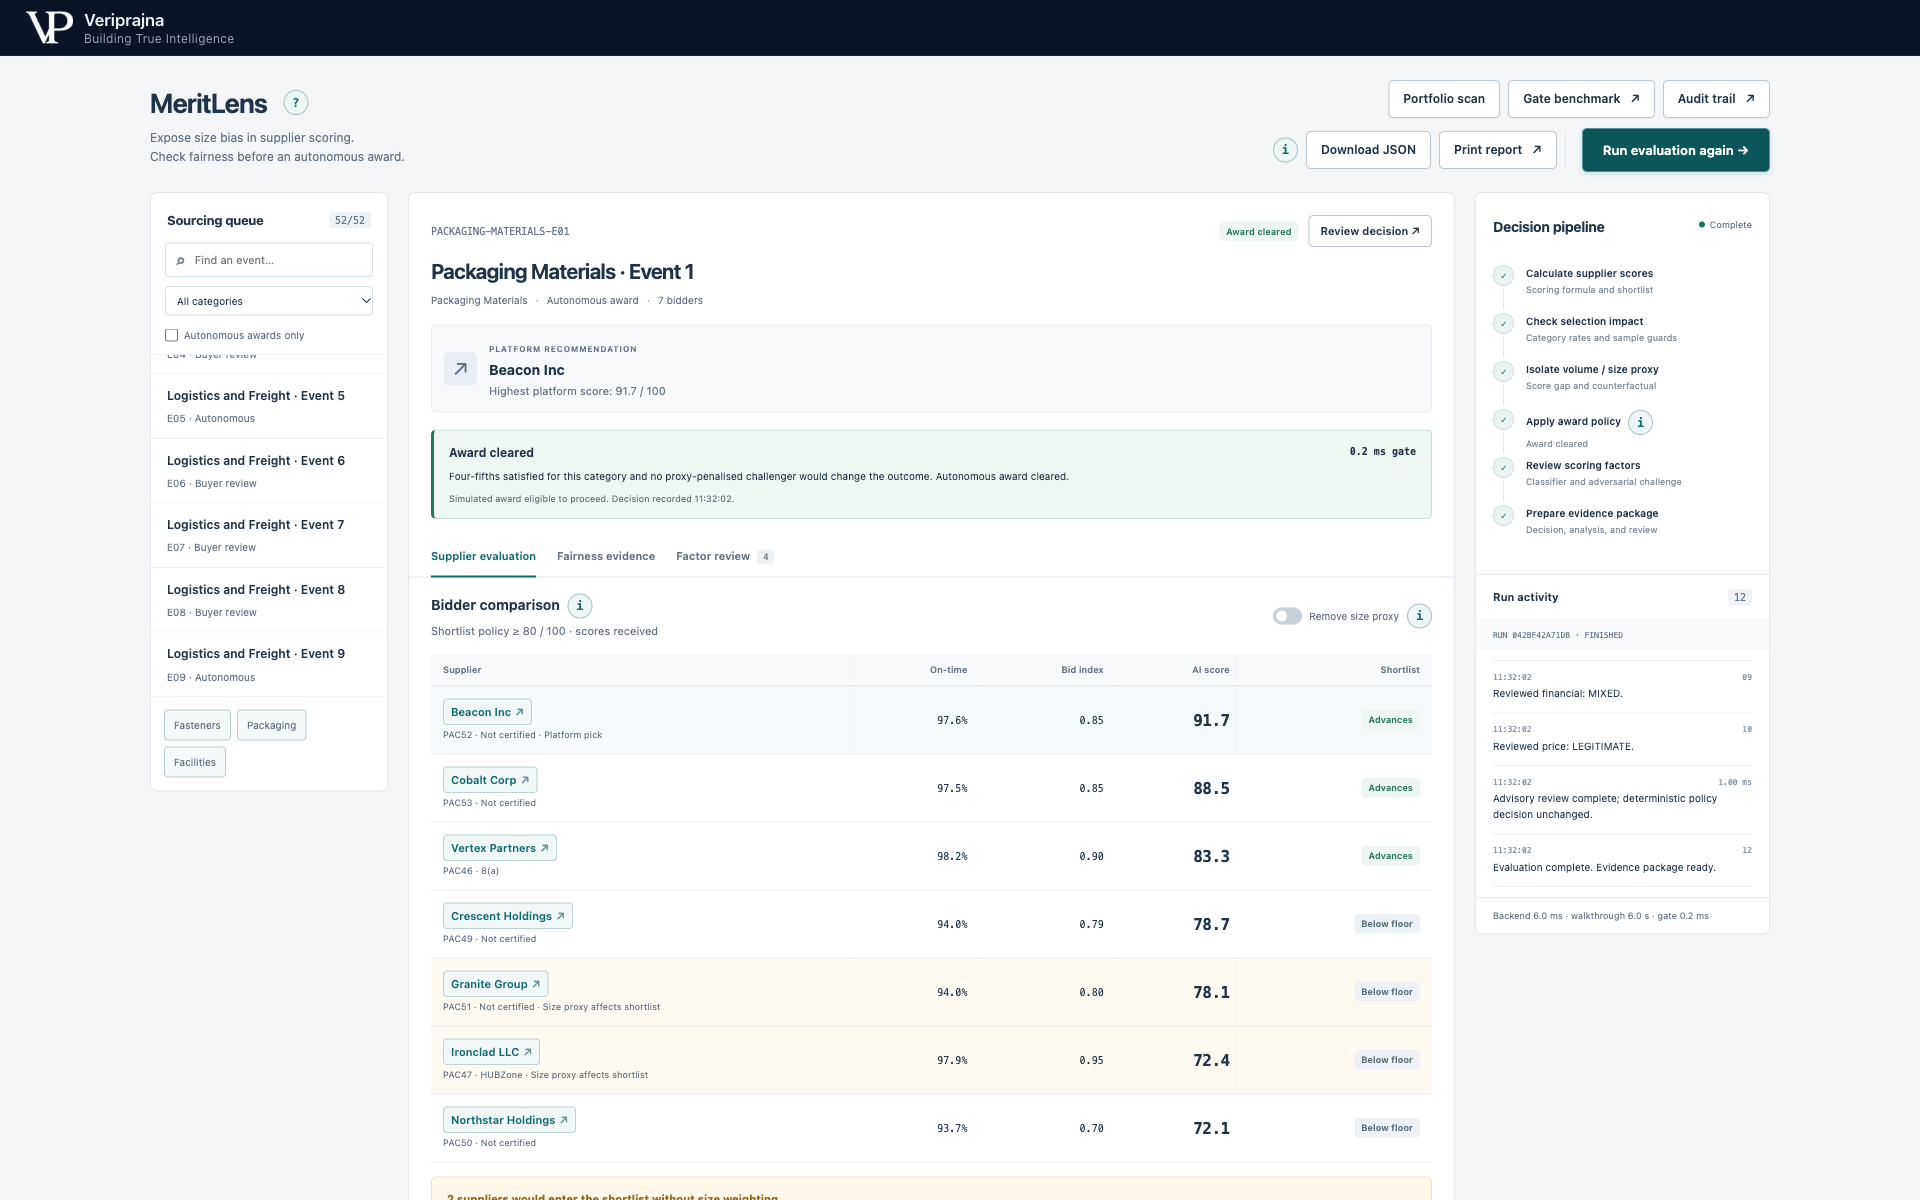
L'agrégat diversifié chevauchant affiche 8 sélections sur 12 lignes examinées, contre 18 sur 38 pour la référence non diverse. Son ratio est d'environ 1.41. Les groupes individuels d'entreprises détenues par des minorités, HUBZone et 8(a) ne comptent chacun que quatre lignes examinées et restent non notés. La mention PASS pour la catégorie n'établit donc pas que chaque classe a été évaluée, et ALLOW ne prouve pas l'absence de proxys ou de disparité.
Pourquoi le manque d'éléments probants suspend l'attribution
L'événement Facilities and MRO dispose d'un historique de catégorie déclaré de 140, inférieur au minimum configuré de 200. Son évaluation de catégorie et sa porte de décision renvoient toutes deux ABSTAIN, de sorte que l'attribution autonome simulée est suspendue pour examen. Les scores et une décomposition peuvent toujours être calculés ; aucun des deux ne transforme une évaluation de catégorie indisponible en validation.
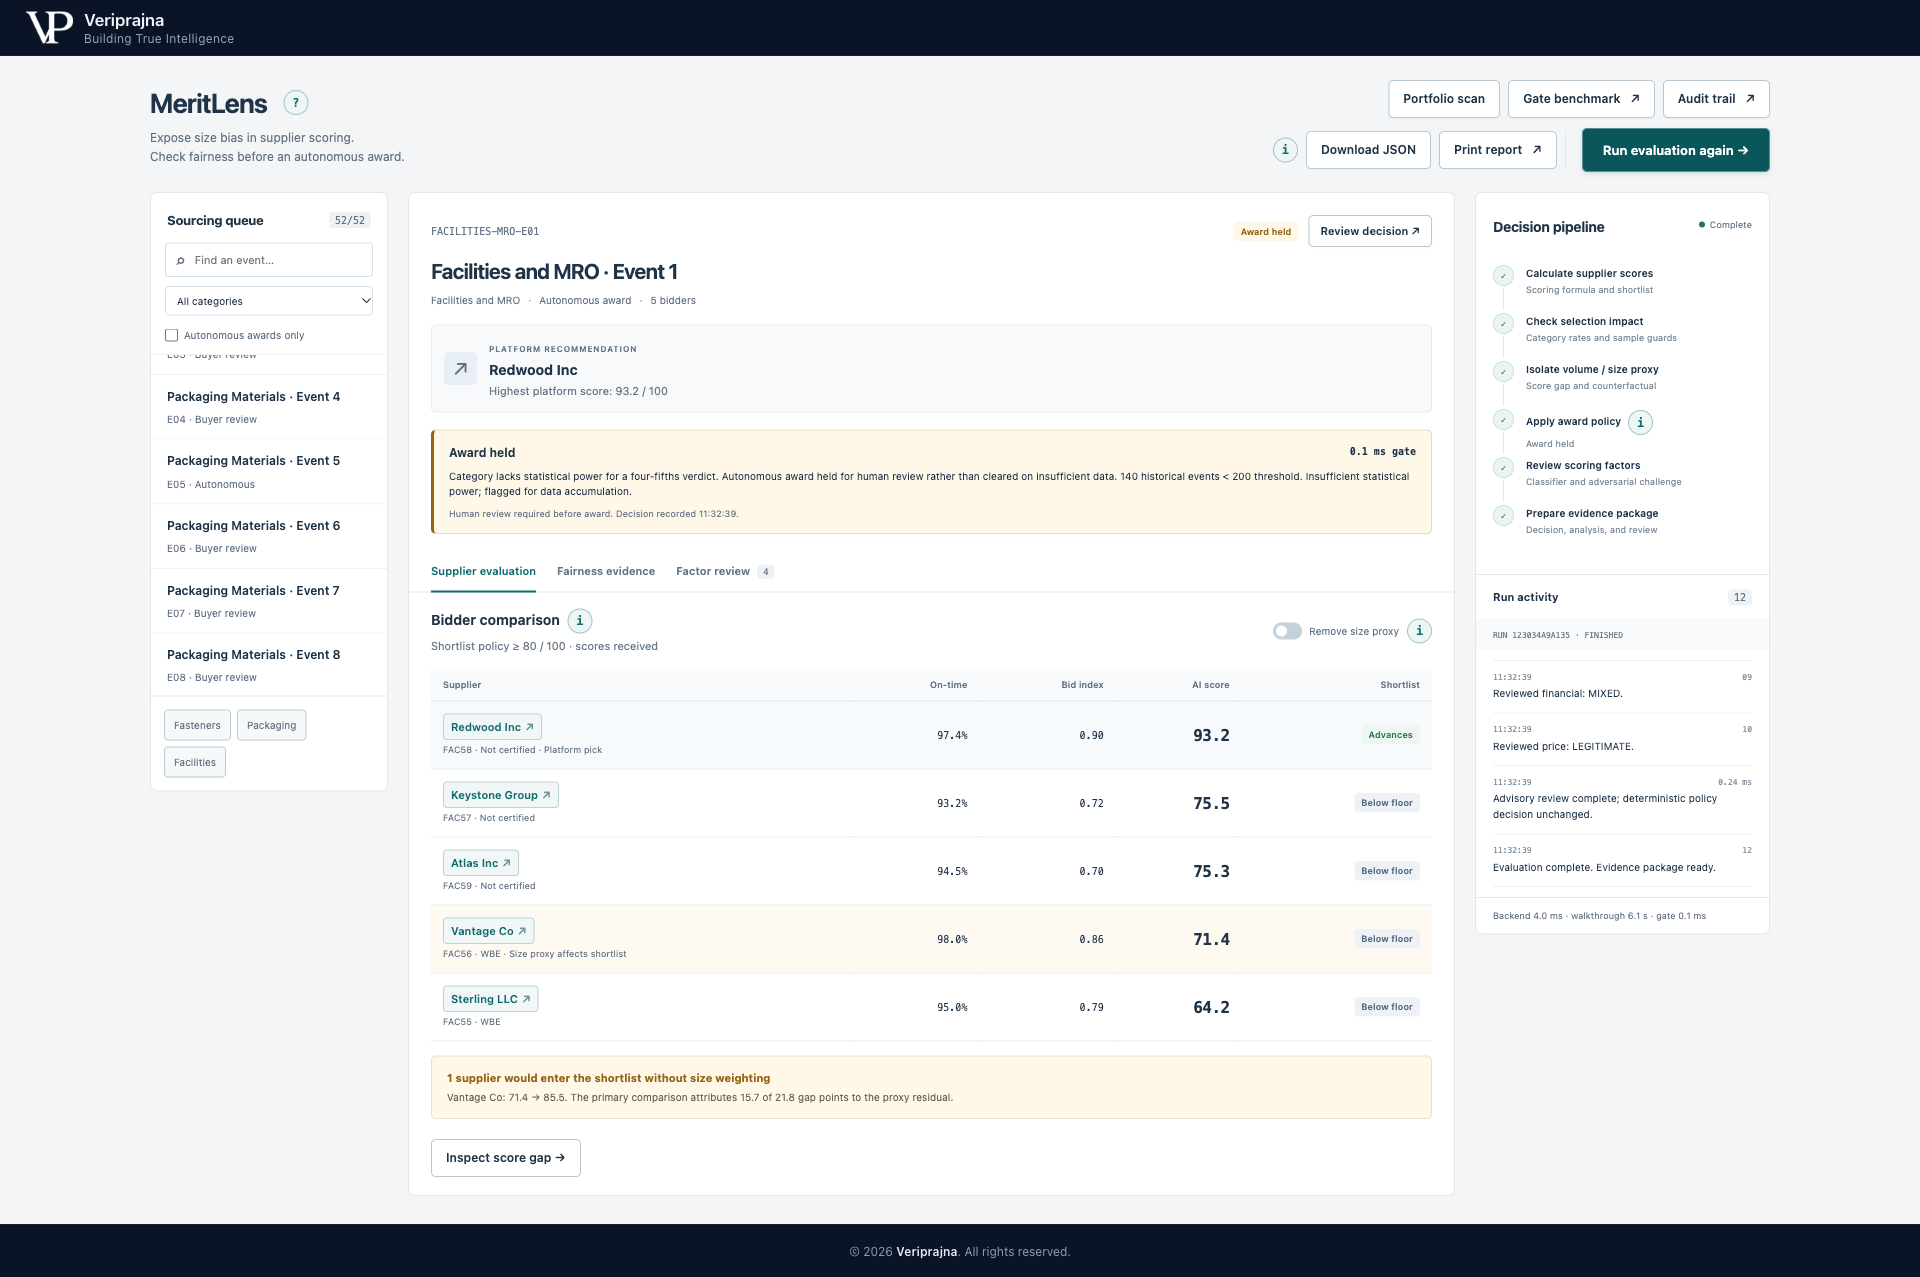
D'autres garde-fous couvrent une référence de base comptant moins de cinq lignes examinées ou aucune sélection. Les groupes individuels de moins de cinq lignes ne sont pas notés, tandis que les groupes de cinq à neuf lignes sont informatifs et ne peuvent pas déterminer le verdict de la catégorie. L'historique minimal de 200 et ces garde-fous de groupe sont des limites configurées, et non la garantie qu'un jeu de données d'achats réel soit statistiquement adéquat.
Vérifier la politique par rapport aux contrôles rédigés
La suite fixe contient dix cas d'entrées brutes rédigés avec des résultats attendus : trois BLOCK, quatre ALLOW et trois ABSTAIN. Les résultats observés correspondent à l'ensemble des dix étiquettes attendues. Les contrôles couvrent les hypothèses d'historique, d'audit et de chiffre d'affaires, les fournisseurs certifiés établis, les écarts portant uniquement sur les prix, l'exclusion fondée sur la performance, les données de référence éparses et une référence de base sans aucune sélection.
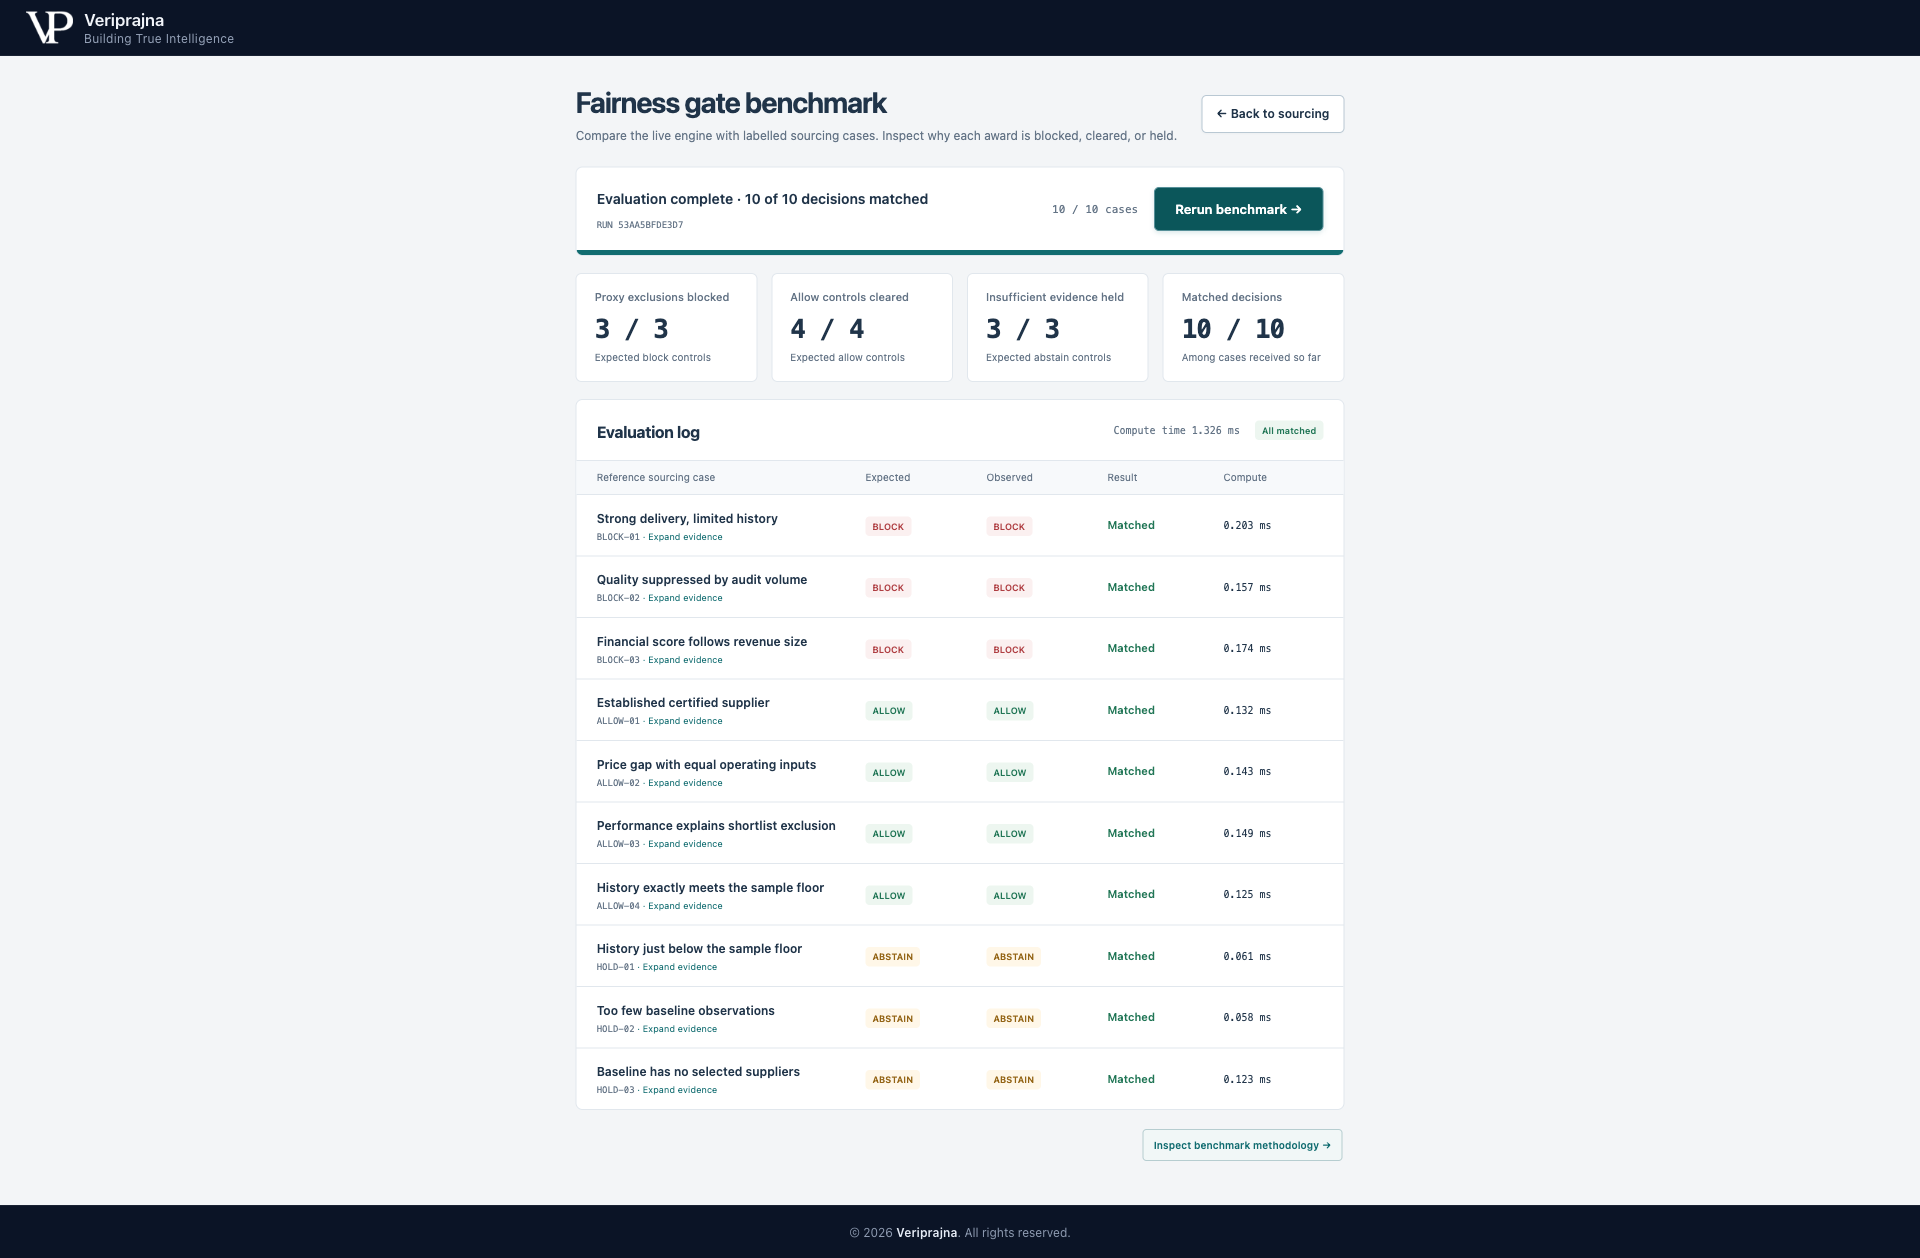
Un cas limite autorise l'évaluation pour un historique d'exactement 200 et renvoie ALLOW ; un autre à 199 renvoie ABSTAIN. Ces contrôles aident à vérifier si l'implémentation respecte sa politique déclarée aux seuils critiques. Ils n'établissent ni la précision en situation réelle d'achat, ni le calibrage, ni une validation indépendante. Le benchmark s'exécute sans appel de modèle et n'ajoute aucune entrée d'audit d'approvisionnement.
Distinguer une analyse de portefeuille des interventions exécutées
Le portefeuille synthétique contient 52 événements répartis sur six catégories et 342 lignes fournisseur-événement. Ces lignes sont des enregistrements de participation répétés, et non 342 fournisseurs uniques. Quinze événements sont marqués pour des attributions autonomes ; le recalcul de la politique produit parmi eux huit BLOCK, un ABSTAIN et six ALLOW. Neuf des quinze seraient donc suspendus pour examen dans cette configuration.
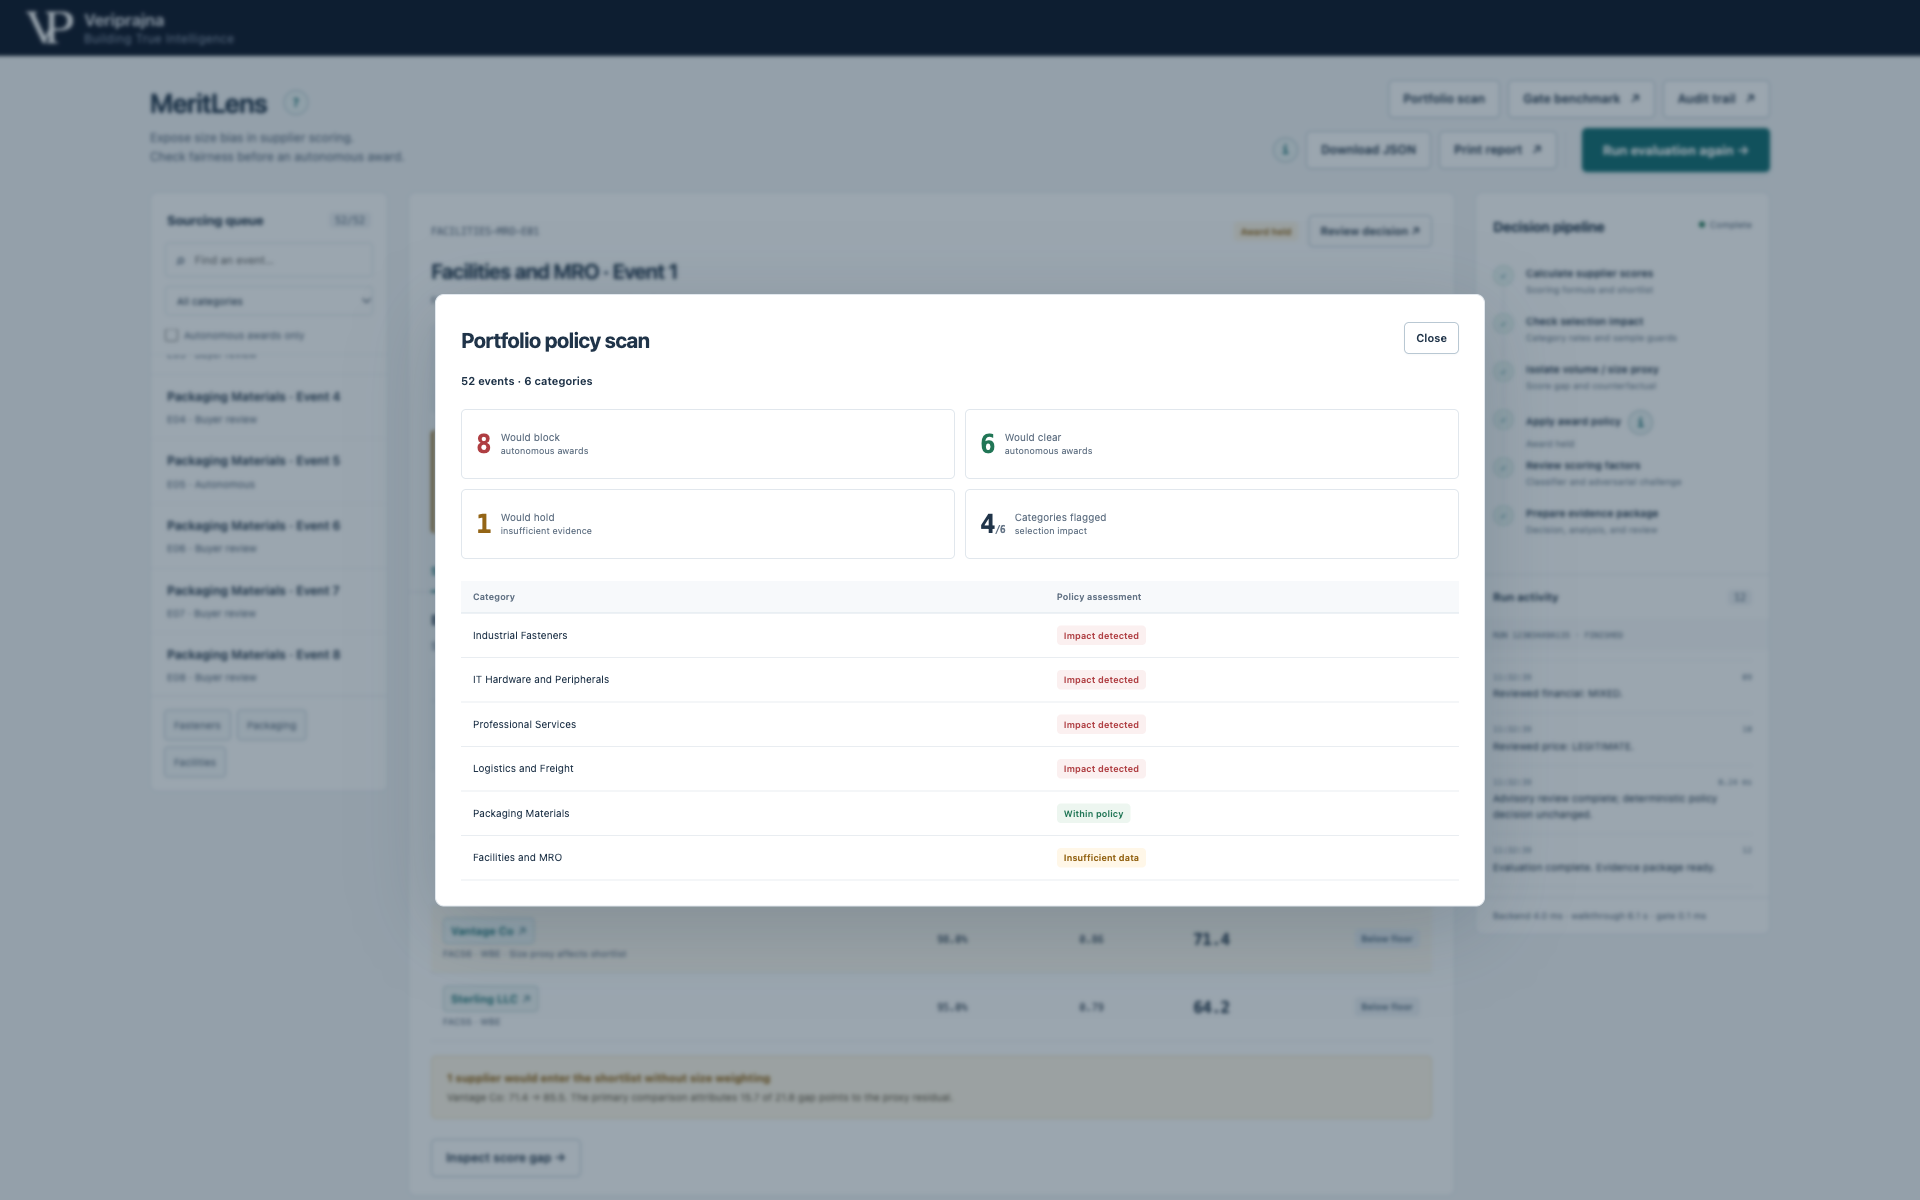
Au niveau de la catégorie, l'analyse signale quatre constats ADVERSE_IMPACT, un PASS et un ABSTAIN. L'analyse aide à identifier où un examinateur devrait inspecter les éléments probants ensuite. Elle est distincte de la suite de contrôle de dix cas : l'une résume un portefeuille initialisé, tandis que l'autre vérifie le comportement d'implémentation attendu. Aucune des deux ne fournit d'éléments probants sur les populations réelles de fournisseurs.
Transmettre la décision et ses éléments probants à l'examinateur
Après l'évaluation et l'examen consultatif des facteurs, Télécharger le JSON et Imprimer le rapport incluent la décision enregistrée, l'entrée d'audit, les décomptes de catégorie, la décomposition et l'examen des facteurs. L'avis facultatif de Proxy Classifier et d'Adversarial Challenger ajoute des étiquettes et des justifications après l'enregistrement de la porte. Les éléments probants numériques restent ancrés dans le code ; la prose consultative ne peut pas autoriser l'attribution. Les réponses consultatives complètes enregistrées peuvent être réutilisées pour des données d'entrée inchangées, et les fournisseurs indisponibles basculent sur un examen déterministe.
Pour une évaluation en production, les questions suivantes portent sur les mesures d'historique défendables pour le contrat, sur la représentativité des comparaisons de catégories par rapport à la population de fournisseurs visée, et sur la personne habilitée à lever une suspension. La démo rend ces questions inspectables. Sa persistance d'audit JSON locale ne constitue pas une garde immuable par un tiers, et les champs d'export aux intitulés juridiques sont des correspondances configurées de modèles plutôt qu'une certification juridique ou une assurance indépendante.