Illinois prohíbe el código postal que la EU AI Act exige conservar. Creé una auditoría de contratación con IA que lo evidencia en lugar de certificar un aprobado.

El 2 de diciembre de 2025, la Contraloría del Estado de Nueva York publicó una revisión de la misma muestra de 32 empresas que el Departamento de Protección al Consumidor y al Trabajador de la ciudad ya había examinado según la Local Law 144, y contabilizó 17 posibles infracciones donde el DCWP había encontrado solo una. El DCWP acordó pasar a una aplicación proactiva.
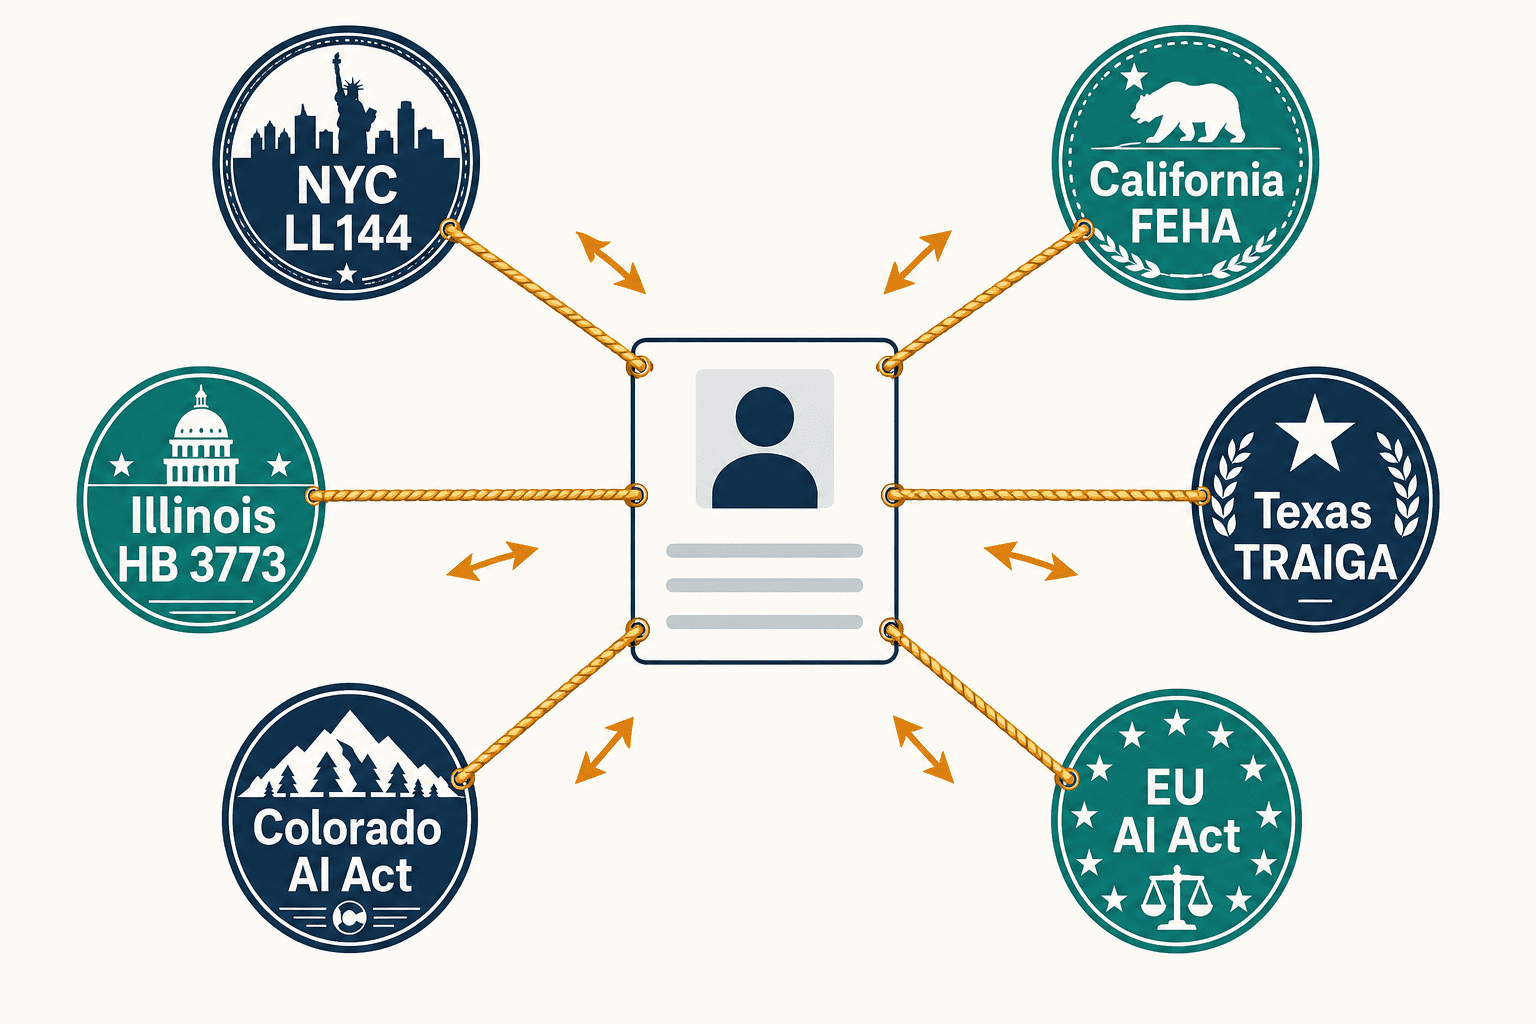
Leí eso y asumí que el problema de ingeniería difícil era la detección: construir algo que detectara el sesgo que la primera pasada pasó por alto. Redactar los paquetes de reglas me hizo cambiar de opinión, porque la detección resultó ser la mitad fácil. La parte difícil es que un empleador que utiliza herramientas de contratación automatizadas en Nueva York, Colorado, Illinois, Texas, California y la Unión Europea responde ante seis reguladores que exigen seis documentos con estructuras diferentes y, al menos en un punto, dos de ellos exigen cosas opuestas a partir de la misma columna de datos.
Así que creé una capa superpuesta de cumplimiento para eso, una consola a la que llamé Clarion que opera sobre las herramientas de contratación con IA que el empleador ya utiliza, lee una única exportación de puntuaciones de proveedores, calcula cada estadística de impacto adverso mediante código determinista y distribuye esa auditoría única en seis entregables adaptados a cada jurisdicción. Puede ver cómo funciona en veriprajna.com/demos/ai-hiring-compliance. Todo lo que sigue se ejecuta sobre una exportación sintética preconfigurada de 1040 registros de candidatos para un empleador ficticio, "Acme Logistics, Inc.", en la solicitud REQ-2026-0412. Yo mismo introduje la infracción en esos datos, razón única por la cual puedo explicarle exactamente qué debía detectar el motor.
La auditoría que se aprueba no es la que exige la ley
Yo mismo preparé los datos iniciales, por lo que el primer resultado aun así logró molestarme. La prueba marginal de los cuatro quintos, la que entrega una autoauditoría de proveedor, pasa limpiamente: ratio de impacto mínimo por raza de 0.8196, con la población hispana y negra empatadas en ese mínimo, y ratio mínimo por sexo de 0.8744. Ambos se sitúan en o por encima de la línea de 0.80. Nada en el código fuerza esa aprobación. El 0.8196 es lo que devuelve el cálculo sobre los datos de prueba, y supera el umbral por sí solo. En pantalla, la tarjeta de tasas lo dice con total claridad: el proveedor se detiene aquí.
La Local Law 144 no se detiene ahí. Exige ratios interseccionales de raza por sexo, y los candidatos sintéticos son evaluados por tres herramientas simuladas (un evaluador al estilo de Workday Spotlight, una ronda de video al estilo de HireVue y un motor de coincidencia al estilo de Eightfold) que son adaptadores de prueba sobre esos datos sintéticos, arquetipos antes que integraciones. Si se desglosan esos mismos registros por raza y sexo, la imagen se invierte. Frente a la celda de referencia White / Male, que hace avanzar a 68 de 130 candidatos con un 52.31%, la celda Black / Female hace avanzar a 44 de 130, es decir, un 33.85%. Ratio de impacto 0.6471. Hispanic / Female también suspende, con 0.7647.
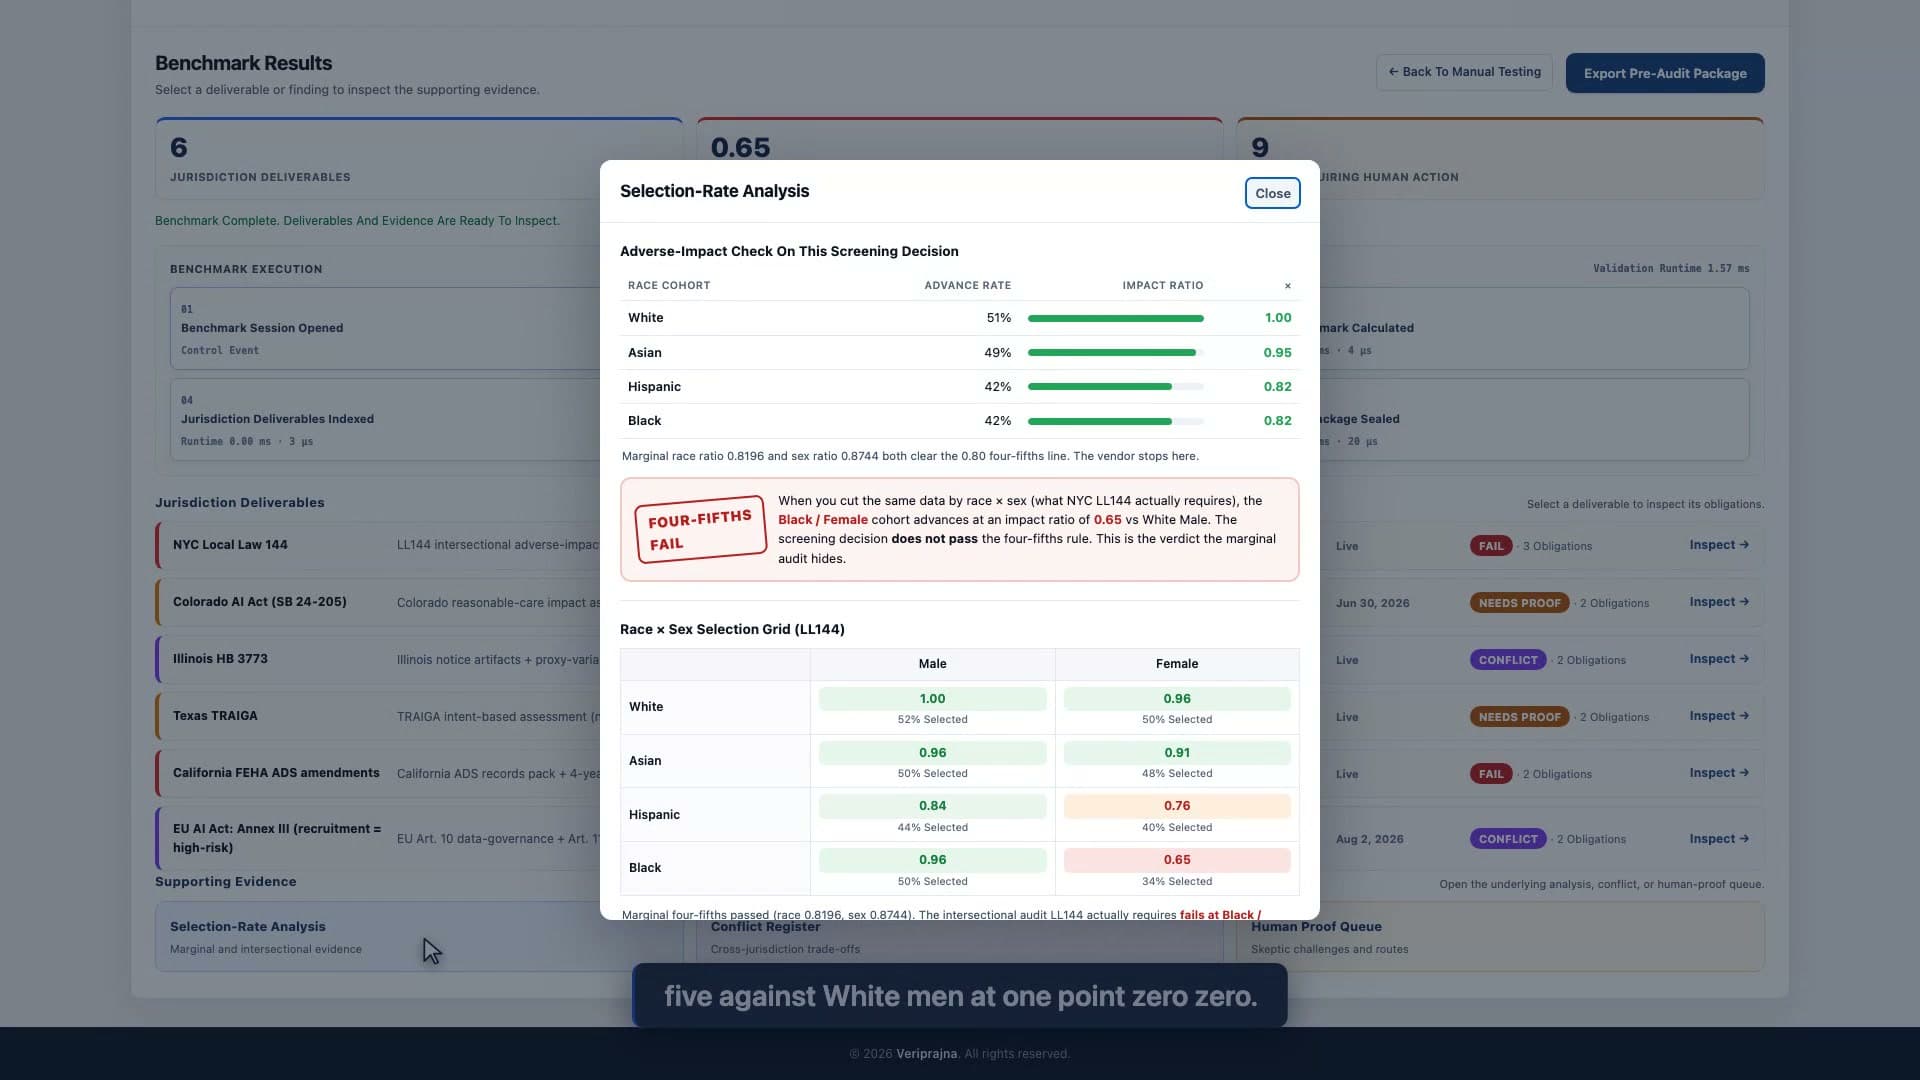
Hispanic / Female es donde discrepé con mi propio motor. Bajo el control de tasa de falsos descubrimientos de Benjamini-Hochberg con alfa 0.05, solo la celda Black / Female es estadísticamente robusta, con q = 0.0185. Hispanic / Female se sitúa en q = 0.1629, por lo que el motor la marca y rechaza explícitamente calificarla como significativa. Yo quería que ambas celdas contasen, porque dos celdas no conformes cuentan una mejor historia que una sola. El motor distingue un hallazgo robusto de uno producto del azar, que es la misma disciplina que exigiría que se aplicase a mis propios números si fuera el empleador del otro lado del informe.
Seis reguladores, seis documentos diferentes
Escribí los seis paquetes de reglas uno tras otro y traté repetidamente de condensarlos en una única puntuación, porque un solo número es lo que cabe en un panel de control y lo que un comprador espera. Nunca resistió el contacto con la normativa. NYC exige un informe de impacto adverso interseccional junto con un resumen público publicado. La ley SB 24-205 de Colorado exige una evaluación documentada de impacto de diligencia razonable y un programa de gestión de riesgos, sin especificar metodología alguna, en vigor a partir del 30 de junio de 2026. TRAIGA de Texas rechaza el impacto dispar como base independiente y pregunta por la intencionalidad. Las enmiendas FEHA ADS de California están en vigor desde el 1 de octubre de 2025 y exigen una vez más su propia estructura documental. La EU AI Act clasifica la selección de personal como de alto riesgo en Annex III y exige gobernanza de datos bajo Article 10 junto con un expediente técnico bajo Article 11, a partir del 2 de agosto de 2026.
La puntuación única sucumbió ante el paquete de Texas. Ya había estructurado el entregable de NYC en torno a ratios interseccionales, y TRAIGA hace que esas estadísticas exactas carezcan de relevancia probatoria para su propia evaluación, por lo que no existía ponderación que pudiera aplicar para que un solo número significara ambas cosas. Seis preguntas distintas planteadas con seis estructuras diferentes, y una puntuación de imparcialidad responde aproximadamente a una y media. Por tanto, Clarion genera seis entregables, cada uno con su propia cita legal, fecha de entrada en vigor y formato exigido, y los paneles principales de la consola informan sobre la cobertura en lugar de emitir una calificación: Jurisdiction Deliverables 6, Lowest Impact Ratio 0.65, Items Requiring Human Action 9.
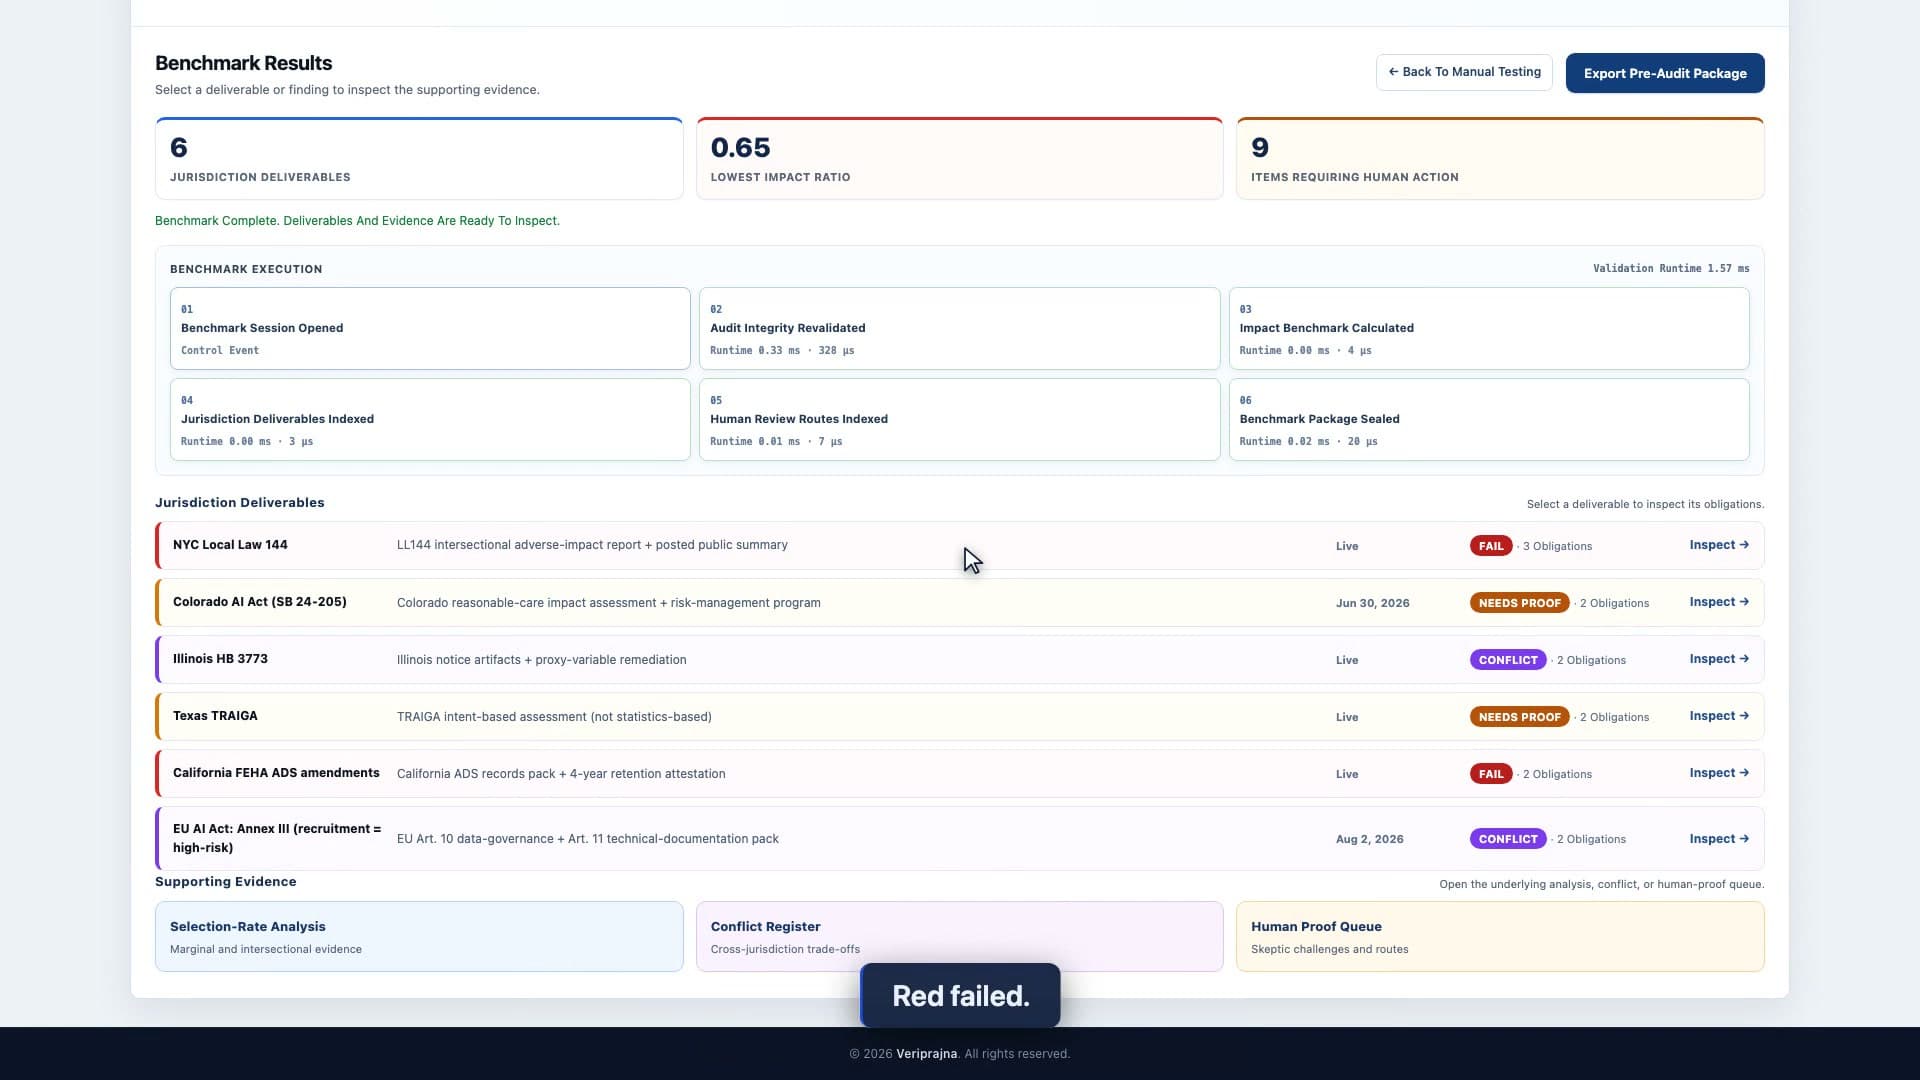
Esa columna de resultados mixtos es la respuesta honesta y también la que nadie está entregando. Investigadores de Cornell, Data & Society y Consumer Reports examinaron a 391 empleadores de NYC en busca de la auditoría exigida por la Local Law 144 y hallaron auditorías de sesgo publicadas en solo el 4.6% de ellos (FAccT 2024). La obligación está en vigor. Su cumplimiento roza el margen de error estadístico, y mi lectura es que gran parte de esa brecha se debe a empleadores que creen sinceramente que el ratio único y aprobado de su proveedor zanjaba la cuestión.
Cramér's V de 0.3321 en zip_region y dos regímenes que exigen cosas opuestas
Escribí un módulo de resolución para el problema del código postal antes de comprender realmente dicho problema, y eliminarlo fue el momento exacto en que el producto redefinió su rumbo. El motor detecta variables indirectas de categorías protegidas mediante correlación, y zip_region devuelve una Cramér's V de 0.3321 frente a la raza, 0.3253 corregida por sesgo, superando el umbral de 0.2. Se trata de una variable indirecta. Y no es una heurística que lo marque todo indiscriminadamente: school_tier se sitúa en 0.0711 en la misma ejecución y pasa sin objeciones.
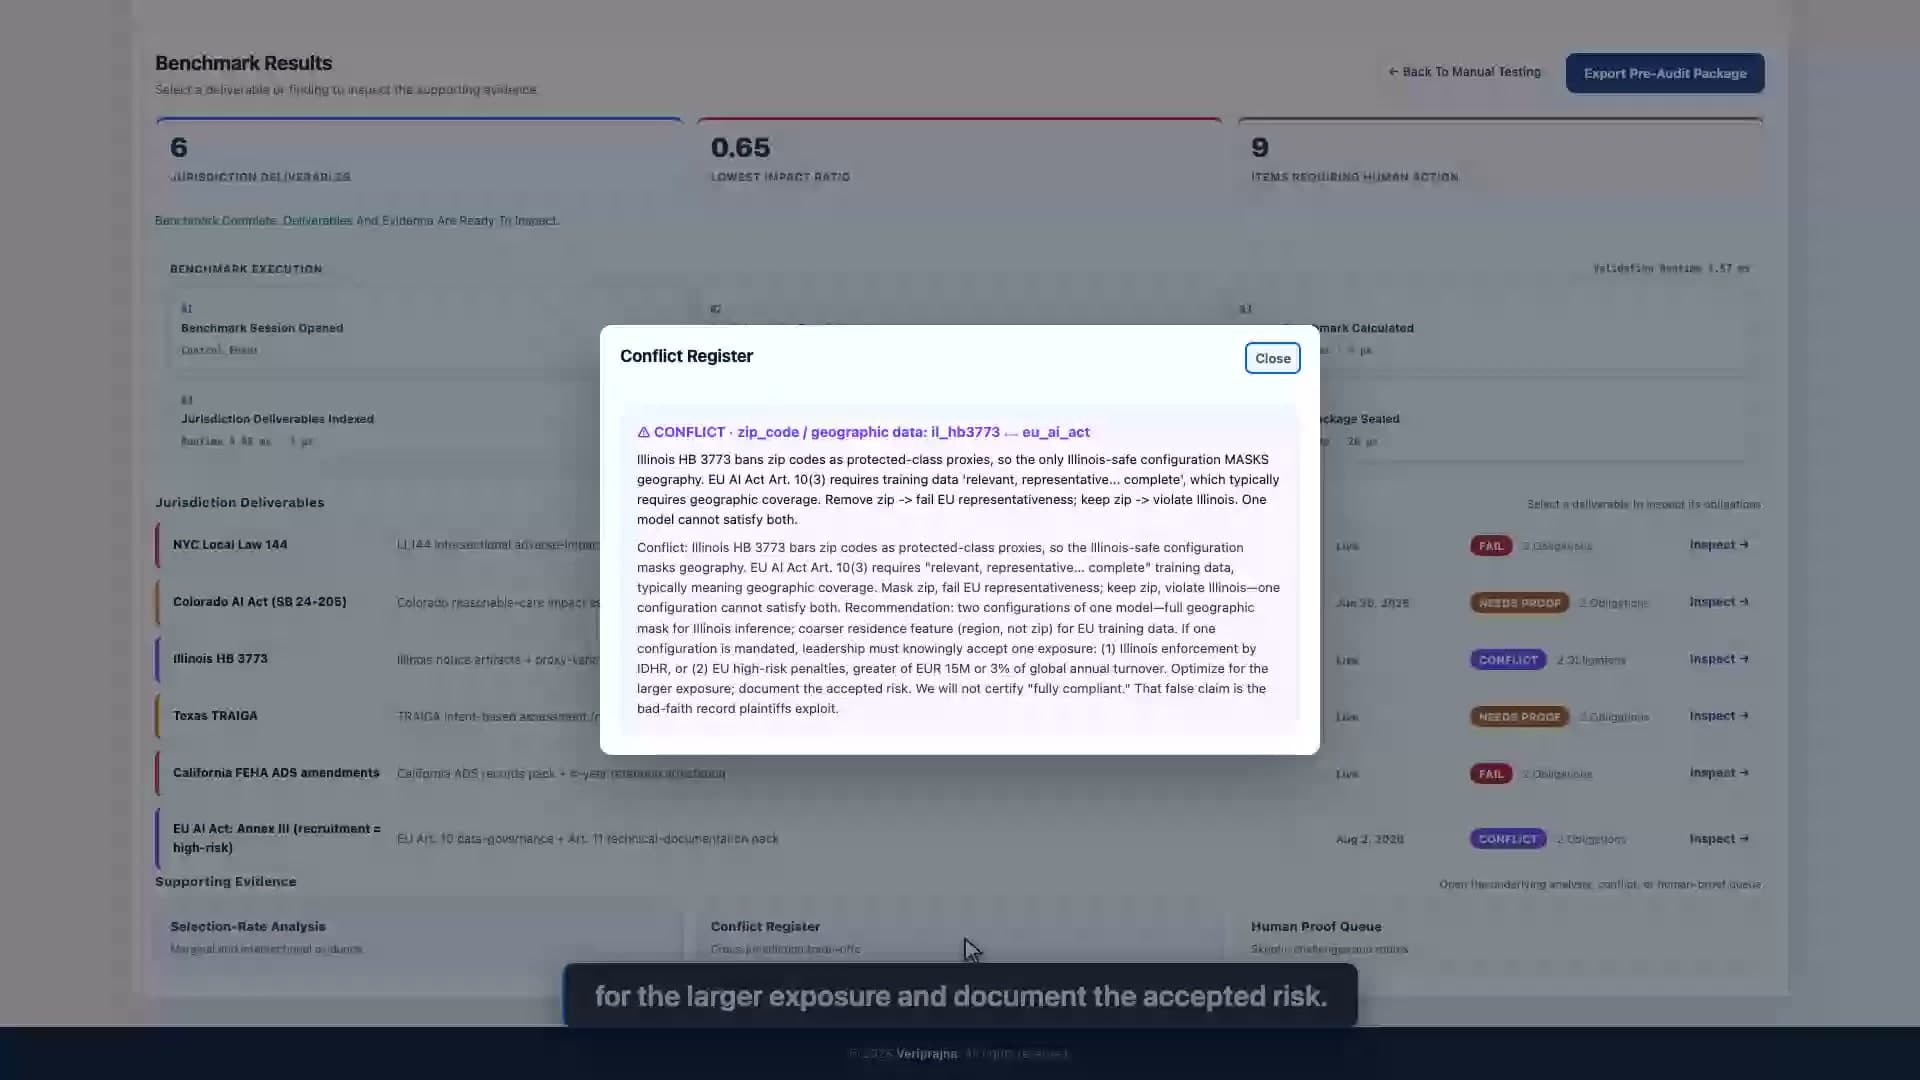
La ley HB 3773 de Illinois, en vigor desde el 1 de enero de 2026, prohíbe el uso de códigos postales como variables indirectas de clases protegidas, por lo que la configuración adaptada a Illinois enmascara la geografía. El Article 10(3) de la EU AI Act exige datos de entrenamiento relevantes, representativos y completos, lo que en la práctica depende de la cobertura geográfica que Illinois acaba de ordenar eliminar. Si se enmascara el campo, se debilita la obligación de representatividad de la UE. Si se conserva, se infringe la normativa de Illinois. Una única configuración del modelo no puede satisfacer ambas exigencias.
Mi módulo de resolución había elegido un ganador. Comparaba ambas exposiciones de riesgo, escogía la mayor y emitía un estado favorable para el otro lado, que es exactamente la conducta que introduce una declaración falsa en un documento oficial. Lo eliminé y lo sustituí por un veredicto que el control tiene permitido emitir: CONFLICT. El reconciliador redacta entonces un memorando de estrategia legal en lugar de una certificación. Aplique dos configuraciones de despliegue: un enmascaramiento geográfico total para la inferencia en Illinois y una característica regional más agregada para los datos de entrenamiento de la UE. O bien, si se exige una única configuración, elija el régimen con mayor exposición y documente el riesgo asumido, señalando que las sanciones de alto riesgo de la UE alcanzan como máximo legal la cifra más alta entre 15 millones de euros o el 3% de la facturación anual global.
Un panel de control que dice que todo cumple la normativa es, en una sala judicial, una prueba incriminatoria. Un memorando que dice sabíamos esto, valoramos el coste de ambas opciones y elegimos conscientemente es una defensa.
Esa es la decisión que yo tomaría como director de asesoría jurídica en cada ocasión, y es la opción que ningún producto concebido para tranquilizar a un comprador ofrecerá jamás, porque la versión tranquilizadora se vende mejor justo hasta el momento de la declaración testifical.
Intenté convencer a mi propio sistema para que aprobara
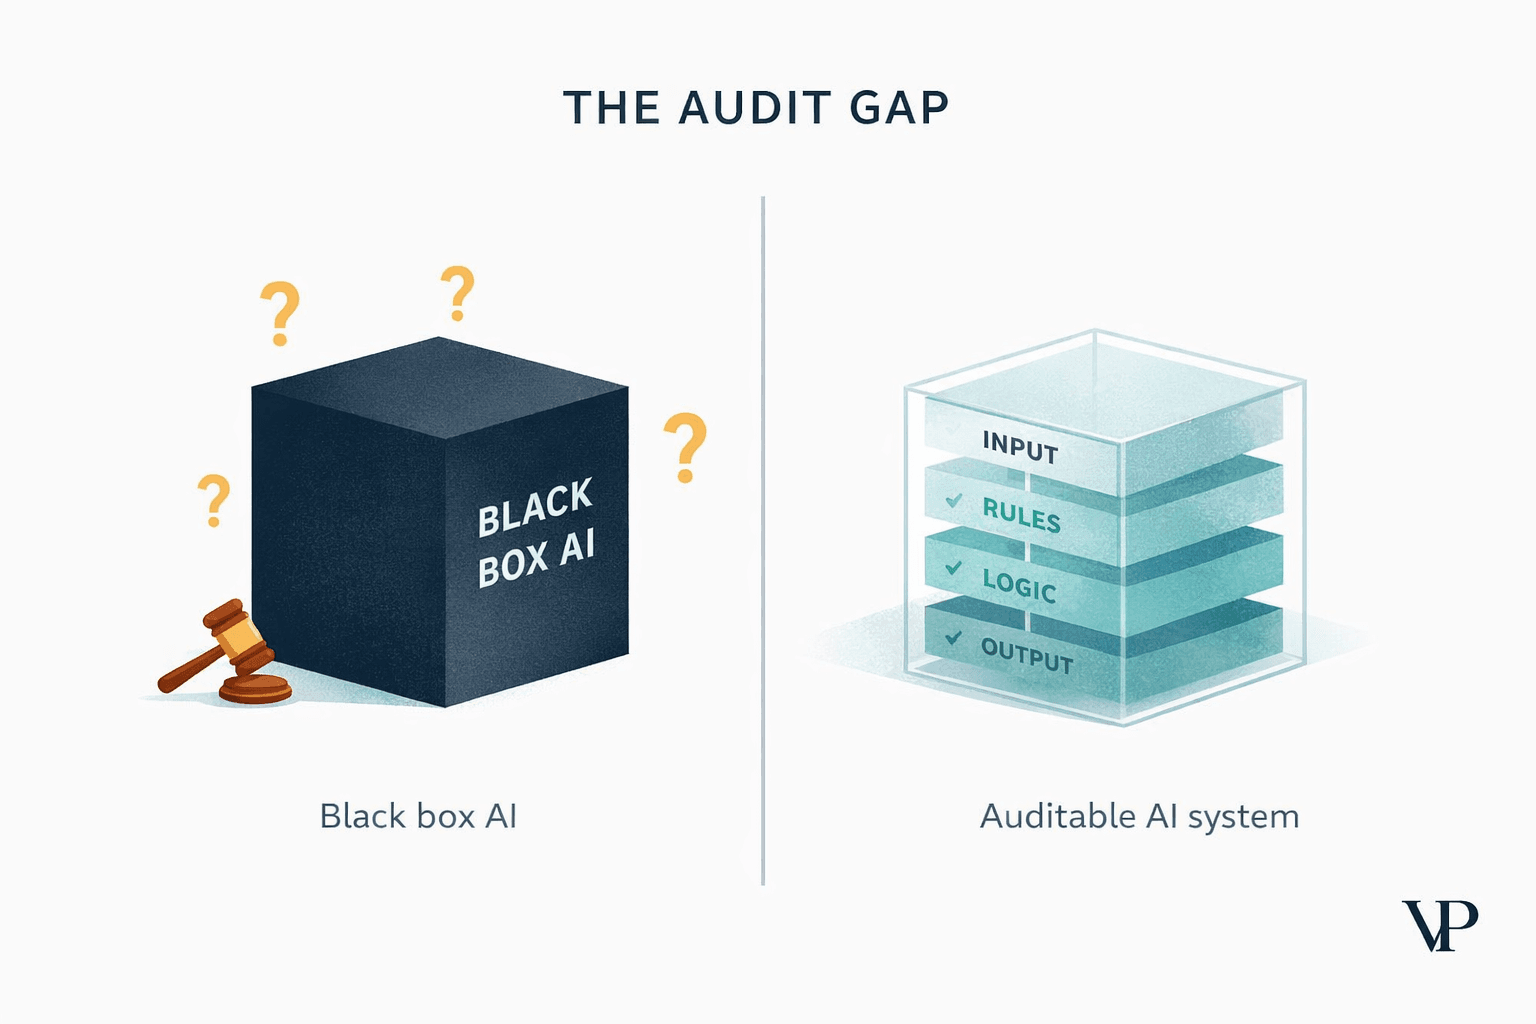
Llevé a cabo el experimento que más temía: averiguar si podía manipular las instrucciones del prompt para obtener un mejor veredicto. Hay seis agentes de jurisdicción en Clarion, además de un reconciliador de conflictos y un escéptico adversario, desarrollados sobre Pydantic AI y con proveedores intercambiables. Reescribí el prompt de narración para inclinarlo a la condescendencia, del mismo modo que un proveedor bajo presión trimestral tendería a ser benevolente. La prosa se volvió más amable. Ni un solo número varió y ni un solo veredicto cambió, porque cada estadística, cada comparación de umbrales y cada decisión de control reside en engine.py y rulepacks.py, totalmente al margen del marco de agentes.
La misma propiedad se manifiesta a la inversa. Sin ningún proveedor de modelos configurado, el equipo recurre a plantillas deterministas y la aplicación funciona de forma idéntica: los mismos seis entregables, el mismo 0.6471, el mismo CONFLICT. Los agentes asesoran, el código decide, y 12 de 12 pruebas del motor fijan la verdad fundamental deliberadamente introducida para que el aprobado marginal y el fallo interseccional no puedan discrepar entre ejecuciones.
Los agentes pueden interpretar una ley y redactar un memorando. No pueden ser los encargados de decidir si se cruzó un umbral, porque su consentimiento se puede comprar con un prompt mejor estructurado.
No empecé con esa visión. Empecé pensando que los agentes eran el producto y que el cálculo aritmético era mera fontanería, y estaba en un error absoluto. Cambié de proveedor, cambié el prompt, ejecuté el sistema sin clave alguna y el motor siguió arrojando 0.6471 en Black / Female y CONFLICT en zip_region. Cualquier mejora que introduzca en el modelo perfecciona la redacción del memorando, pero nada de lo que un auditor verificaría.
Tres teorías jurídicas que una auditoría de sesgo superada jamás contempló
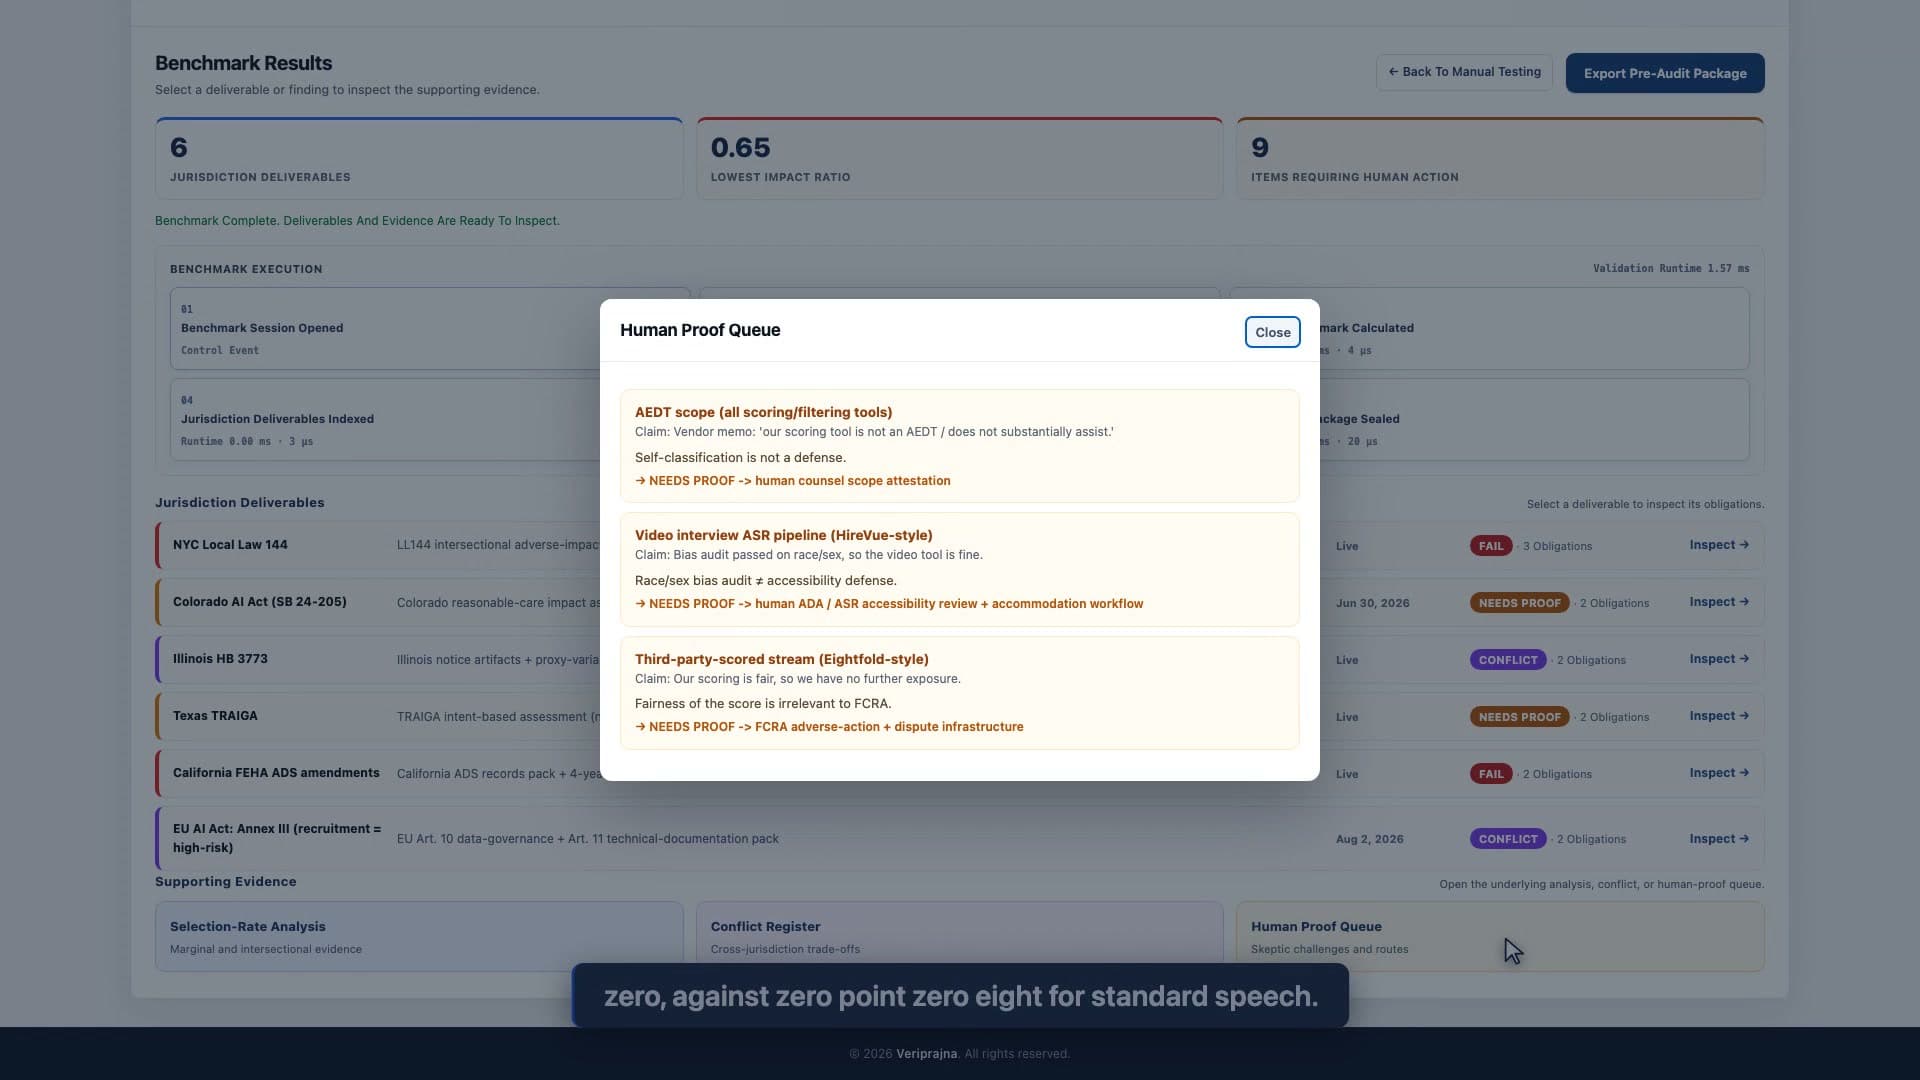
Construí el evaluador escéptico adversario esperando que discutiera sobre estadística, y en su lugar dedicó su tiempo a debatir sobre el alcance. Se niega a dar luz verde a tres aspectos, y cada uno es una teoría jurídica independiente que una auditoría de sesgo aprobada no cubre.
La primera es la autoclasificación. Un memorando de proveedor que afirme que "nuestro sistema de puntuación no es un AEDT" queda rechazado, porque según la teoría del agente planteada en Mobley v. Workday, una herramienta que recomienda o filtra candidatos interviene directamente en la decisión. Esa teoría no cuenta con resolución judicial firme, no constituye jurisprudencia vinculante, motivo por el cual el asunto se remite a asesores jurídicos humanos para un testimonio de alcance en lugar de asignársele un color de estado.
La segunda es la accesibilidad. En los 432 candidatos que pasaron por la ronda de video, la tasa de error por palabra es de 0.0794 para el habla estándar y de 0.3016 para los 104 candidatos con habla no estándar: una disparidad de 3.8 veces que la Local Law 144 nunca evalúa, ya que la LL144 se enfoca en raza y sexo. La teoría planteada en D.K. v. Intuit/HireVue es una teoría amparada en la ADA, y sale indemne de una auditoría de sesgo impecable. Clarion detecta la disparidad y la canaliza a una revisión humana de la ADA. No diseña el flujo de trabajo de adaptaciones, y no voy a fingir lo contrario.
La tercera es la FCRA, a la que la imparcialidad no le importa en absoluto. En esta exportación, 510 candidatos fueron calificados a partir de datos recopilados de terceros mediante scraping y filtrados por una puntuación numérica, el patrón en disputa en Kistler v. Eightfold. Si la plataforma califica como agencia de informes crediticios del consumidor, a cada candidato puntuado se le debe una notificación de acción adversa y una vía de reclamación, al margen de cuán equilibrados resulten los desenlaces. Clarion detecta el detonante y lo deriva a la infraestructura de impugnación y acción adversa. Tampoco construye el portal para los candidatos. Encuentro esta la menos intuitiva de las tres, y la más propensa a ser pasada por alto por un equipo que haya hecho todo impecablemente en materia de equidad, porque ninguna estadística revela la respuesta. La pregunta que plantea la FCRA se refiere a lo que la plataforma es, y una empresa puede superar cada ratio de impacto del informe y aun así adeudar a varios cientos de personas una notificación que jamás llegó a remitir.
El paquete que pondría en manos de quien deba firmarlo
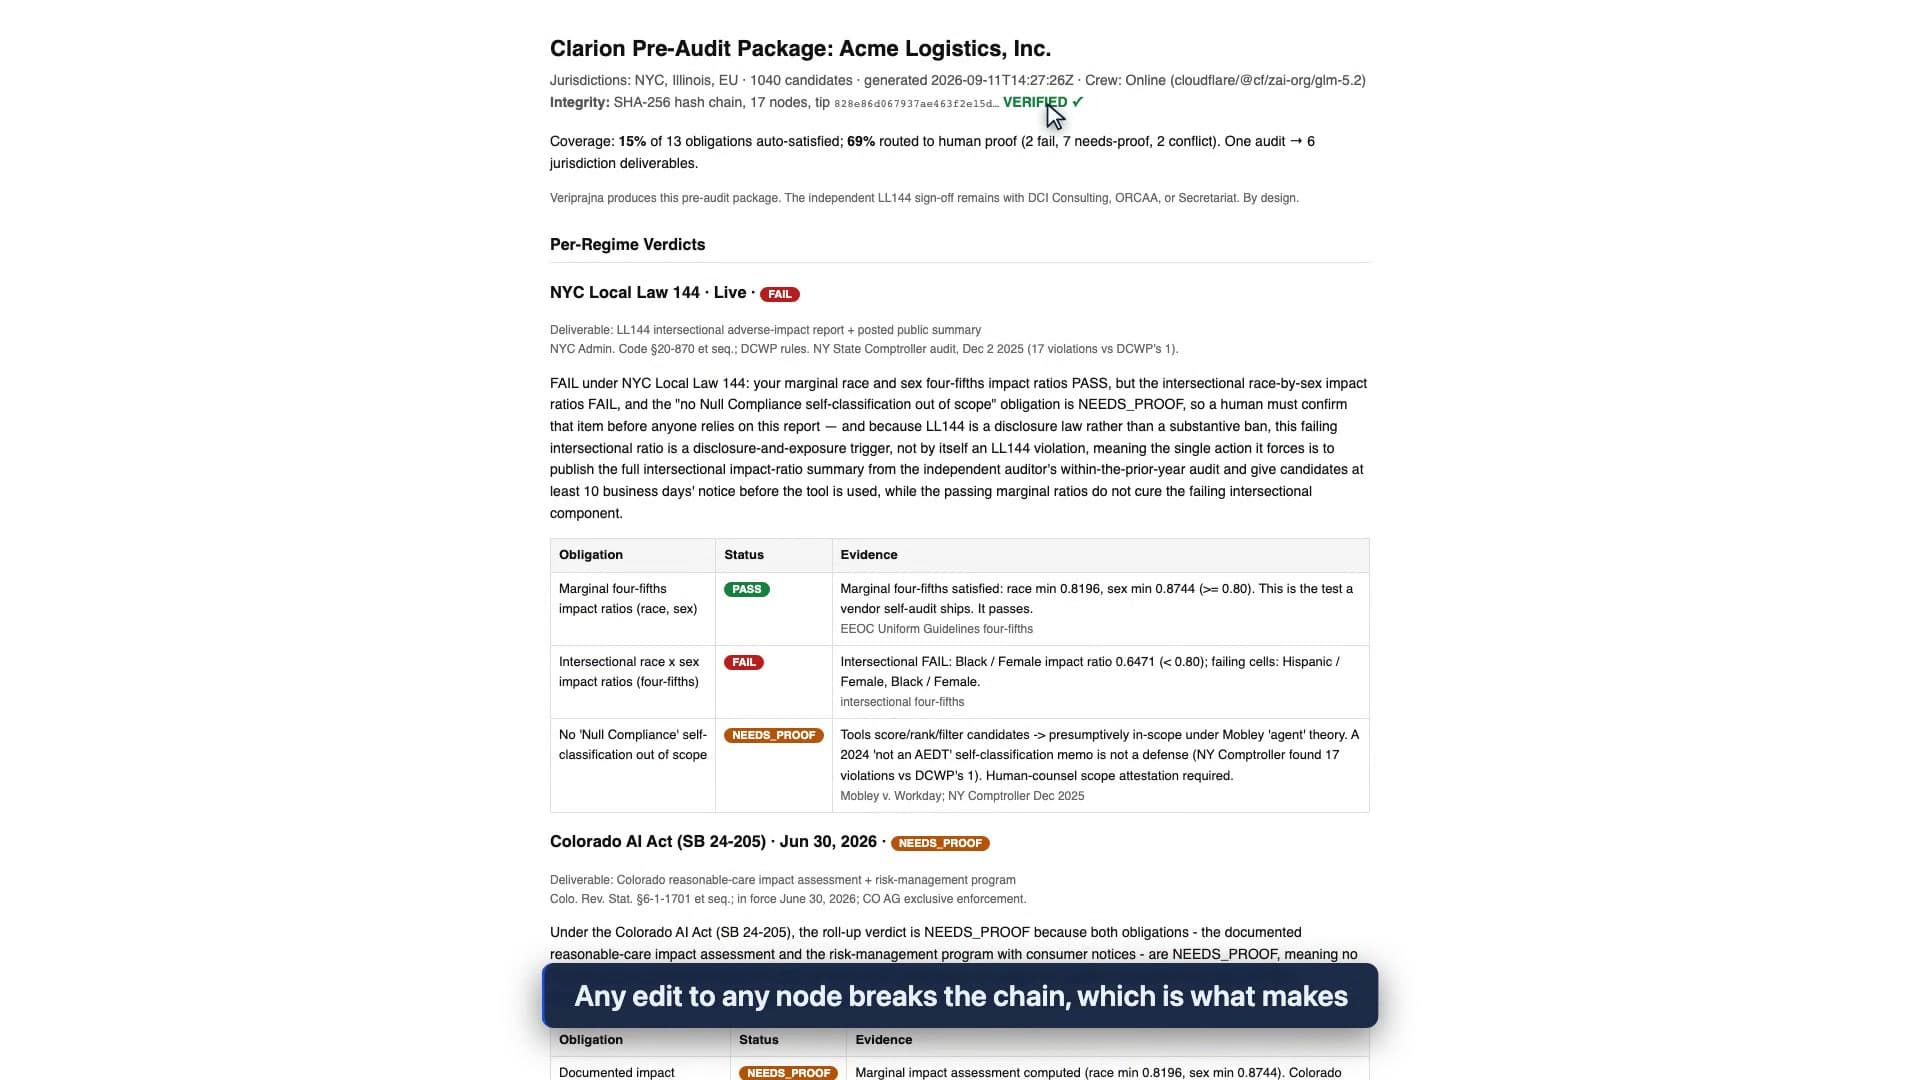
Mantuve una pregunta pegada frente a mí durante todo el desarrollo: ¿qué necesita la persona que realmente firma esto?, y no es una puntuación. Entre los seis marcos regulatorios, el motor evalúa 13 obligaciones y devuelve 2 PASS, 2 FAIL, 7 NEEDS_PROOF y 2 CONFLICT. Expresado como cobertura sobre esta exportación sintética preconfigurada, 2 de las 13 obligaciones se satisfacen automáticamente solo con los datos, y 9 de 13 se remiten a una persona designada porque son NEEDS_PROOF o CONFLICT. En un sistema que se vende como automatización, esa proporción parecería un fracaso. Como auditoría, es la única presentación bajo la cual estamparía mi firma.
La exportación es un paquete de 17 nodos encadenados mediante hash SHA-256, donde cada nodo se enlaza al hash del nodo previo, de tal modo que cualquier edición a cualquier nodo quiebra la cadena. Se genera como JSON y como un paquete HTML imprimible, donde cada cifra lleva asociados sus datos de entrada y su cómputo, y cada veredicto incluye su cita reglamentaria. La cadena se verifica en cada ejecución y la detección de manipulaciones está probada mediante pruebas unitarias.
Veriprajna no firma esto. La función de auditor independiente para la Local Law 144 corresponde a firmas como DCI, ORCAA y Secretariat, y el objetivo de diseño fundamental del paquete es que una de ellas pueda firmarlo sin tener que reescribirlo antes. La guía explicativa del proceso completo, incluido el memorando de conflicto, está disponible en veriprajna.com/demos/ai-hiring-compliance.
Y si prefiere ver cómo el control rechaza la aprobación en lugar de leerme describirlo, aquí tiene la ejecución completa de principio a fin, memorando de conflicto incluido.
El memorando de conflicto deja al empleador exactamente con el mismo nivel de cumplimiento que tenía el día anterior. Lo que añade es un balance de riesgos legible, fechado y atribuible, de modo que dentro de dos años, cuando alguien pregunte quién decidió conservar el campo del código postal y qué sabía cuando tomó la decisión, exista un documento que responda en lugar de una insignia verde que haya que justificar.