L'Illinois vieta il campo del codice postale che l'EU AI Act vuole mantenere. Ho creato un audit per l'IA nelle assunzioni che lo dichiara invece di stampare un via libera.

Il 2 dicembre 2025, il New York State Comptroller ha pubblicato un riesame dello stesso campione di 32 aziende che il Department of Consumer and Worker Protection della città aveva già esaminato ai sensi della Local Law 144, rilevando 17 potenziali violazioni dove il DCWP ne aveva riscontrata una sola. Il DCWP ha accettato di passare a un'azione di contrasto proattiva.
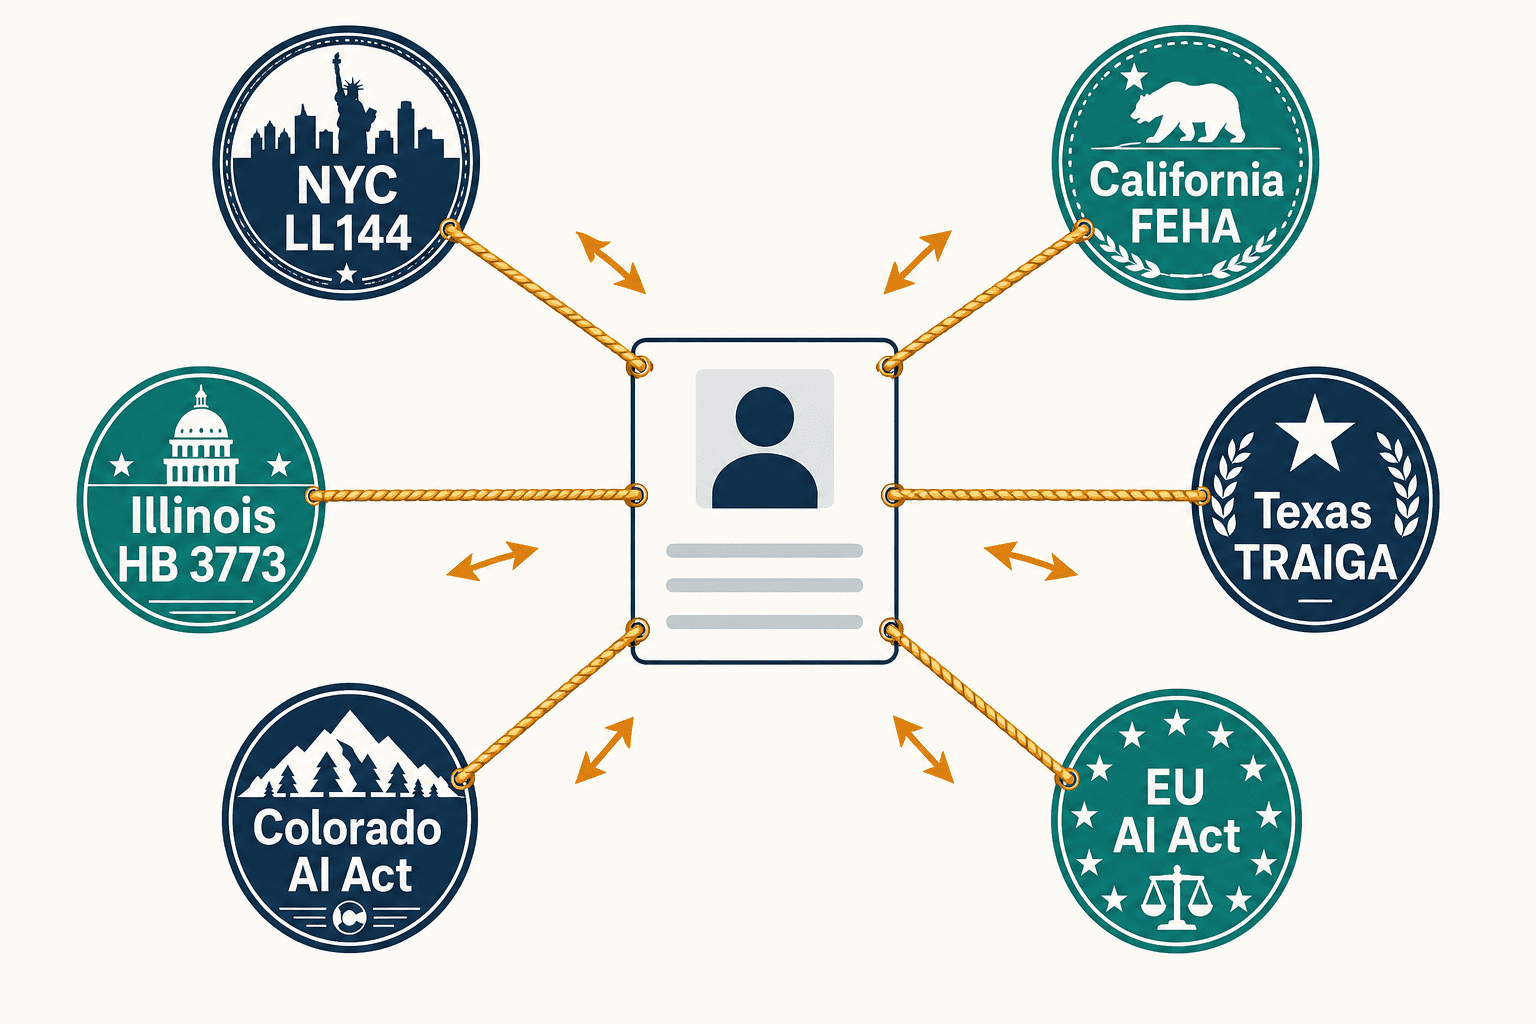
Leggendo quella notizia, ho pensato che il problema ingegneristico complesso fosse il rilevamento: costruire qualcosa che intercettasse i bias sfuggiti al primo passaggio. Scrivere i rule pack mi ha fatto cambiare idea, perché il rilevamento si è rivelato la metà facile del lavoro. La parte difficile è che un datore di lavoro che utilizza strumenti automatizzati di assunzione a New York, in Colorado, Illinois, Texas, California e nell'UE deve rispondere a sei autorità di regolamentazione che richiedono sei documenti strutturati in modo diverso e, in almeno un caso, due di loro esigono requisiti opposti dalla stessa colonna di dati.
Ho quindi creato un overlay di conformità per questo: una console che ho chiamato Clarion, che si innesta sopra gli strumenti di assunzione basati sull'IA già utilizzati dal datore di lavoro, legge un singolo export dei punteggi del fornitore, calcola ogni statistica di impatto negativo in codice deterministico e distribuisce quell'unico audit in sei deliverable conformi a ciascuna giurisdizione. Puoi vedere come funziona all'indirizzo veriprajna.com/demos/ai-hiring-compliance. Tutto ciò che segue viene eseguito su un export sintetico e controllato di 1.040 profili di candidati per un datore di lavoro fittizio, "Acme Logistics, Inc.", sulla posizione REQ-2026-0412. Ho inserito io stesso la violazione in quei dati, ed è l'unico motivo per cui posso spiegare con esattezza cosa il motore avrebbe dovuto trovare.
L'audit che viene superato non è l'audit richiesto dalla legge
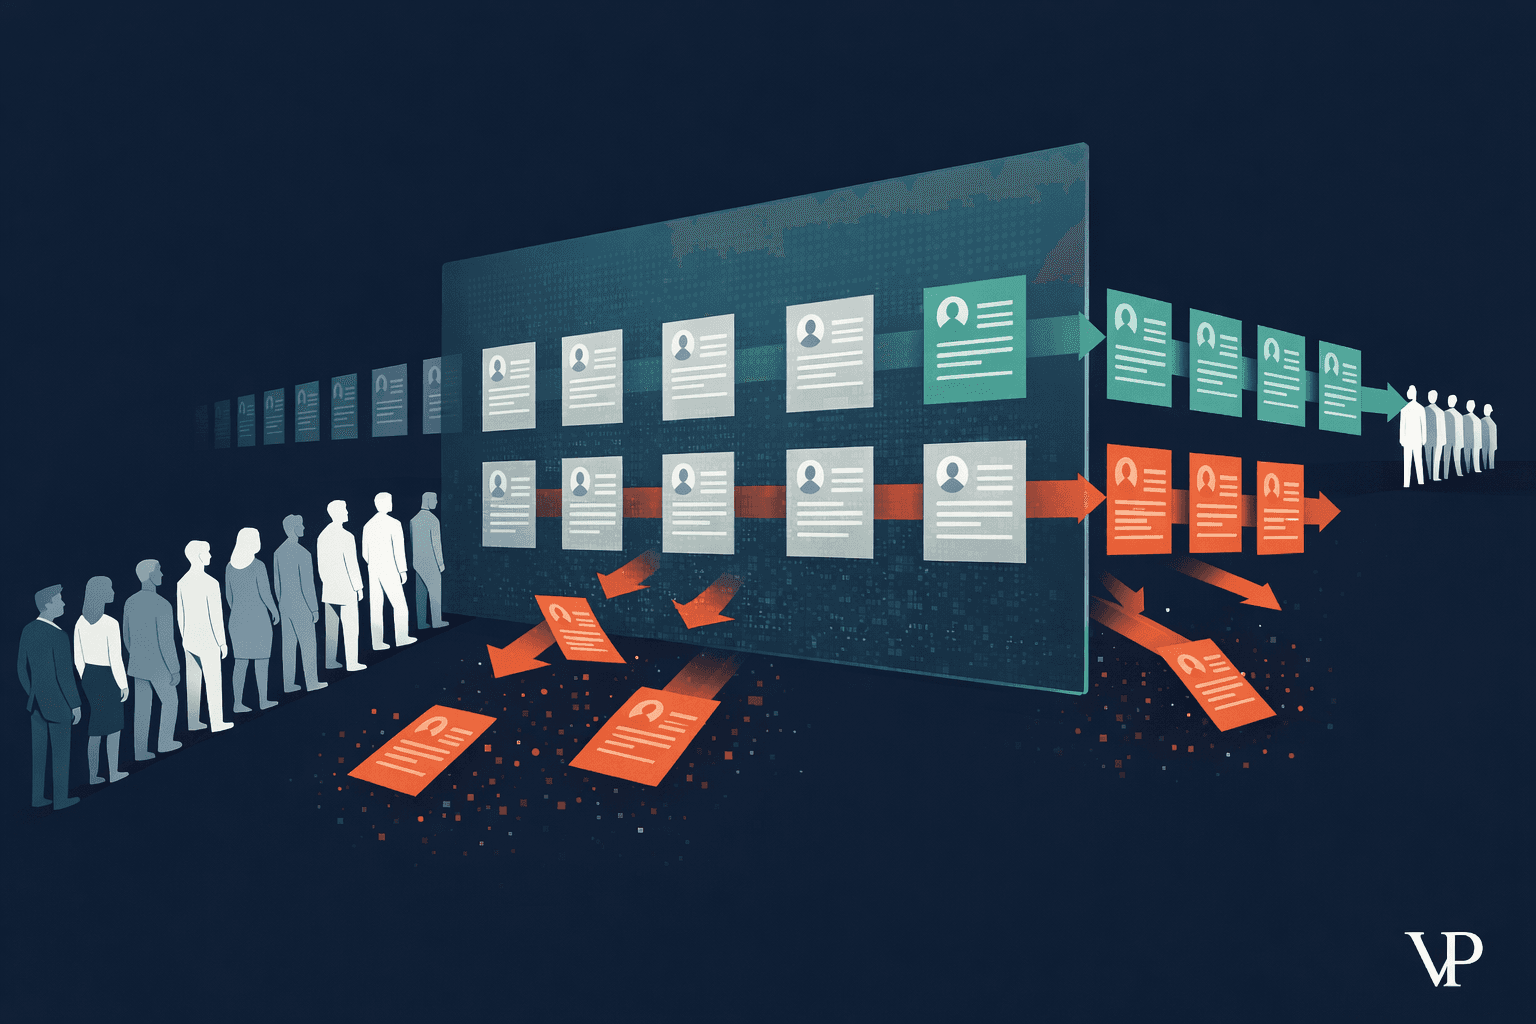
Avendo impostato io stesso il dataset, il primo risultato è comunque riuscito a infastidirmi. Il test marginale dei quattro quinti, quello fornito dall'auto-audit del fornitore, passa senza problemi: rapporto di impatto minimo per razza pari a 0.8196, con candidati ispanici e neri appaiati a tale minimo, e rapporto minimo per sesso pari a 0.8744. Entrambi si collocano pari o al di sopra della soglia di 0.80. Nulla nel codice forza questo superamento. Lo 0.8196 è ciò che il calcolo restituisce sul fixture, e supera la soglia in piena autonomia. Sullo schermo il riepilogo delle percentuali lo dice a chiare lettere: il fornitore si ferma qui.
La Local Law 144 non si ferma qui. Richiede rapporti intersezionali incrociando razza e sesso, e i candidati sintetici vengono valutati da tre strumenti simulati (un modulo di scoring in stile Workday Spotlight, una sessione video in stile HireVue, un motore di abbinamento in stile Eightfold) che fungono da adattatori per fixture su quei dati sintetici: archetipi anziché integrazioni complete. Suddividendo gli stessi record per razza e sesso, il quadro si capovolge. Rispetto alla cella di riferimento White / Male, che fa avanzare 68 candidati su 130 con il 52,31%, la cella Black / Female ne fa avanzare 44 su 130, ossia il 33,85%. Rapporto di impatto 0.6471. Anche Hispanic / Female fallisce, a 0.7647.
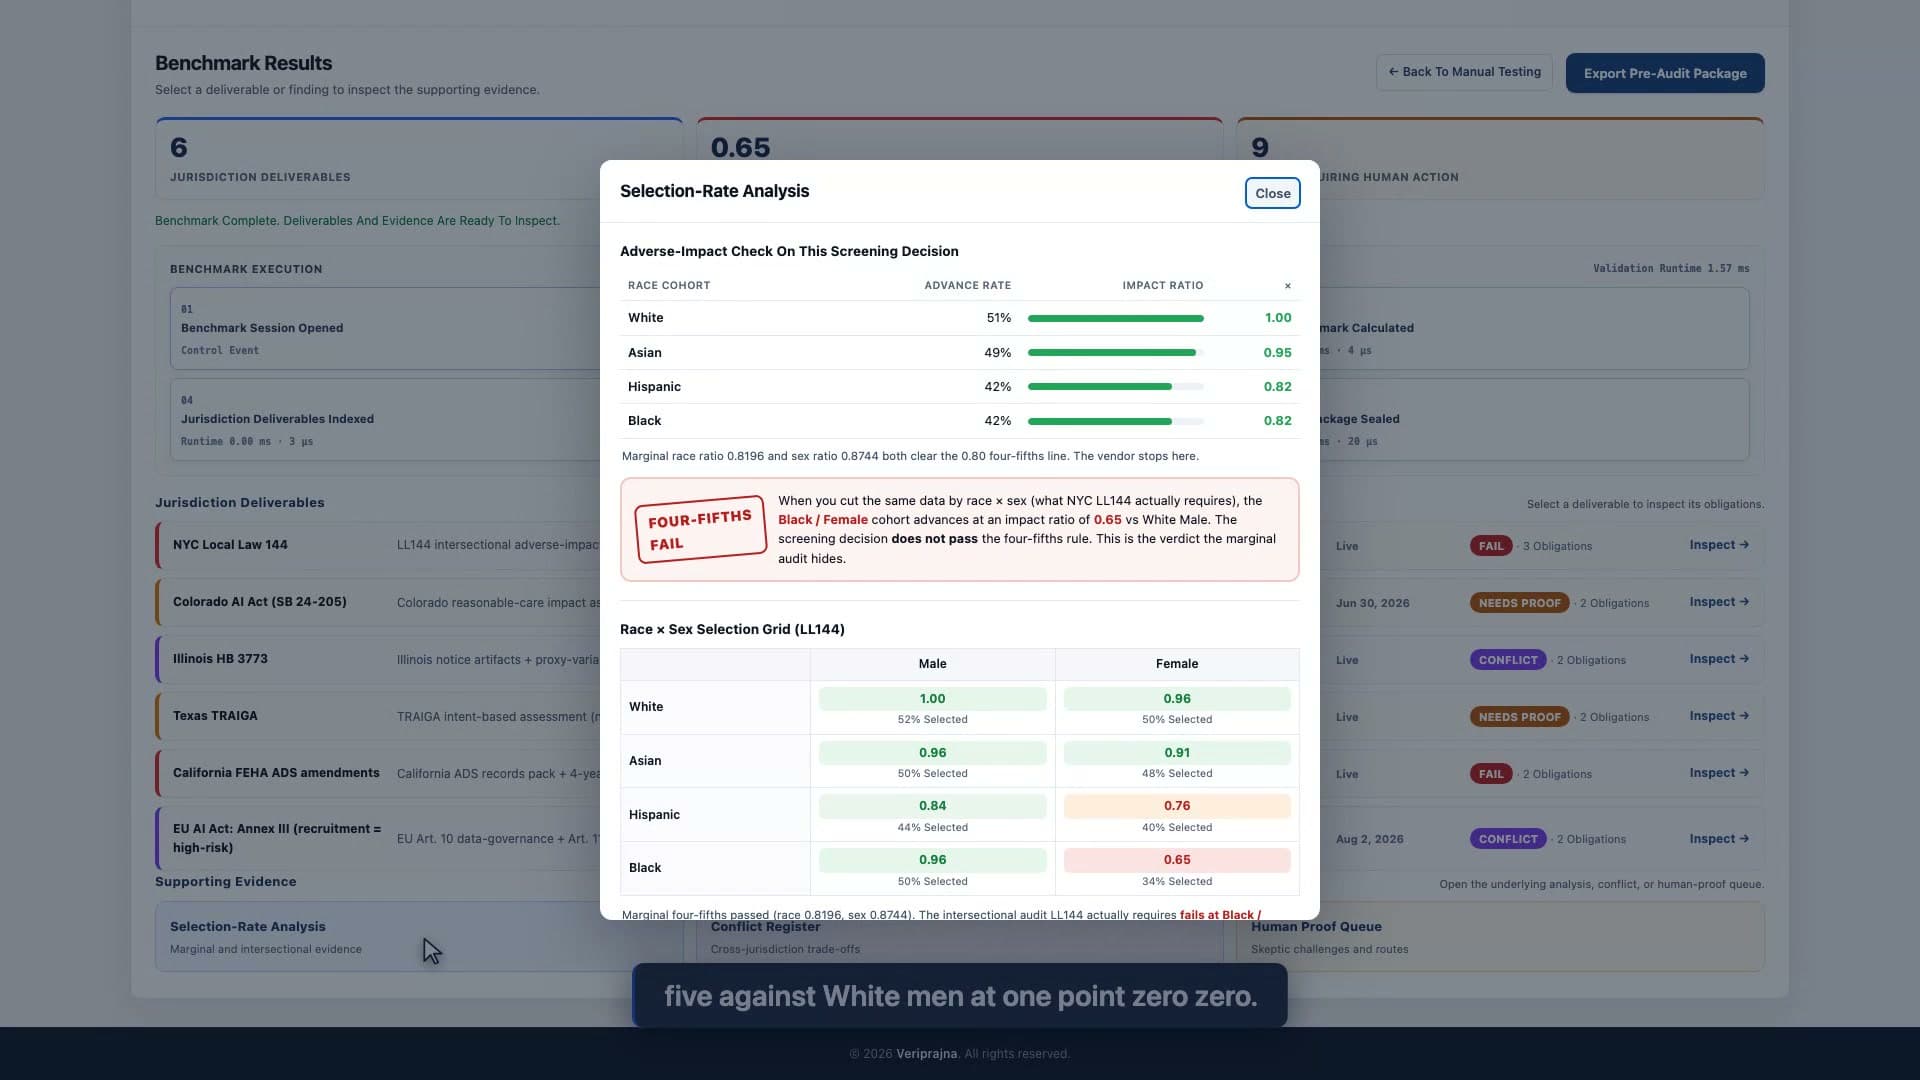
È sulla cella Hispanic / Female che mi sono trovato in disaccordo con il mio stesso motore. Con il controllo del tasso di falsi positivi di Benjamini-Hochberg con alfa a 0,05, solo la cella Black / Female risulta statisticamente solida, con q = 0.0185. Hispanic / Female si attesta a q = 0.1629, quindi il motore la segnala ma rifiuta esplicitamente di definirla significativa. Volevo che entrambe le celle contassero, perché due celle non conformi raccontano una storia più incisiva di una sola. Il motore distingue un risultato robusto da uno dovuto al caso, che è esattamente lo stesso rigore che vorrei venisse applicato ai miei numeri se fossi il datore di lavoro dall'altra parte del report.
Sei autorità di regolamentazione, sei documenti diversi
Ho scritto i sei rule pack uno dopo l'altro continuando a cercare di condensarli in un unico punteggio, perché un solo numero è quanto una dashboard può contenere ed è ciò che un acquirente si aspetta. Ma questa idea non ha retto al confronto con le normative. NYC richiede un report di impatto negativo intersezionale unitamente a una sintesi pubblica pubblicata online. La legge SB 24-205 del Colorado richiede una valutazione d'impatto documentata improntata alla ragionevole diligenza e un programma di gestione del rischio, senza specificare alcuna metodologia, in vigore dal 30 giugno 2026. Il TRAIGA del Texas respinge l'impatto eterogeneo come fondamento autonomo e interroga sull'intenzionalità. Gli emendamenti FEHA ADS della California sono in vigore dal 1° ottobre 2025 e richiedono a loro volta una specifica struttura documentale. L'EU AI Act considera il recruiting ad alto rischio ai sensi dell'Annex III e impone la governance dei dati ex Article 10 oltre a un fascicolo tecnico ex Article 11, a partire dal 2 agosto 2026.
L'idea del punteggio unico è tramontata definitivamente con il pack del Texas. Avevo già costruito il deliverable per NYC basandomi sui rapporti intersezionali, e il TRAIGA rende proprio quelle statistiche irrilevanti sul piano probatorio per la propria valutazione; non esisteva quindi alcuna ponderazione applicabile che consentisse a un singolo numero di esprimere entrambe le cose. Sei domande diverse, formulate con sei strutture distinte, alle quali un punteggio di equità risponde a malapena a una e mezza. Clarion genera quindi sei deliverable, ciascuno con la propria citazione normativa, data di entrata in vigore e struttura prescritta, e i riquadri principali della console segnalano la copertura invece di un voto: Jurisdiction Deliverables 6, Lowest Impact Ratio 0.65, Items Requiring Human Action 9.
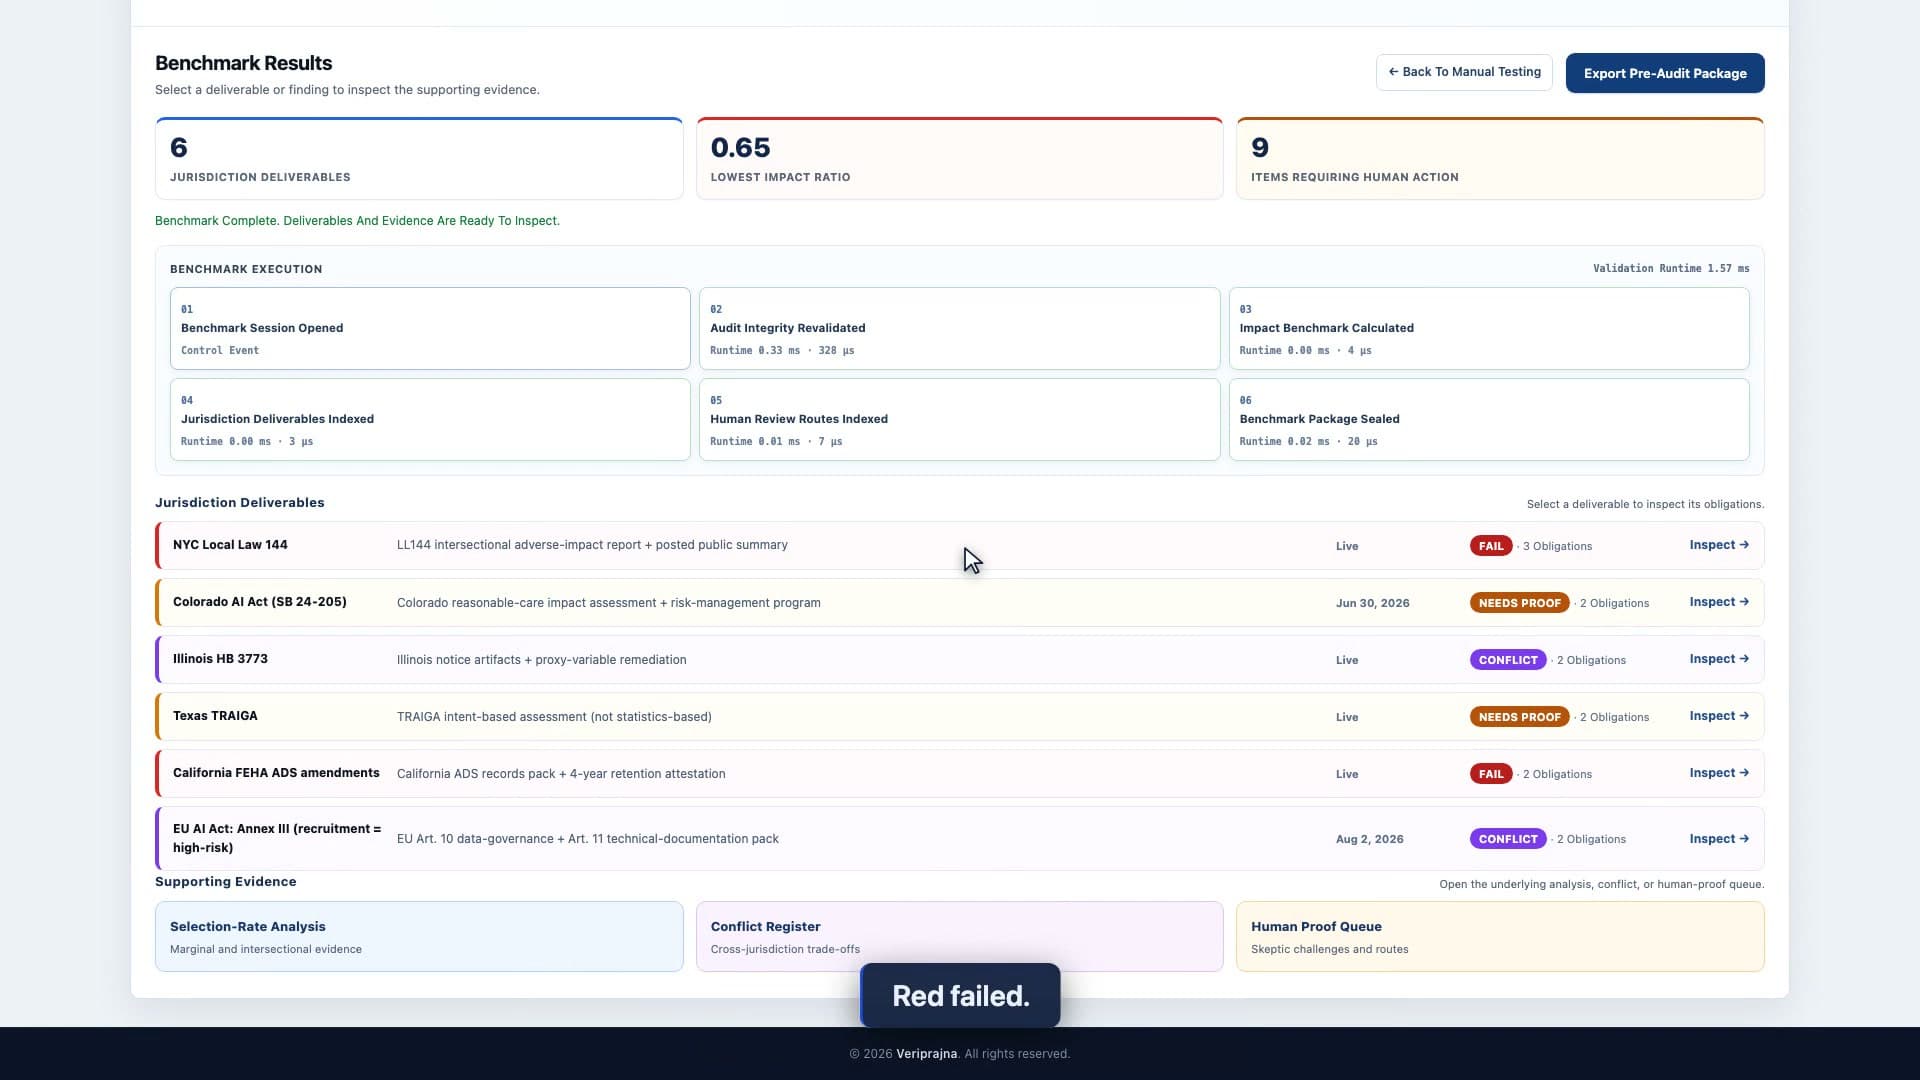
Quella colonna con risultati eterogenei è l'output onesto, ed è anche quello che nessuno fornisce. I ricercatori di Cornell, Data & Society e Consumer Reports hanno esaminato 391 datori di lavoro di New York per verificare l'audit prescritto dalla Local Law 144, trovando audit sui bias pubblicati solo per il 4,6% di essi (FAccT 2024). L'obbligo è in vigore. La conformità effettiva è vicina a un errore di arrotondamento, e la mia interpretazione è che gran parte di questo divario sia dovuta a datori di lavoro convinti in buona fede che l'unico rapporto favorevole fornito dal fornitore avesse risolto la questione.
V di Cramér pari a 0.3321 su zip_region, e due regimi che esigono cose opposte
Ho scritto un modulo di risoluzione per il problema del codice postale prima ancora di averlo compreso a fondo, e la sua eliminazione è stata il momento in cui il prodotto ha cambiato fisionomia. Il motore individua le variabili proxy per le categorie protette tramite correlazione, e zip_region restituisce una V di Cramér di 0.3321 rispetto alla razza, 0.3253 corretta per il bias, superando la soglia di 0.2. Si tratta di una variabile proxy. E non è affatto un'euristica che segnala qualunque cosa: school_tier si attesta a 0.0711 nella stessa esecuzione e supera il controllo.
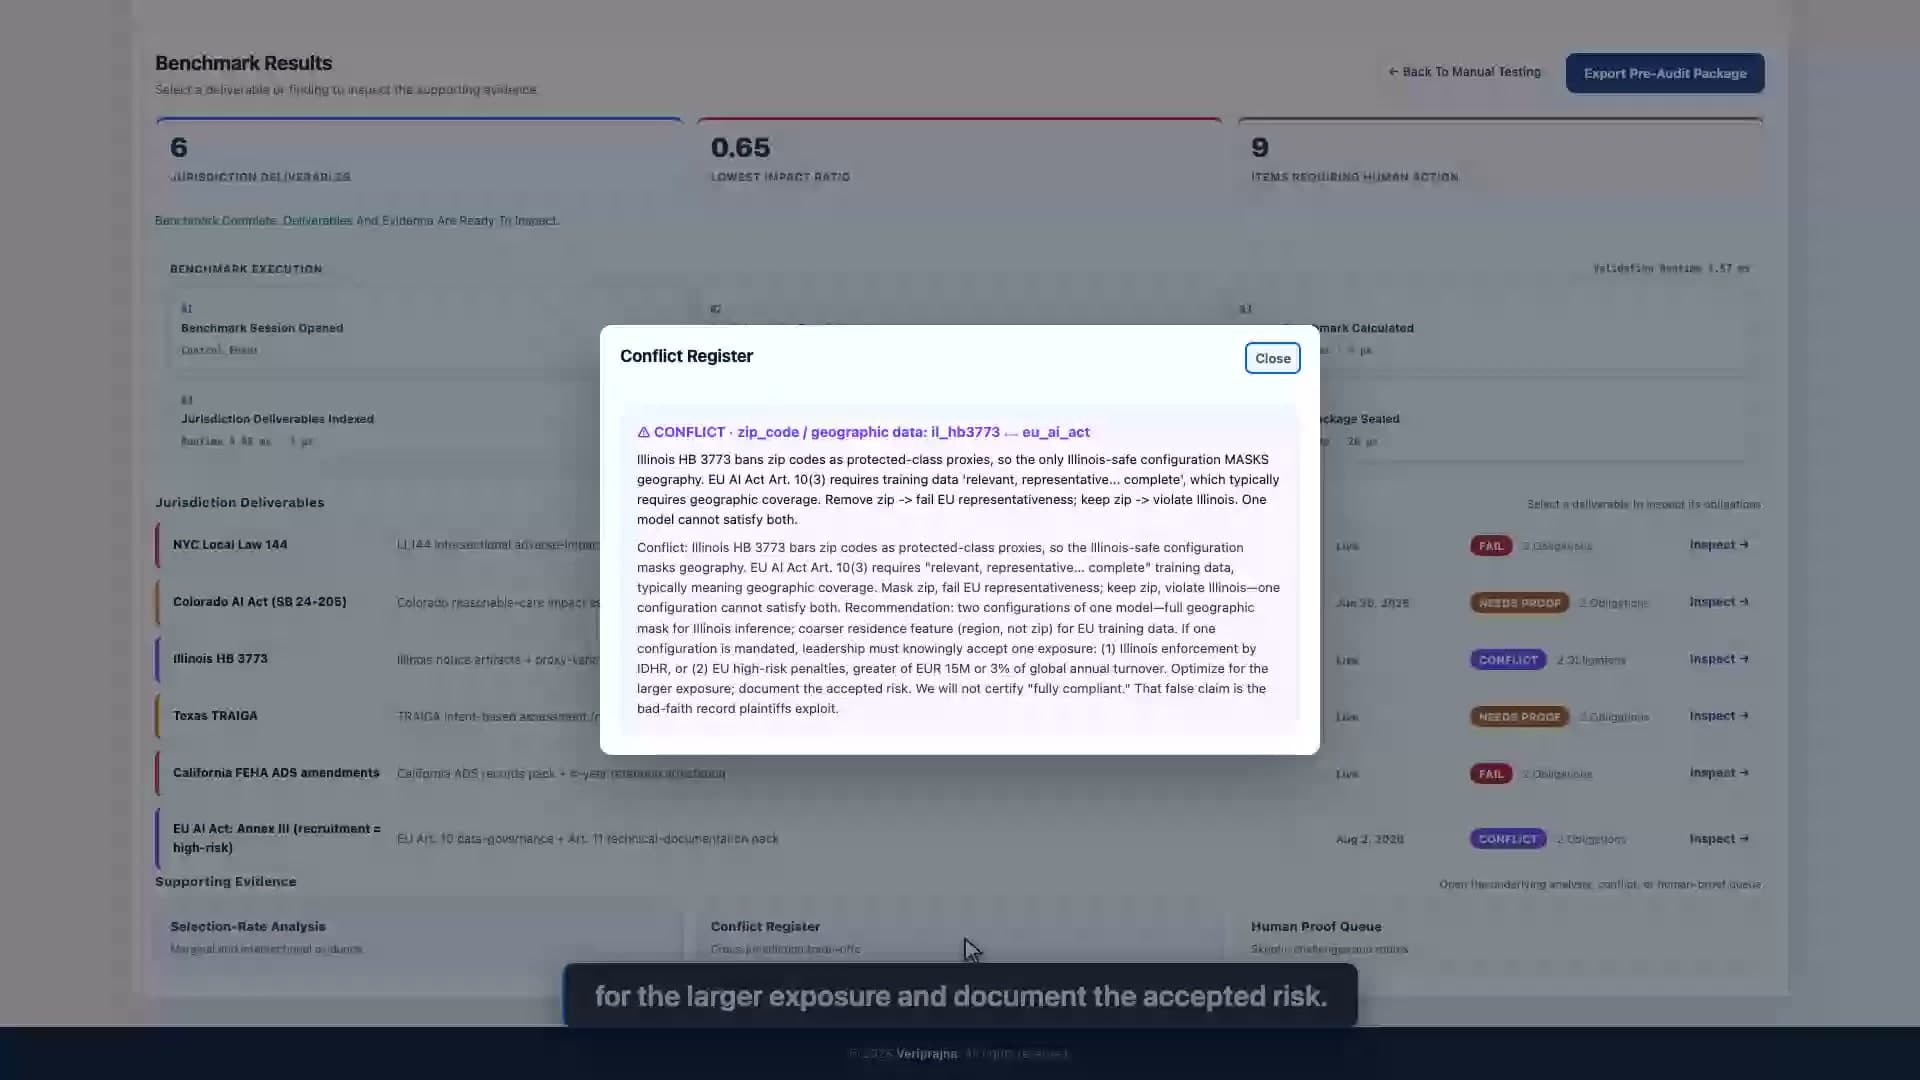
La legge HB 3773 dell'Illinois, in vigore dal 1° gennaio 2026, vieta l'uso dei codici postali come proxy di categorie protette, per cui la configurazione sicura per l'Illinois maschera il dato geografico. L'Article 10(3) dell'EU AI Act impone che i dati di addestramento siano pertinenti, rappresentativi e completi, il che nella pratica fa leva proprio sulla copertura geografica che l'Illinois ha appena imposto di rimuovere. Mascherando il campo, l'obbligo di rappresentatività dell'UE si indebolisce. Mantenendolo, si viola la norma dell'Illinois. Una sola configurazione del modello non può soddisfare entrambi i requisiti.
Il mio resolver aveva decretato un vincitore. Aveva confrontato le due esposizioni al rischio, scelto la maggiore ed emesso uno stato di conformità per l'altra parte: esattamente il comportamento che introduce una falsa dichiarazione in un atto depositato. L'ho rimosso e sostituito con un verdetto che il controllo è autorizzato a emettere: CONFLICT. Il modulo di riconciliazione redige quindi un promemoria di strategia legale invece di una certificazione. Eseguire due configurazioni di deployment: un mascheramento geografico completo per l'inferenza in Illinois e una caratteristica regionale più aggregata per i dati di addestramento nell'UE. Oppure, qualora sia obbligatoria un'unica configurazione, scegliere il regime con la maggiore esposizione e documentare il rischio accettato, tenendo presente che le sanzioni dell'UE per i sistemi ad alto rischio possono raggiungere, come massimo edittale, la cifra più elevata tra 15 milioni di euro o il 3% del fatturato annuo globale.
Una dashboard che certifica la conformità diventa, in un'aula di tribunale, una prova a carico. Un promemoria che attesta che eravamo consapevoli, abbiamo valutato entrambi i rami e abbiamo fatto una scelta consapevole, costituisce una difesa.
Questo è il compromesso che sceglierei ogni volta nei panni di un General Counsel, ed è il compromesso che nessun prodotto progettato per rassicurare l'acquirente offrirà mai, perché la versione tranquillizzante vende meglio, almeno fino al momento della deposizione giurata.
Ho tentato di convincere il mio stesso sistema a promuovere i risultati
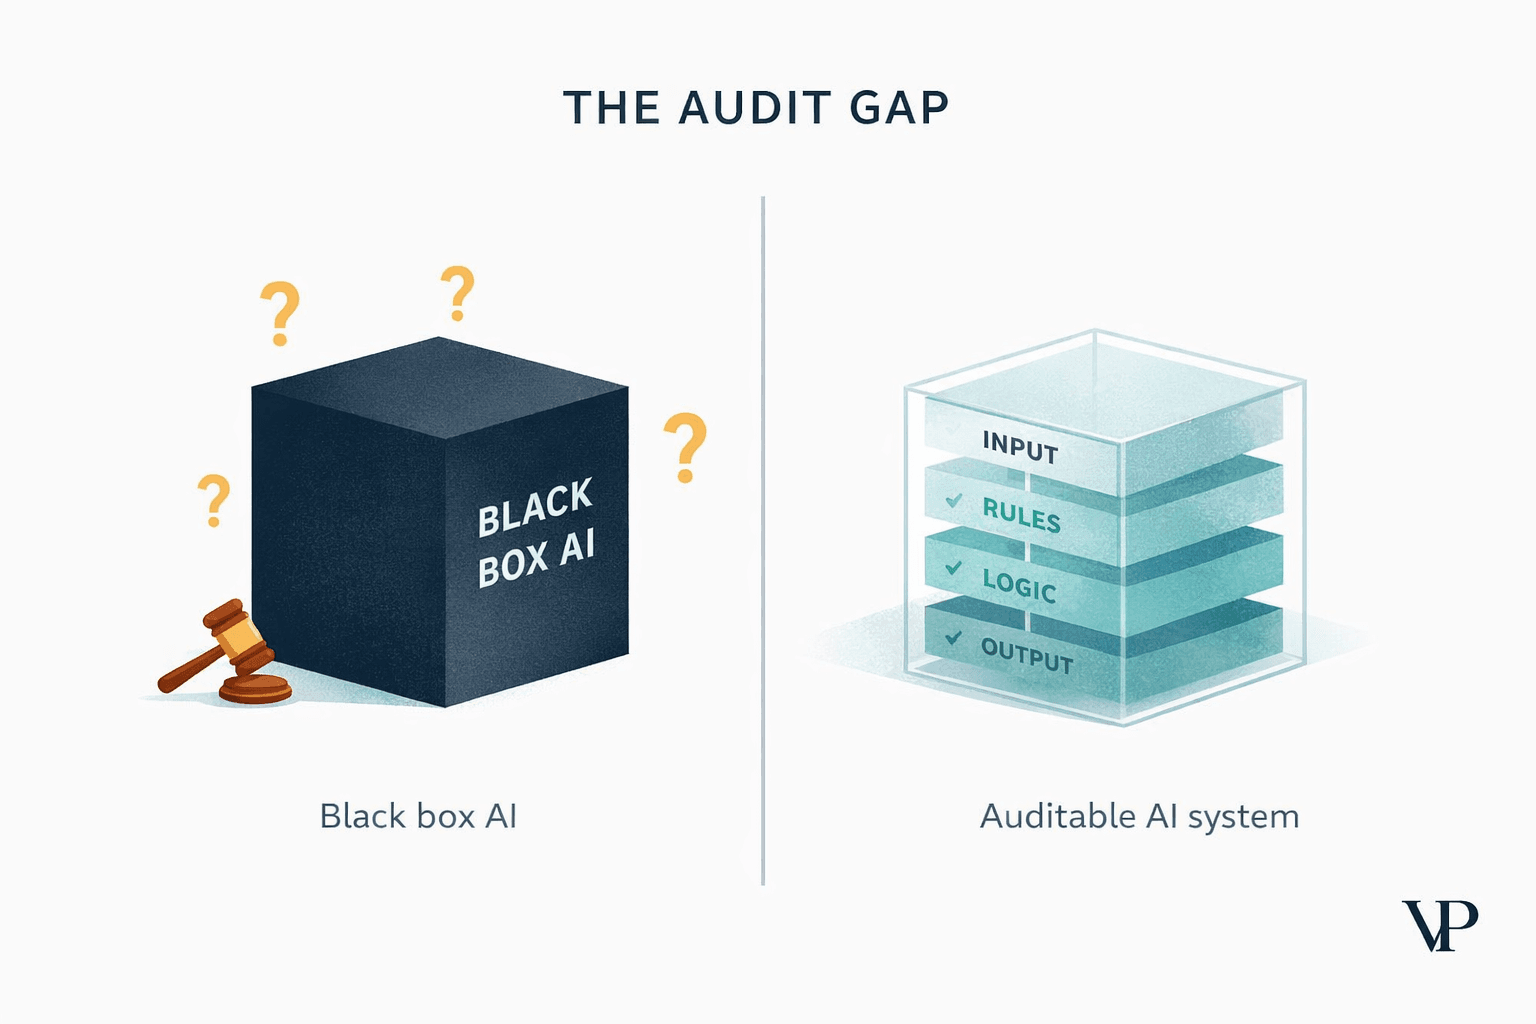
Ho condotto l'esperimento che temevo di più: scoprire se potessi manipolare i prompt per ottenere un verdetto più favorevole. In Clarion operano sei agenti di giurisdizione, oltre a un riconciliatore di conflitti e a uno scettico contraddittorio, sviluppati su Pydantic AI e con provider intercambiabili. Ho riscritto il prompt di narrazione per renderlo indulgente, esattamente come farebbe un fornitore sotto la pressione dei target trimestrali. Il tono del testo è diventato più rassicurante. Non un solo numero si è mosso e nessun verdetto è cambiato, perché ogni statistica, ogni confronto di soglia e ogni decisione dei gate risiede in engine.py e in rulepacks.py, del tutto all'esterno del framework degli agenti.
La stessa proprietà si manifesta anche nel caso inverso. Senza alcun provider di modelli configurato, il team di agenti ricorre a template deterministici e l'applicazione viene eseguita in modo identico: stessi sei deliverable, stesso 0.6471, stesso CONFLICT. Gli agenti consigliano, il codice decide, e 12 test del motore su 12 blindano la verità di fondo introdotta nei dati, impedendo che la promozione marginale e il fallimento intersezionale possano divergere tra un'esecuzione e l'altra.
Gli agenti possono leggere una legge e redigere un promemoria. Ma non possono essere l'elemento che stabilisce se una soglia sia stata superata, perché il loro consenso si può comprare con un prompt migliore.
Non sono partito con questa consapevolezza. All'inizio pensavo che gli agenti fossero il prodotto e i calcoli aritmetici fossero solo tubature di raccordo, ed era l'esatto contrario. Ho sostituito il provider, ho cambiato il prompt, l'ho eseguito del tutto privo di chiavi API, e il motore ha comunque restituito 0.6471 per Black / Female e CONFLICT su zip_region. Qualsiasi miglioramento apportato al modello affina lo stile del testo nel promemoria, ma non tocca nulla di ciò che un revisore andrebbe a verificare.
Tre teorie legali che un audit sui bias superato con successo non ha mai sfiorato
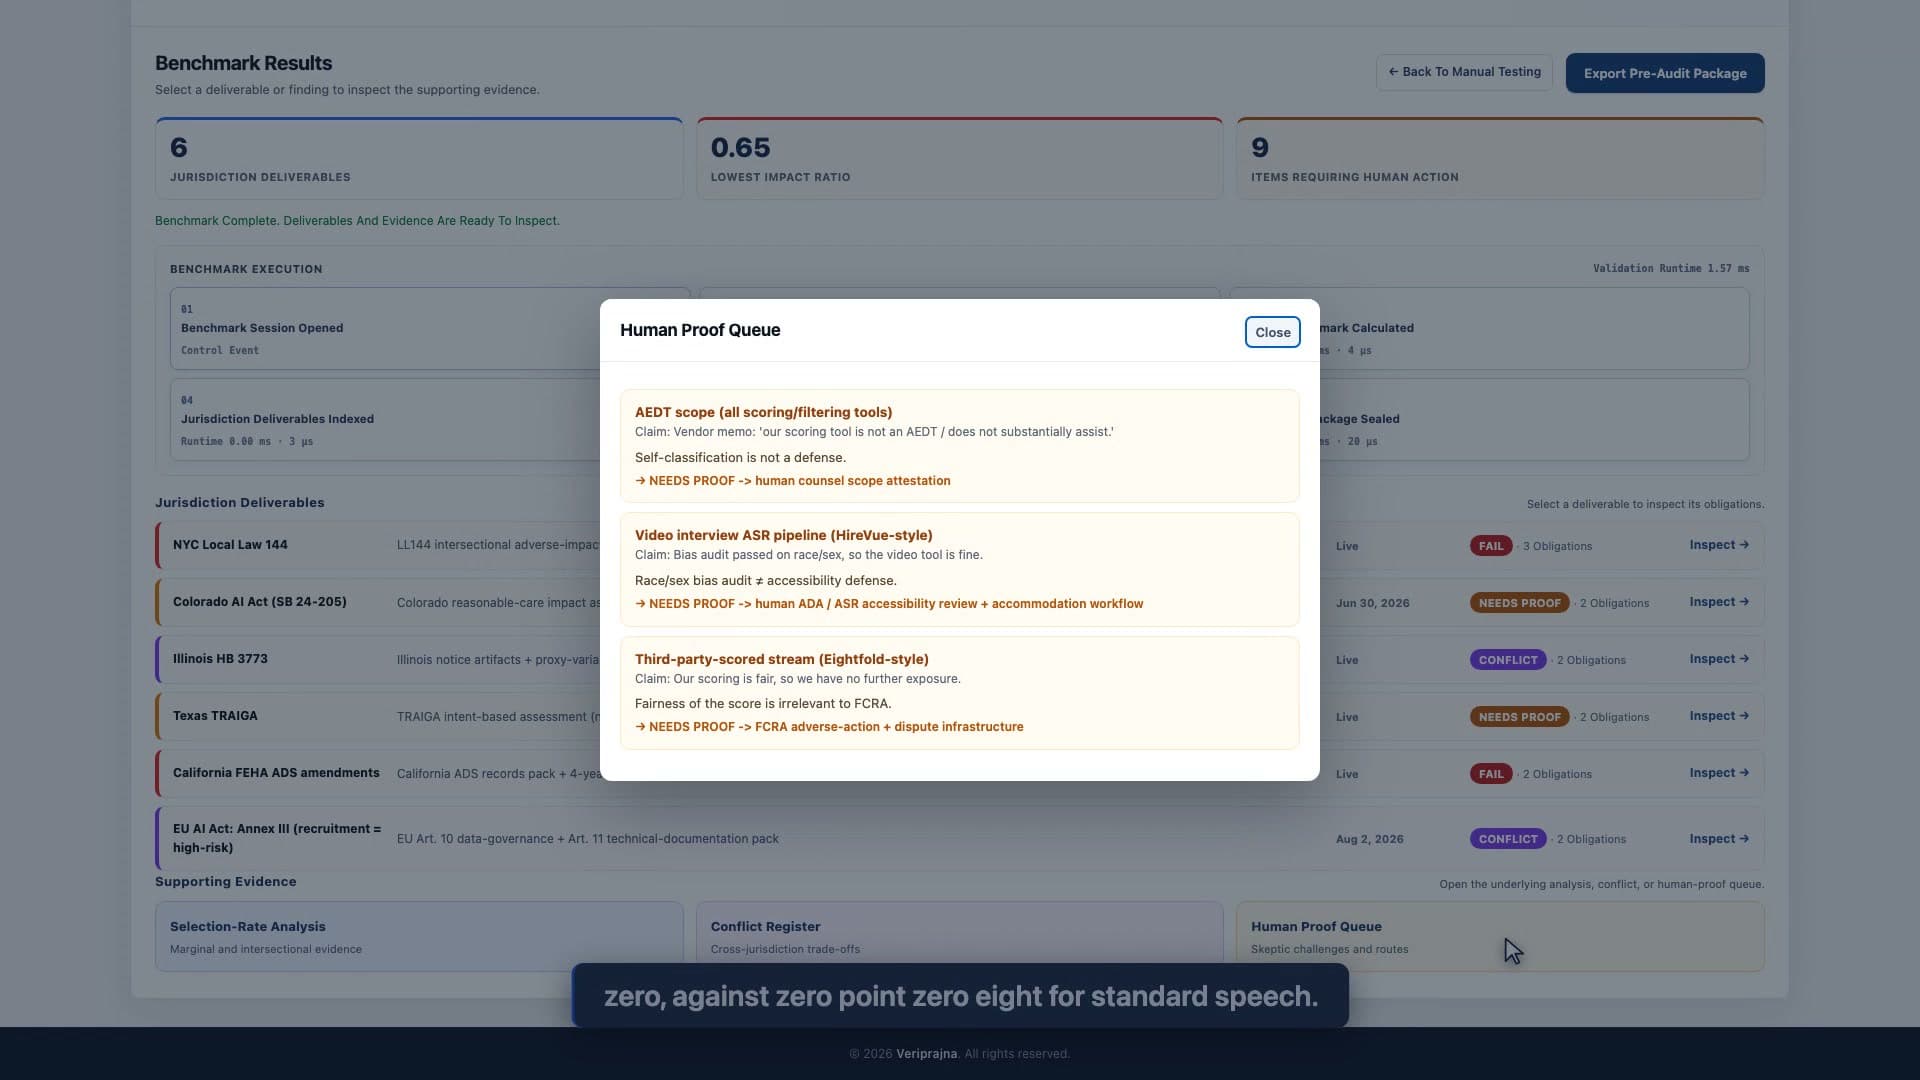
Ho creato lo scettico contraddittorio aspettandomi che sollevasse obiezioni sulle statistiche, e invece ha impiegato il suo tempo a contestare l'ambito di applicazione. Si rifiuta di dare il via libera a tre elementi, e ognuno di essi rappresenta una teoria giuridica distinta che un audit sui bias superato non copre.
La prima riguarda l'auto-classificazione. Una dichiarazione del fornitore che affermi "il nostro sistema di punteggio non è un AEDT" viene respinta, perché in base alla teoria dell'intermediazione sollevata in Mobley v. Workday uno strumento che raccomanda o filtra i candidati rientra a pieno titolo nel processo decisionale. Tale teoria non è ancora giunta a sentenza definitiva, non è un precedente vincolante, ed è per questo che la voce viene inoltrata a un legale umano per un'attestazione sull'ambito di applicazione anziché risolversi in un colore di stato.
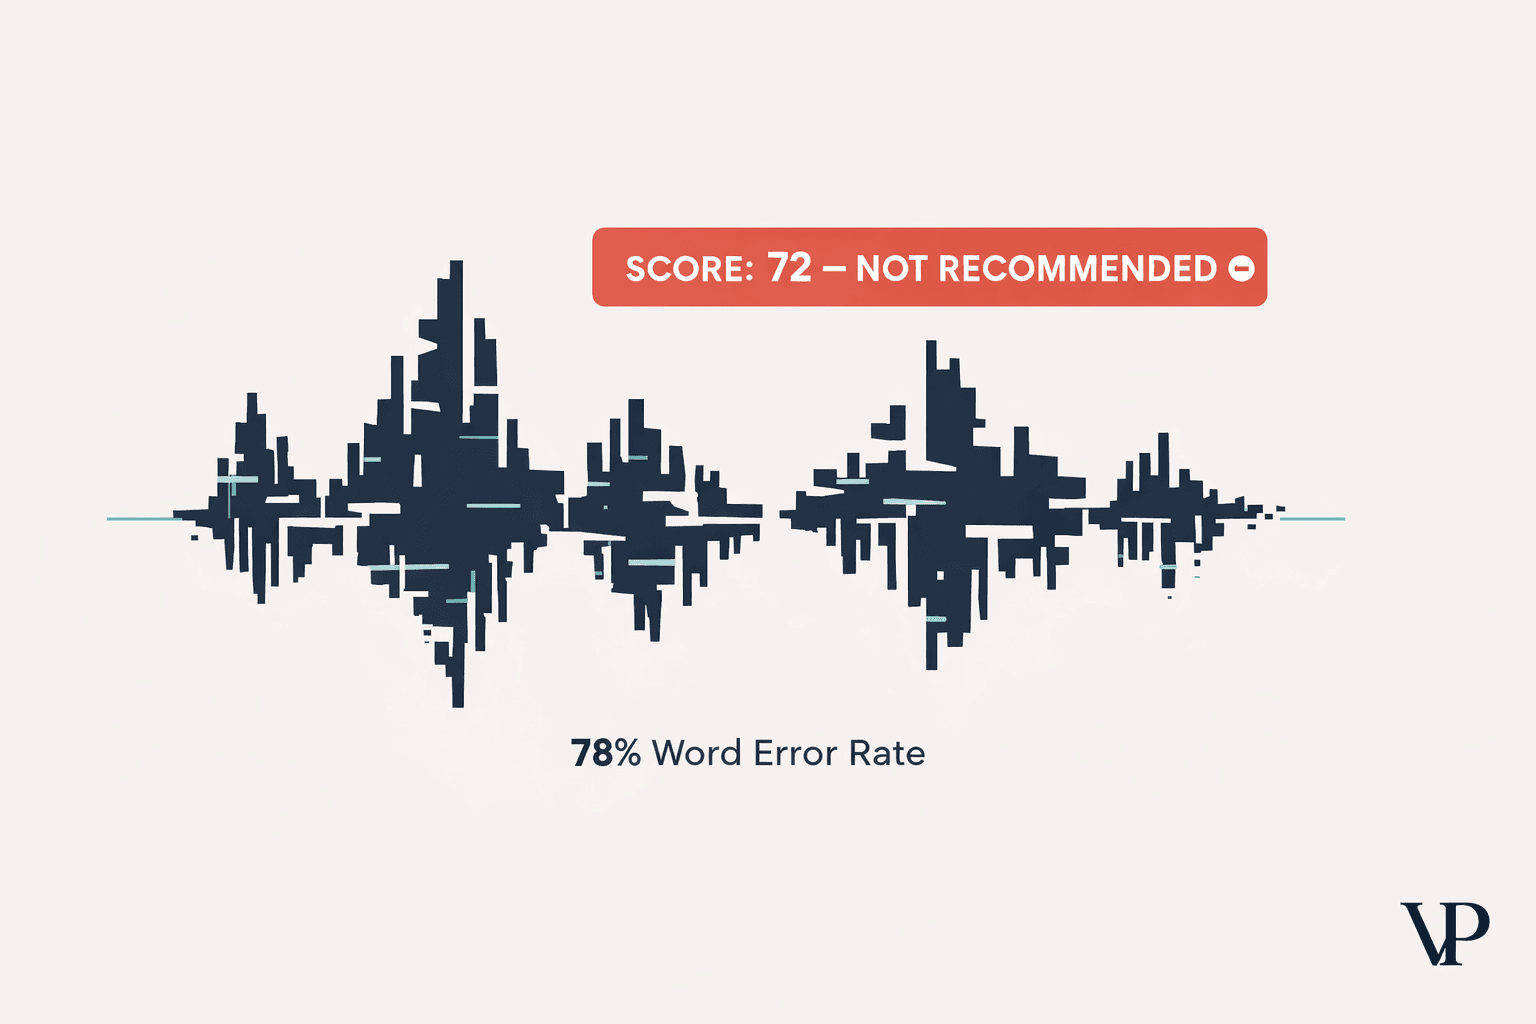
La seconda riguarda l'accessibilità. Sui 432 candidati sottoposti alla video-intervista, il tasso di errore sulle parole (word error rate) è pari a 0.0794 per il linguaggio standard e a 0.3016 per i 104 candidati con parlato non standard: una disparità di 3,8 volte che la Local Law 144 non verifica mai, poiché riguarda esclusivamente razza e sesso. La tesi avanzata in D.K. v. Intuit/HireVue è una teoria fondata sull'ADA, e rimane del tutto intatta anche di fronte a un audit sui bias impeccabile. Clarion rileva la disparità e la indirizza a una revisione ADA svolta da un operatore umano. Non costruisce il flusso di lavoro per gli accomodamenti ragionevoli, e non intendo fingere il contrario.
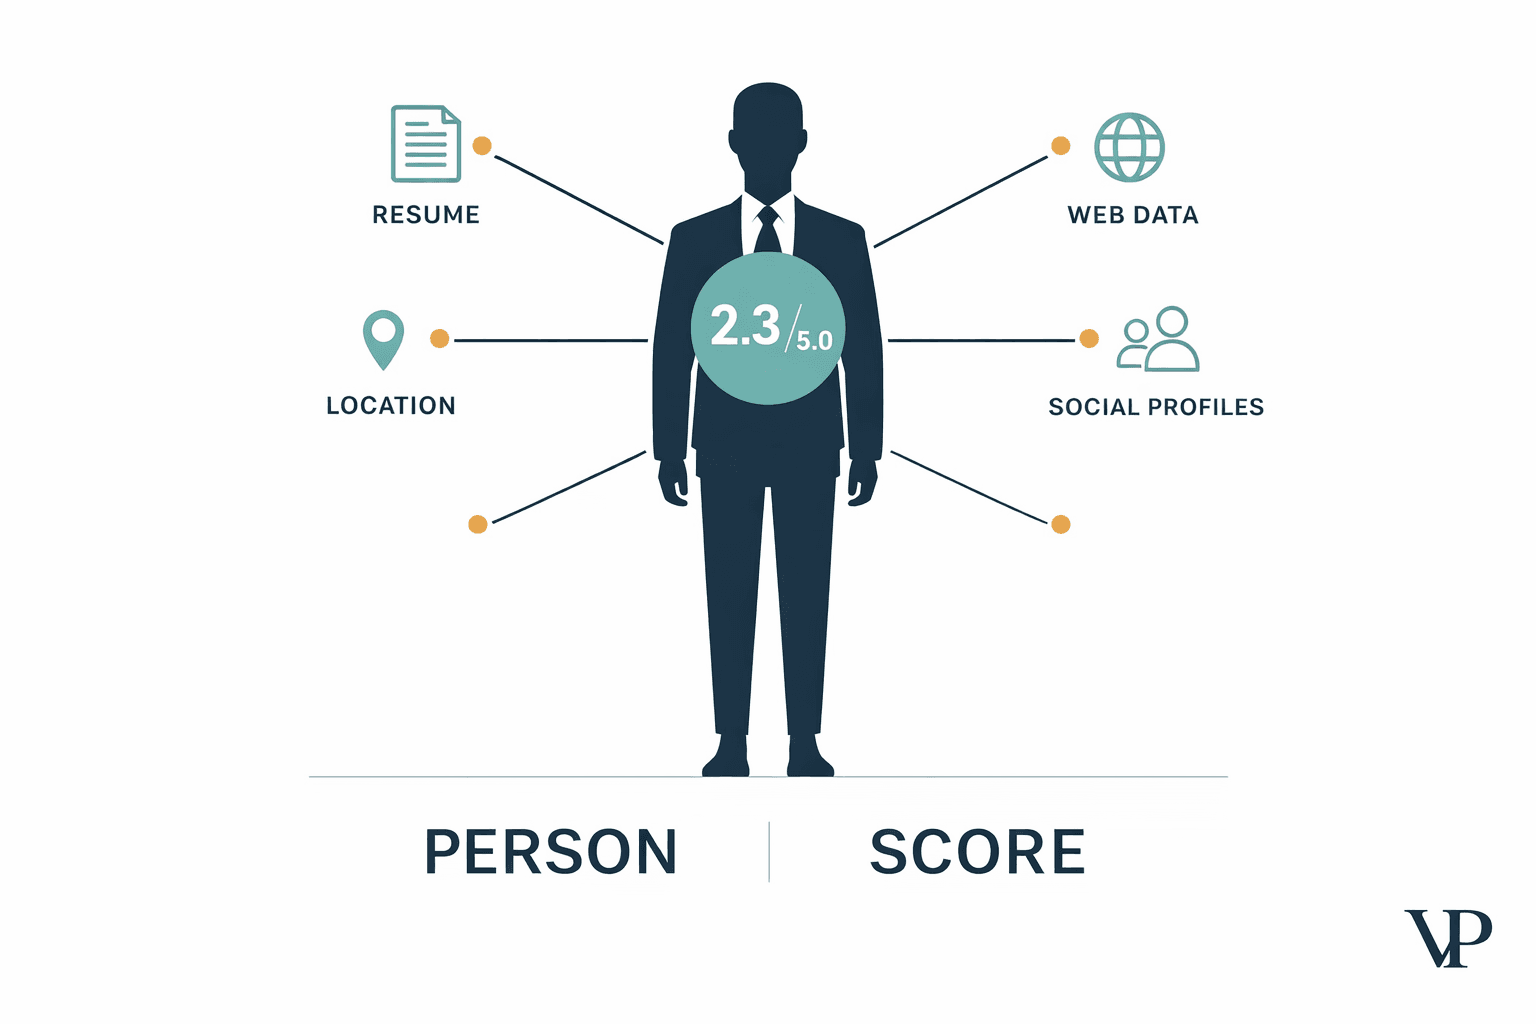
La terza è il FCRA, che non si cura minimamente dell'equità statistica. In questo export, 510 candidati sono stati valutati sulla base di dati estratti da terze parti e filtrati tramite un punteggio numerico, esattamente lo schema contestato in Kistler v. Eightfold. Se la piattaforma è considerata una consumer reporting agency, a ciascun candidato valutato spetta una notifica di adverse action e una procedura di contestazione, a prescindere da quanto equilibrati siano gli esiti. Clarion rileva l'evento scatenante e lo indirizza all'infrastruttura di adverse action e contestazione. Non costruisce nemmeno il portale rivolto ai candidati. Trovo questo aspetto il meno intuitivo dei tre, e quello che con maggiore probabilità sfugge a un team che ha fatto tutto alla perfezione sull'equità, perché nessun dato statistico ne fornisce la risposta. La questione posta dal FCRA riguarda ciò che la piattaforma è, e un'azienda può superare ogni rapporto di impatto presente nel report e avere comunque un debito informativo verso diverse centinaia di persone a cui non ha mai inviato una notifica.
Il fascicolo che consegnerei a chiunque debba apporre la firma
Ho tenuto una domanda ben visibile davanti a me durante l'intero sviluppo: di cosa ha realmente bisogno la persona che deve apporre la firma? E la risposta non è un punteggio. Tra i sei regimi, il motore valuta 13 obblighi e restituisce 2 PASS, 2 FAIL, 7 NEEDS_PROOF e 2 CONFLICT. Espresso in termini di copertura su questo export sintetico controllato, 2 obblighi su 13 sono soddisfatti automaticamente dai soli dati, mentre 9 su 13 sono indirizzati a un referente umano designato perché classificati come NEEDS_PROOF o CONFLICT. In un sistema venduto come automazione, tale proporzione sembrerebbe un fallimento. Come audit, è l'unica formula sotto la quale metterei la mia firma.
L'export è un bundle concatenato tramite hash SHA-256 composto da 17 nodi, ciascuno collegato all'hash del nodo precedente, cosicché qualsiasi modifica a un nodo spezza la catena. Viene generato in formato JSON e come pacchetto HTML stampabile, dove ogni numero reca con sé i relativi input e il relativo calcolo e ogni verdetto riporta la propria citazione di legge. La catena viene verificata a ogni esecuzione e l'inalterabilità a prova di manomissione è coperta da unit test.
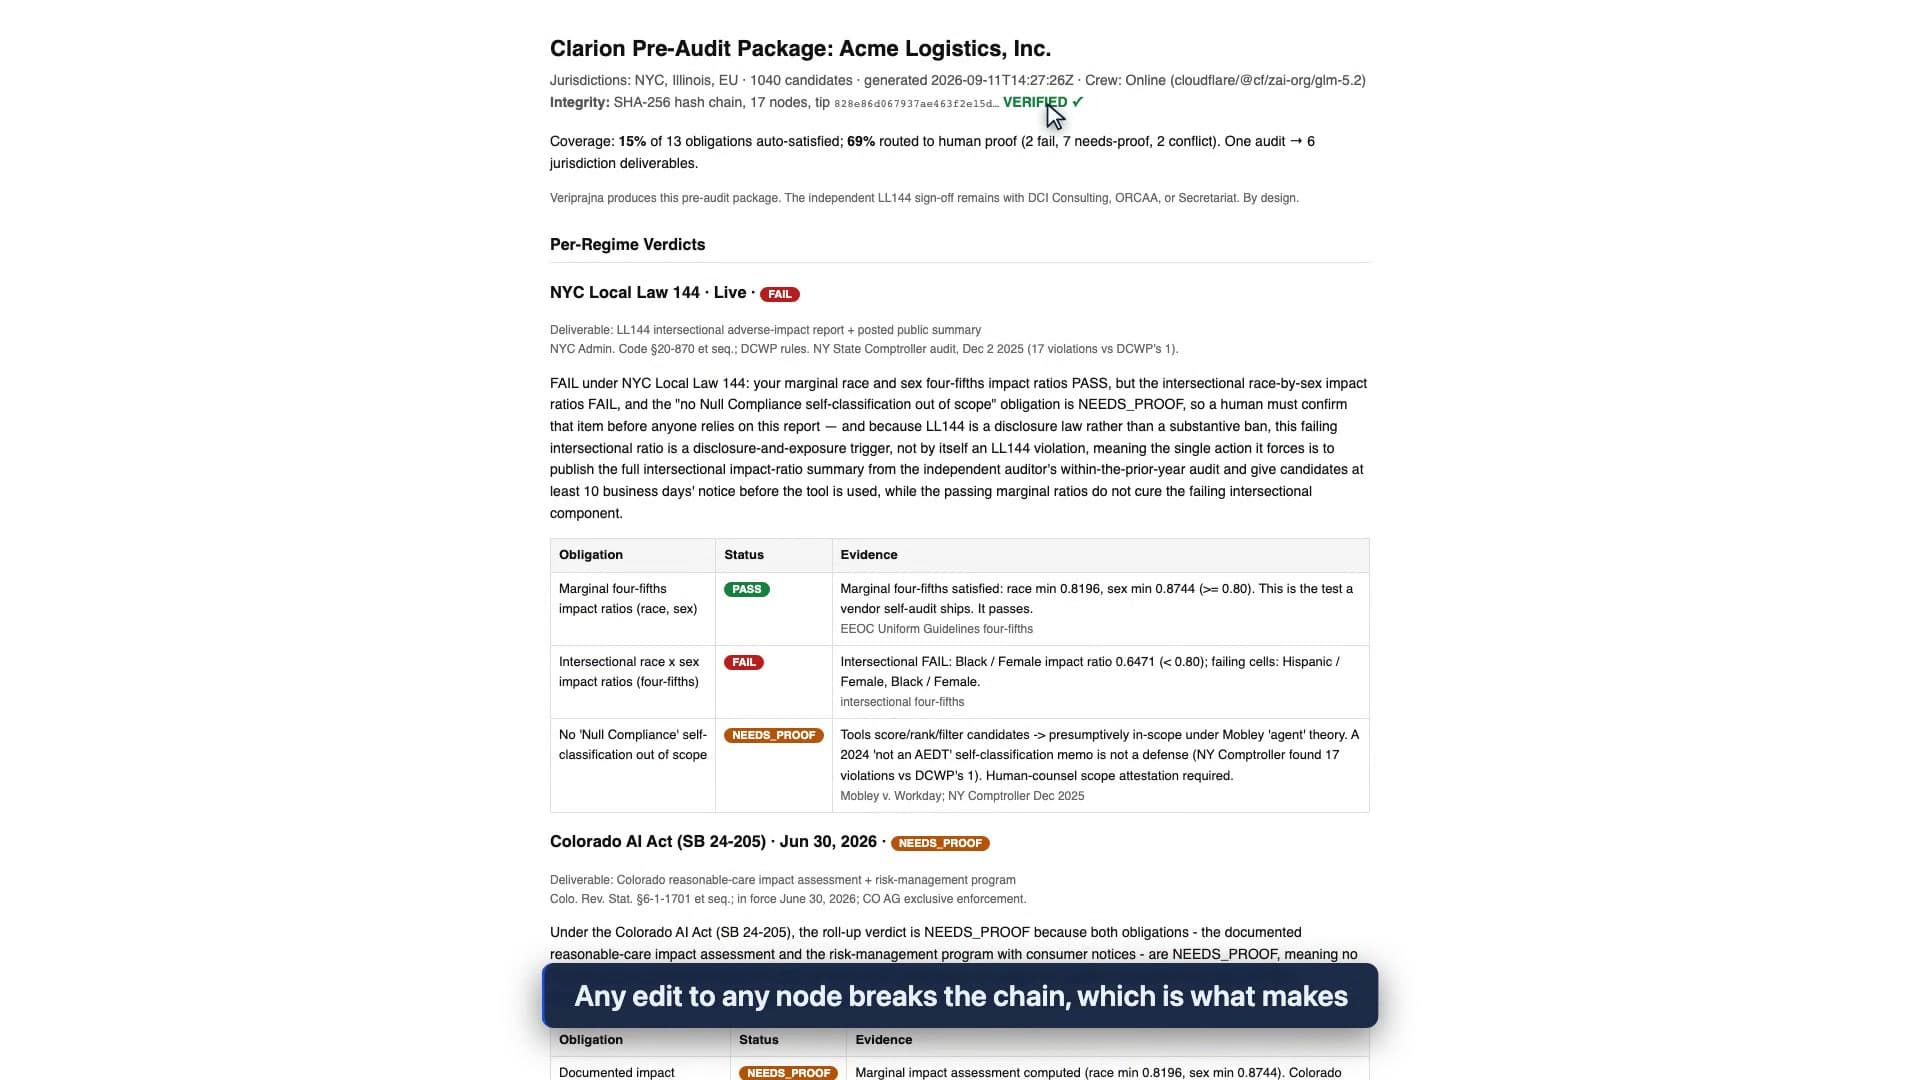
Veriprajna non appone la firma su questo documento. Il ruolo di revisore indipendente ai sensi della Local Law 144 spetta a società come DCI, ORCAA e Secretariat, e l'intero obiettivo progettuale del pacchetto è fare in modo che una di esse possa firmarlo senza doverlo prima riscrivere. La guida completa all'esecuzione, comprensiva del promemoria di conflitto, è disponibile all'indirizzo veriprajna.com/demos/ai-hiring-compliance.
E se preferisci vedere il gate opporre il proprio rifiuto invece di leggermi mentre lo descrivo, ecco l'intera esecuzione end-to-end, inclusa la nota di conflitto.
Il promemoria sul conflitto lascia il datore di lavoro esattamente conforme quanto lo era il giorno prima. Ciò che aggiunge è un compromesso chiaro, datato e riconducibile a precise responsabilità, così che tra due anni, quando qualcuno chiederà chi ha deciso di conservare il campo del codice postale e cosa sapesse nel momento in cui lo ha deciso, ci sarà un documento a testimoniarlo invece di un badge verde che richiederebbe giustificazioni.