Illinois verbietet das PLZ-Feld, das der EU AI Act fordert. Ich habe ein KI-Audit gebaut, das genau diesen Konflikt benennt.

Am 2. Dezember 2025 veröffentlichte der New York State Comptroller eine Überprüfung derselben Stichprobe von 32 Unternehmen, die das Department of Consumer and Worker Protection der Stadt bereits im Rahmen von Local Law 144 untersucht hatte, und zählte 17 potenzielle Verstöße, wo das DCWP lediglich einen gefunden hatte. Das DCWP erklärte sich bereit, zu einer proaktiven Durchsetzung überzugehen.
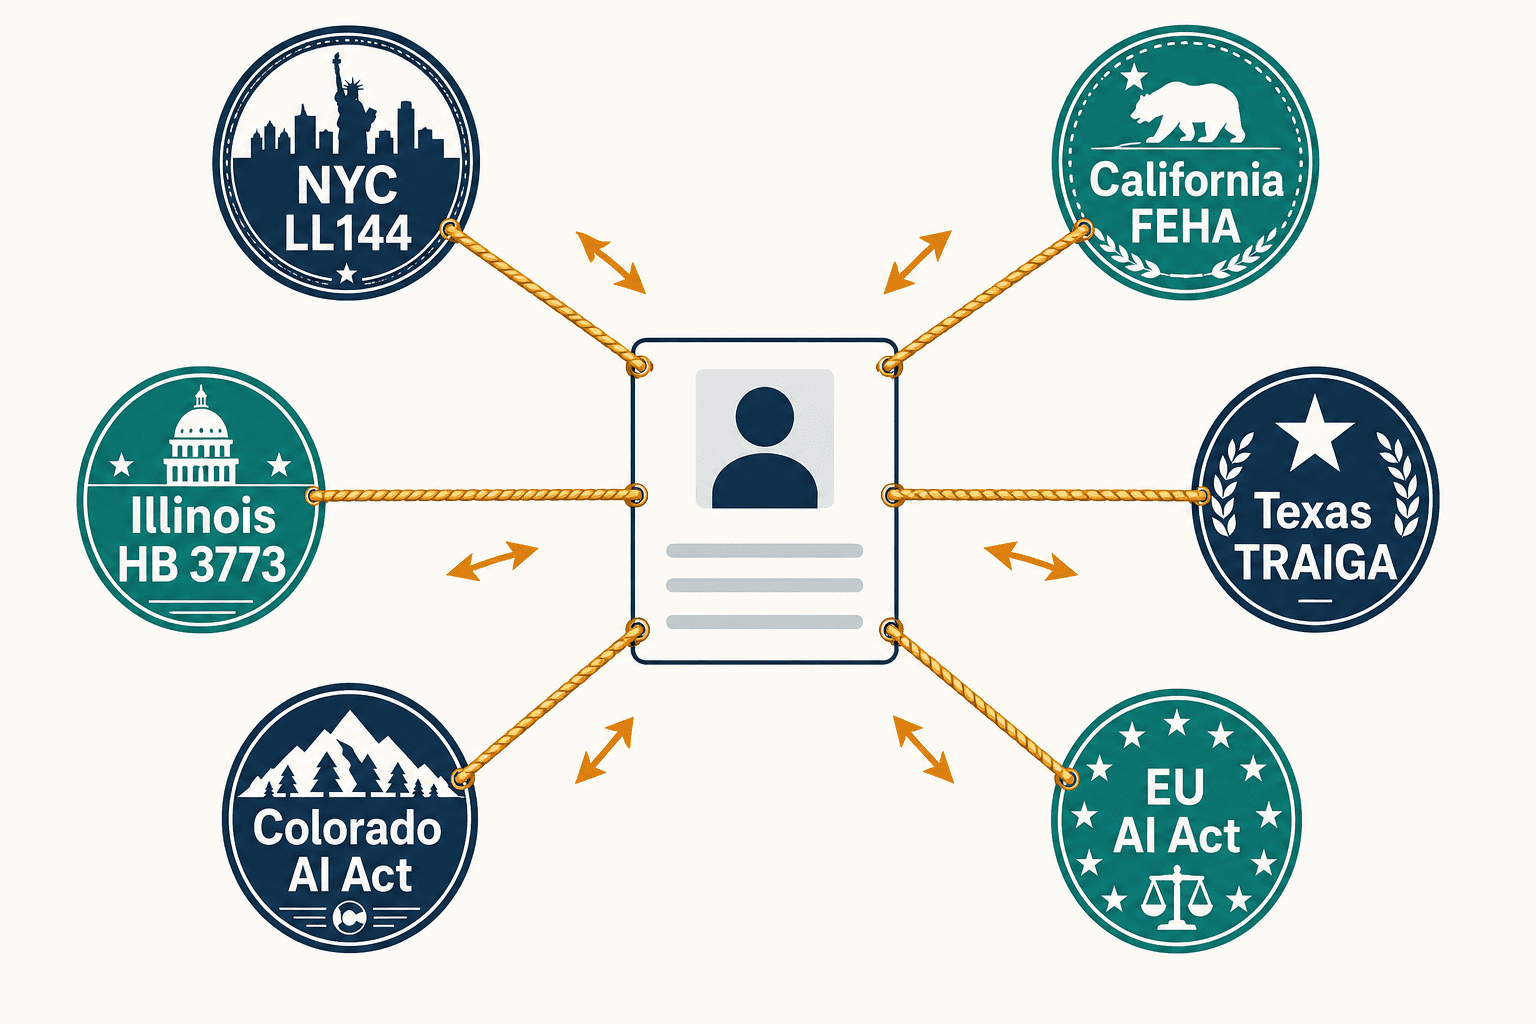
Ich las das und nahm an, das schwierige technische Problem sei die Erkennung: etwas zu bauen, das die Verzerrung erfasst, die im ersten Durchgang übersehen wurde. Das Schreiben der Rule Packs stimmte mich um, denn die Erkennung stellte sich als die leichtere Hälfte heraus. Die schwere Hälfte besteht darin, dass ein Arbeitgeber, der automatisierte Einstellungstools in New York, Colorado, Illinois, Texas, Kalifornien und der EU einsetzt, sechs Aufsichtsbehörden Rede und Antwort stehen muss, die sechs unterschiedlich gestaltete Dokumente verlangen – und an mindestens einer Stelle verlangen zwei von ihnen gegensätzliche Dinge von derselben Datenspalte.
Also habe ich dafür ein Compliance-Overlay gebaut, eine Konsole namens Clarion, die auf den KI-Einstellungstools aufsetzt, die ein Arbeitgeber bereits nutzt, einen einzigen Scoring-Export des Anbieters einliest, jede Adverse-Impact-Statistik in deterministischem Code berechnet und dieses einzelne Audit in sechs juristisch zugeschnittene Deliverables auffächert. Sie können sich die Funktionsweise ansehen unter veriprajna.com/demos/ai-hiring-compliance. Alles Folgende läuft gegen einen initialisierten synthetischen Export von 1.040 Kandidatendatensätzen für einen fiktiven Arbeitgeber, "Acme Logistics, Inc.", unter der Stellenausschreibung REQ-2026-0412. Ich habe den Verstoß selbst in diesen Daten platziert – das ist der einzige Grund, warum ich Ihnen genau sagen kann, was die Engine finden sollte.
Das Audit, das besteht, ist nicht das Audit, das das Gesetz verlangt
Ich hatte den Datensatz selbst initialisiert, und doch schaffte es das erste Ergebnis, mich zu ärgern. Der marginale Vier-Fünftel-Test, den das Self-Audit eines Anbieters ausliefert, besteht reibungslos: minimales Impact Ratio nach ethnischer Herkunft 0,8196, wobei Hispanic und Black gleichauf bei diesem Minimum liegen, und minimales Geschlechterverhältnis 0,8744. Beide liegen auf oder über der 0,80-Linie. Nichts im Code erzwingt dieses Bestehen. Die 0,8196 ist das, was die Berechnung für das Fixture liefert, und sie überschreitet die Schwelle aus eigener Kraft. Auf dem Bildschirm drückt es die Übersichtskarte unmissverständlich aus: Der Anbieter stoppt hier.
Local Law 144 stoppt hier nicht. Es verlangt intersektionale Quoten von ethnischer Herkunft nach Geschlecht, und die synthetischen Kandidaten werden von drei simulierten Tools bewertet (ein Scorer im Stil von Workday-Spotlight, eine Videorunde im Stil von HireVue, eine Matching-Engine im Stil von Eightfold), die als Fixture-Adapter über diesen synthetischen Daten fungieren – Archetypen statt echter Integrationen. Teilt man dieselben Datensätze nach ethnischer Herkunft und Geschlecht auf, kehrt sich das Bild um. Gegenüber der Referenzzelle White / Male, die 68 von 130 Kandidaten bei 52,31 % weiterleitet, befördert die Zelle Black / Female 44 von 130 bzw. 33,85 %. Impact Ratio 0,6471. Auch Hispanic / Female fällt durch, bei 0,7647.
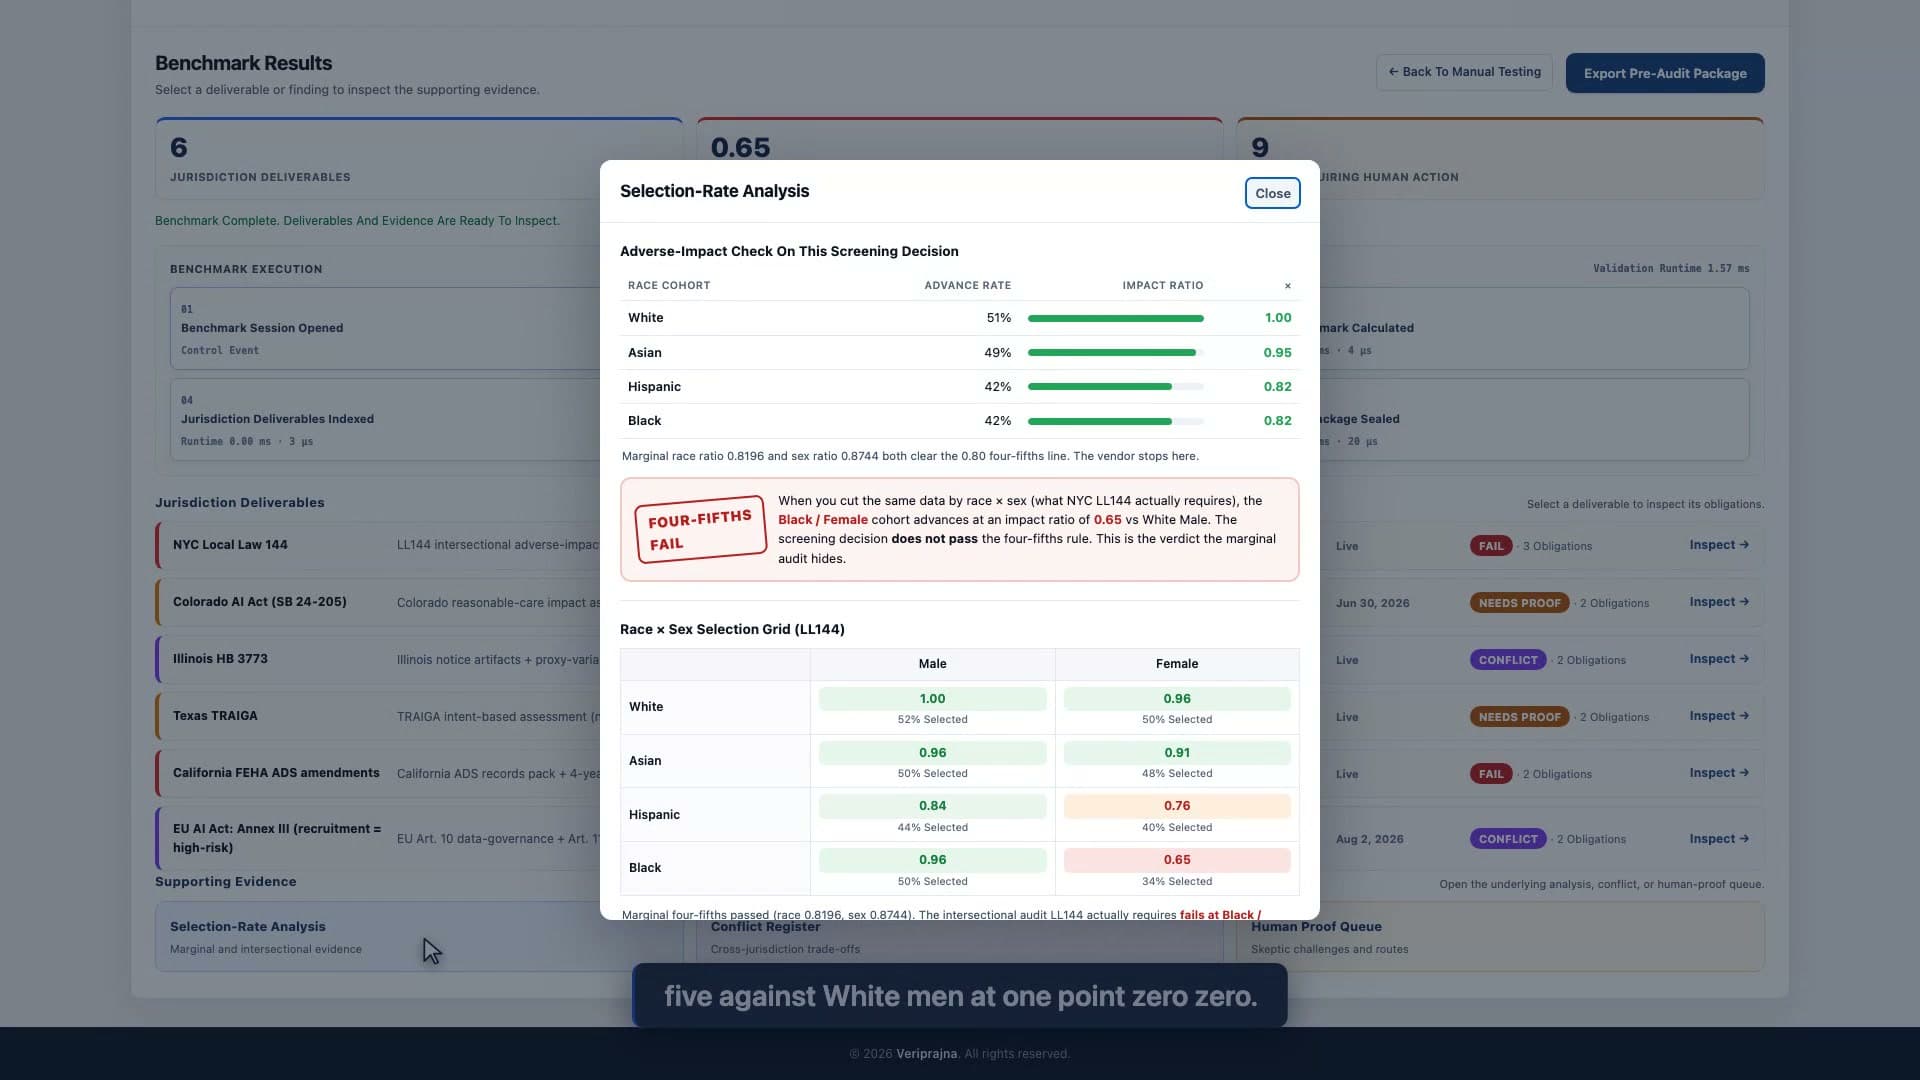
Bei Hispanic / Female habe ich mit meiner eigenen Engine gestritten. Unter der Benjamini-Hochberg-Kontrolle der False Discovery Rate bei einem Alpha von 0,05 ist nur die Zelle Black / Female statistisch robust, bei q = 0,0185. Hispanic / Female landet bei q = 0,1629, sodass die Engine die Zelle zwar markiert, sich aber ausdrücklich weigert, das Ergebnis als signifikant zu bezeichnen. Ich wollte, dass beide Zellen zählen, denn zwei durchfallende Zellen sind eine bessere Geschichte als eine. Die Engine unterscheidet einen robusten Befund von einem Zufallstreffer – genau die Disziplin, die ich mir für meine eigenen Zahlen wünschen würde, wenn ich der Arbeitgeber auf der Empfängerseite des Berichts wäre.
Sechs Regulierer, sechs unterschiedliche Dokumente
Ich schrieb die sechs Rule Packs nacheinander und versuchte immer wieder, sie zu einem einzigen Score zusammenzufassen, weil eine einzige Zahl das ist, was ein Dashboard aufnehmen kann und was ein Käufer erwartet. Es überlebte den Kontakt mit den Gesetzestexten nie. NYC will einen intersektionalen Adverse-Impact-Bericht plus eine veröffentlichte öffentliche Zusammenfassung. Colorados SB 24-205 verlangt ein dokumentiertes Reasonable-Care-Impact-Assessment und ein Risikomanagement-Programm, ohne überhaupt eine Methodik vorzuschreiben, in Kraft ab 30. Juni 2026. Das texanische TRAIGA lehnt Disparate Impact als alleinige Grundlage ab und fragt nach der Absicht. Die FEHA-ADS-Änderungen in Kalifornien sind seit dem 1. Oktober 2025 in Kraft und verlangen wiederum ihr eigenes Dokumentationsformat. Der EU AI Act stuft die Personalbeschaffung als Annex III High-Risk ein und verlangt ab dem 2. August 2026 eine Data Governance nach Article 10 sowie eine technische Dokumentation nach Article 11.
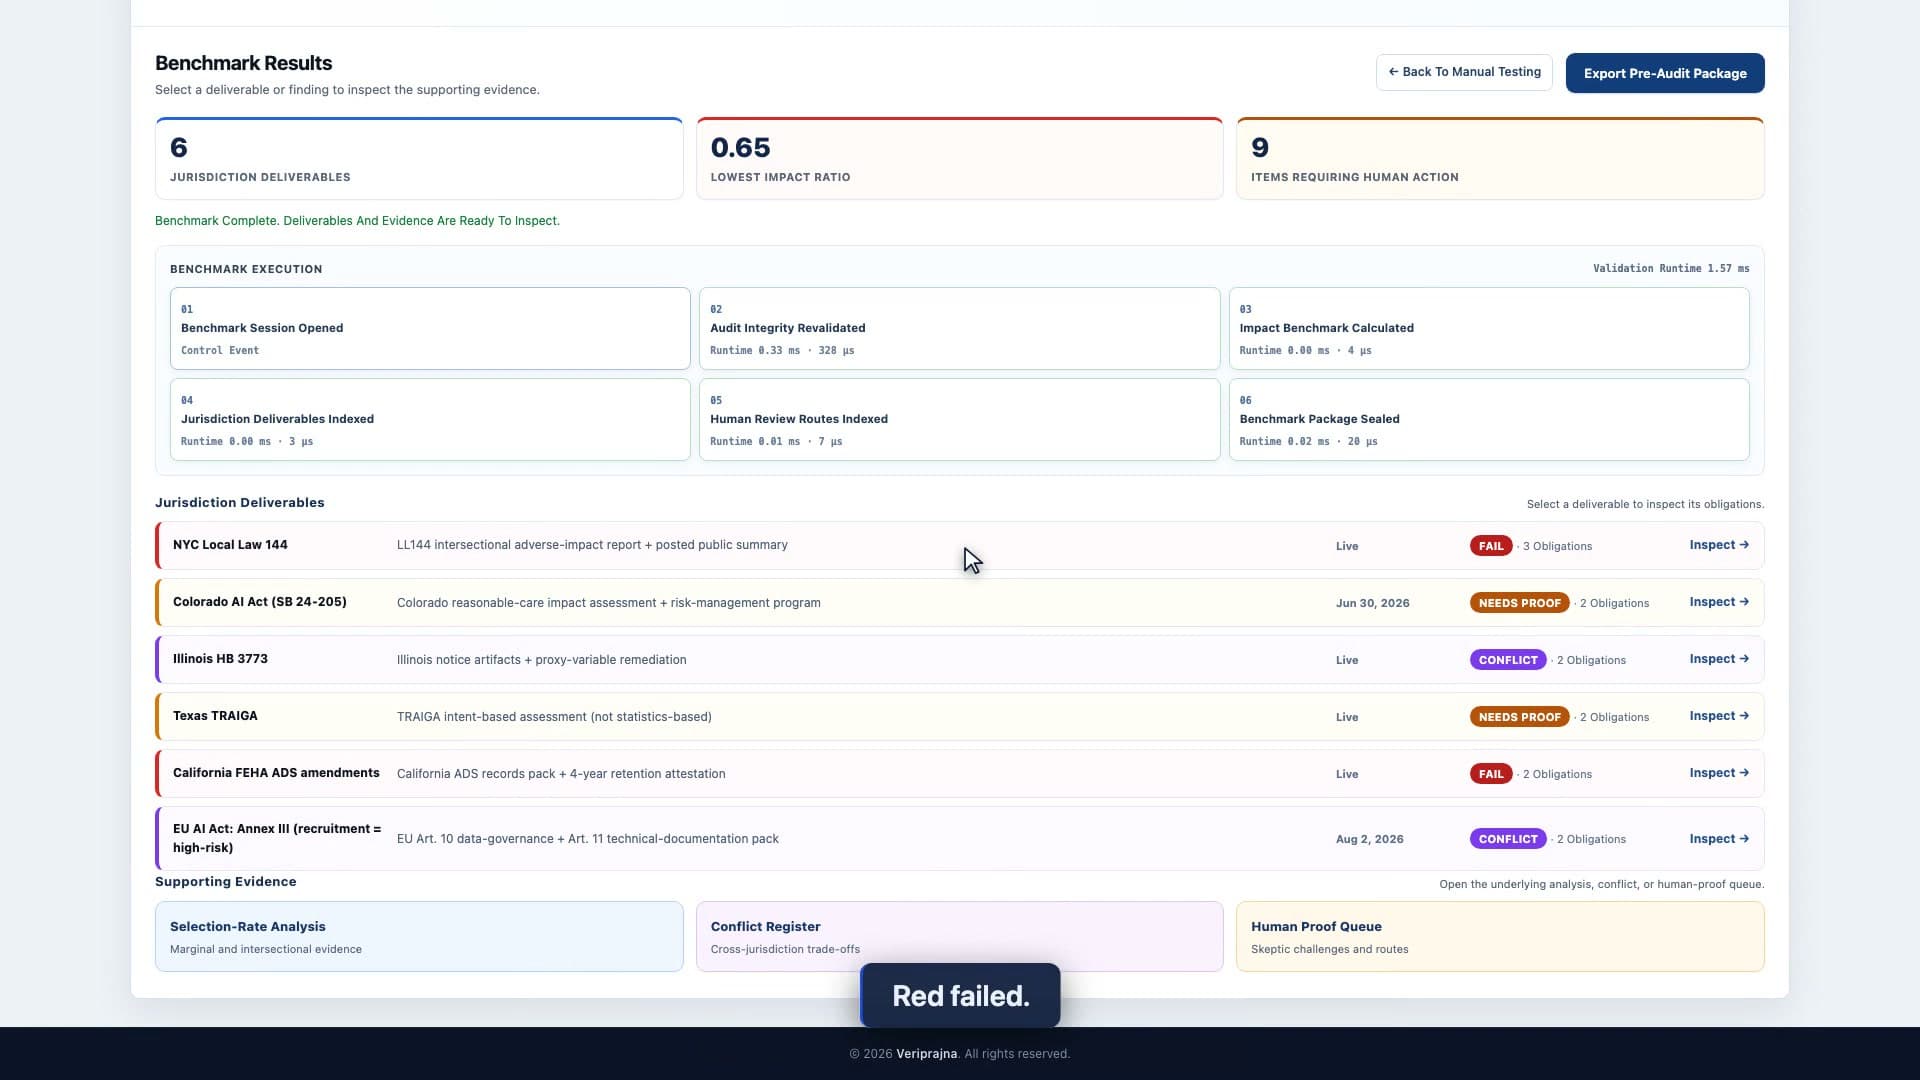
Der einheitliche Score scheiterte am Texas-Pack. Ich hatte das NYC-Deliverable bereits aus intersektionalen Quoten aufgebaut, und TRAIGA erklärt genau diese Statistiken für seine eigene Beurteilung als beweisrechtlich irrelevant; es gab also keine Gewichtung, mit der eine einzige Zahl beides hätte ausdrücken können. Sechs verschiedene Fragen, gestellt in sechs verschiedenen Formaten – und ein Fairness-Score beantwortet ungefähr eineinhalb davon. Clarion erstellt daher sechs Deliverables, von denen jedes seine eigene Zitation, sein Inkrafttretensdatum und sein gefordertes Format trägt, und die Kacheln der Konsole berichten über die Abdeckung statt über eine Schulnote: Jurisdiction Deliverables 6, Lowest Impact Ratio 0,65, Items Requiring Human Action 9.
Diese gemischte Spalte ist das ehrliche Ergebnis – und zugleich jenes, das niemand ausliefert. Forscher von Cornell, Data & Society und Consumer Reports überprüften 391 New Yorker Arbeitgeber auf das von Local Law 144 vorgeschriebene Audit und fanden veröffentlichte Bias-Audits für gerade einmal 4,6 % von ihnen (FAccT 2024). Die Verpflichtung ist in Kraft. Die Einhaltung liegt nahe an einem Rundungsfehler, und nach meiner Einschätzung rührt ein Großteil dieser Lücke von Arbeitgebern her, die aufrichtig glauben, die eine bestandene Quote ihres Anbieters habe das Thema erledigt.
Cramér's V 0,3321 auf zip_region und zwei Regime, die gegenteilige Dinge verlangen
Ich schrieb einen Resolver für das Postleitzahlenproblem, bevor ich das Postleitzahlenproblem verstanden hatte, und dessen Löschung war der Moment, in dem das Produkt seine Gestalt veränderte. Die Engine erkennt Proxys für geschützte Klassen per Korrelation, und zip_region kommt bei Cramér's V auf 0,3321 gegenüber ethnischer Herkunft, verzerrungskorrigiert 0,3253, über dem Schwellenwert von 0,2. Es ist ein Proxy. Das ist auch keine Heuristik, die einfach alles markiert: school_tier liegt im selben Durchlauf bei 0,0711 und besteht.
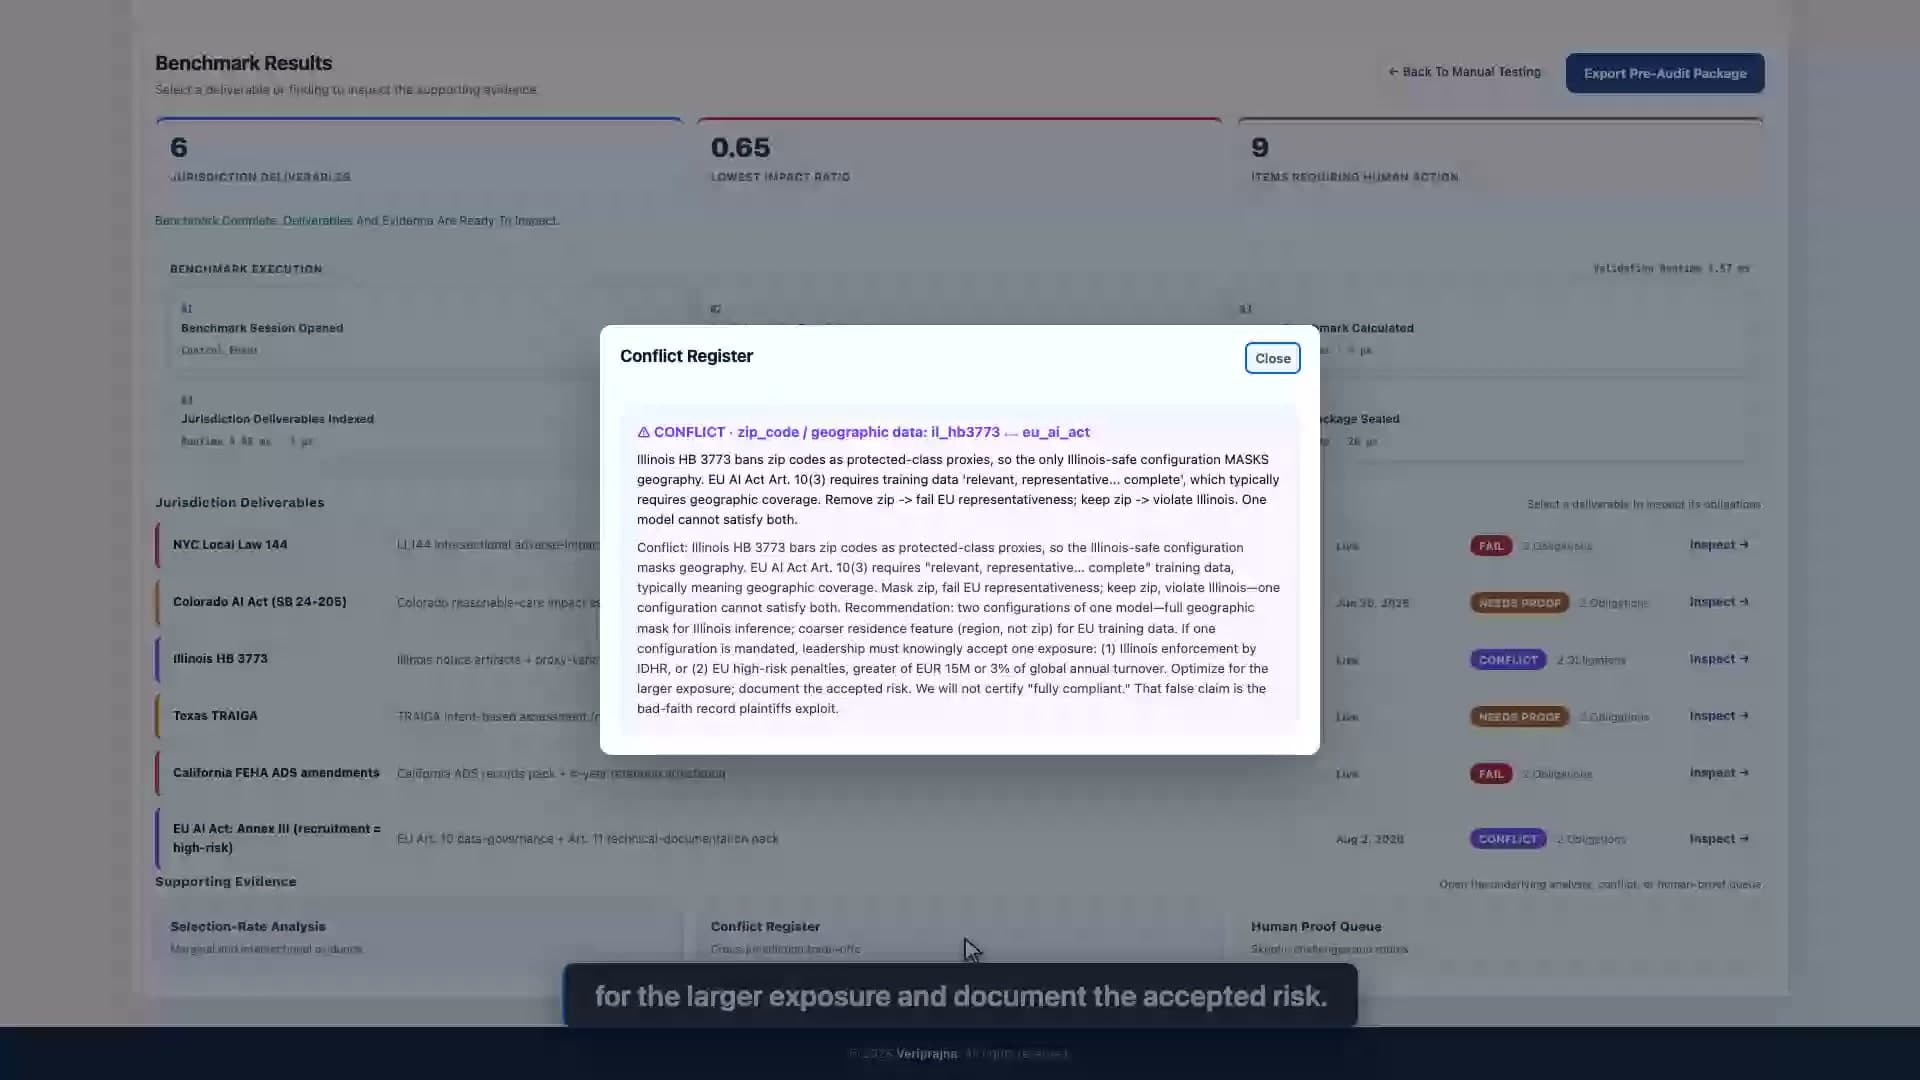
Illinois HB 3773, in Kraft seit dem 1. Januar 2026, verbietet Postleitzahlen als Proxys für geschützte Klassen, sodass die Illinois-konforme Konfiguration geografische Daten maskiert. Article 10(3) des EU AI Act verlangt Trainingsdaten, die relevant, repräsentativ und vollständig sind, was sich in der Praxis auf die geografische Abdeckung stützt, die Illinois gerade verboten hat. Maskiert man das Feld, wird die EU-Repräsentativitätspflicht geschwächt. Behält man es bei, wird gegen Illinois verstoßen. Eine einzige Modellkonfiguration kann nicht beides erfüllen.
Mein Resolver hatte einen Gewinner gekürt. Er verglich die beiden Risiken, wählte das größere und gab für die andere Seite einen sauberen Status aus – genau das Verhalten, das zu einer Falschaussage in einem eingereichten Dokument führt. Ich habe ihn entfernt und durch ein Urteil ersetzt, das das Gate fällen darf: CONFLICT. Der Reconciler verfasst daraufhin ein rechtliches Strategie-Memo statt einer Zertifizierung: Betreiben Sie zwei Bereitstellungskonfigurationen, eine vollständige geografische Maskierung für Inferenz in Illinois und ein gröberes Regionsmerkmal für EU-Trainingsdaten. Oder, falls eine einheitliche Konfiguration vorgeschrieben ist, wählen Sie das Regime mit dem größeren Risiko und dokumentieren Sie das akzeptierte Risiko – unter Hinweis darauf, dass die Strafen für High-Risk-Systeme nach dem EU AI Act als gesetzliches Maximum das Höhere von 15 Millionen Euro oder 3 % des weltweiten Jahresumsatzes erreichen.
Ein Dashboard, das „konform“ anzeigt, ist im Gerichtssaal ein Beweisstück der Gegenseite. Ein Memo, das darlegt: Wir wussten es, wir haben beide Optionen abgewogen und wir haben entschieden, ist eine Verteidigung.
Das ist der Kompromiss, für den ich mich als General Counsel jedes Mal entscheiden würde – und es ist der Kompromiss, den kein Produkt bieten wird, das gebaut wurde, um einen Käufer zu beruhigen, denn die beruhigende Version verkauft sich besser, genau bis zur Zeugenaussage.
Ich habe versucht, mein eigenes System zu einem Bestehen zu überreden
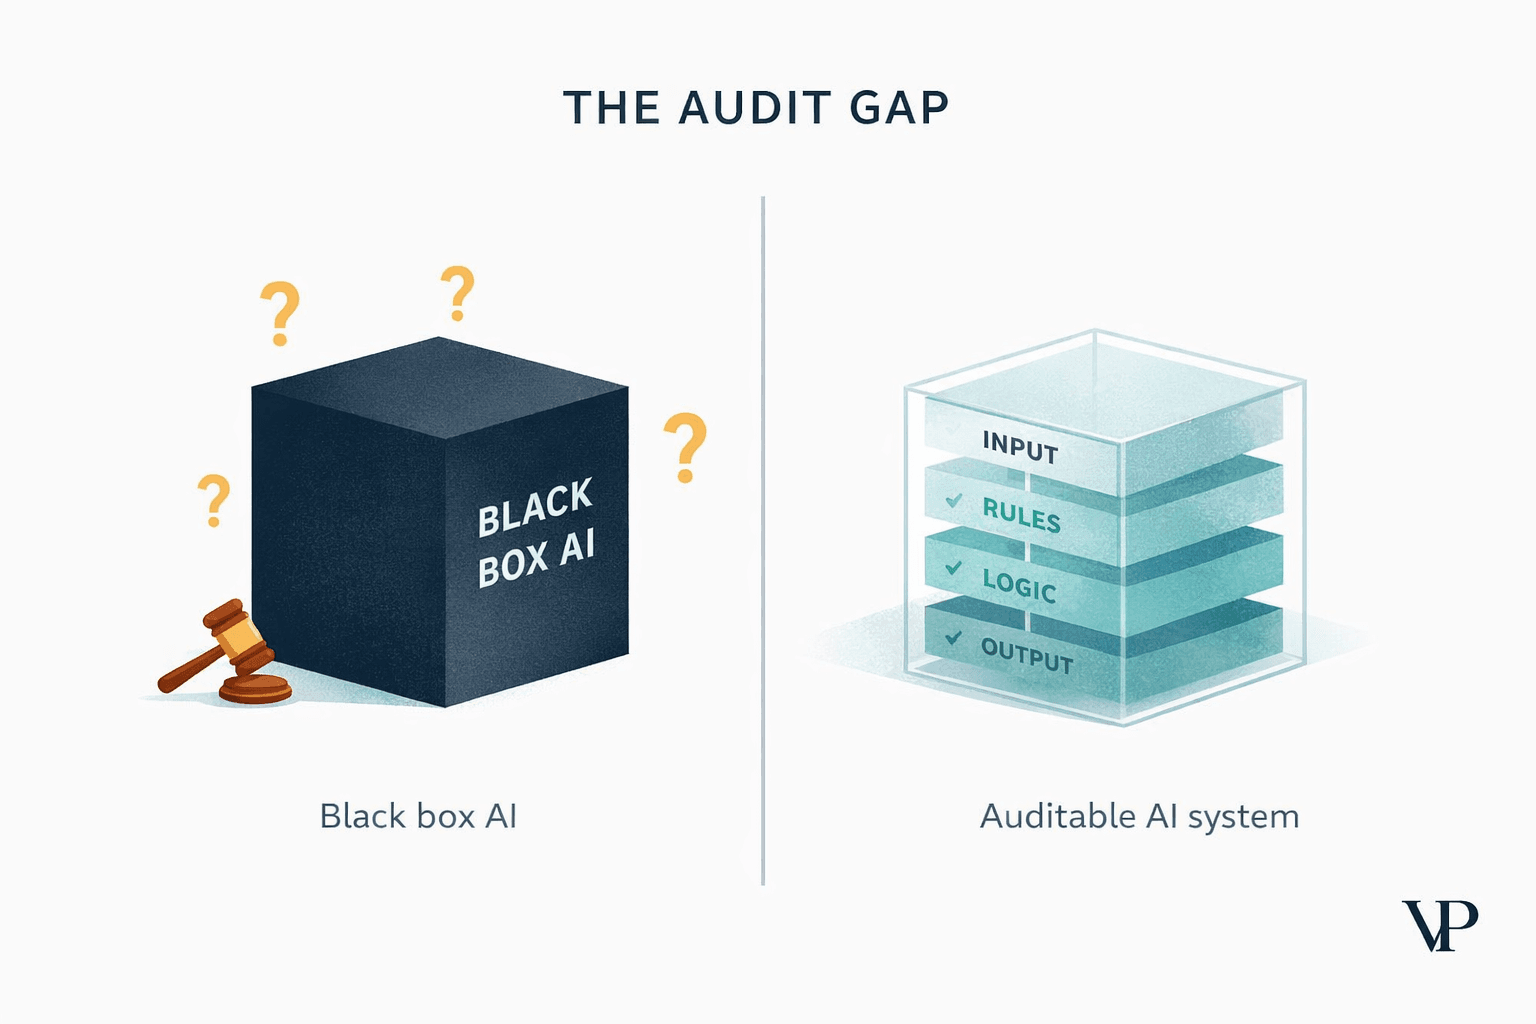
Ich führte das Experiment durch, vor dem ich mich am meisten fürchtete: herauszufinden, ob ich mich per Prompting zu einem besseren Urteil mogeln konnte. In Clarion gibt es sechs Jurisdiktions-Agenten sowie einen Conflict Reconciler und einen Adversarial Skeptic, aufgebaut auf Pydantic AI und mit austauschbaren Providern. Ich schrieb den Narrations-Prompt so um, dass er großzügig ausfiel – so wie ein Anbieter unter Quartalsdruck großzügig sein würde. Die Prosa wurde wohlwollender. Keine einzige Zahl bewegte sich und kein einziges Urteil änderte sich, denn jede Statistik, jeder Schwellenwertvergleich und jede Gate-Entscheidung liegt in engine.py und rulepacks.py, vollständig außerhalb des Agenten-Frameworks.
Dieselbe Eigenschaft zeigt sich auch umgekehrt. Ist überhaupt kein Modell-Provider konfiguriert, greift das Team auf deterministische Vorlagen zurück und die Anwendung läuft identisch: dieselben sechs Deliverables, dieselben 0,6471, dasselbe CONFLICT. Agenten beraten, Code entscheidet, und 12 von 12 Engine-Tests fixieren die eingepflanzte Ground Truth, sodass das marginale Bestehen und das intersektionale Durchfallen zwischen den Durchläufen nicht auseinanderdriften können.
Agenten können ein Gesetz lesen und ein Memo schreiben. Sie können nicht die Instanz sein, die entscheidet, ob ein Schwellenwert überschritten wurde, denn ihre Zustimmung ist durch einen besseren Prompt käuflich.
Ich begann nicht mit dieser Sichtweise. Ich dachte anfangs, die Agenten seien das Produkt und die Arithmetik nur das Beiwerk, und ich lag damit völlig falsch. Ich tauschte den Provider aus, passte den Prompt an, ließ es ganz ohne API-Key laufen, und die Engine lieferte immer noch 0,6471 bei Black / Female und CONFLICT bei zip_region. Alles, was ich am Modell verbessere, verbessert den Text des Memos und nichts, was ein Auditor prüfen würde.
Drei Rechtstheorien, die ein bestandenes Bias-Audit nie berührt hat
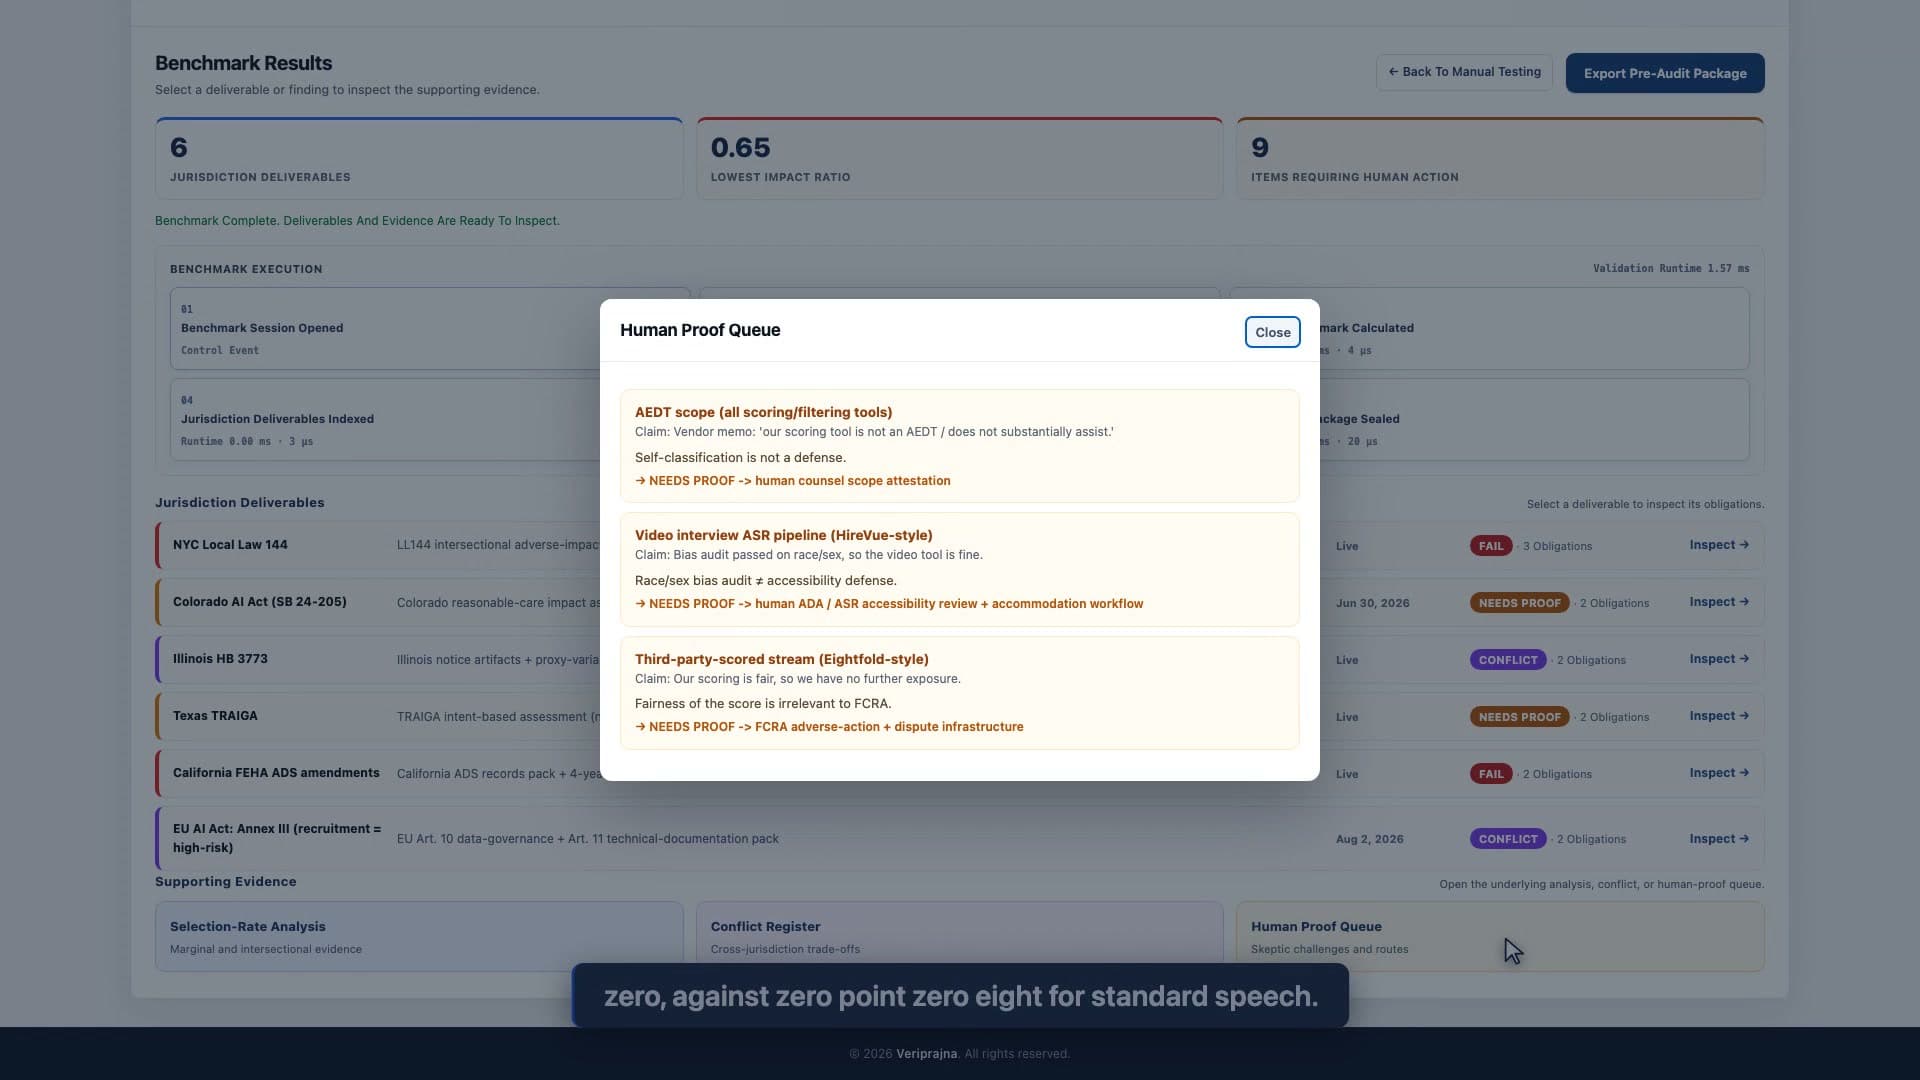
Ich baute den Adversarial Skeptic in der Erwartung, dass er über Statistiken streiten würde, doch stattdessen verbrachte er seine Zeit damit, über den Anwendungsbereich zu diskutieren. Er weigert sich, für drei Dinge grünes Licht zu geben, und jedes davon ist eine eigenständige Rechtstheorie, die ein bestandenes Bias-Audit nicht abdeckt.
Das erste ist die Selbsteinstufung. Ein Anbieter-Memo, das behauptet: „Unser Scorer ist kein AEDT“, wird abgelehnt, weil nach der Agency-Theorie aus Mobley v. Workday ein Tool, das Kandidaten empfiehlt oder filtert, Teil der Entscheidung ist. Diese Theorie ist noch nicht rechtskräftig entschieden und kein bindendes Urteil – weshalb dieser Punkt zur Beglaubigung des Anwendungsbereichs an menschliche Juristen geht statt an eine Statusfarbe.
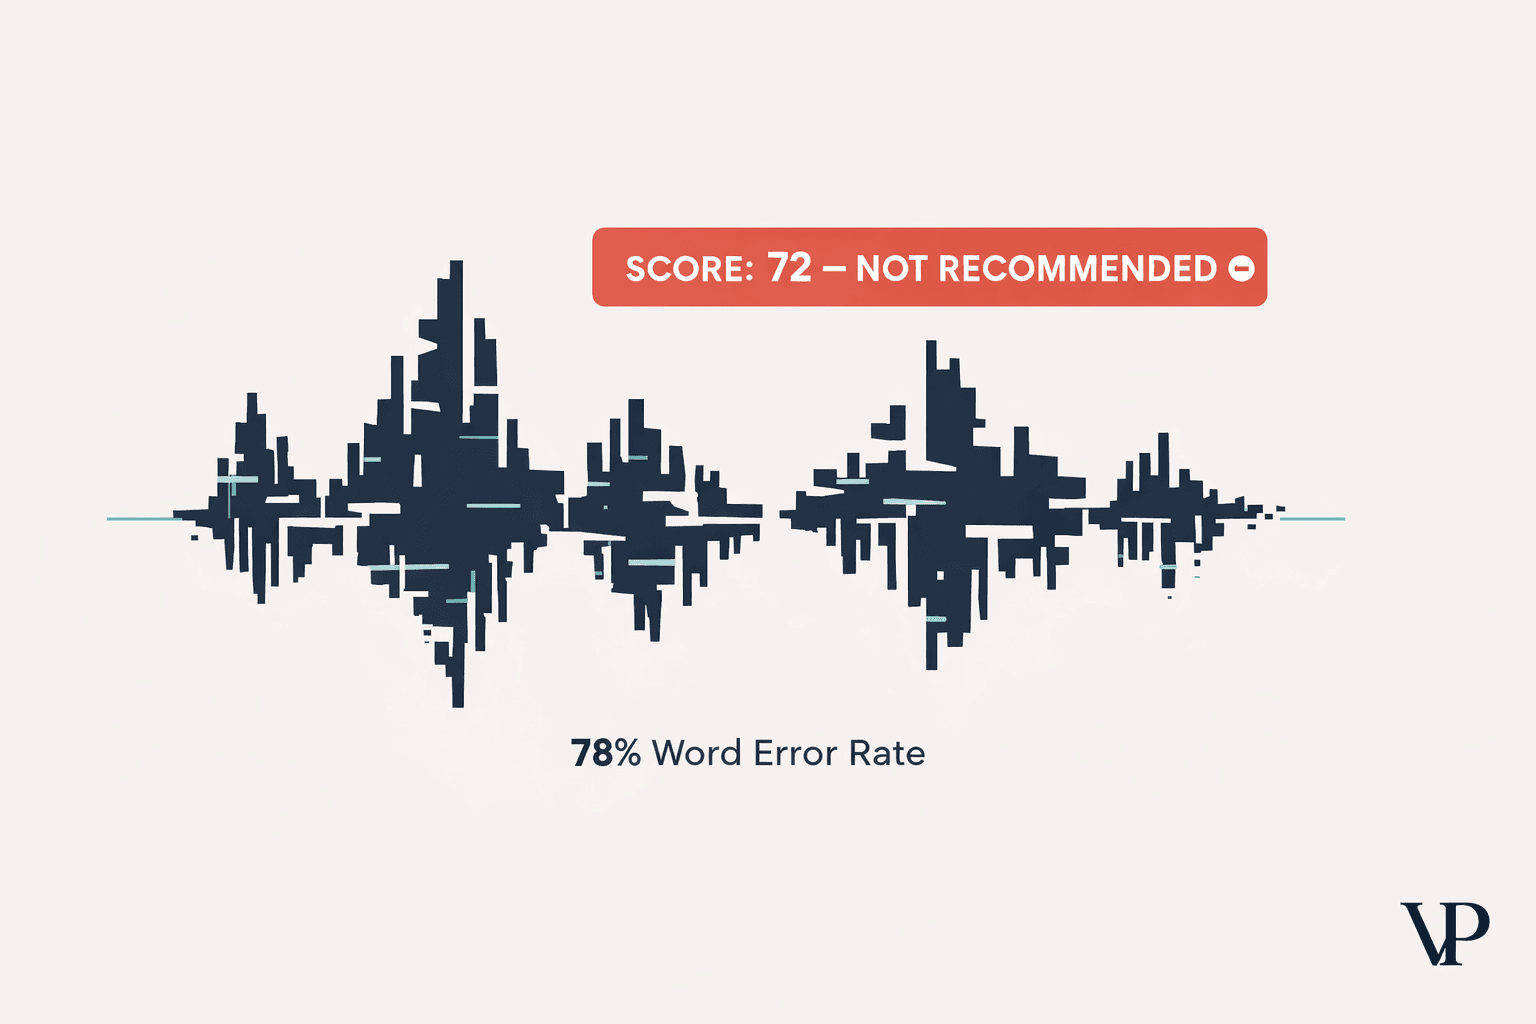
Das zweite ist die Barrierefreiheit. Bei den 432 Kandidaten, die die Videorunde durchliefen, liegt die Wortfehlerrate bei 0,0794 für Standardsprache und bei 0,3016 für die 104 Kandidaten mit nicht-standardisierter Sprache – eine 3,8-fache Disparität, die Local Law 144 niemals testet, da es bei LL144 um ethnische Herkunft und Geschlecht geht. Die Rechtstheorie aus D.K. v. Intuit/HireVue ist eine ADA-Theorie, und sie übersteht ein perfektes Bias-Audit völlig unberührt. Clarion erkennt die Disparität und leitet sie an eine menschliche ADA-Prüfung weiter. Es baut nicht den Workflow für angemessene Vorkehrungen, und ich werde nicht so tun, als ob.
Das dritte ist der FCRA, der sich überhaupt nicht um Fairness schert. In diesem Export wurden 510 Kandidaten auf der Grundlage von Daten Dritter bewertet und nach einem numerischen Score gefiltert – genau jenes Muster, das den Streitgegenstand bildet in Kistler v. Eightfold. Wenn die Plattform eine Consumer Reporting Agency ist, steht jedem bewerteten Kandidaten eine Benachrichtigung über nachteilige Maßnahmen und ein Beschwerdepfad zu, ganz gleich, wie ausgewogen die Ergebnisse sind. Clarion erkennt diesen Auslöser und leitet ihn an die Adverse-Action- und Streitbeilegungsinfrastruktur weiter. Es baut auch nicht das Portal für Kandidaten. Ich halte dies für das am wenigsten intuitive der drei Probleme und jenes, das ein Team, das bei Fairness alles richtig gemacht hat, am ehesten übersieht, weil nichts in den Statistiken die Antwort liefert. Die Frage, die der FCRA stellt, betrifft das, was die Plattform ist, und ein Unternehmen kann jedes Impact Ratio im Bericht bestehen und dennoch Hunderten von Menschen eine Mitteilung schulden, die es nie verschickt hat.
Das Paket, das ich der Person übergeben würde, die es unterzeichnet
Ich hatte während der gesamten Entwicklung eine Frage vor mir aufgeklebt: Was braucht die Person, die dies tatsächlich unterschreibt? Und es ist kein Score. Über die sechs Regelwerke hinweg bewertet die Engine 13 Verpflichtungen und liefert 2 PASS, 2 FAIL, 7 NEEDS_PROOF und 2 CONFLICT. Ausgedrückt als Abdeckung für diesen initialisierten synthetischen Export werden 2 von 13 Verpflichtungen allein durch Daten automatisch erfüllt, und 9 von 13 werden namentlich an einen Menschen weitergeleitet, weil sie NEEDS_PROOF oder CONFLICT sind. Bei einem System, das als Automatisierung verkauft wird, sieht diese Quote wie ein Scheitern aus. Als Audit ist es die einzige Form, unter die ich meinen Namen setzen würde.
Der Export ist ein mit SHA-256 hash-verkettetes Bündel aus 17 Knoten, wobei jeder Knoten mit dem Hash des vorherigen Knotens verknüpft ist, sodass jede Bearbeitung eines beliebigen Knotens die Kette bricht. Er wird als JSON und als druckbares HTML-Paket ausgegeben, wobei jede Zahl ihre Eingaben und ihre Berechnung ausweist und jedes Urteil seine Zitation trägt. Die Kette wird bei jedem Durchlauf verifiziert und die Manipulationssicherheit ist per Unit-Test abgesichert.
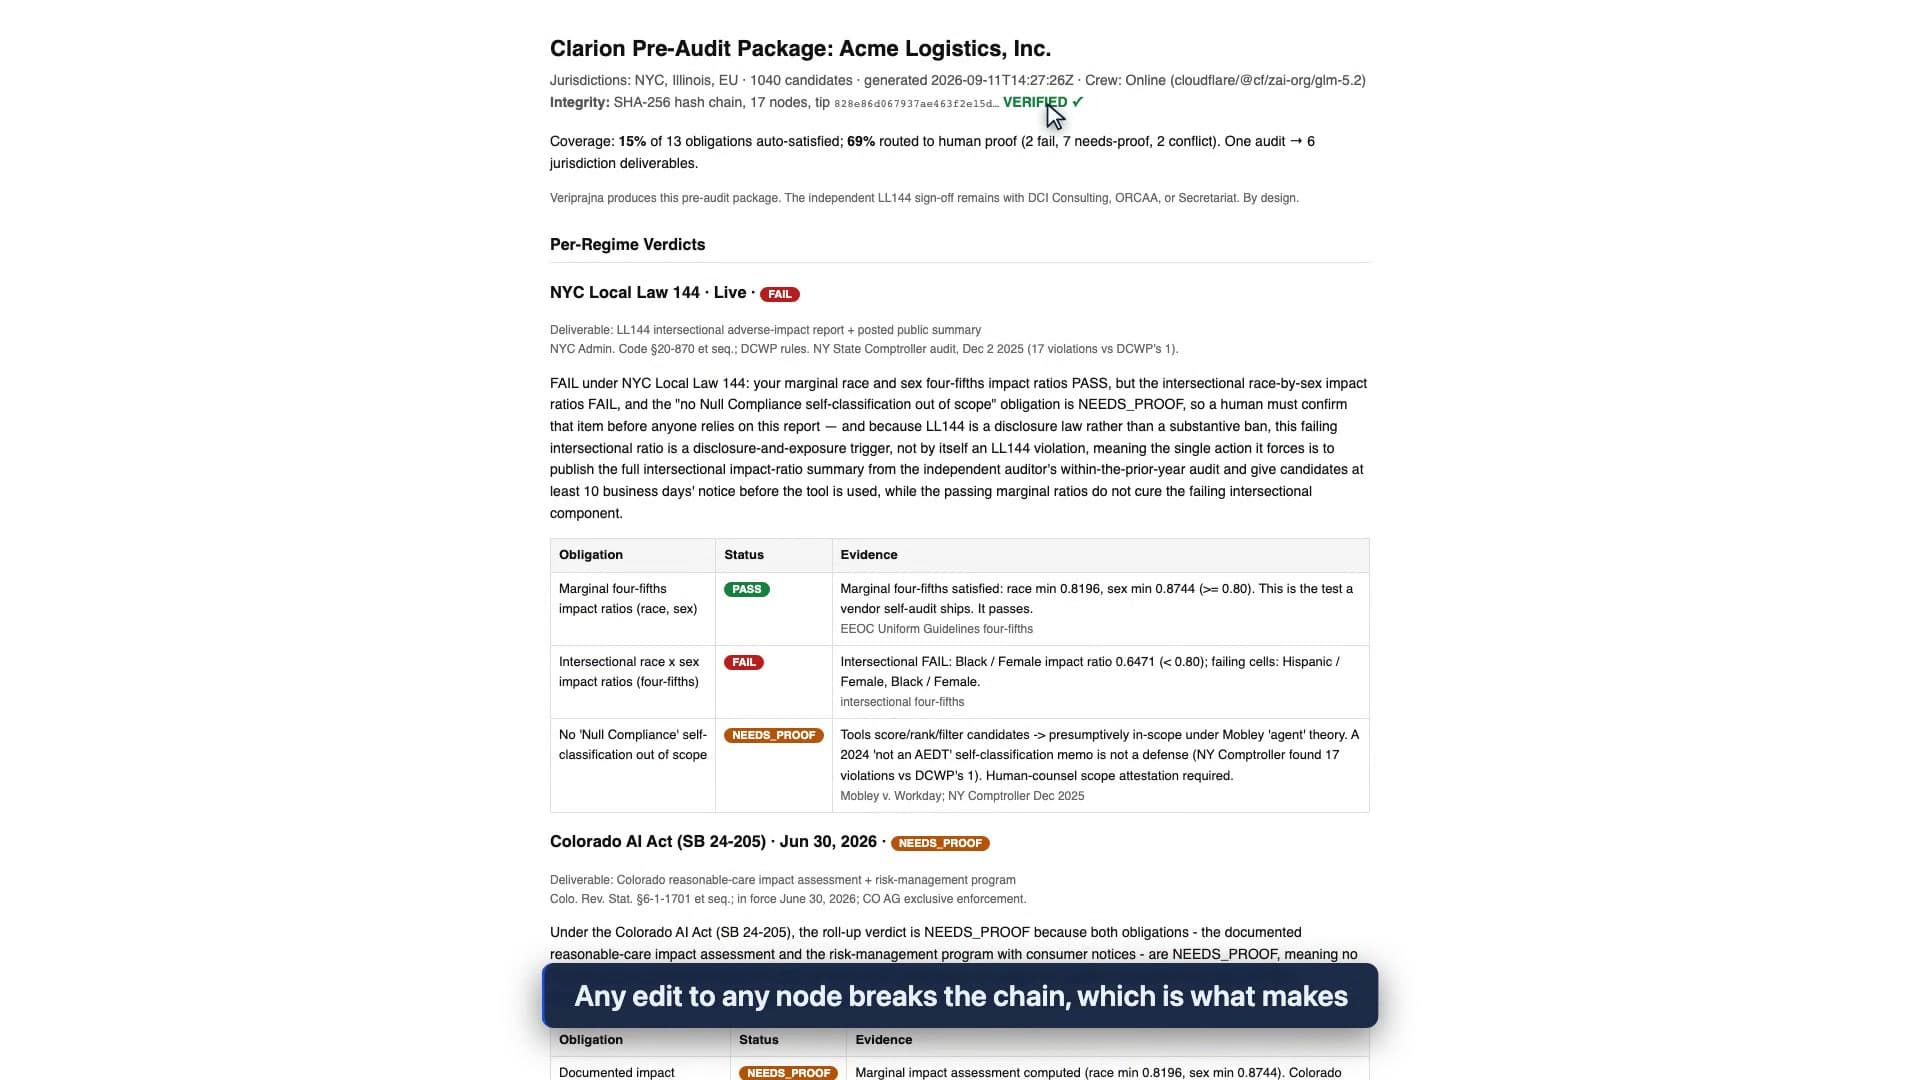
Veriprajna unterschreibt dies nicht. Die Rolle des unabhängigen Auditors für Local Law 144 gehört Firmen wie DCI, ORCAA und Secretariat, und das gesamte Designziel des Pakets besteht darin, dass eine von ihnen es unterzeichnen kann, ohne es zuvor umschreiben zu müssen. Der Durchgang des vollständigen Laufs, einschließlich des Konflikt-Memos, ist abrufbar unter veriprajna.com/demos/ai-hiring-compliance.
Und wenn Sie lieber zusehen möchten, wie das Gate die Freigabe verweigert, anstatt meine Beschreibung zu lesen: Hier ist der gesamte Durchlauf von Anfang bis Ende, einschließlich des Konflikt-Memos.
Das Konflikt-Memo hinterlässt einen Arbeitgeber exakt so rechtskonform, wie er es am Tag zuvor war. Was es hinzufügt, ist eine Abwägung, die verständlich, datiert und zuordenbar ist – sodass in zwei Jahren, wenn jemand fragt, wer beschlossen hat, das Postleitzahlenfeld beizubehalten, und was die Beteiligten zu diesem Zeitpunkt wussten, ein Dokument vorliegt, das antwortet, anstatt eines grünen Abzeichens, das mühsam erklärt werden muss.