95 % der Unternehmen verstoßen gegen ein KI-Gesetz, von dessen Existenz die meisten nichts wissen

Ich war Anfang Januar in einem Gespräch mit einer Fortune-500-CHRO – Chief Human Resources Officer –, als sie etwas sagte, das mich mitten im Satz innehalten ließ.
„Unser Juristenteam hat uns gesagt, es sei sicherer, sich einfach nicht daran zu halten.“
Sie handelte nicht leichtsinnig. Sie handelte rational. Ihr Unternehmen setzt bei Einstellungen in New York City ein KI-gestütztes Screening-Tool ein, was bedeutet, dass sie dem Local Law 144 unterliegen – einer Verordnung, die Unternehmen dazu verpflichtet, Bias-Audits aller automatisierten Tools, die bei Beschäftigungsentscheidungen mitwirken, öffentlich zu publizieren. Ihre Anwälte hatten nachgerechnet: Die Strafe für Nichteinhaltung betrug ein Bußgeld von 500 bis 1.500 US-Dollar pro Verstoß. Die Strafe für Rechtskonformität – also die tatsächliche Veröffentlichung des Bias-Audits – bestand darin, den Anwälten der Klägerseite einen statistischen Leitfaden für eine Diskriminierungsklage in die Hand zu drücken.
Dieses Gespräch brachte etwas auf den Punkt, das mich schon seit Monaten beschäftigte. Wir haben kein Problem mit KI-Ethik. Wir haben ein Problem der KI-Architektur. Und das Audit des New York State Comptroller vom Dezember 2025 hat genau das bewiesen.
Das Audit, das die Illusion zerstörte
Am 2. Dezember 2025 veröffentlichte Tom DiNapoli, der Comptroller des Bundesstaates New York, ein Audit darüber, wie das Department of Consumer and Worker Protection (DCWP) von New York City das Local Law 144 durchgesetzt hatte. Die Ergebnisse waren verheerend.
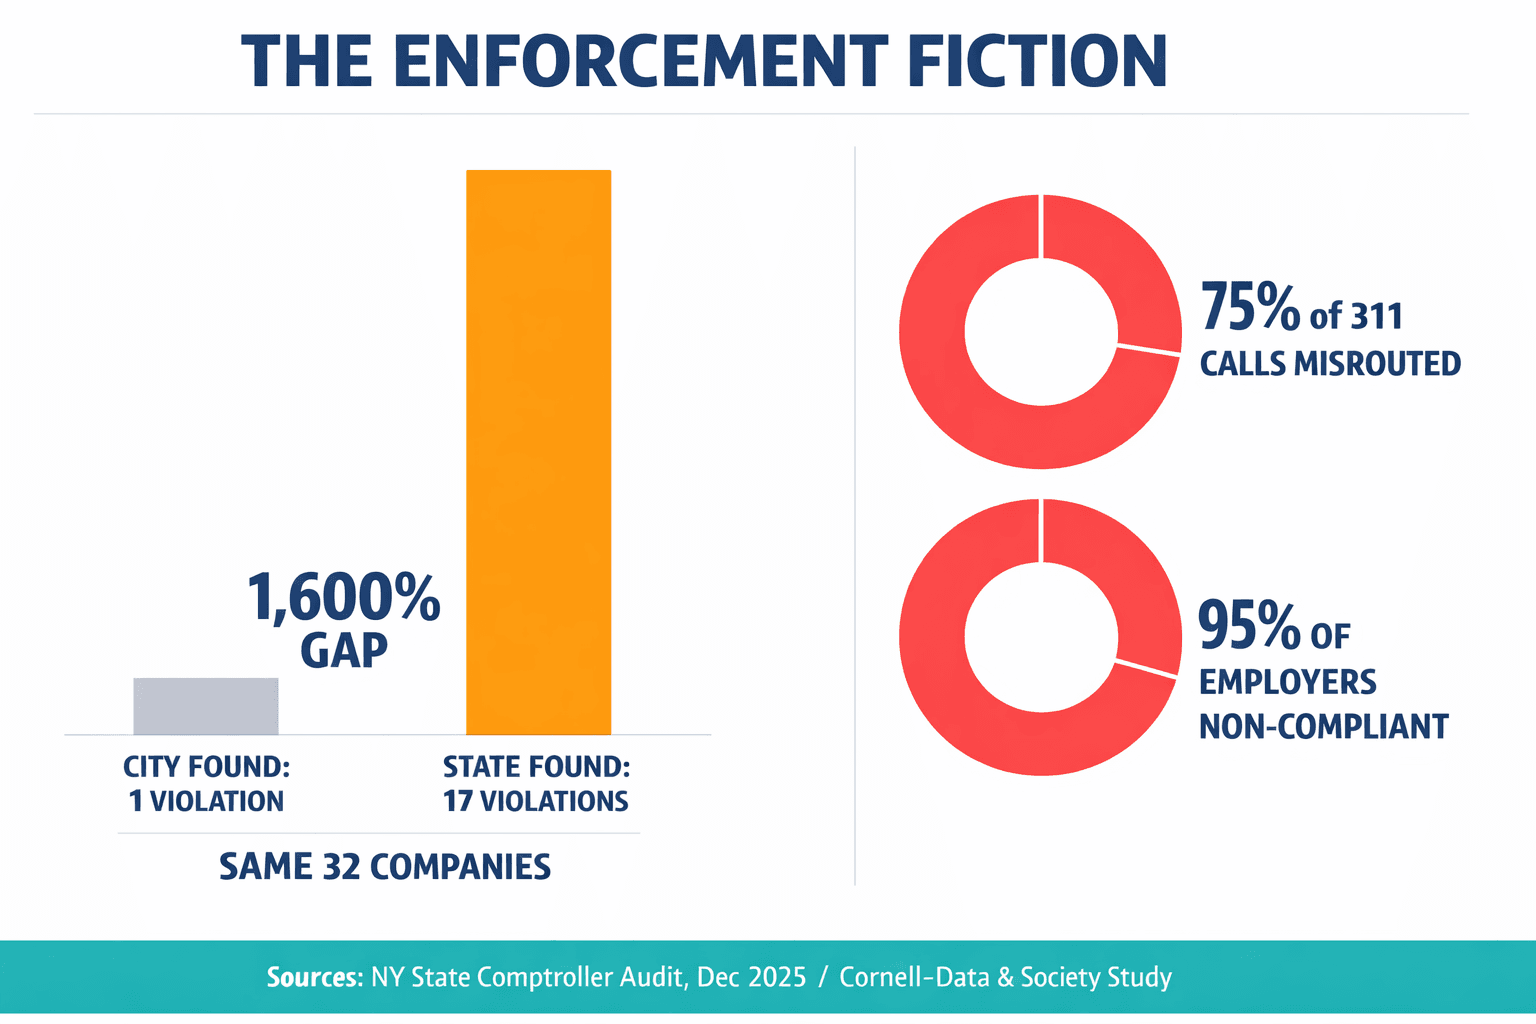
Die städtischen Prüfer selbst hatten 32 Arbeitgeber unter die Lupe genommen und genau einen Fall potenzieller Nichteinhaltung festgestellt. Die staatlichen Prüfer untersuchten dieselben 32 Unternehmen mit strengeren technischen Methoden. Sie fanden 17 Verstöße.
Das ist kein Rundungsfehler. Das ist eine Diskrepanz von 1.600 % zwischen dem, was die Stadt erfasst hat, und dem, was tatsächlich vor sich ging.
Ich erinnere mich noch daran, wie ich den Prüfbericht um 23 Uhr auf meinem Laptop las, durch die Befunde scrollte und eine Mischung aus Bestätigung und Beklemmung spürte. Bestätigung, weil dies genau die Art von Fehlschlag war, vor der wir unsere Kunden gewarnt hatten – oberflächliche KI-Compliance, die bei echter Überprüfung in sich zusammenfällt. Beklemmung, weil das Ausmaß des Problems noch schlimmer war, als selbst ich erwartet hatte.
Wenn die Stadt in derselben Stichprobe 1 Verstoß findet und der Bundesstaat 17, dann ist das keine Durchsetzungslücke – es ist eine Durchsetzungsfiktion.
Das Audit deckte etwas fast schon komisch Kaputtes auf: 75 % der Testanrufe bei der 311-Hotline der Stadt bezüglich KI-Einstellungsproblemen wurden fehlgeleitet und erreichten das DCWP nie. Die Behörde räumte ein, dass ihr das technische Fachwissen fehle, um zu beurteilen, ob Unternehmen tatsächlich automatisierte Entscheidungstools einsetzen. Sie konsultierte kein einziges Mal das städtische Office of Technology and Innovation. Der gesamte Durchsetzungsapparat war im Grunde ein potemkinsches Dorf.
Warum die meisten Unternehmen das Schweigen wählten
Hier wird es noch gravierender. Eine Studie der Cornell University, von Data & Society und Consumer Reports untersuchte 391 Arbeitgeber, die dem Local Law 144 unterliegen. Davon hatten lediglich 18 die vorgeschriebenen Bias-Audits veröffentlicht. Nur 13 hatten Transparenzhinweise platziert.
Das bedeutet, dass rund 95 % der betroffenen Arbeitgeber das Gesetz schlichtweg ignorierten.
Mein Team und ich verbrachten eine Woche damit, diese Studie durchzugehen und die Ergebnisse mit dem abzugleichen, was wir über die KI-Tools wussten, die diese Unternehmen einsetzten. In unserem Büro gab es eine fortlaufende Debatte darüber, ob es sich hierbei um massenhafte Fahrlässigkeit oder um etwas Kalkuliertes handelte. Mein CTO hielt es für Bequemlichkeit – die Unternehmen seien einfach noch nicht dazu gekommen. Ich war anderer Meinung.
Ich glaube, dass die meisten dieser Unternehmen die Audits intern durchgeführt, die Zahlen gesehen und Panik bekommen haben.
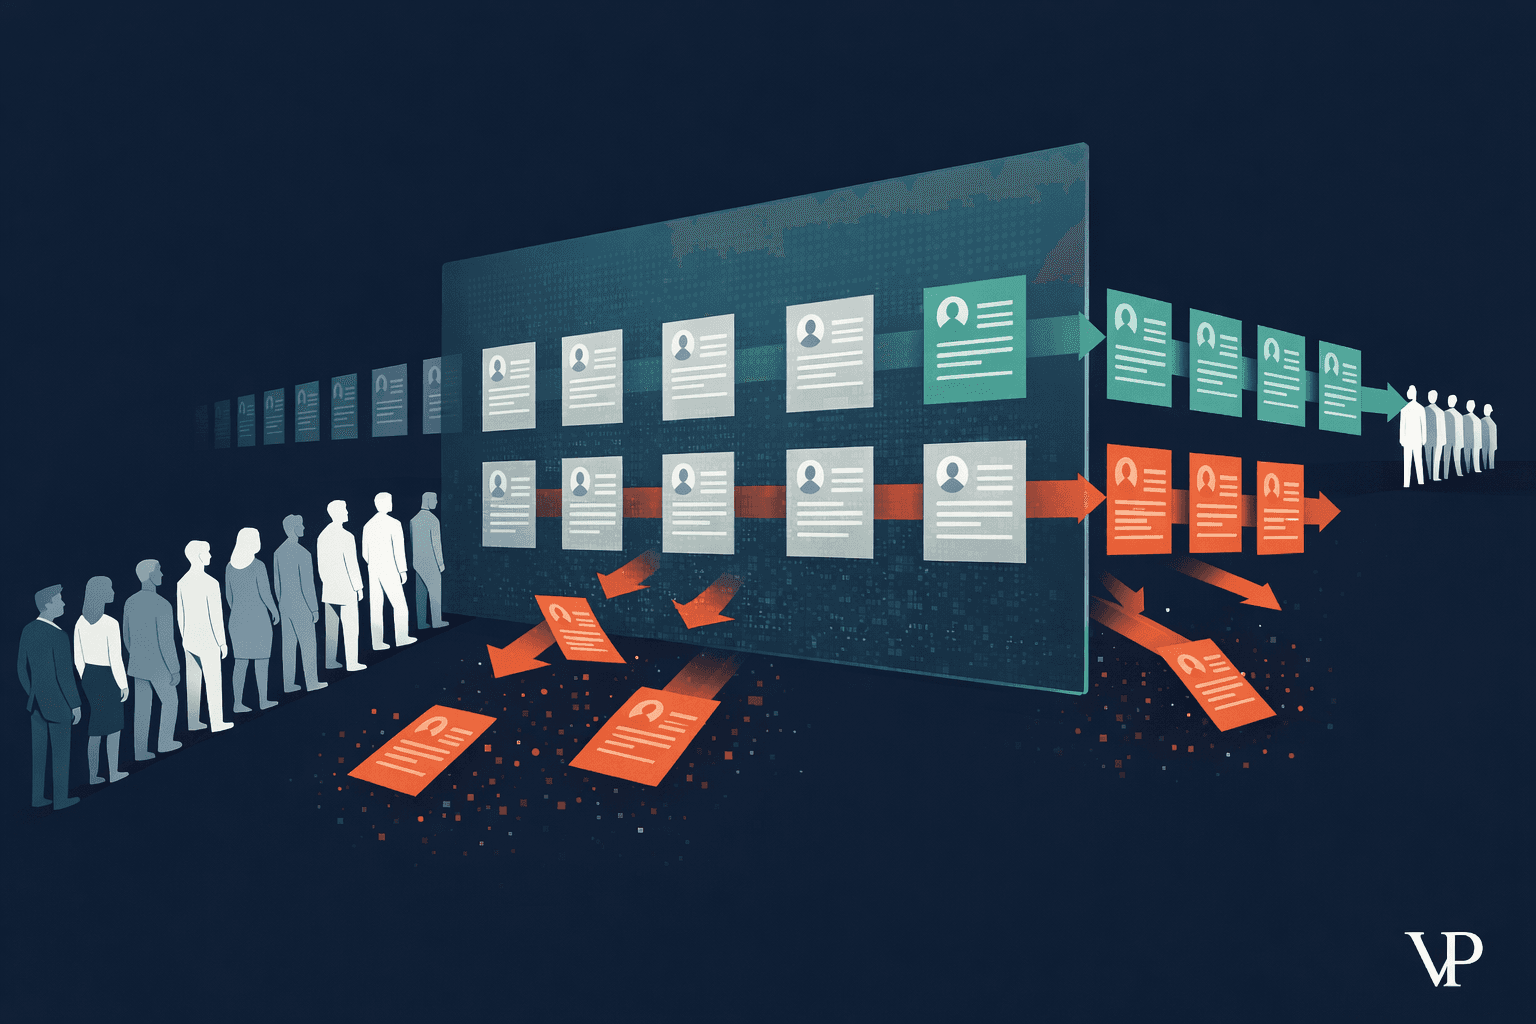
Der Grund dafür ist struktureller Natur. Das Local Law 144 verlangt die Veröffentlichung von „Impact Ratios“ (Wirkungsverhältnissen) – im Wesentlichen vergleicht man die Auswahlquoten verschiedener demografischer Gruppen und prüft, ob sie die Vier-Fünftel-Regel der EEOC erfüllen. Wenn Ihr Tool Männer mit einer Quote von 60 % und Frauen mit 40 % auswählt, ergibt das ein Verhältnis von 0,67 – unter dem Schwellenwert von 0,80, der auf eine potenzielle Benachteiligung (Disparate Impact) hinweist.
Das Problem dabei? Die meisten KI-Einstellungstools, die auf Allzweck-Sprachmodellen basieren, werden diesen Test nicht bestehen. Nicht, weil sie böswillig voreingenommen sind, sondern weil sie auf Daten im Internetmaßstab trainiert wurden, die jahrzehntelange gesellschaftliche Vorurteile widerspiegeln. Wenn man die Zahlen ehrlich durchrechnet, tritt der Bias zutage. Und wenn man diese Zahlen veröffentlicht, hat man ein juristisches Beweisstück geschaffen.
Die CHRO, mit der ich sprach, war nicht zynisch. Sie beschrieb die rationale Reaktion auf ein System, in dem die Tools selbst Beweise für Diskriminierung generieren, sobald man sie auditiert.
Was passiert, wenn man KI auf bloßem Bauchgefühl aufbaut
Ich muss etwas darüber erklären, wie die meiste Unternehmens-KI heute tatsächlich funktioniert, denn das ist die Wurzel dieser gesamten Krise.
Das dominierende Modell auf dem Markt ist derzeit das, was ich die „Wrapper-Ökonomie“ nenne. Ein Beratungsunternehmen nimmt ein Basismodell – GPT-4, Claude, Gemini –, legt eine dünne Schicht aus maßgeschneiderten Prompts und API-Aufrufen darum und verkauft es an ein Unternehmen als Lösung. Lebenslauf-Screening, Schadensbearbeitung, Risikobewertung – der Wrapper übernimmt die Benutzeroberfläche, aber das Denken findet innerhalb eines Modells statt, das niemand im Unternehmen kontrolliert, auditiert oder vollständig versteht.
Diese Modelle funktionieren, indem sie das statistisch wahrscheinlichste nächste Wort in einer Sequenz vorhersagen. Sie arbeiten auf der Basis dessen, was ich semantische Plausibilität nennen würde – was richtig klingt –, nicht auf forensischer Realität – was tatsächlich richtig ist.
Ich habe das auf die harte Tour gelernt. Zu Beginn von Veriprajna, bevor wir uns voll und ganz unserer aktuellen Architektur verschrieben hatten, führten wir einen Test durch, bei dem wir ein führendes LLM baten, eine Reihe von Lebensläufen zu bewerten und dabei „das Geschlecht zu ignorieren“. Es diskriminierte trotzdem. Nicht offen – es markierte „weiblich“ nicht als negativ. Aber es bevorzugte systematisch Lebensläufe, die bestimmte Universitäten erwähnten, bestimmte Formulierungsmuster verwendeten und bestimmte außerschulische Aktivitäten auflisteten – die allesamt in den Trainingsdaten des Modells statistisch mit dem Geschlecht korrelierten.
Einem LLM zu sagen, es solle „das Geschlecht ignorieren“, ist wie jemandem zu sagen, er solle nicht an Elefanten denken. Die Korrelationen sind fest in die Gewichte eingebrannt. Man kann sich aus strukturellem Bias nicht herausprompten.
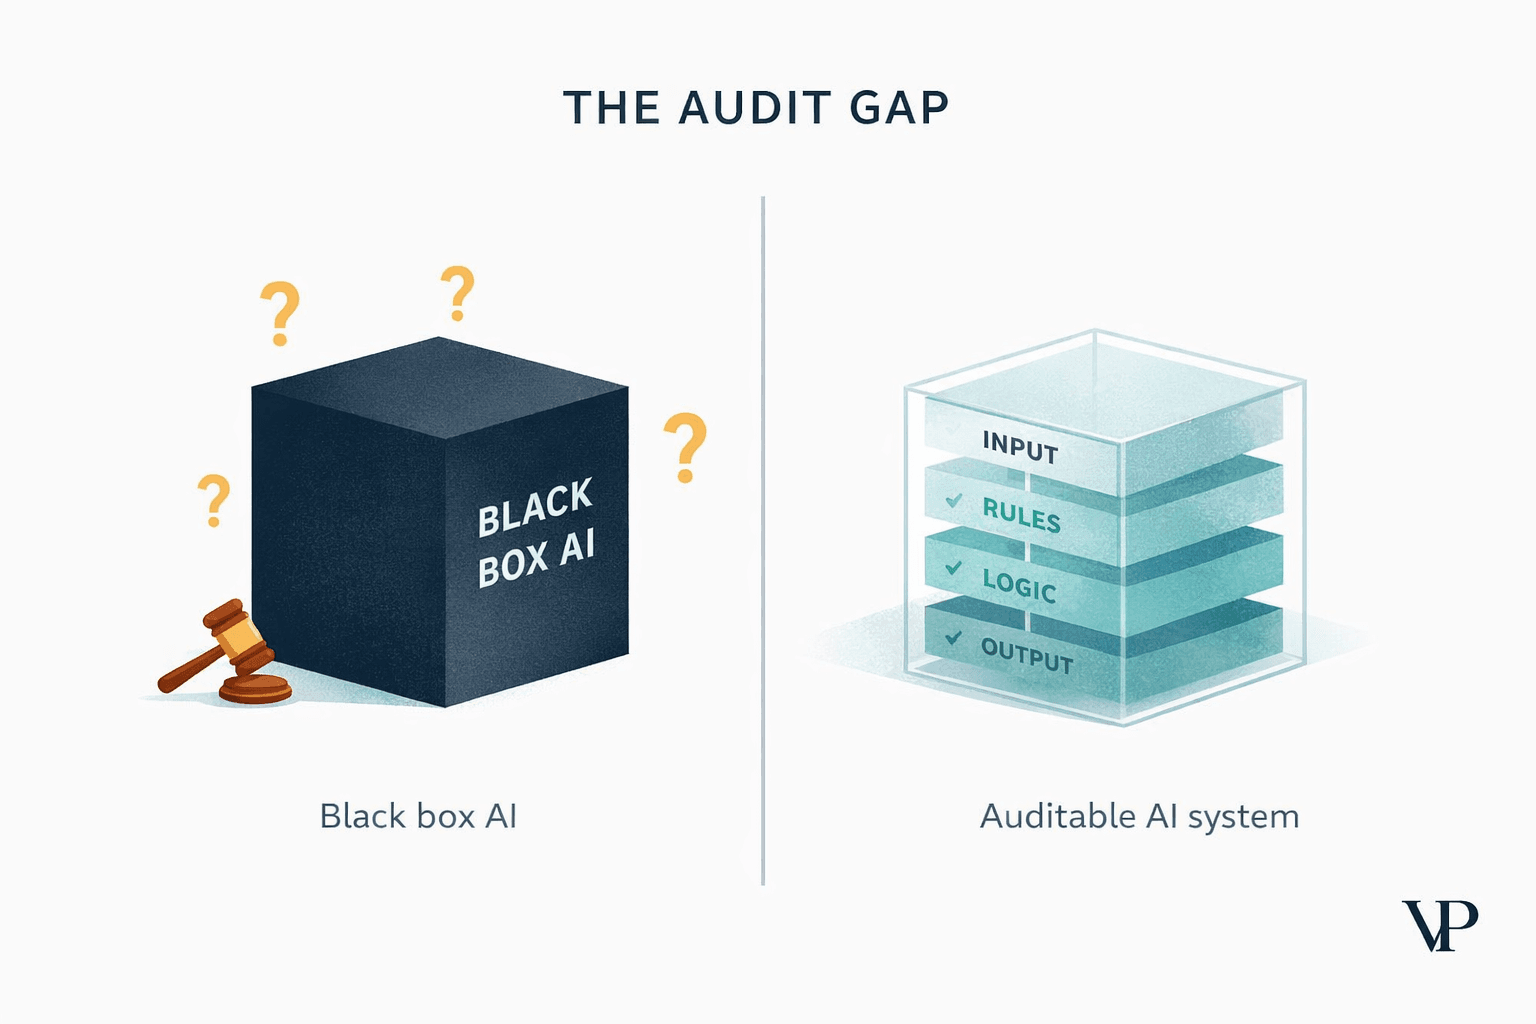
Wenn Colorado oder die EU von Ihnen verlangen, zu erklären, warum Ihre KI eine nachteilige Entscheidung getroffen hat, kann ein Wrapper-System Ihnen nur eine nachträgliche Geschichte liefern – ein plausibel klingendes Narrativ darüber, warum es glaubt, so entschieden zu haben. Das ist keine Erklärung. Das ist eine Halluzination über die eigene Argumentation. Ich habe ausführlich über dieses Problem in der interaktiven Version unserer Forschung geschrieben, in der wir aufzeigen, wie sich diese „Auditierbarkeitslücke“ über verschiedene Regulierungssysteme hinweg auswirkt.
Das Compliance-Trilemma, über das niemand spricht
Was mich nachts wachhält, ist Folgendes: Es betrifft nicht mehr nur New York.
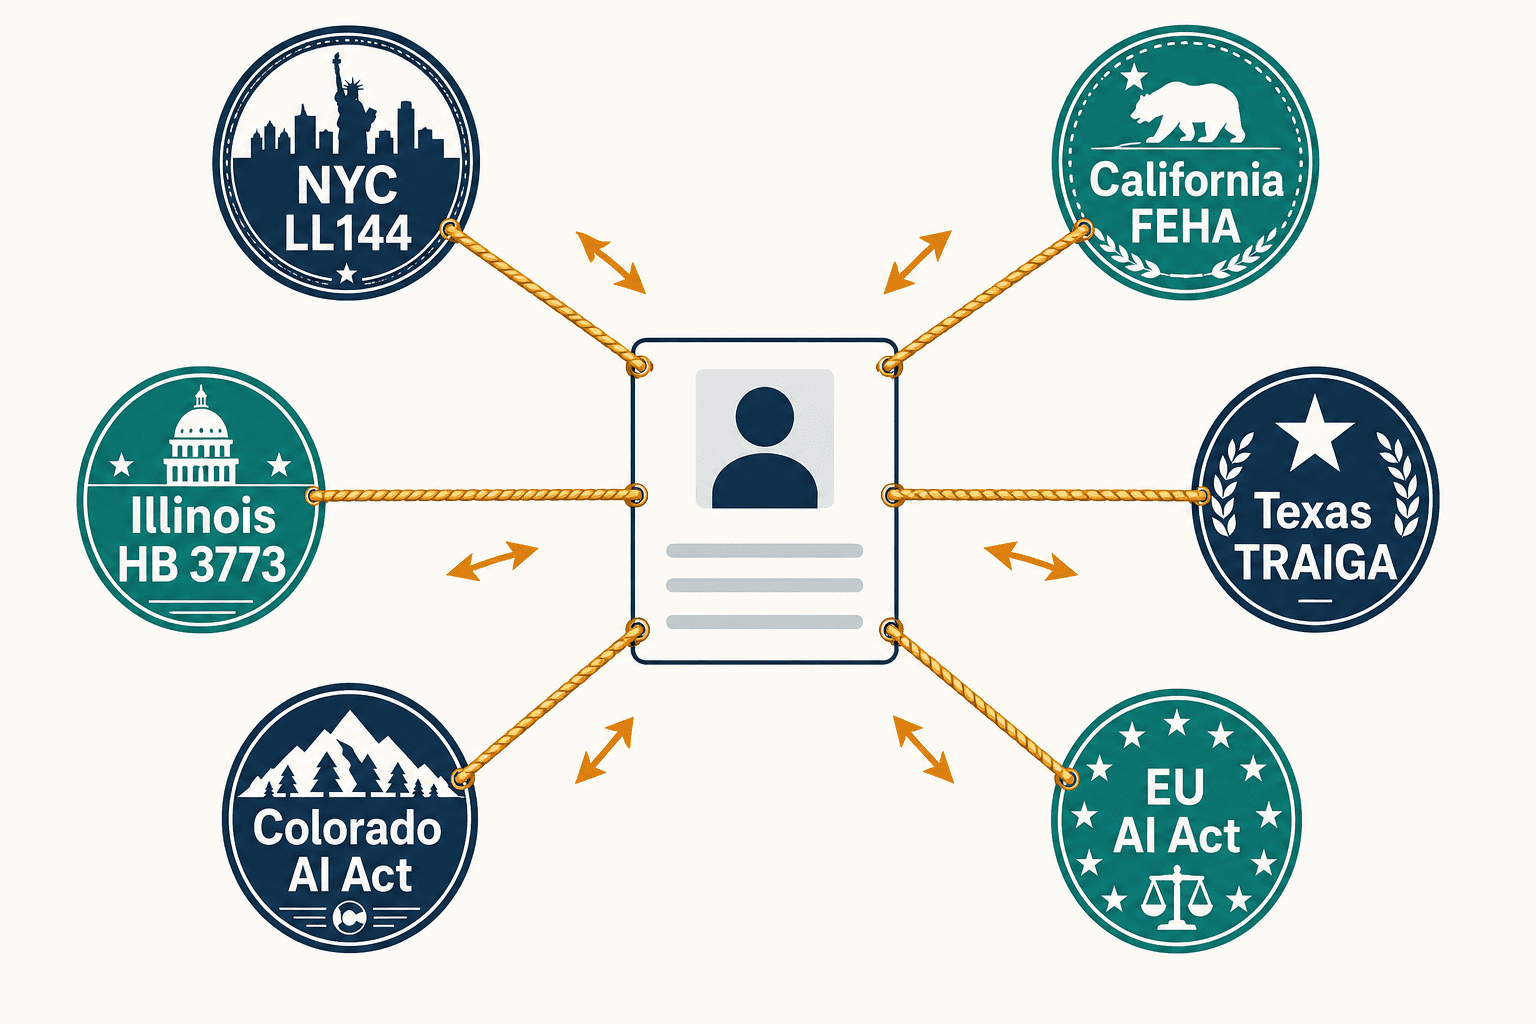
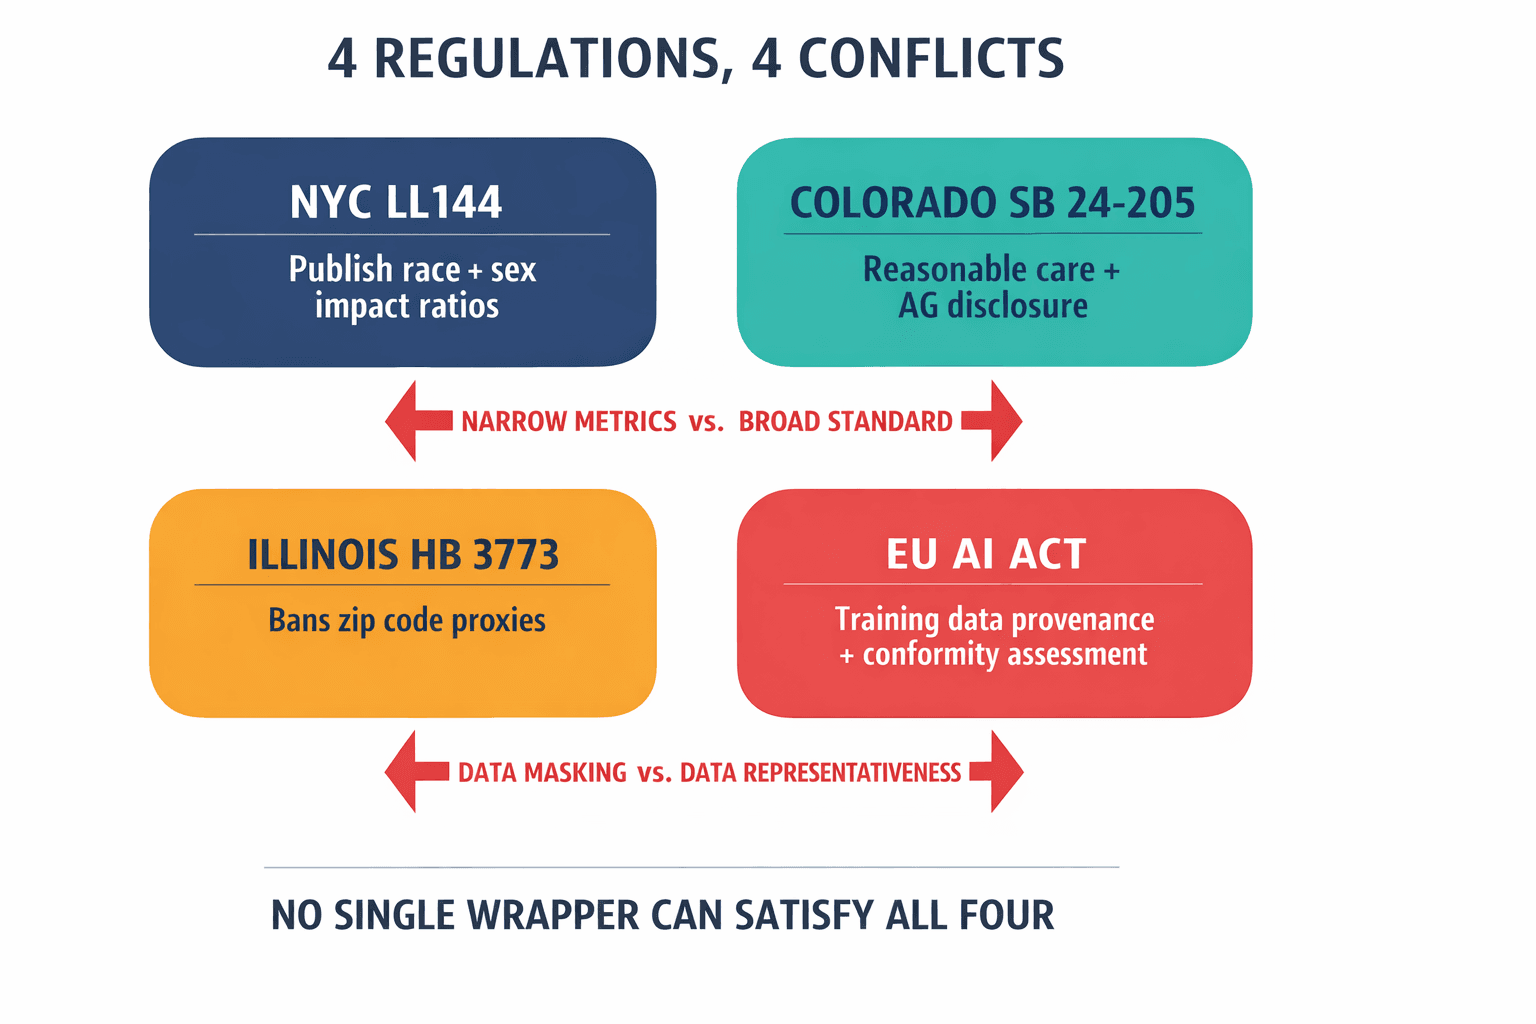
Bis Mitte 2026 werden Unternehmen, die in mehreren US-Bundesstaaten und in Europa tätig sind, mit mindestens vier sich überschneidenden – und technisch widersprüchlichen – KI-Vorschriften konfrontiert sein:
Das Local Law 144 von New York City verlangt die Veröffentlichung intersektionaler Bias-Statistiken, aufgeschlüsselt nach ethnischer Herkunft und Geschlecht. Colorados SB 24-205, gültig ab Juni 2026, fordert einen umfassenderen Standard der „angemessenen Sorgfalt“ und eine obligatorische Offenlegung gegenüber dem Generalstaatsanwalt, falls algorithmische Diskriminierung festgestellt wird. Illinois HB 3773 verbietet die Verwendung von Postleitzahlen als Proxies für geschützte Klassen – eine Technik, auf die sich viele Tools zur Bias-Minderung tatsächlich stützen. Und das KI-Gesetz der EU (EU AI Act) verlangt eine detaillierte Dokumentation der Herkunft von Trainingsdaten sowie „Konformitätsbewertungen“ für Hochrisikosysteme.
Dies sind nicht bloß unterschiedliche Regeln. Sie sind stellenweise architektonisch inkompatibel.
Eine Datenmaskierungstechnik, die Sie anwenden, um das Postleitzahlenverbot von Illinois einzuhalten, könnte die von der EU geforderte Datenrepräsentativität zunichtemachen. Ein Bias-Audit, das das Rassen- und Geschlechtermodell von New York erfüllt, könnte am Standard von Colorado scheitern, wenn es Alter und Behinderung nicht ebenfalls berücksichtigt. Und keines dieser Regelwerke akzeptiert die Aussage „Wir haben GPT-4 verwendet und einige Schutzmechanismen hinzugefügt“ als Konformitätsbewertung.
Ein Investor sagte mir letztes Jahr: „Nutzen Sie einfach GPT und setzen Sie eine Compliance-Schicht obendrauf.“ Ich fragte ihn: Welche Compliance-Schicht? Für welche Rechtsordnung? Getestet anhand welcher Metriken? Er hatte keine Antwort, weil es keine gibt. Man kann Compliance nicht auf ein System aufpfropfen, das nie darauf ausgelegt war, auditierbar zu sein.
Was wir stattdessen tatsächlich bauen
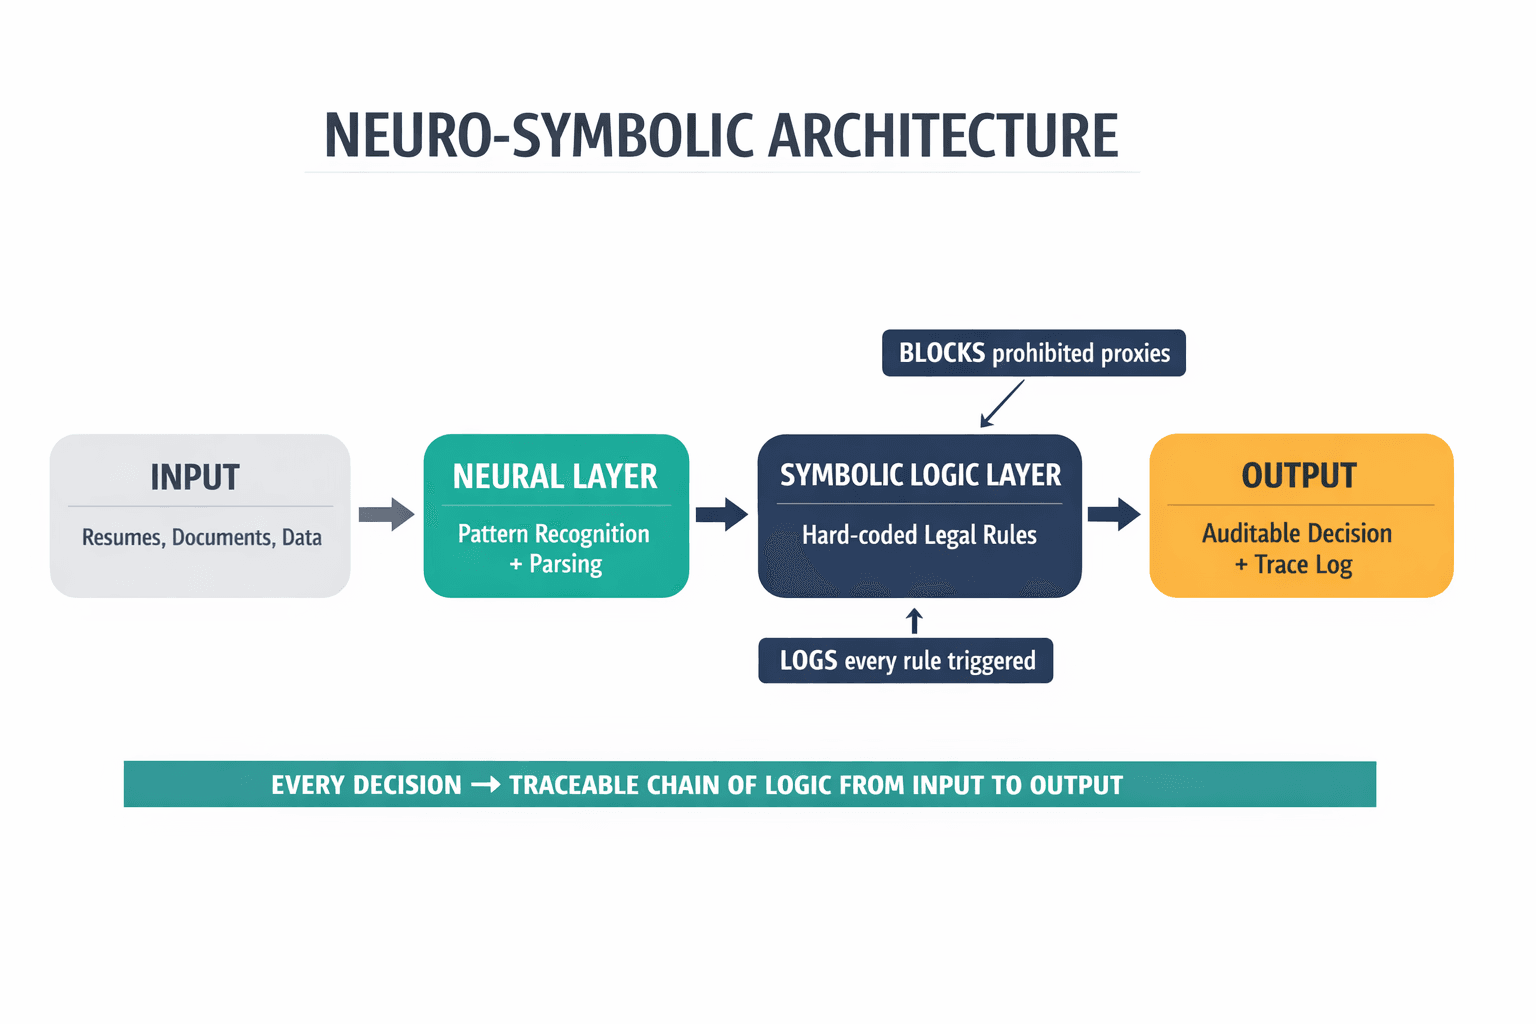
Bei Veriprajna sind wir frühzeitig eine Wette eingegangen, von der ich zugeben muss, dass sie sich damals einsam anfühlte: Wir haben das Wrapper-Modell vollständig verworfen. Keine dünnen API-Schichten. Kein Prompt-Engineering-als-Produkt. Stattdessen bauen wir das, was ich Deep AI nenne – Systeme, die von Grund auf für Determinismus, Nachvollziehbarkeit und souveräne Kontrolle entwickelt wurden.
Die Kernidee ist eine neuro-symbolische Architektur – ein System, das die „Stimme“ vom „Gehirn“ trennt. Das neuronale Netzwerk übernimmt die Mustererkennung: das Lesen von Lebensläufen, das Parsen von Dokumenten, das Identifizieren relevanter Merkmale. Doch jede Entscheidung durchläuft eine symbolische Logikschicht – fest codierte Regeln, die aus geltendem Recht, Branchenontologien und Domänenbeschränkungen abgeleitet sind –, bevor sie den Benutzer erreicht.
Wenn Illinois sagt, dass man Postleitzahlen nicht als Proxy für ethnische Zugehörigkeit verwenden darf, versucht unsere symbolische Schicht nicht einfach, dies zu vermeiden. Sie blockiert es, deterministisch, und protokolliert genau, welche Regel ausgelöst wurde und warum. Wenn eine Regulierungsbehörde eine Erklärung verlangt, generieren wir keine plausible Geschichte. Wir liefern eine nachvollziehbare Kette von Logik von der Eingabe bis zur Ausgabe.
Der Unterschied zwischen einem Wrapper und Deep AI ist der Unterschied zwischen „Das Modell hat es so gesagt“ und „Hier ist die genaue Regel, die genaue Eingabe und der genaue logische Pfad, der zu dieser Entscheidung geführt hat“.
Wir bestehen außerdem auf dem, was wir souveräne Infrastruktur nennen – die Bereitstellung von Modellen in der eigenen Cloud des Kunden, ohne sensible Daten über öffentliche APIs zu leiten. Wenn Sie Mitarbeiterakten oder Bewerberdaten an eine Drittanbieter-API senden, können diese Daten protokolliert, in künftige Trainingsläufe eingebettet oder über Sicherheitslücken offengelegt werden, auf die Sie keinen Einblick haben. Für ein Unternehmen, das der DSGVO, dem CCPA und nun diesen KI-spezifischen Vorschriften unterliegt, ist das ein unvertretbares Risiko.
Für die vollständige technische Aufschlüsselung der Funktionsweise dieser Architekturen – die graphbasierte Nachvollziehbarkeit, die physik-informierten Verifikationsschichten, die Edge-nativen Bereitstellungsmodelle – verweise ich auf unser ausführliches Forschungspapier. Das Engineering ist anspruchsvoll, aber das Prinzip ist einfach: Jede Ausgabe muss nachweisbar korrekt sein, nicht wahrscheinlich korrekt.
„Aber ist das nicht übertrieben?“
Die Leute fragen mich das ständig. Meistens ist es jemand, dem das Wrapper-Modell schmackhaft gemacht wurde und der meint, ich würde die Dinge verkomplizieren.
Hier ist meine Antwort: Der New York State Comptroller hat soeben bewiesen, dass selbst eine wohlwollende behördliche Überprüfung – durchgeführt von der städtischen Behörde selbst – mit einer Fehlerquote von 1.600 % arbeitete. Die Prüfer auf Bundesstaatsebene stellten 17 Verstöße fest, wo die Stadt nur 1 fand. Und das bei einer Stichprobe von lediglich 32 Unternehmen.
Was passiert, wenn der Generalstaatsanwalt von Colorado mit den Ermittlungen beginnt? Was passiert, wenn die EU ihre Konformitätsbewertungen aufnimmt? Was passiert, wenn der Anwalt eines Klägers die Entscheidungsprotokolle Ihres Modells vorladen lässt und feststellt, dass Ihre „Bias-Minderung“ aus einem System-Prompt bestand, der besagte: „Bitte sei fair“?
Das ist keine Hypothese. Das Audit des Comptrollers empfahl ausdrücklich den Übergang von einer passiven, beschwerdegetriebenen Durchsetzung zu einer proaktiven, forschungsbasierten Untersuchung. Das DCWP erklärte sich bereit, diese Empfehlung zu übernehmen. Die Ära des „Niemand kontrolliert es“ ist vorbei.
Es gibt noch einen weiteren Einwand, den ich höre: „Wir warten einfach ab, bis sich die Vorschriften eingependelt haben, bevor wir investieren.“ Ich verstehe den Impuls. Aber die Cornell-Studie hat gezeigt, dass die Unternehmen, die abgewartet haben – die 95 %, die sich nicht daran hielten –, nun auf einem wachsenden Berg juristischer Risiken sitzen, ohne über eine Infrastruktur zu verfügen, um diesen zu begegnen. Wenn die Durchsetzung anzieht, werden sie keine Monate haben, um konforme Systeme aufzubauen. Sie werden Wochen haben.
Die Nacht, in der die Zahlen meine Meinung änderten
Ich möchte einen Moment teilen, der meine Sicht auf dieses Problem grundlegend verändert hat.
Vor etwa acht Monaten führten wir einen Proof-of-Concept für einen Finanzdienstleistungskunden durch. Sie wollten testen, ob ihr bestehendes KI-Screening-Tool – das Produkt eines bekannten Anbieters, basierend auf einem großen LLM – ein simuliertes LL144-Audit bestehen könnte. Mein Team richtete den Test ein, berechnete die Wirkungsverhältnisse und schickte mir die Ergebnisse gegen 21 Uhr.
Ich hatte marginale Fehlschläge erwartet – Quoten von 0,75 oder 0,78, nahe genug, dass eine Neukalibrierung sie beheben könnte. Stattdessen stellten wir für bestimmte intersektionale Kategorien Wirkungsverhältnisse von bis zu 0,58 fest. Nicht annähernd am Schwellenwert. Nicht durch Prompt-Tuning behebbar. Strukturell und fundamental voreingenommen auf eine Weise, die für die Menschen, die das Tool täglich nutzen, unsichtbar war.
Ich saß in meinem Arbeitszimmer, starrte auf diese Zahlen und begriff etwas, dem sich meiner Meinung nach die gesamte Branche stellen muss: Die Tools, die die meisten Unternehmen derzeit einsetzen, würden ihre eigenen Bias-Audits nicht bestehen. Bei der Nichteinhaltungsquote von 95 % geht es nicht bloß darum, dass Unternehmen das Gesetz ignorieren. Es geht um Unternehmen, die sahen, was eine Einhaltung offenbaren würde, und beschlossen, dass sie es lieber gar nicht wissen wollen.
Das ist kein regulatorisches Problem. Das ist ein Versagen des Engineerings.
Wohin die Reise als Nächstes geht
Das Audit vom Dezember 2025 ist nicht das Ende der Kinderkrankheiten der KI-Regulierung. Es ist der Beginn ihrer Reifephase. Die Regulierungsbehörden lernen aus ihren Fehlern. Die nächste Generation der Durchsetzung wird sich nicht auf 311-Hotlines und selbstberichtete Offenlegungen stützen. Sie wird forensische Werkzeuge einsetzen, um zu untersuchen, was Ihre KI tatsächlich tut – nicht das, was Ihr Compliance-Team behauptet.
Für Unternehmen bedeutet dies, dass sich das Zeitfenster für architektonische Entscheidungen schließt. Man kann einem probabilistischen System nicht nachträglich Determinismus aufpfropfen. Man kann eine Blackbox nicht nachträglich auditierbar machen. Man kann nicht vier widersprüchliche Rechtsordnungen mit einer einzigen Prompt-Vorlage einhalten.
Die Unternehmen, die im Jahr 2026 und darüber hinaus florieren werden, sind diejenigen, die jetzt die schwierigere Entscheidung treffen: Systeme zu bauen, bei denen jede Entscheidung eine nachvollziehbare, auditierbare und vertretbare Kette von Logik aufweist. Nicht, weil es einfach ist. Nicht, weil es billig ist. Sondern weil es die einzige Architektur ist, die den Kontakt mit einer Regulierungsbehörde übersteht, die tatsächlich weiß, wonach sie sucht.
Die Ära der auf bloßem Bauchgefühl aufgebauten KI ist vorbei. Was an ihre Stelle tritt, wird von Unternehmen geprägt sein, die bereit sind, Gewissheit in Systeme einzubauen, die der Rest der Branche auf Wahrscheinlichkeiten aufgebaut hat.
Die CHRO, mit der ich im Januar gesprochen hatte, rief mich letzte Woche zurück. Ihr Juristenteam hatte das Audit des Comptrollers gelesen. Sie rieten nicht mehr zur Nichteinhaltung. Sie fragten, wie schnell wir das System bereitstellen könnten.