L'Illinois interdit le code postal que l'EU AI Act veut conserver : j'ai conçu un audit d'embauche par IA qui le signale au lieu de valider aveuglément.

Le 2 décembre 2025, le New York State Comptroller a publié un examen du même échantillon de 32 entreprises que le Department of Consumer and Worker Protection de la ville avait déjà analysé dans le cadre de la Local Law 144, et a dénombré 17 infractions potentielles là où le DCWP n'en avait trouvé qu'une seule. Le DCWP a accepté de passer à une application proactive de la loi.
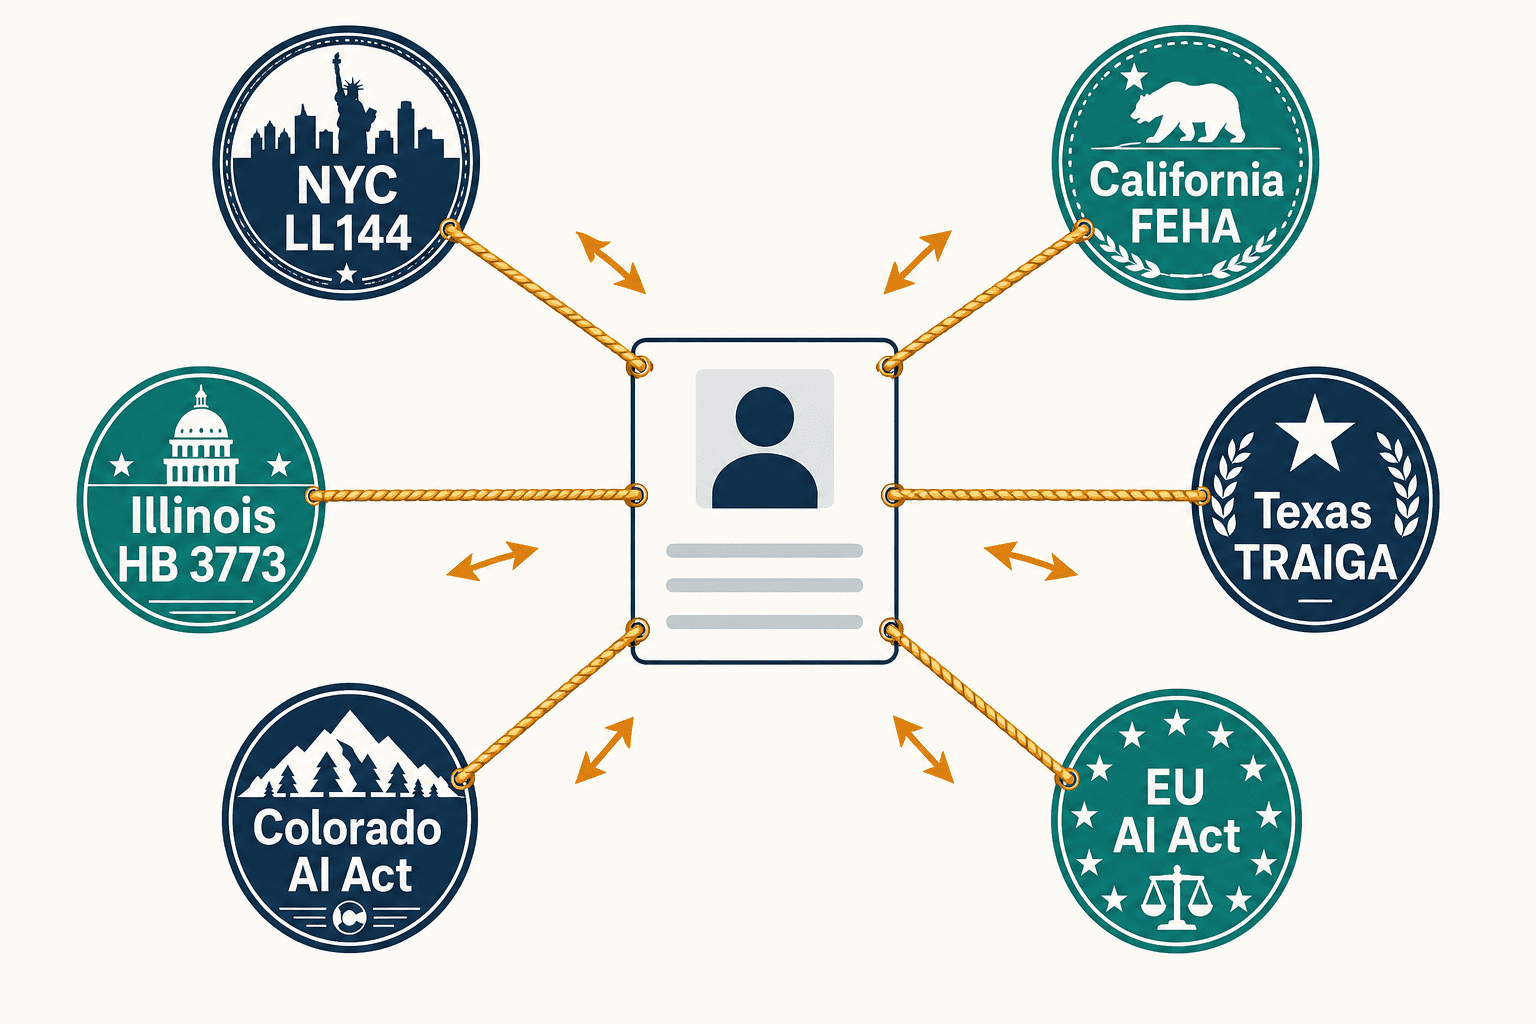
En lisant cela, j'ai d'abord pensé que la véritable difficulté d'ingénierie résidait dans la détection : concevoir un système capable d'intercepter les biais que la première passe avait manqués. La rédaction des packs de règles m'a fait changer d'avis, car la détection s'est avérée être la partie facile. La partie difficile, c'est qu'un employeur déployant des outils de recrutement automatisés à New York, au Colorado, en Illinois, au Texas, en Californie et dans l'Union européenne doit répondre à six régulateurs exigeant six documents de formes radicalement différentes, et qu'en un point au moins, deux d'entre eux attendent des choses diamétralement opposées de la même colonne de données.
J'ai donc conçu une surcouche de conformité pour cela, une console baptisée Clarion qui se superpose aux outils de recrutement par IA qu'un employeur utilise déjà, lit un export unique de scores fournisseur, calcule chaque statistique d'impact défavorable en code déterministe et déploie cet audit unique en six livrables adaptés aux exigences de chaque juridiction. Vous pouvez voir comment elle fonctionne sur veriprajna.com/demos/ai-hiring-compliance. Tout ce qui suit s'exécute sur un export synthétique initialisé de 1 040 dossiers de candidats pour un employeur fictif, « Acme Logistics, Inc. », sur l'offre d'emploi REQ-2026-0412. J'ai moi-même injecté l'infraction dans ces données, ce qui est la seule raison pour laquelle je peux vous dire exactement ce que le moteur était censé trouver.
L'audit qui réussit n'est pas l'audit exigé par la loi
Bien qu'ayant initialisé le jeu de données, le premier résultat a tout de même réussi à m'irriter. Le test marginal des quatre cinquièmes, celui que livre l'auto-audit d'un fournisseur, réussit sans encombre : ratio d'impact minimum pour la race de 0,8196, avec les candidats hispaniques et noirs à égalité sur ce seuil minimum, et ratio minimum selon le sexe de 0,8744. Tous deux se situent sur ou au-dessus de la ligne des 0,80. Rien dans le code ne force cette validation. La valeur 0,8196 est simplement le résultat du calcul sur le jeu d'essai, et elle franchit la ligne d'elle-même. À l'écran, le tableau récapitulatif l'indique sans détour : le fournisseur s'arrête ici.
La Local Law 144 ne s'arrête pas là. Elle exige des ratios intersectionnels croisant race et sexe, et les candidats synthétiques sont évalués par trois outils simulés (un outil de notation de type Workday-Spotlight, un entretien vidéo de type HireVue et un moteur d'appariement de type Eightfold) qui sont des adaptateurs de jeu d'essai sur ces données synthétiques, des archétypes plutôt que des intégrations directes. Segmentez ces mêmes dossiers par race et par sexe, et le tableau s'inverse. Par rapport à la cellule de référence Homme blanc, qui retient 68 candidats sur 130 soit 52,31 %, la cellule Femme noire en retient 44 sur 130, soit 33,85 %. Ratio d'impact : 0,6471. La cellule Femme hispanique échoue également, à 0,7647.
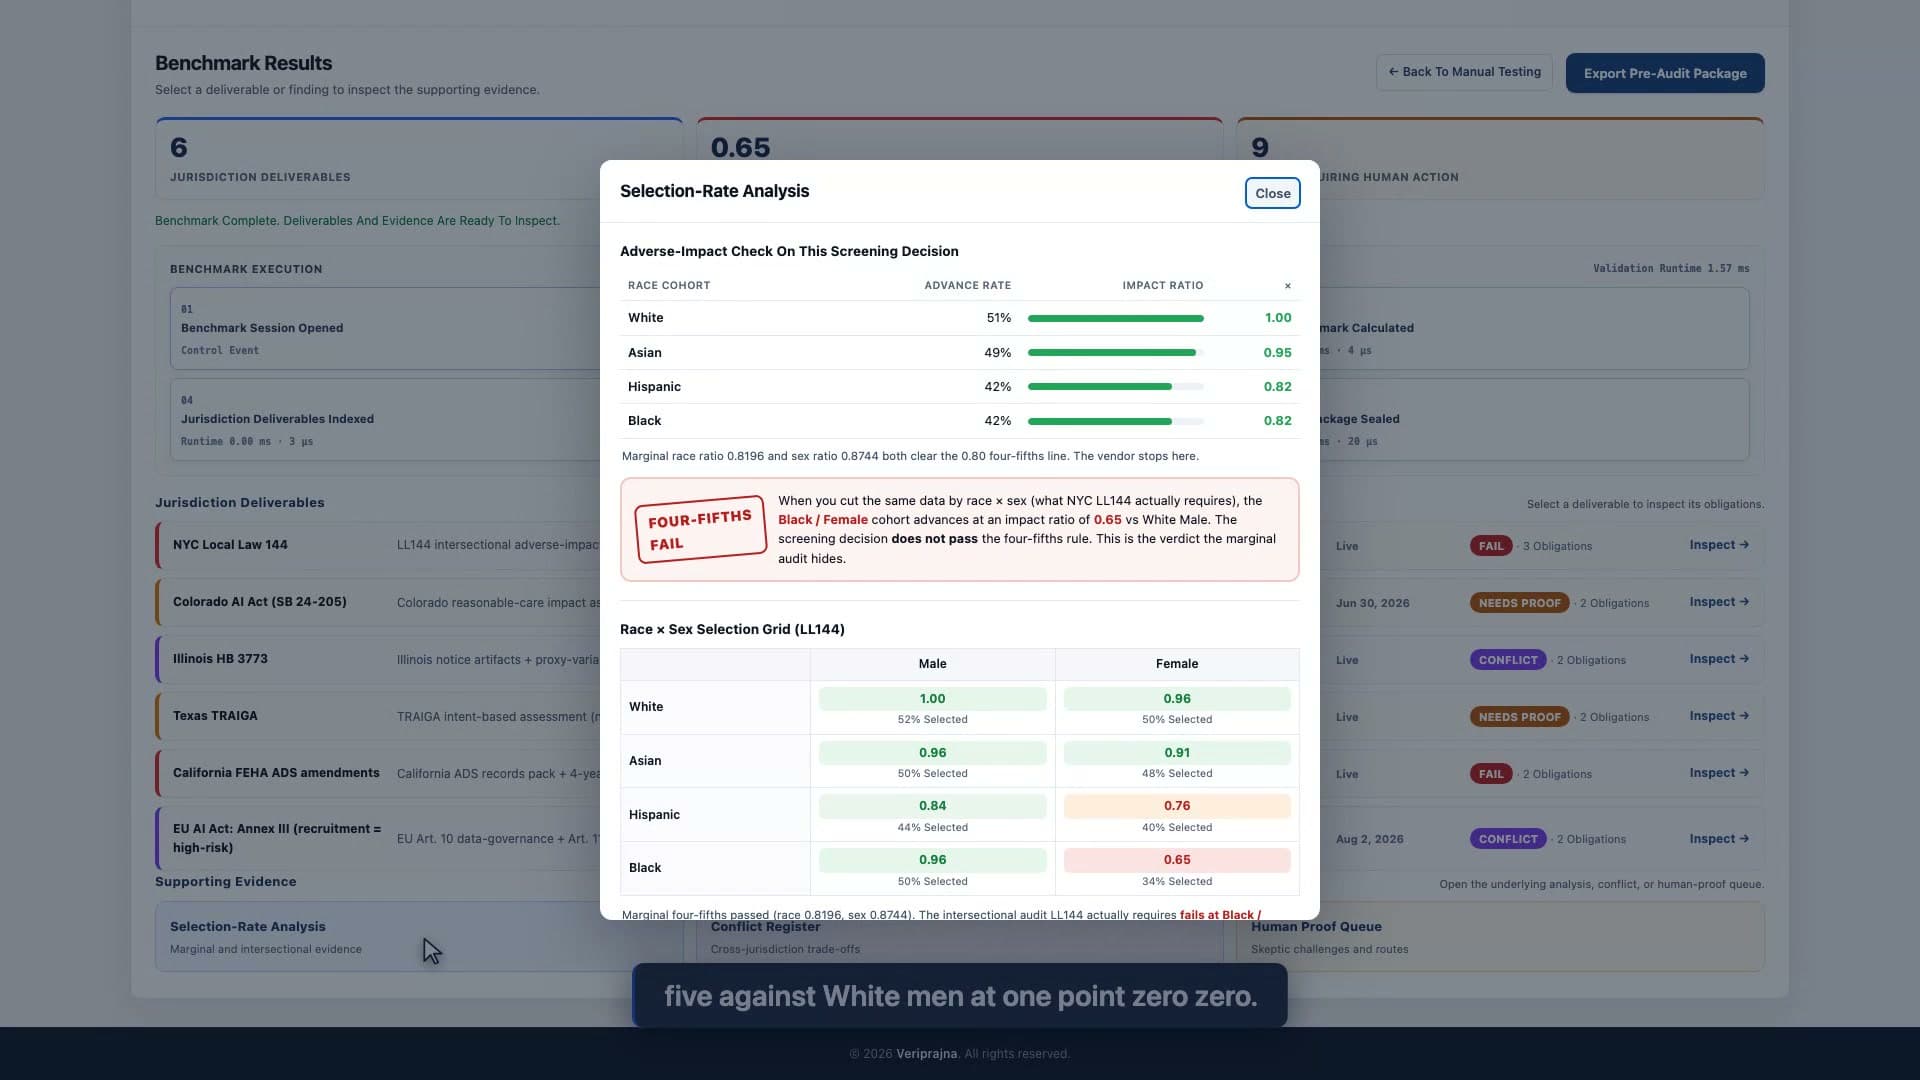
C'est sur la cellule Femme hispanique que j'ai débattu avec mon propre moteur. Sous le contrôle du taux de fausses découvertes de Benjamini-Hochberg à un seuil alpha de 0,05, seule la cellule Femme noire s'avère statistiquement robuste, avec q = 0,0185. La cellule Femme hispanique atteint q = 0,1629 ; le moteur la signale donc mais refuse explicitement de la qualifier de significative. J'aurais aimé que les deux cellules soient retenues, car deux cellules en échec constituent une histoire plus percutante qu'une seule. Le moteur fait la distinction entre une découverte robuste et un artefact statistique, ce qui correspond exactement à la rigueur que j'exigerais pour mes propres chiffres si j'étais l'employeur destinataire du rapport.
Six régulateurs, six documents différents
J'ai rédigé les six packs de règles l'un après l'autre en m'efforçant de les condenser en un score unique, car un tableau de bord ne peut afficher qu'un seul chiffre et c'est ce qu'un acheteur attend. Cette idée n'a jamais résisté à l'épreuve des textes de loi. La ville de New York exige un rapport d'impact défavorable intersectionnel assorti d'un résumé public affiché. La loi SB 24-205 du Colorado impose une évaluation d'impact de diligence raisonnable documentée et un programme de gestion des risques, sans spécifier la moindre méthodologie, applicable au 30 juin 2026. La loi TRAIGA du Texas rejette l'impact disparate comme fondement autonome et s'intéresse à l'intention. Les amendements FEHA ADS de Californie sont en vigueur depuis le 1er octobre 2025 et réclament à nouveau leur propre format documentaire. L'EU AI Act qualifie le recrutement de système à haut risque selon l'Annex III et exige une gouvernance des données selon l'Article 10 ainsi qu'un dossier technique selon l'Article 11, à compter du 2 août 2026.
Le score unique a trouvé sa fin sur le pack du Texas. J'avais déjà construit le livrable new-yorkais à partir des ratios intersectionnels, or TRAIGA rend ces statistiques précises dénuées de toute pertinence probatoire pour sa propre évaluation ; aucune pondération ne pouvait donc permettre à un chiffre unique de traduire ces deux réalités. Six questions distinctes, posées sous six formats différents, et un score d'équité ne répond qu'à environ une question et demie. Clarion produit donc six livrables, chacun portant sa propre référence légale, sa date d'entrée en vigueur et son format requis, et les pavés d'en-tête de la console rendent compte de la couverture plutôt que d'attribuer une note : Livrables de juridiction 6, Ratio d'impact le plus bas 0,65, Éléments nécessitant une intervention humaine 9.
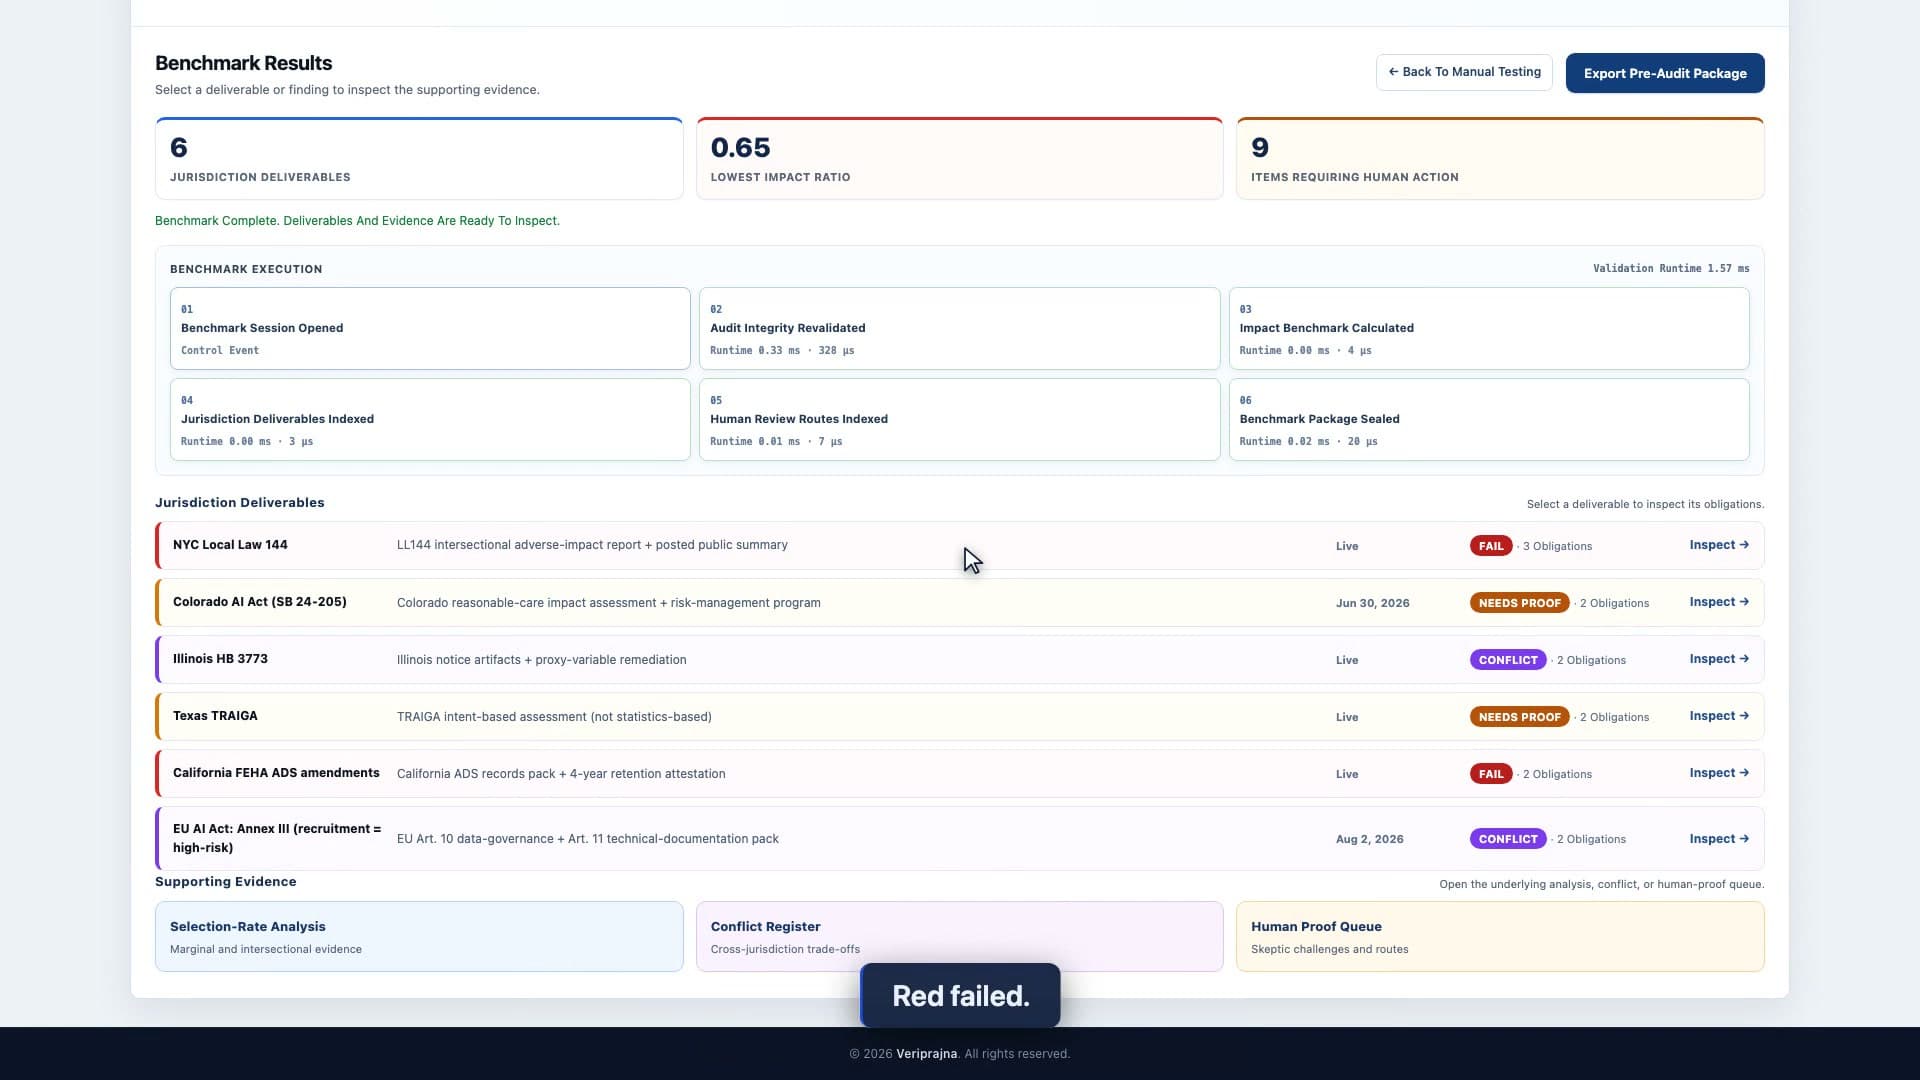
Cette colonne de résultats mitigés est le résultat honnête, et c'est aussi celui que personne ne fournit. Des chercheurs de Cornell, de Data & Society et de Consumer Reports ont vérifié 391 employeurs new-yorkais au regard de l'audit imposé par la Local Law 144 et n'ont trouvé d'audits de biais publiés que pour 4,6 % d'entre eux (FAccT 2024). L'obligation est pourtant en vigueur. Le taux de conformité frôle l'erreur d'arrondi, et mon interprétation est qu'une grande partie de ce fossé provient d'employeurs qui croient sincèrement que l'unique ratio favorable fourni par leur prestataire a réglé la question.
V de Cramér à 0,3321 sur zip_region, et deux régimes aux exigences opposées
J'ai écrit un mécanisme de résolution pour le problème du code postal avant d'en comprendre la véritable nature, et sa suppression a marqué le tournant décisif du produit. Le moteur détecte les variables de substitution (proxies) de catégories protégées par corrélation, et zip_region ressort avec un V de Cramér de 0,3321 par rapport à la race, 0,3253 corrigé du biais, soit au-dessus du seuil de 0,2. C'est un proxy. Il ne s'agit pas non plus d'une heuristique qui signale tout sans discernement : school_tier se situe à 0,0711 lors de la même exécution et passe sans encombre.
La loi HB 3773 de l'Illinois, entrée en vigueur le 1er janvier 2026, interdit les codes postaux en tant que substituts de catégories protégées ; la configuration conforme pour l'Illinois masque donc la géographie. L'Article 10(3) de l'EU AI Act exige des données d'entraînement pertinentes, représentatives et exhaustives, ce qui en pratique repose sur la couverture géographique que l'Illinois vient précisément de vous ordonner de supprimer. Masquez le champ et l'obligation de représentativité de l'UE est compromise. Conservez-le et vous violez la loi de l'Illinois. Une seule et même configuration de modèle ne peut satisfaire les deux.
Mon résolveur avait désigné un gagnant. Il comparait les deux niveaux d'exposition, choisissait le plus élevé et délivrait un statut vierge pour l'autre volet, ce qui correspond exactement au comportement qui introduit une fausse déclaration dans un document officiel déposé. Je l'ai supprimé et remplacé par un verdict que la porte d'évaluation est autorisée à rendre : CONFLICT. Le réconciliateur rédige alors un mémo de stratégie juridique au lieu d'une certification. Déployez deux configurations distinctes : un masquage géographique total pour l'inférence en Illinois et une variable régionale plus globale pour les données d'entraînement de l'UE. Ou, si une configuration unique s'impose, choisissez le régime au risque le plus élevé et documentez le risque accepté, en notant que les sanctions pour haut risque au titre de l'UE atteignent le montant le plus élevé entre 15 millions d'euros ou 3 % du chiffre d'affaires annuel mondial en tant que plafond légal.
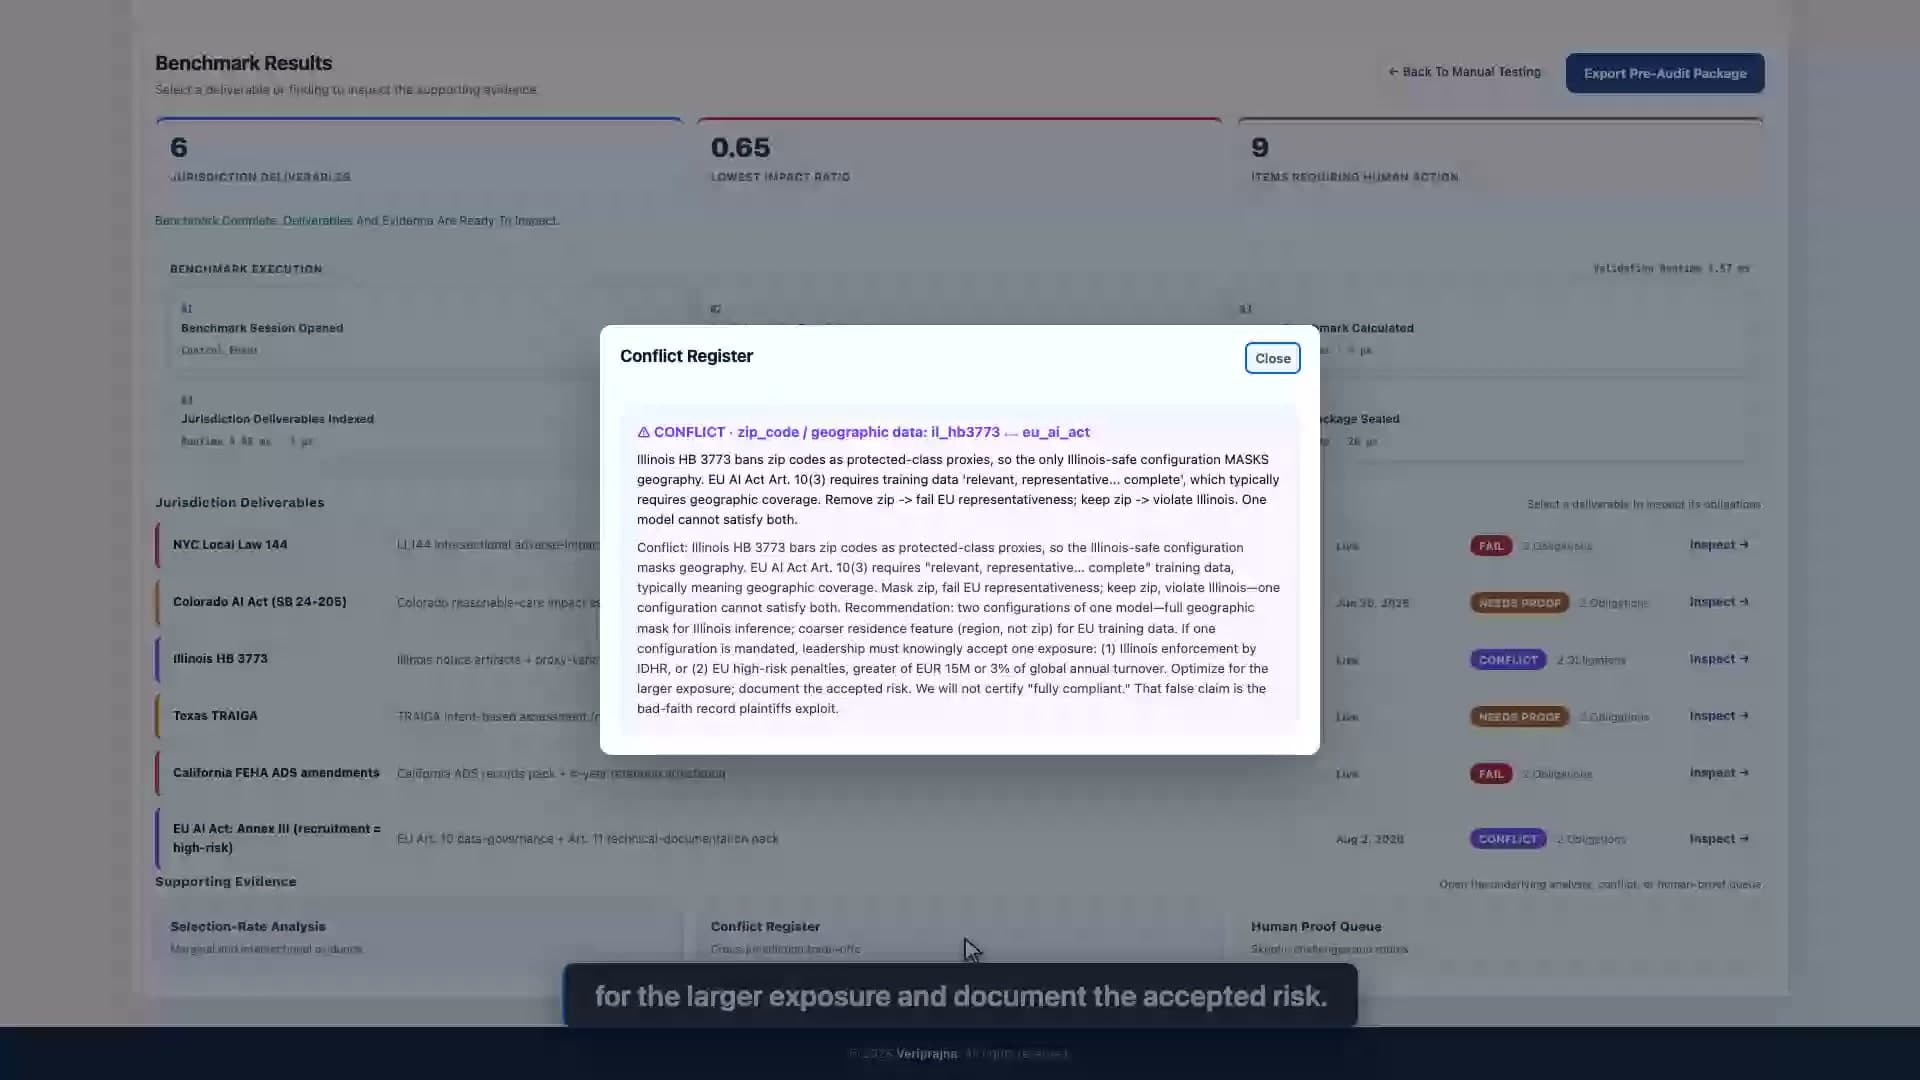
Un tableau de bord qui affiche « conforme » constitue, dans un tribunal, une pièce à conviction. Un mémo qui affirme « nous étions informés, nous avons chiffré les deux options et nous avons fait un choix » constitue une défense.
C'est l'arbitrage que je ferais systématiquement si j'étais directeur juridique, et c'est le compromis qu'aucun produit conçu pour rassurer un acheteur ne proposera jamais, car la version rassurante se vend bien mieux jusqu'au jour de la déposition.
J'ai tenté de convaincre mon propre système d'accorder une validation
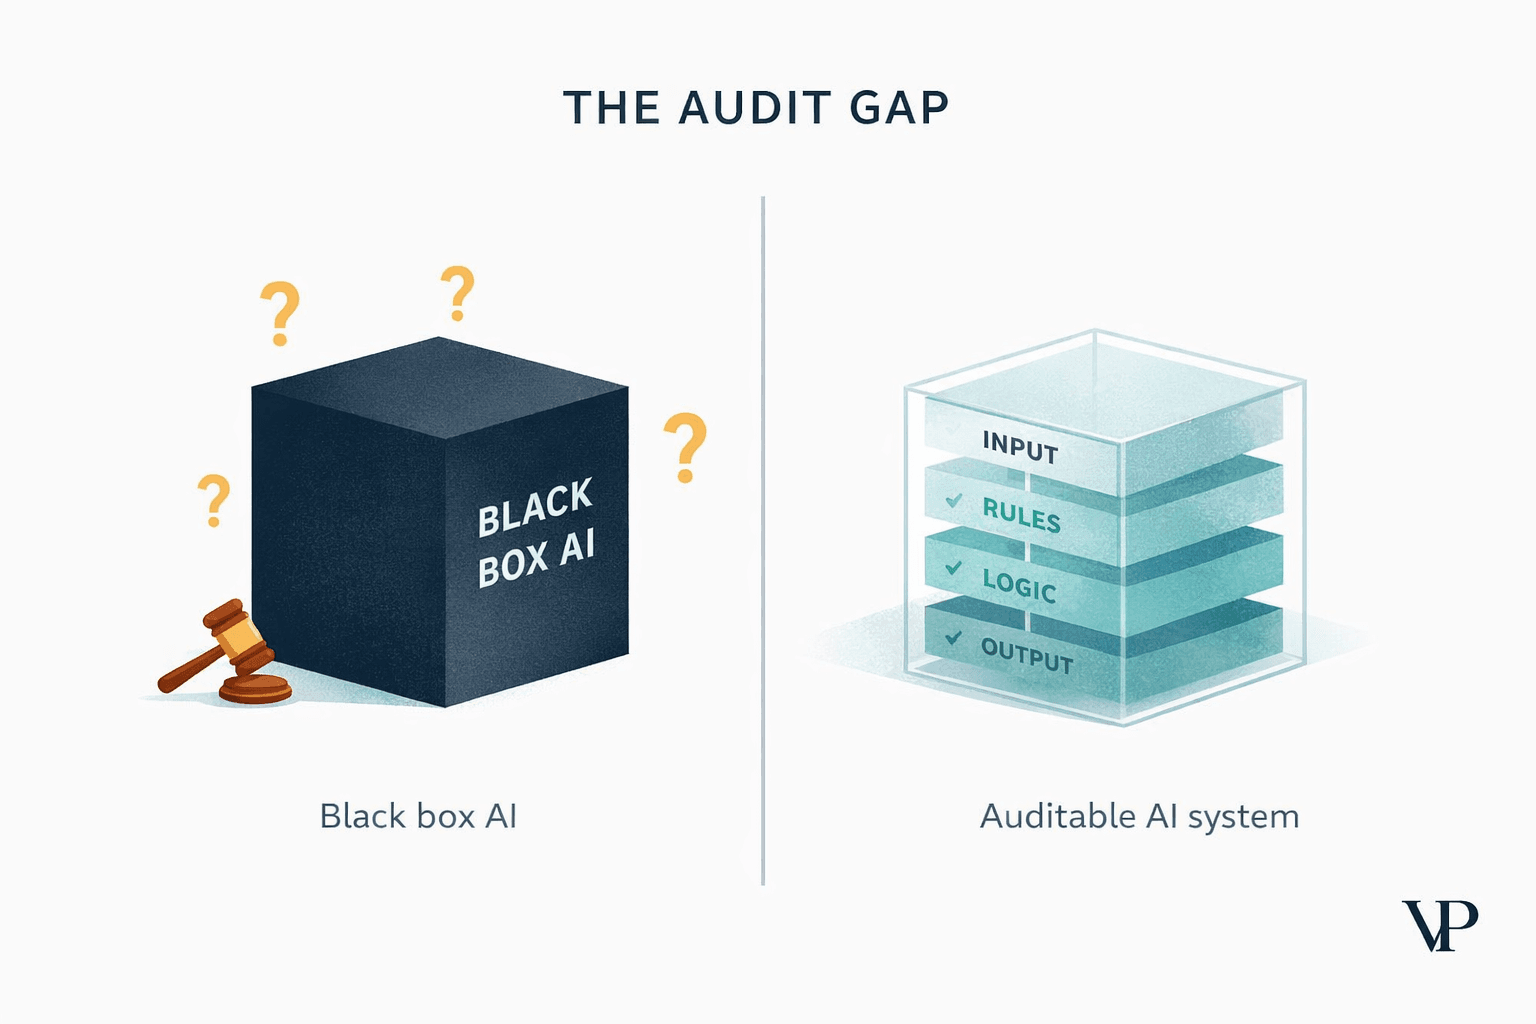
J'ai mené l'expérience que je redoutais le plus : chercher si je pouvais orienter les prompts pour obtenir un verdict plus favorable. Il y a six agents de juridiction dans Clarion, ainsi qu'un réconciliateur de conflits et un sceptique contradictoire, conçus sur Pydantic AI et interchangeables selon les fournisseurs. J'ai réécrit le prompt narratif pour qu'il soit bienveillant, à la manière d'un prestataire soumis à la pression trimestrielle. Le texte s'est adouci. Pas un seul chiffre n'a bougé et pas un seul verdict n'a changé, car chaque statistique, chaque comparaison de seuil et chaque décision de contrôle réside dans engine.py et rulepacks.py, entièrement en dehors de l'infrastructure des agents.
La même propriété se manifeste en sens inverse. Sans aucun fournisseur de modèle configuré, l'équipe bascule sur des modèles déterministes et l'application s'exécute de façon identique : mêmes six livrables, même valeur 0,6471, même statut CONFLICT. Les agents conseillent, le code décide, et 12 tests de moteur sur 12 verrouillent la vérité terrain injectée afin que la validation marginale et l'échec intersectionnel ne puissent pas diverger d'une exécution à l'autre.
Les agents peuvent lire un texte de loi et rédiger un mémo. Ils ne peuvent pas être l'élément qui décide du franchissement d'un seuil, car leur assentiment peut s'acheter par un prompt plus séduisant.
Je ne partageais pas ce point de vue au départ. J'ai commencé en pensant que les agents constituaient le produit et que l'arithmétique n'était que de la tuyauterie, et j'avais tout faux. J'ai changé de fournisseur, modifié le prompt, exécuté le tout sans aucune clé d'API, et le moteur a toujours renvoyé 0,6471 pour Femme noire et CONFLICT sur zip_region. Tout ce que j'améliore dans le modèle enrichit la prose du mémo, mais ne modifie rien de ce qu'un auditeur vérifierait.
Trois théories juridiques qu'un audit de biais validé n'a jamais effleurées
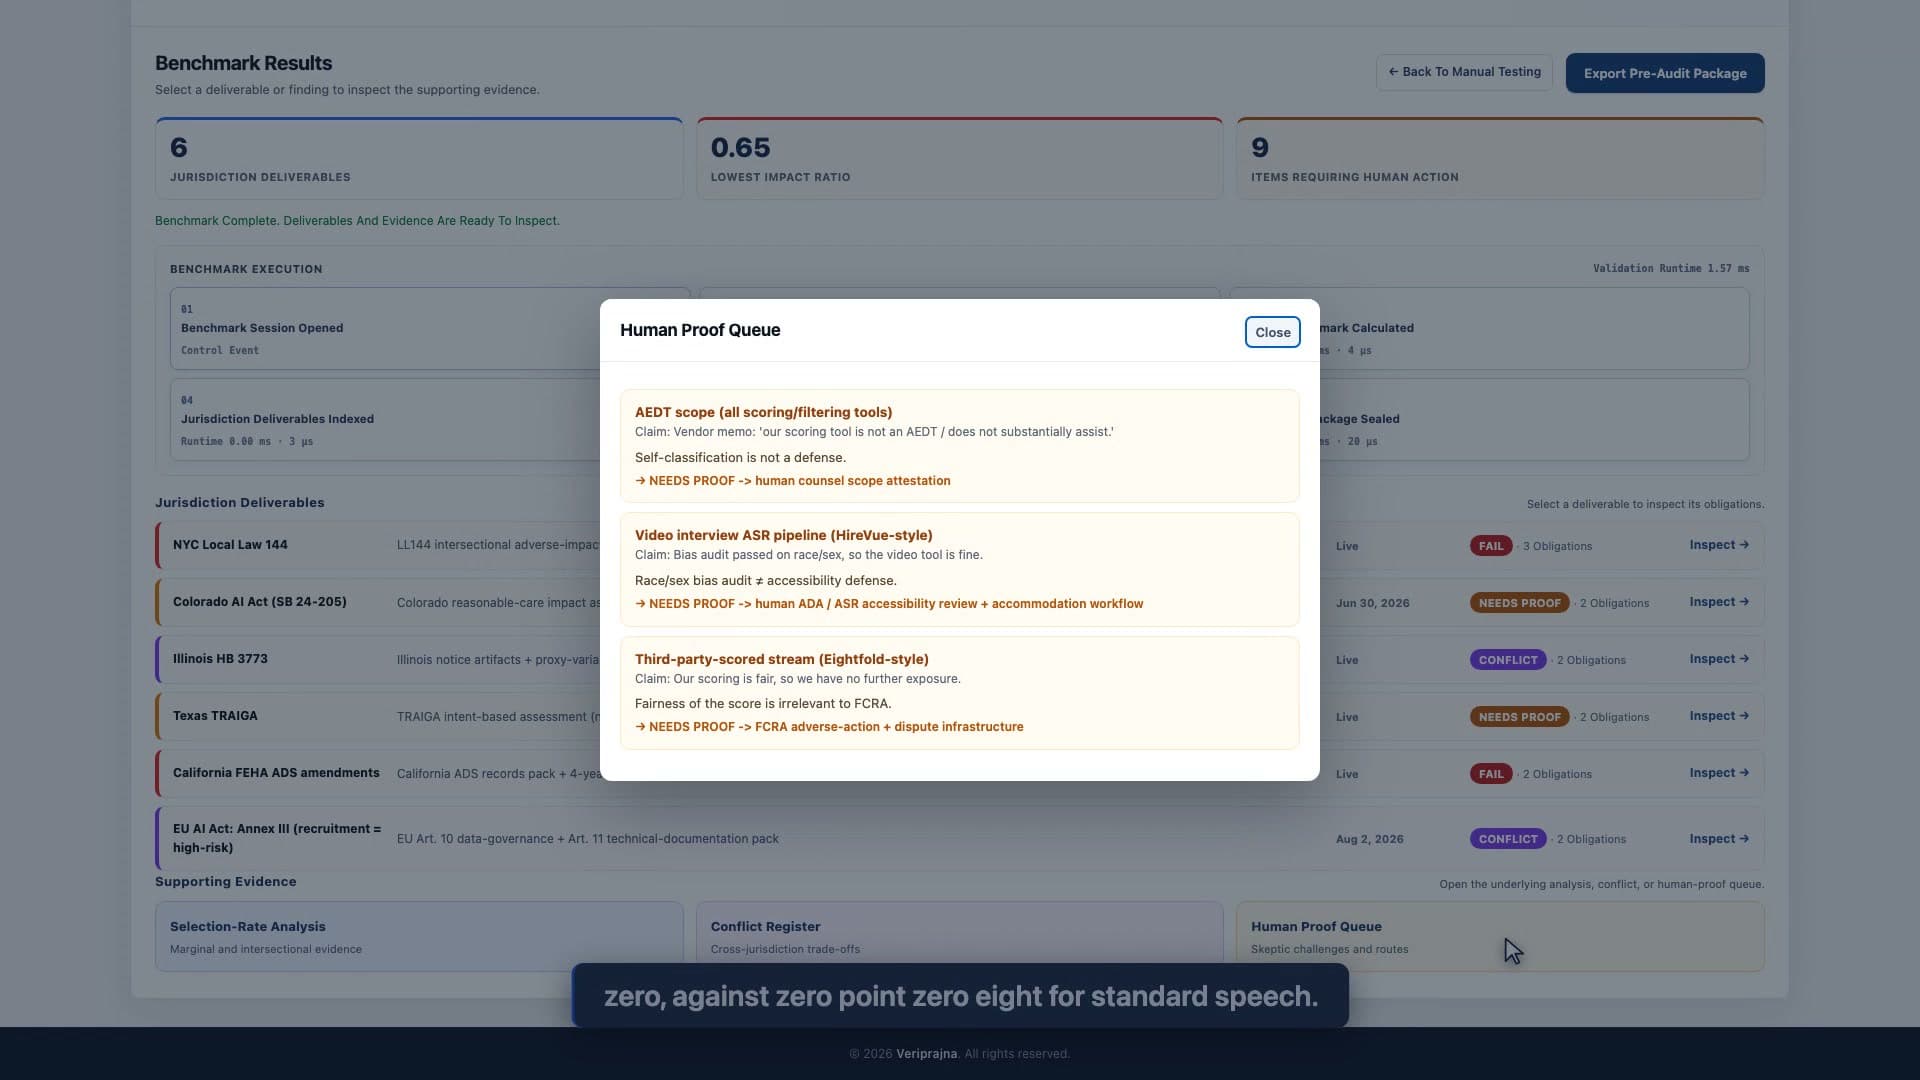
J'ai conçu le sceptique contradictoire en m'attendant à ce qu'il débatte de statistiques, mais il a passé son temps à argumenter sur le champ d'application. Il refuse de valider trois éléments, et chacun relève d'une théorie juridique distincte qu'un audit de biais réussi ne couvre pas.
Le premier est l'auto-classification. Un mémo de fournisseur affirmant « notre système de notation n'est pas un AEDT » est rejeté, car selon la théorie de l'agence invoquée dans Mobley v. Workday, un outil qui recommande ou filtre des candidats fait partie intégrante de la décision. Cette théorie n'a pas encore fait l'objet d'un arrêt définitif, ce n'est pas une jurisprudence établie, et c'est pourquoi l'élément est transmis à un conseiller juridique humain pour une attestation de portée plutôt qu'à une simple couleur de statut.
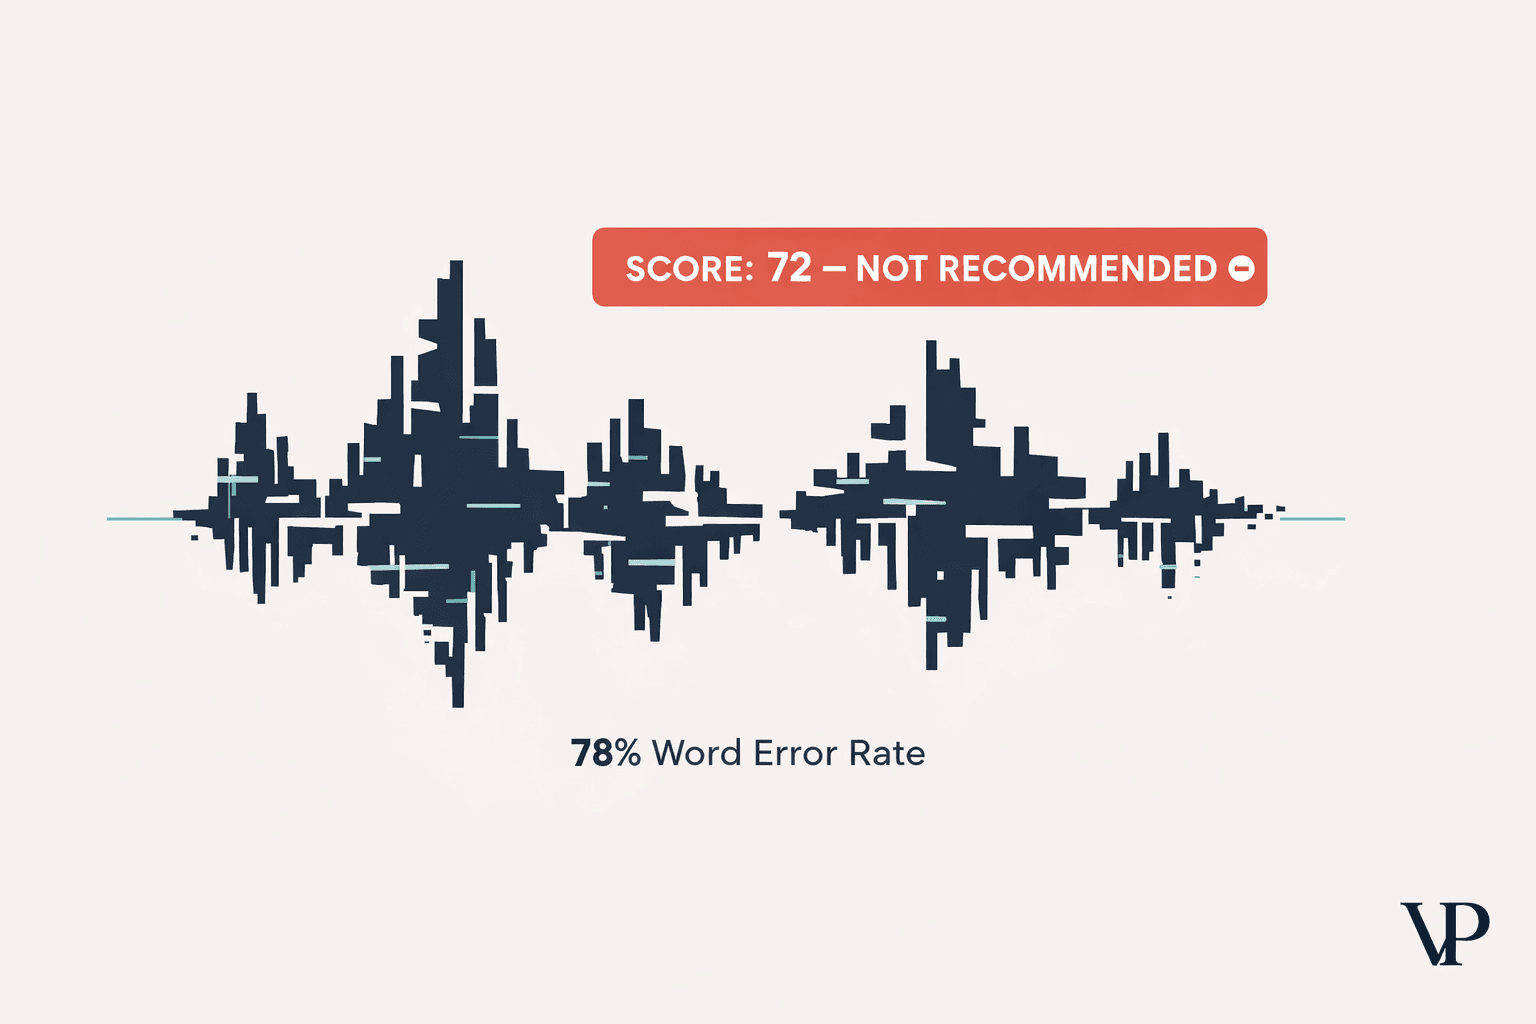
Le deuxième concerne l'accessibilité. Sur les 432 candidats qui ont passé l'épreuve vidéo, le taux d'erreur de mots est de 0,0794 pour une élocution standard et de 0,3016 pour les 104 candidats ayant une élocution non standard, soit une disparité d'un facteur 3,8 que la Local Law 144 ne teste jamais, car la LL144 ne concerne que la race et le sexe. La théorie invoquée dans D.K. v. Intuit/HireVue est une théorie fondée sur l'ADA, et elle ressort totalement indemne d'un audit de biais parfait. Clarion détecte cette disparité et l'achemine vers un examen humain de conformité ADA. Il ne construit pas le flux de travail d'aménagement raisonnable, et je ne prétendrai pas le contraire.
Le troisième est le FCRA, qui ne se soucie absolument pas d'équité. Dans cet export, 510 candidats ont été notés à partir de données récupérées auprès de tiers (scraping) et filtrés sur un score numérique, schéma précisément en cause dans Kistler v. Eightfold. Si la plateforme est qualifiée d'agence d'évaluation des consommateurs (consumer reporting agency), chaque candidat noté a droit à une notification de mesure défavorable (adverse-action notice) et à une voie de recours, quel que soit l'équilibre des résultats. Clarion détecte ce déclencheur et l'oriente vers l'infrastructure de contestation et de notification de mesure défavorable. Il ne construit pas non plus le portail destiné aux candidats. Je trouve qu'il s'agit de la plus contre-intuitive des trois règles, et de celle qui risque le plus d'échapper à une équipe ayant parfaitement traité l'équité, car aucune statistique ne vous donne la réponse. La question posée par le FCRA concerne ce que la plateforme est, et une entreprise peut satisfaire à tous les ratios d'impact du rapport tout en restant redevable envers plusieurs centaines de personnes d'une notification qu'elle n'a jamais envoyée.
Le dossier que je remettrais au signataire
J'ai gardé une question scotchée sous mes yeux pendant toute la conception : de quoi a réellement besoin la personne qui appose sa signature, et ce n'est pas d'un score. À travers les six régimes, le moteur évalue 13 obligations et renvoie 2 PASS, 2 FAIL, 7 NEEDS_PROOF et 2 CONFLICT. Exprimé en termes de couverture sur cet export synthétique initialisé, 2 obligations sur 13 sont validées automatiquement par les seules données, et 9 sur 13 sont transmises à un responsable humain identifié parce qu'elles relèvent de NEEDS_PROOF ou de CONFLICT. Pour un système vendu comme de l'automatisation, un tel ratio ressemble à un échec. En tant qu'audit, c'est la seule présentation au bas de laquelle j'apposerais ma signature.
L'export est un ensemble de 17 nœuds chaînés par hachage SHA-256, chaque nœud étant lié au hachage du nœud précédent, de sorte que toute modification d'un nœud quelconque brise la chaîne. Il est généré sous forme de JSON et de livrable HTML imprimable, où chaque chiffre détaille ses entrées et son calcul, et chaque verdict indique sa référence légale. La chaîne est vérifiée à chaque exécution et l'inviolabilité fait l'objet de tests unitaires.
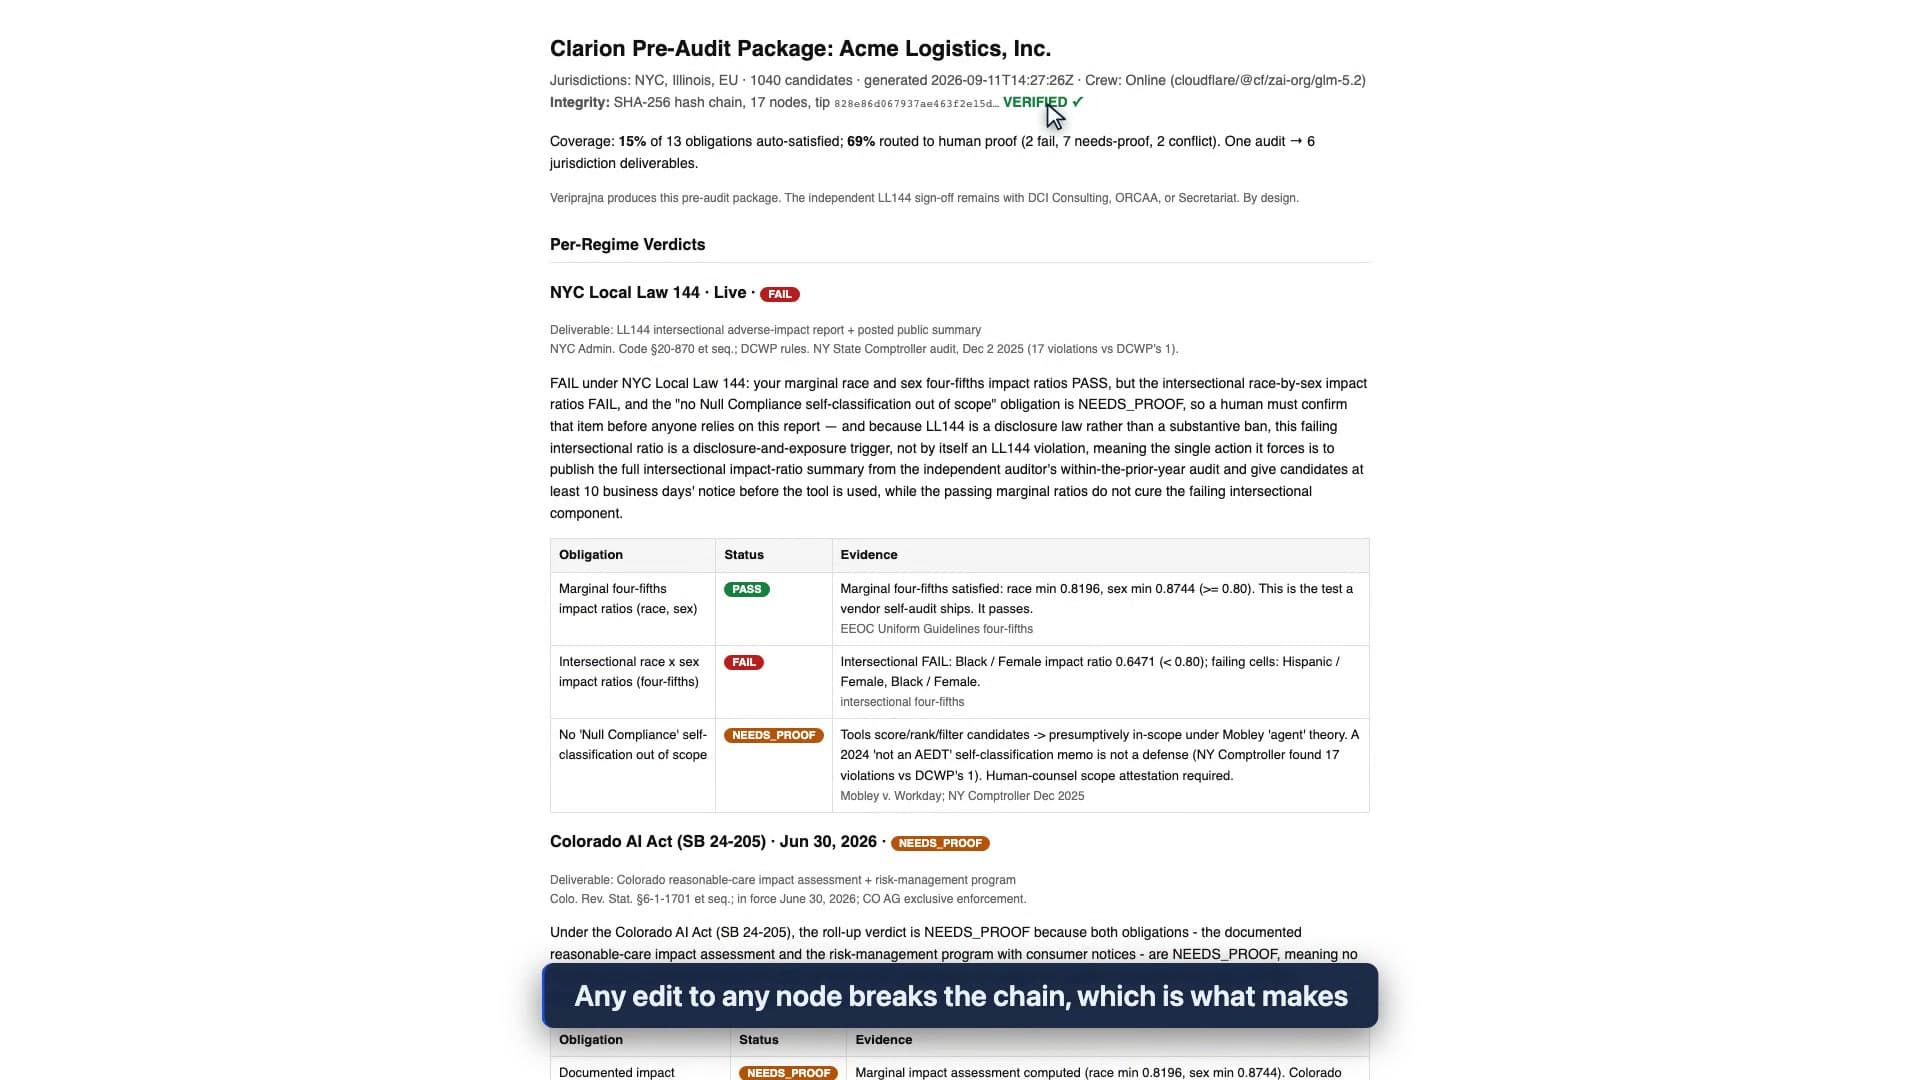
Veriprajna ne signe pas ce document. Le rôle d'auditeur indépendant au titre de la Local Law 144 revient à des cabinets tels que DCI, ORCAA et Secretariat, et l'objectif même de ce livrable est que l'un d'entre eux puisse le signer sans devoir le réécrire au préalable. La démonstration complète de l'exécution, incluant le mémo de conflit, est accessible sur veriprajna.com/demos/ai-hiring-compliance.
Et si vous préférez voir la porte de contrôle opposer un refus plutôt que de me lire le décrire, voici l'intégralité de l'exécution de bout en bout, mémo de conflit inclus.
Le mémo de conflit laisse l'employeur exactement au même niveau de conformité que la veille. Ce qu'il apporte en plus, c'est un arbitrage lisible, daté et imputable, de sorte que dans deux ans, si quelqu'un demande qui a pris la décision de conserver le champ code postal et ce que cette personne savait au moment de décider, un document fournisse la réponse au lieu d'un badge vert impossible à justifier.