6,400 萬人應徵一份工作。一組「123456」的密碼,就洩露了他們的秘密。

我當時正與一位潛在客戶通話——一家中型物流公司——這時 McHire 事件爆發了。我的共同創辦人在我說話說到一半時傳來一個連結。我瞥了一眼,讀完前兩行,便完全沉默了。客戶問我是否還在線上。
「抱歉,」我說。「我剛讀到麥當勞的 AI 招聘平台——那個篩選數百萬求職者的系統——竟然只用密碼『123456』來保護。而且有人剛剛就這樣走了進去。」
接著是一段長長的沉默。然後客戶說:「那基本上就是我們的設定。」
他半是在開玩笑。但也只是一半而已。
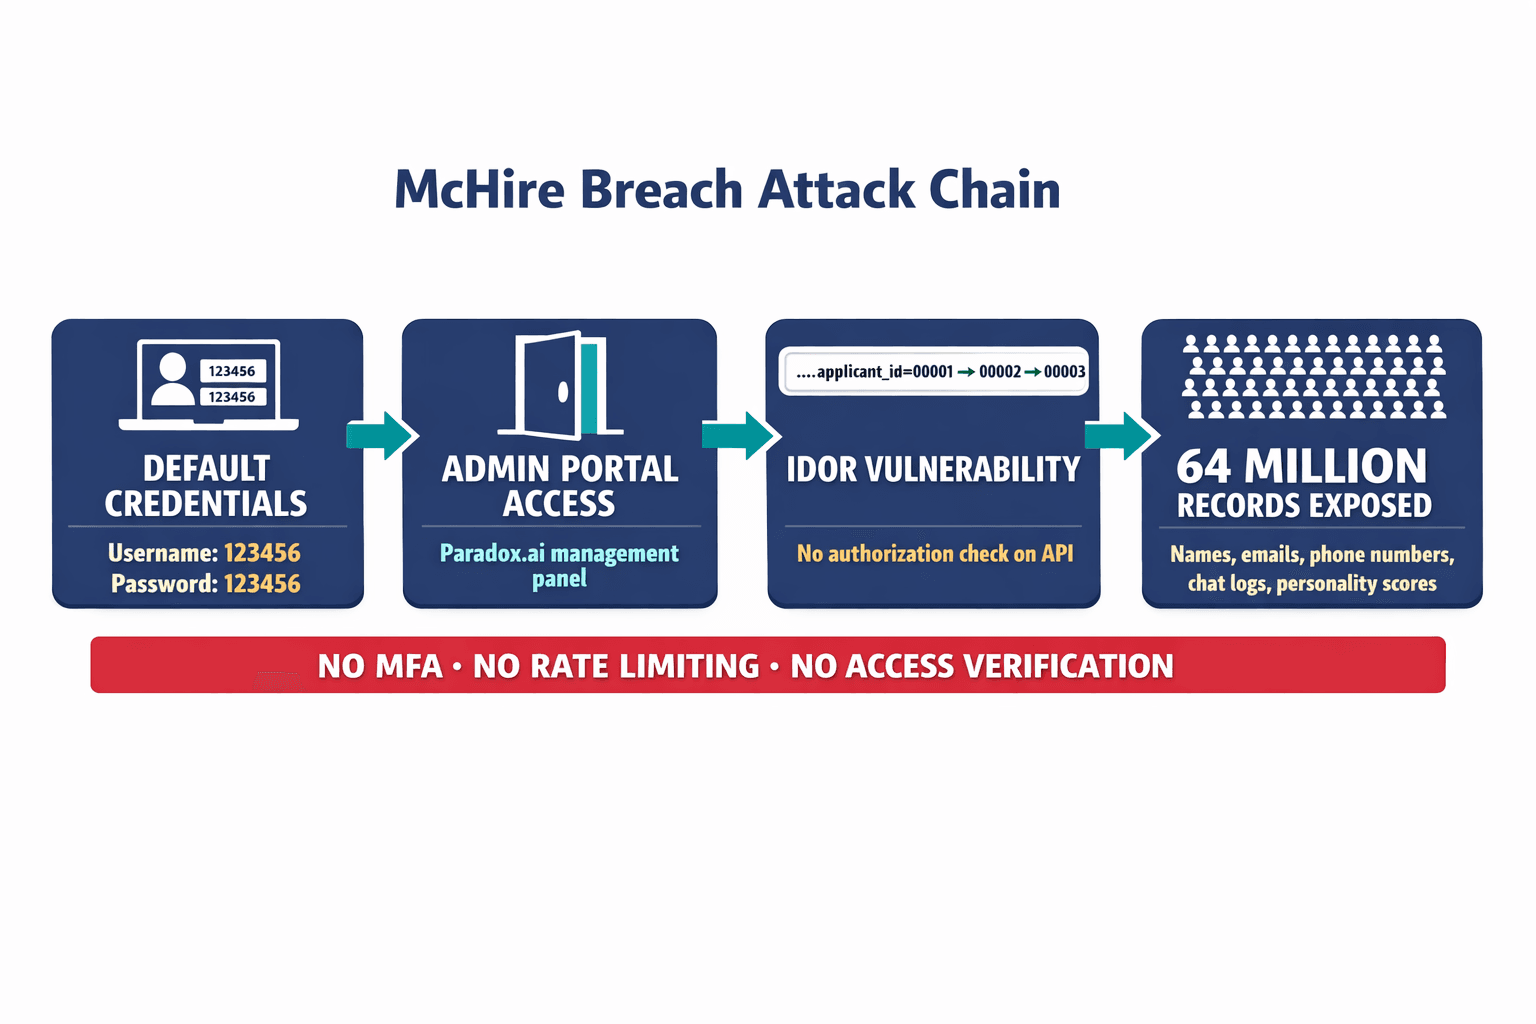
2025 年 6 月的 McHire 資料外洩事件,曝露了大約 6,400 萬名求職者的個人資料——姓名、電子郵件、電話號碼、IP 位址、與一位名叫「Olivia」的 AI 招聘機器人的聊天記錄,以及最令人不安的——他們的人格測驗結果。攻擊途徑並非某個精密的國家級攻擊。它不是需要一支精英駭客團隊才能施展的零時差漏洞。它只是一個自 2019 年以來從未更改過的預設管理員密碼,掛在一個沒有多重要素驗證的帳號上,守護著一個讓任何人都能在瀏覽器網址列裡逐一遍歷求職者 ID 的 API。
當我告訴人們我們在 Veriprajna 做什麼——打造將安全與治理內建於架構之中的 AI 系統時——我有時會得到那種禮貌性的點頭,那意思是「當然啦,但這不是太過頭了嗎?」McHire 外洩事件就是我的答案。這不是過頭。這是最低限度。而大多數公司連這一點都沒做到。
McHire 平台內部究竟發生了什麼?
這起外洩事件並非由威脅情報團隊或政府機構所發現。它始於兩位資安研究員——Ian Carroll 與 Sam Curry——他們注意到一件很平凡的事:使用者抱怨「Olivia」聊天機器人有問題。前端體驗既笨拙又不可靠。
這個細節很重要。根據我的經驗,一個壞掉的前端幾乎總是一個訊號。如果一家公司連使用者看得見的部分都沒有投入,想像一下他們看不見的部分正在發生什麼。
Carroll 與 Curry 開始四處探查,發現了一個原本供 Paradox.ai 員工使用的管理入口——Paradox.ai 就是那家代表麥當勞打造並營運 McHire 的供應商。他們試了一個測試帳號。使用者名稱?「123456。」密碼?「123456。」它成功登入了。
我記得讀到這段時,感受到一種特定的憤怒,任何曾經打造過正式生產系統的人都會認得這種感覺。那不是驚訝——而是明知這件事完全可以預防的那種怒火。這不是 Kubernetes 叢集中某個細微的配置錯誤。它相當於數位版的把金庫大門敞開著,還貼了一張便利貼寫著「鑰匙在踏墊底下」。
但密碼只是第一階段。一旦進入內部,研究員便發現了一個「不安全的直接物件參照」漏洞——資安術語稱為 IDOR。這意味著該 API 並不會驗證一個已登入的使用者是否真的獲得授權去查看某位特定求職者的資料。只要更改 URL 中的求職者 ID 編號——字面上就是把一個數字加一——他們就能調出系統中任何一位求職者的完整記錄。
六千四百萬位求職者。
為什麼人格測驗資料是最糟糕、最不該外洩的那種資料
這正是大多數關於此次外洩的報導出錯之處。頭條聚焦在密碼上——「123456」,哈哈,真蠢——然後就此打住。但真正的災難不在於憑證。而在於它背後的東西。
信用卡號碼可以取消。密碼可以更改。但人格評估結果呢?行為篩選分數呢?一段 AI 探測你的性情、你的情緒反應、你的衝突處理風格的對話記錄呢?
那些資料就是你。它不會過期。
當一份人格側寫外洩時,你無法像更換密碼那樣輪替它。你的心理計量指紋會永遠跟著你。
在那次外洩之後的某個深夜,我熬夜讀了關於資料曝露之心理衝擊的研究。這些數字令人震驚:將近70% 的外洩受害者回報自己出現持續性的無法信任他人。三分之二的人經歷深切的無助感。研究已將個人資料曝露與焦慮、憂鬱及創傷後壓力症候群連結起來。而嚴重程度會隨著資料的私密程度而升高——一個外洩的電子郵件位址讓人刺痛;而一份說你「情緒不穩定」或「盡責性偏低」的外洩人格評估,則可能感覺像是被公開解剖。
對求職者而言——他們許多人年紀輕輕,許多人是在應徵人生第一份速食連鎖店的工作——這尤其殘忍。他們接受人格測驗,只因為一個 AI 叫他們這麼做。他們沒有任何有意義的方式去理解哪些資料正被蒐集、如何被儲存,或誰能夠存取。而如今那些資料已在外流傳,可能永遠如此,在一個未來的雇主、保險公司或惡意份子都可能利用推論出的特質來對付他們的世界裡。
我的團隊為此爭論過。我們的一位工程師說:「聽著,資料是曝露了沒錯,但很可能並未真正被大規模外洩——研究員是負責任地通報的。」而就技術上而言,那是真的。Paradox 在收到通知後數小時內就修補了漏洞。但我強力反駁。重點不在於這一份特定的資料集是否最終出現在某個暗網論壇上。重點在於那套架構允許了它發生。這個系統的設計方式,使得一個預設密碼加上一個瀏覽器,就足以存取 6,400 萬人的心理計量側寫。那不是一次僥倖躲過。那是一次設計理念上的失敗。
越南的那位開發者,以及那把解開一切的密碼
這個故事有一條沒有得到足夠關注的支線。調查顯示,一位駐越南的 Paradox.ai 開發者遭到一種名為 Nexus Stealer 的惡意程式感染——這是一款在網路犯罪論壇上販售的憑證竊取工具。這次感染從該開發者的裝置中竊走了數百組密碼。其中許多都很脆弱且重複使用,在多項服務中都採用同一組七位數的基礎密碼。
那單一一位被入侵的開發者,曝露了與 Paradox.ai 帳號相關聯的憑證,這些客戶包括百事、洛克希德馬丁、Lowe's,以及 Aramark。
我希望你花一點時間好好想想這件事。一個人。一台被感染的筆電。一組重複使用的密碼。然後,美國一些最大型雇主的招聘資料,突然就陷入了風險之中。
這就是我所稱的「人類節點」問題,而這件事讓我夜不能寐的程度,遠遠超過任何奇特的 AI 攻擊途徑。你可以打造世界上最精密的模型,用潔淨無瑕的資料進行微調,再用護欄層層包覆——然後,單單一位開發者的密碼衛生習慣崩壞,整座紙牌屋便隨之倒塌。2025 年一次資料外洩的平均成本達到了444 萬美元。但各組織仍持續把身分管理當作事後才想到的東西,當作 IT 團隊靠一支沒人看的年度訓練影片就能處理的事。
你的 AI 系統的安全性,永遠不會比這條鏈中最脆弱的那個人類憑證更堅固。
在 Veriprajna,我們打造架構時所依據的假設是:人類存取是一個需要持續驗證的高風險途徑——也就是業界所稱的零信任(Zero Trust)。並不是因為我們不信任自己的團隊,而是因為我曾親眼見過,當你信任任何單一的驗證點來守住防線時,會發生什麼事。
「深度 AI」究竟是什麼意思——以及你為什麼該在意?
我必須引入一個區別,我認為這是當前企業 AI 中最重要的觀念,也是 McHire 外洩事件完美詮釋的一點:AI 外殼(AI Wrapper)與我們所稱的深度 AI(Deep AI)之間的差異。
AI 外殼,是大多數公司在聲稱自己「正在做 AI」時實際上所打造的東西。它是一個薄薄的應用層——通常是一個聊天機器人或一張表單——把使用者的輸入透過 API 送往像 GPT-4 或 Claude 這樣的基礎模型,取得回應,再顯示出來。這個 AI 是你租來的一項服務。你的應用程式則是店面。安全性、資料管理、治理——那些全都是事後才拴上去的,用的是你為任何一個 CRUD 應用程式所會採用的同一套網頁開發實務。
Paradox.ai 的「Olivia」,就架構而言,就是一個外殼。當然,是個精密的外殼。但其安全態勢是繫在傳統的網頁基礎設施上——而那套基礎設施在可想像的最基本層級上失守了。
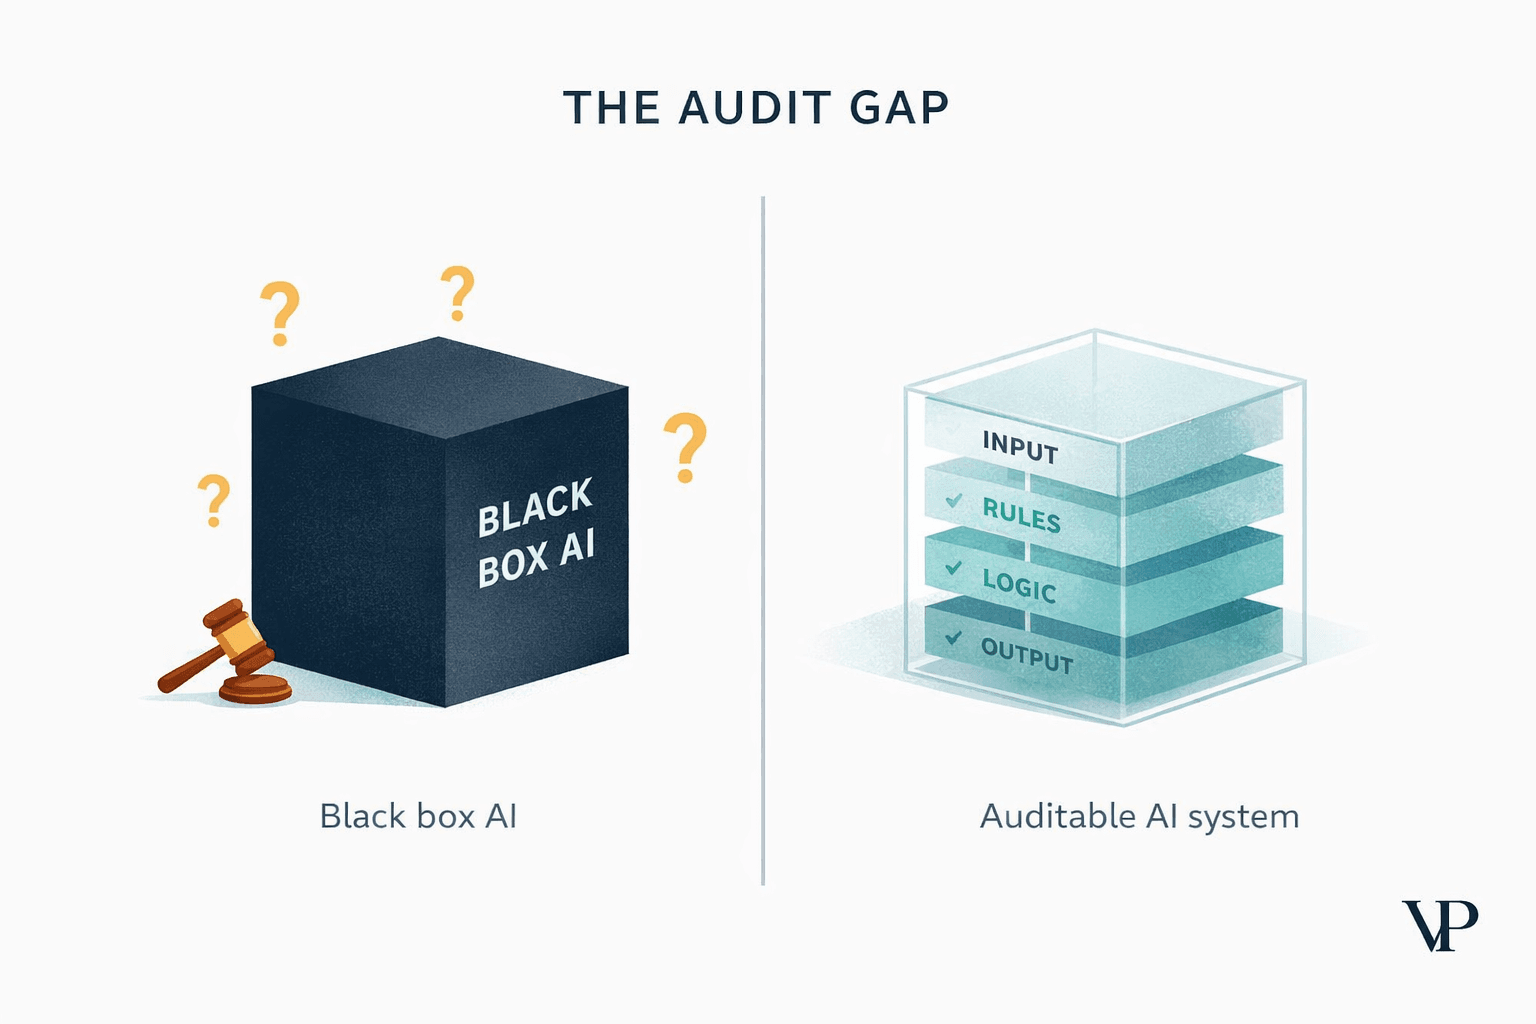
深度 AI 則截然不同。它將 AI 模型視為一個架構上的基本元件——就像資料庫或訊息佇列一樣——擁有它自己的安全邊界、自己的存取控制、自己的稽核軌跡。這個模型不是你去呼叫的一個黑盒子;它是一個你去治理的元件。你會建立提示路由器、記憶層、回饋評估器。你會實作分層防禦,假設每一個輸入都懷有敵意,每一個輸出都不可信任。
我曾在我們研究的互動版本中深入探討過這套架構理念,但其核心洞見很簡單:如果你的 AI 安全策略是「我們會加上驗證機制和一道 WAF」,那你打造的就是一個外殼,而你距離一場災難,只差一個預設密碼。
沒人想打造的五層防禦
在 McHire 的消息傳出後,我把工程團隊拉進一個房間,說:「一步一步帶我看,我們的技術堆疊究竟會如何防止這件事發生。」不是因為我懷疑他們——而是因為我想對每一個假設進行壓力測試。
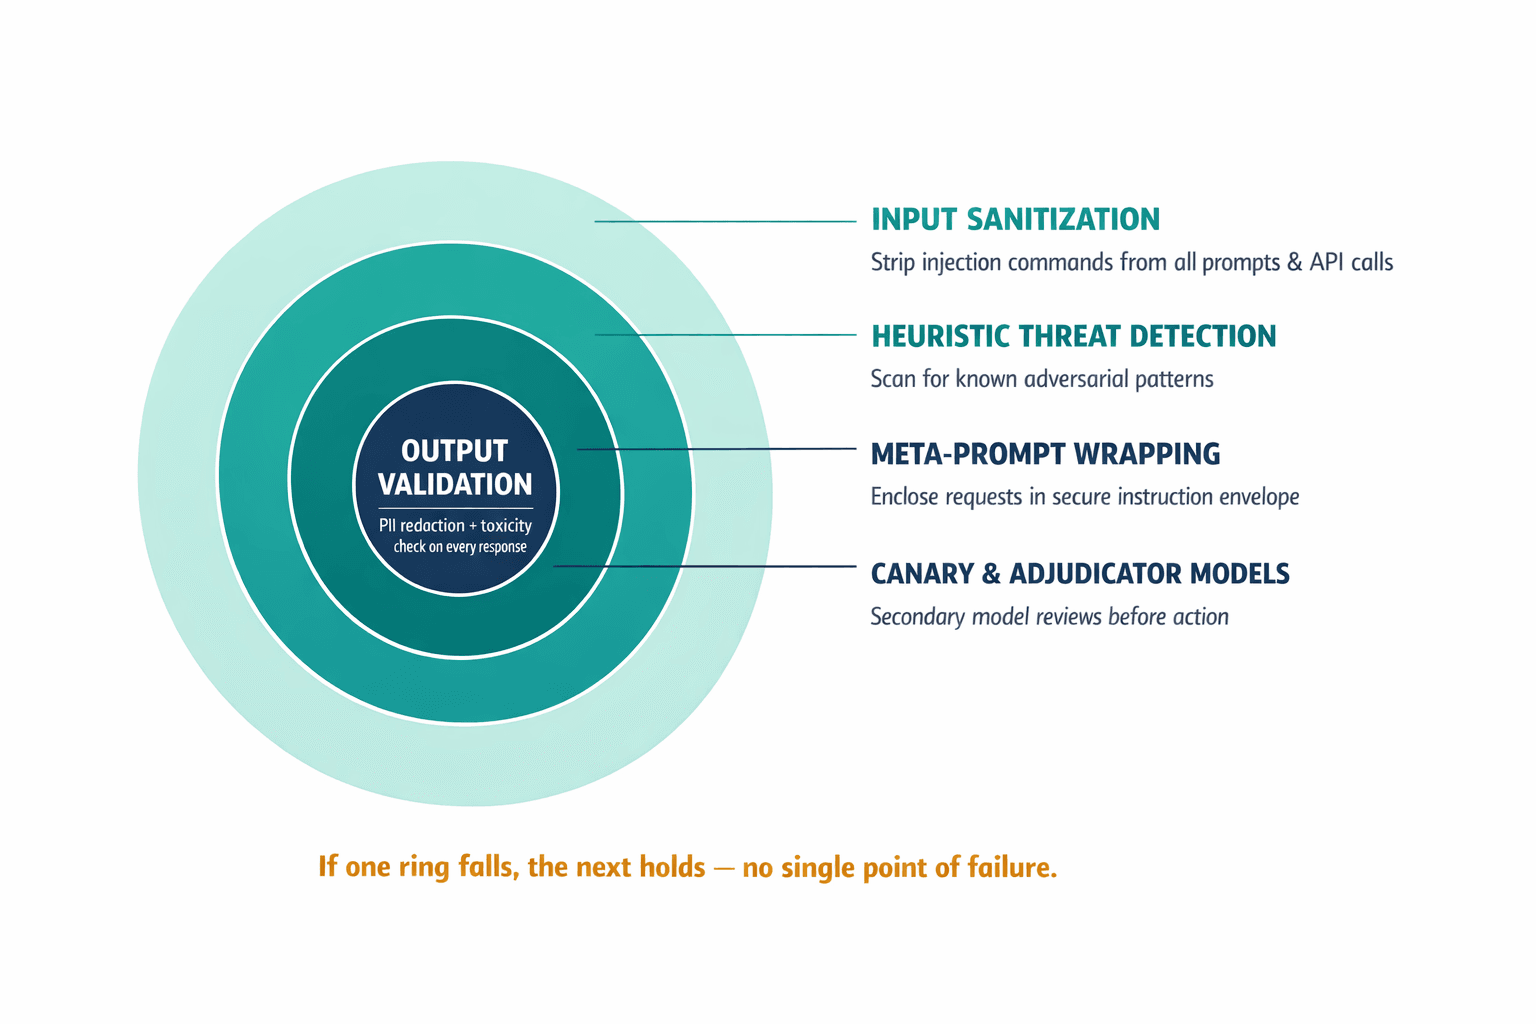
我們為此花了三個小時。在某個時刻,我們的資安工程主管在白板上畫了一張圖,看起來像中世紀城堡的橫剖面——一圈圈同心的防禦環,每一圈都獨立運作。若一圈失守,下一圈就頂上。以下是這在實務上的樣貌:
最外層的環是輸入淨化——每一個提示、每一次 API 呼叫,都會被剝除任何可能被誤讀為注入指令的東西。第二圈是啟發式威脅偵測,主動掃描已知的對抗性模式。第三圈是元提示包覆,在這裡,使用者的請求會被封裝進一個模型無法凌駕的安全指令封套之中。
第四圈開始變得有趣了:金絲雀與裁決模型。一個較小的模型會先分析請求。若它標記出某個可疑之處,便由第二個模型做出最終定奪。這是 AI 版的夥伴制度——沒有任何單一模型能夠獨斷專行。
第五、也是最內層的環是輸出驗證。AI 生成的每一個回應,在被證明無虞之前,都被視為不可信任。個人識別資訊(PII)遮蔽層會掃描敏感資料。毒性分類器會檢查有害內容。沒有東西能未經檢視就通過。
在那場白板會議中讓我感到挫折的,是這件事:這一切沒有一樣是奇特的。沒有一樣需要研究上的突破。這只是把工程紀律套用到一個新領域上而已。大多數公司之所以不這麼做,是因為它昂貴、緩慢,而且展示效果不好。一個外殼聊天機器人可以在一個週末內打造完成,並在星期一展示給董事會看。而一套經過妥善治理的 AI 系統則要花上好幾個月。猜猜哪一個會拿到資金。
AI 產業有一個「展示」上的問題:那個在簡報中打動投資人的東西,在架構上,恰恰與那個在正式生產環境中保護使用者的東西背道而馳。
為什麼法律看待人格資料的態度,就好像它具有放射性一樣?
每一位與我談話的技術長都會問我一個問題:「這裡的法律風險,說真的,到底有多嚴重?」
答案是:可能攸關存亡。
根據 CCPA,若未加密的個人資訊因未能維持「合理的安全程序」而遭竊,企業可能被提告。法定損害賠償為每位消費者每起事件 750 美元。將這個數字乘上 6,400 萬筆記錄,你所面對的理論責任高達 480 億美元。沒有任何法院會判決那全額,但即便只是其中一小部分,也足以讓公司倒閉。
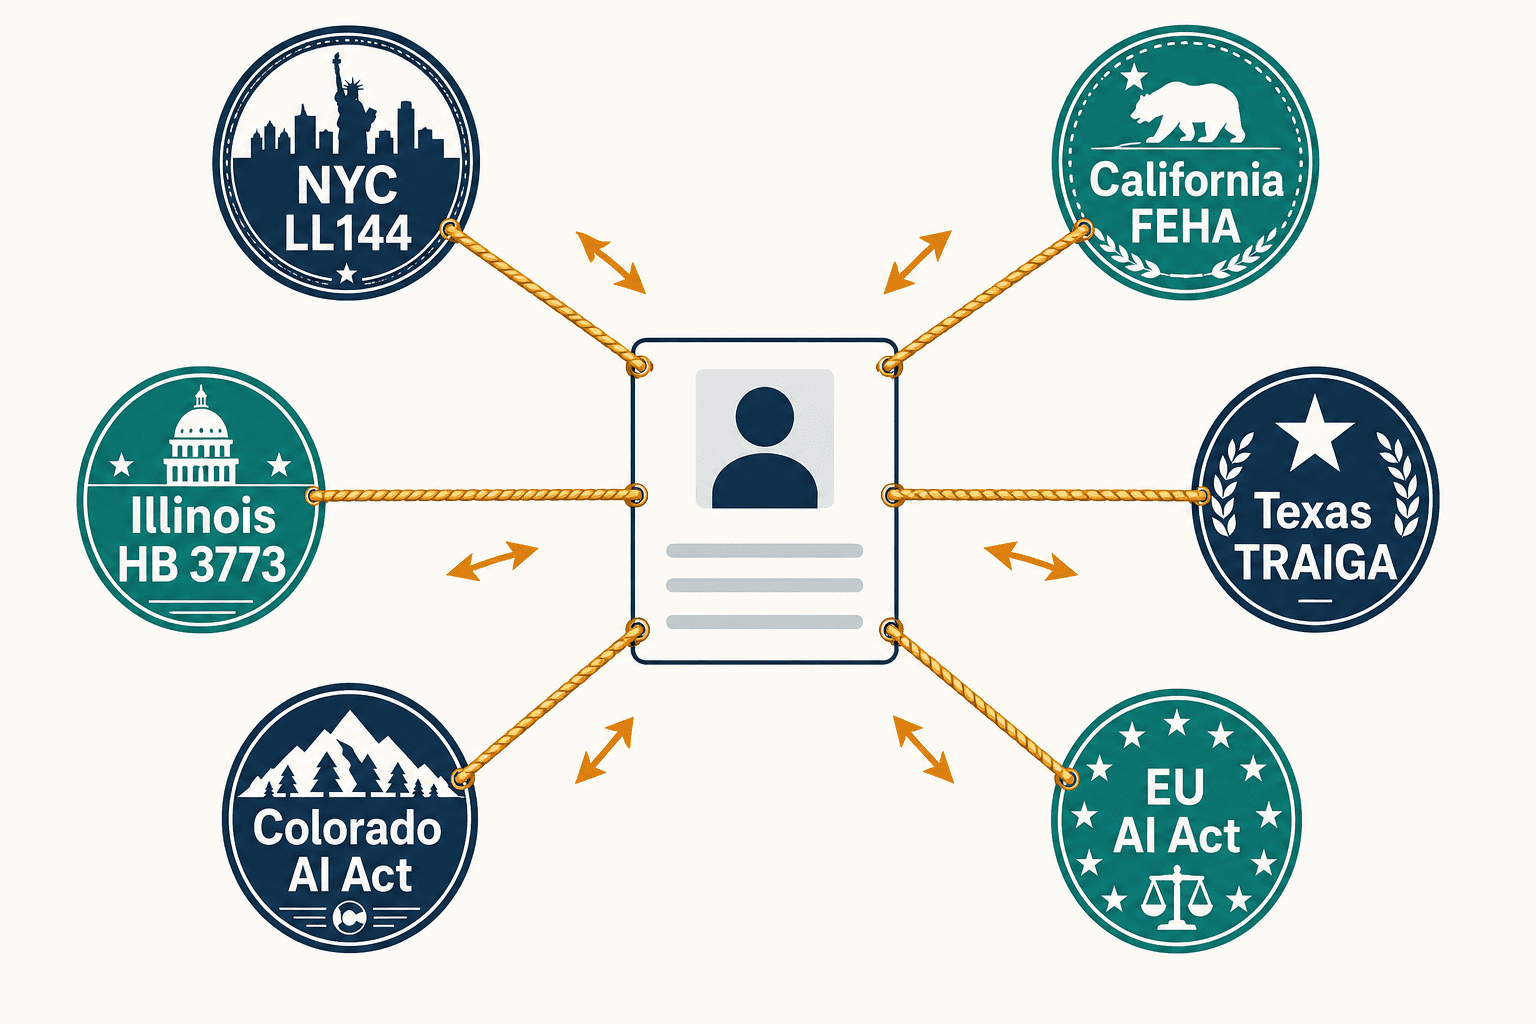
根據 GDPR,罰則的上限是 2,000 萬歐元或全球年營業額的 4%——以較高者為準。而將招聘 AI 歸類為「高風險」的《歐盟 AI 法案》,則對未遵守強制性風險評估與人為監督要求者,引入了最高3,500 萬歐元或全球營業額 7%的罰款。
但這是大多數法律分析所忽略的:聲譽損害比罰款更嚴重。外洩事件發生幾週後,我和一家《財星》500 大公司的人資長談過。她告訴我,她的團隊一直在評估 AI 招聘工具,並已篩選出三家供應商入圍。McHire 事件之後,執行長把整個計畫喊停了。「我們就再用人工做一年吧,」他說。「我才不要當下一個上頭條的人。」
那才是真正的代價。不只是對 Paradox.ai,更是對每一家試圖與企業買家建立信任的正當 AI 公司。一次災難性的外洩,便毒害了每一個人的水源。
你究竟該如何治理一個替人做決定的 AI?
在這裡,我必須誠實面對一件令人不太舒服的事:治理框架聽起來很無聊。ISO 42001、NIST AI RMF、給大型語言模型用的 OWASP 十大——這些都不是那種能讓創辦人在晚宴上興奮起來的東西。但它們正是那些將能撐過監管審查的公司,與撐不過的公司區分開來的東西。
ISO 42001 是全球第一個針對 AI 管理系統的國際標準。它要求組織辨識 AI 特有的風險、為透明度與安全性建立明確的目標、為每一套 AI 系統進行影響評估,並透過內部稽核維持持續性的監控。它不是一個打勾了事的形式——它是一套管理系統,逼你以看待財務控制的方式去思考 AI 治理。
NIST AI 風險管理框架提供了政策上的錨點,圍繞四項功能組織起來:治理(GOVERN)、對映(MAP)、量測(MEASURE)、管理(MANAGE)。在 Paradox 這起外洩事件中,治理這項功能失守得最為明顯——對於除役那個自 2019 年以來便一直閒置在那裡的過時管理員帳號,根本沒有任何組織層級的當責機制。
而 OWASP 框架——尤其是它針對代理型 AI 的 2025 年更新版——為開發者提供了一份依嚴重性排序的最關鍵漏洞分類表。代理目標劫持,即惡意內容改變了一個代理的核心行為。工具濫用,即一個代理被誘騙將某項正當的功能用於有害的目的。記憶投毒,即不良資料被注入到一個持久性代理的長期記憶之中。
若想了解這些框架如何交會的完整技術剖析,包括實作細節與一份 90 天的 CXO 路線圖,我已發表了一篇詳盡的搭配論文。但其執行摘要是這樣的:到了 2026 年,AI 治理將不再是選項。它將成為與任何擁有法務團隊的企業做生意的先決條件。
「我們不能之後再加上安全性嗎?」
人們不斷這樣問我。答案總是相同的,而且總是令人不太舒服:不行。你不能。
事後才拴上去的安全性,是安全的表演。那是一把裝在一扇早已被卸離其鉸鏈的門上的鎖。McHire 外洩事件證明了這一點——Paradox.ai 有驗證機制。他們有一個管理入口。他們想必也有某種安全審查流程。但因為安全性從第一天起就沒有被嵌入架構之中,整個系統的堅固程度,便只等同於一個連幼童都能猜到的密碼。
我聽到的另一個反對意見是:「但我們用的是一家大型雲端供應商。難道他們的安全性還不夠好嗎?」那位在越南的 Paradox 開發者是被商品化的惡意程式所入侵——並非某個雲端基礎設施的漏洞。你的雲端供應商可以擁有完美的安全性,但你的系統依然可能因為一位開發者在多項服務間重複使用了一組密碼而遭到入侵。防線並不在你以為的那個地方。
然後還有一個,那個真正讓我火大的:「安全性由我們的 AI 供應商負責。」這正是麥當勞當初的想法。他們把 AI 招聘外包給 Paradox.ai,而在這麼做的同時,也把自己的安全態勢外包給了一家管理入口只用「123456」來保護的供應商。如今,供應鏈就是那道安全防線。若你不以你套用在自己身上的同等嚴謹,去治理你的供應商的 AI 基礎設施,那你就不是在委派風險——而是在無視它。
那個我甩不掉的念頭
在 McHire 的故事最初爆發的數週之後,以下是我一再回想的事。
6,400 萬人——他們許多是青少年,許多正在應徵人生第一份工作——坐在一塊螢幕前,回答著一個 AI 聊天機器人所提出的問題。他們分享了關於自己的資訊,只因為系統叫他們這麼做。他們沒有任何籌碼、沒有任何談判的力量、沒有任何說出「其實,我寧可不要為了翻漢堡肉而去做一份人格測驗」的能力。這種權力上的不對稱是全面性的。
而那個保管著他們資料的系統——他們的姓名、他們的行為側寫、AI 對他們人格的評估——所受到的保護,竟是用我女兒拿來登入她 Roblox 帳號的同一組密碼。
我們打造了能夠大規模評估人類人格的 AI 系統。我們只是忘了保護那些人類。
這不是一個技術問題。這是一個價值觀問題。這是當一個產業把 AI 當作一件要出貨的產品、而非一套要治理的系統時,所會發生的事。這是當「快速行動、打破常規」撞上「我們正在對人們的生計做出自動化的決定」時,所會發生的事。
外殼的時代已經結束了。那些能夠撐過下一波監管、下一次外洩、下一場公眾清算的公司——將會是那些把安全性建進地基裡的公司,而不是那些在頭條爆出之後才把它拴上去的公司。在 Veriprajna,那是我們唯一願意打造的那種 AI。不是因為它比較容易。而是因為另一種選擇,根本無法自圓其說。
密碼「123456」本該是一件遺物。那套讓它得以舉足輕重的架構,本該早已絕跡。而那 6,400 萬名資料遭曝露的人們,值得比業界目前對「夠好了」的定義更好的對待。