בינה מלאכותית אמרה לאישה חירשת "לתרגל הקשבה פעילה". זה הרגע שבו הבנתי שהתעשייה הזאת שבורה.

ישבתי במשרד הביתי שלי, בשעת לילה מאוחרת ביום שלישי, וגללתי בכתב התלונה שהגיש ה-ACLU נגד Intuit ו-HireVue, כשנתקלתי בשורה שגרמה לי להניח את המחשב הנייד ופשוט לבהות בקיר.
אישה חירשת בת קבוצה ילידית — המזוהה בכתבי בית הדין כ-D.K. — נדרשה להשלים ריאיון וידאו אוטומטי לצורך קידום. היא כבר זכתה בהערכות חיוביות, בבונוסים שנתיים, ובניסיון מוכח שהיה צריך להפוך את הקידום למובן מאליו. אך מערכת ה-AI שעיבדה את הריאיון שלה הפיקה משוב שירדוף את התעשייה הזאת במשך שנים: היא אמרה לה "לתרגל הקשבה פעילה."
היא חירשת.
המערכת לא ידעה. למערכת לא היה אכפת. המערכת עשתה את מה שכל מודל שפה גדול עושה — היא התאימה תבניות מול מערך אימון שנבנה ברובו המכריע מבני אדם שומעים, נוירוטיפוסיים, דוברי אנגלית אמריקאית תקנית, והחליטה שכל מי שלא נשמע כמו מערך הנתונים הזה הוא לקוי. לא שונה. לקוי.
ביליתי שנים בבניית מערכות AI ב-Veriprajna שמתוכננות לקבל החלטות בעלות סיכון גבוה לגבי בני אדם. ואני יכול לומר לכם בוודאות מוחלטת: זה לא היה באג. זו הייתה הארכיטקטורה שעובדת בדיוק כפי שתוכננה. זו הבעיה.
מה בעצם קרה ל-D.K.?
כדאי לשבת עם העובדות, כי הן חושפות משהו עמוק יותר מכשל תוכנה בודד.
D.K. ביקשה התאמה סבירה — ובאופן ספציפי, כתבנית אנושית לתמלול תרגום בזמן אמת לגישה לתקשורת (CART) שתסייע לה לנווט בריאיון הווידאו. במקום זאת, ניתנו לה כתוביות אוטומטיות. אם צפיתם אי-פעם בכתוביות אוטומטיות שמשחיתות דובר בעל מבטא אזורי קל, דמיינו מה קורה כשלדובר יש מה שבלשנים מכנים "מבטא חירשים" — דפוסי דיבור שעוצבו לאורך חיים שלמים של תקשורת ללא היזון שמיעתי.
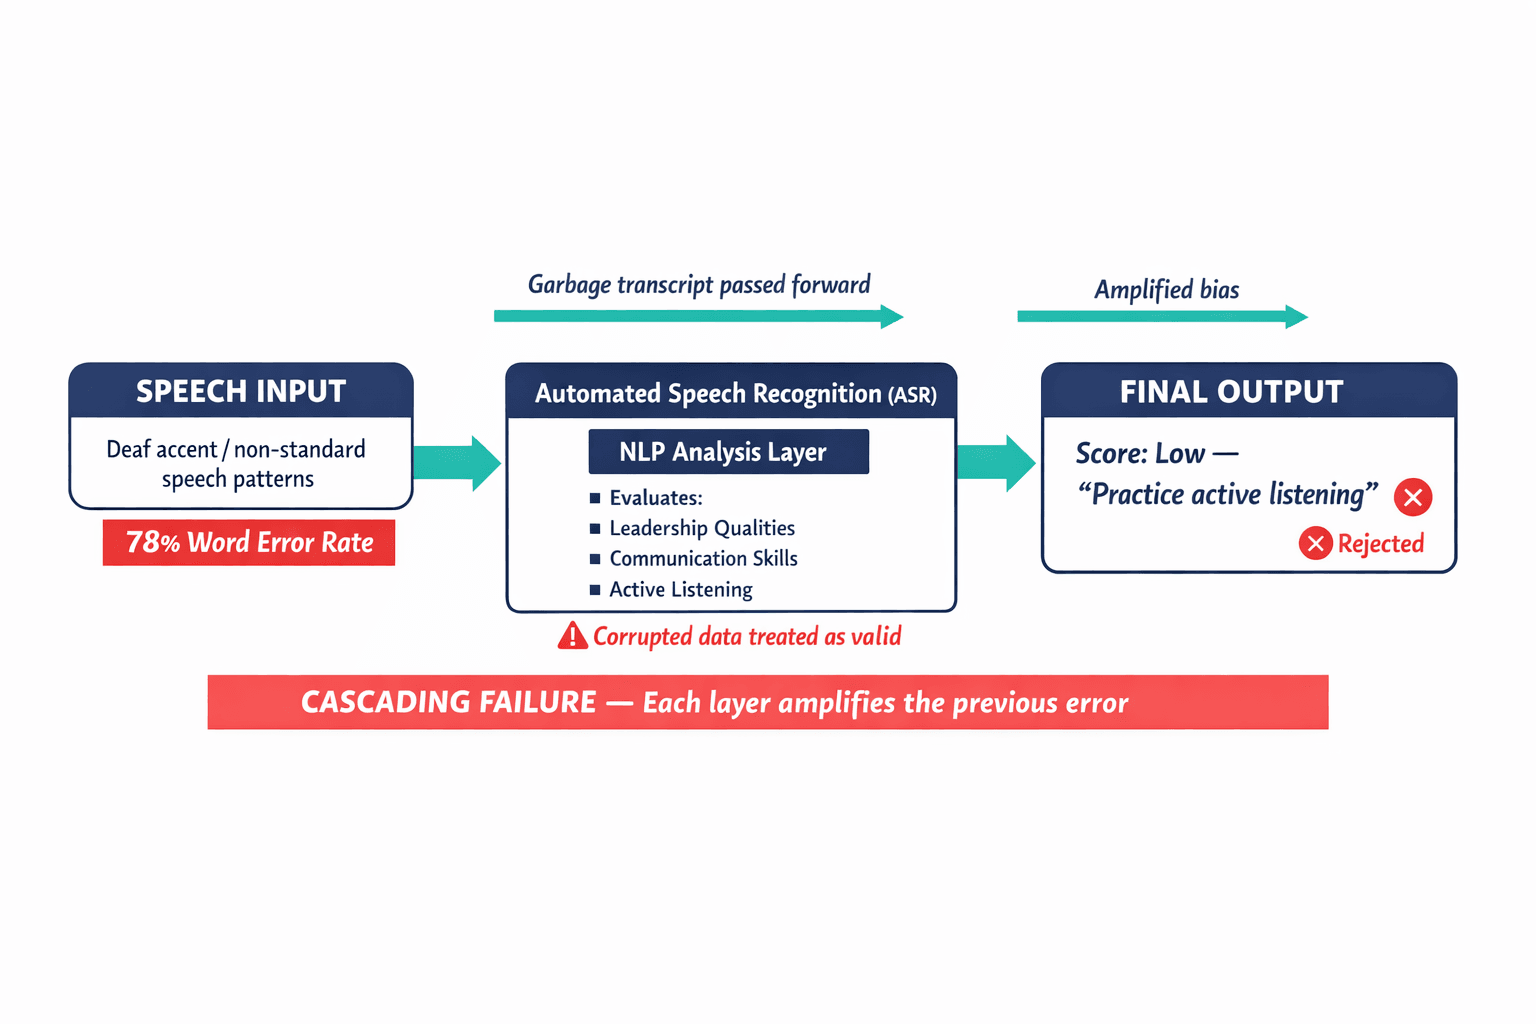
מערכת זיהוי הדיבור האוטומטי לא הצליחה לנתח את הדיבור שלה. התמליל שהיא הפיקה היה, מבחינה תפקודית, זבל. ואז שכבת AI שנייה ניתחה את התמליל הזבל הזה בחיפוש "תכונות מנהיגות" ו"כישורי תקשורת" והסיקה שהיא אינה מוכנה לניהול.
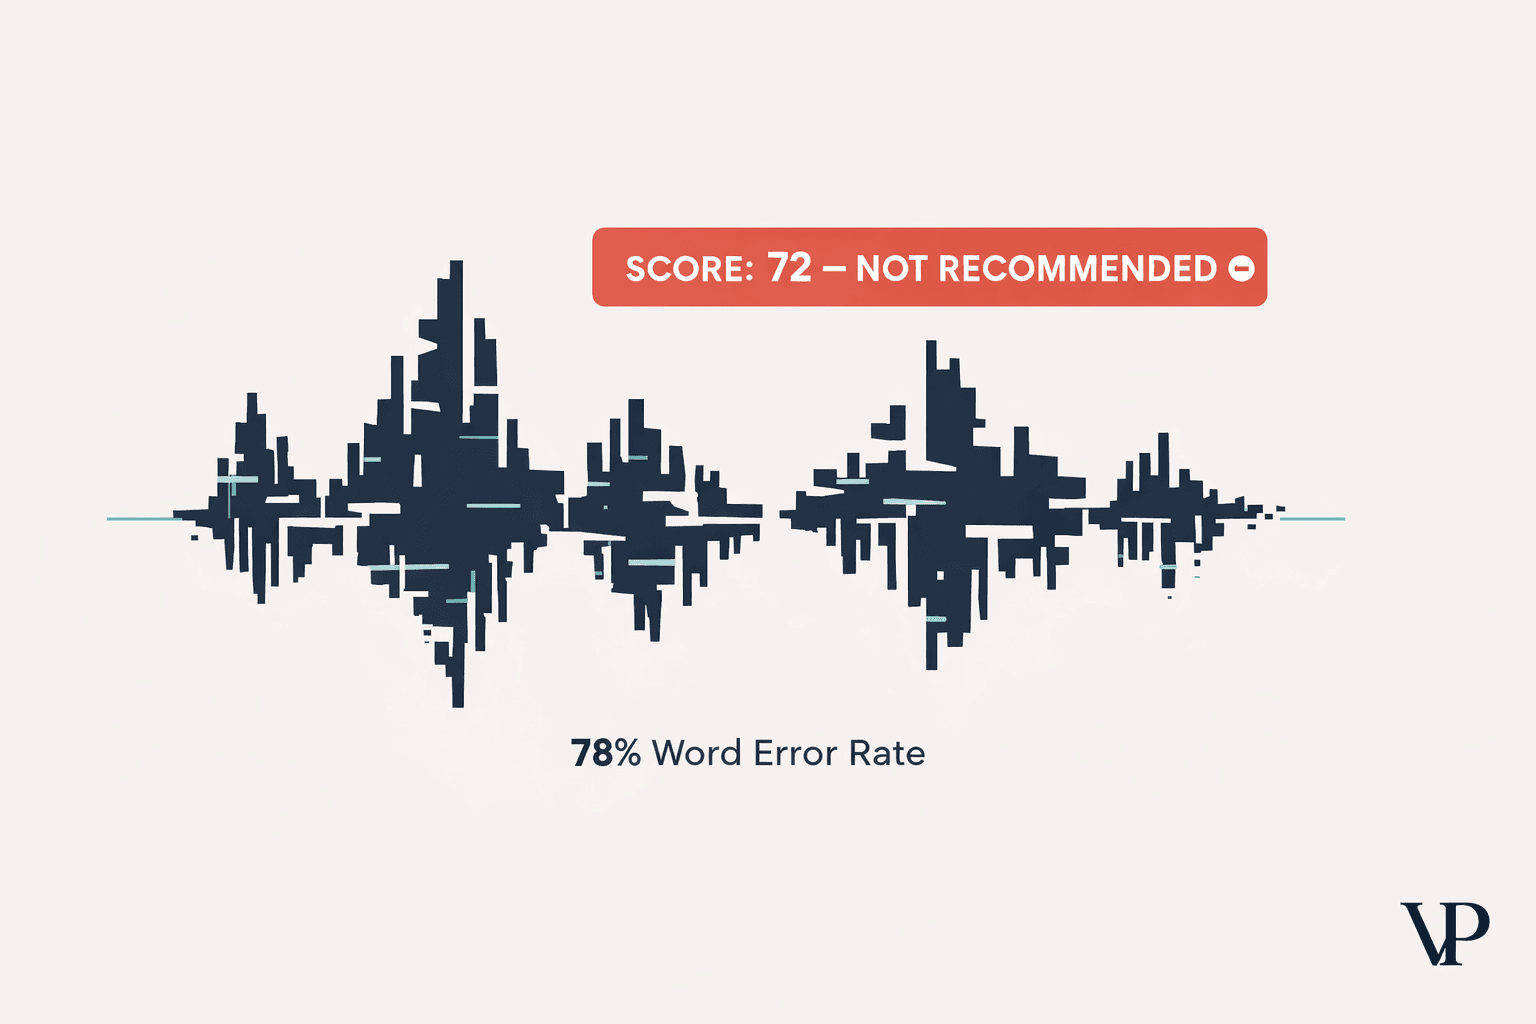
זה מה שהתחלתי לכנות כשל מדורג בשיחות עם הצוות שלי — כאשר שגיאה בשכבת AI אחת לא רק נמשכת אלא מתעצמת בעוברה דרך השכבות הבאות. תמליל גרוע מזין ניתוח גרוע שמזין המלצה גרועה. עד שאדם רואה את הפלט, הוא נראה נקי. ציון. דירוג. דחייה. אף אחד לא רואה את שיעור שגיאות המילים של 78% שמתחת.
כאשר לתמליל היסודי יש שיעור שגיאות של 78%, כל מודל שנבנה מעליו אינו מנתח את המועמד — הוא מנתח רעש.
המספר הזה אינו היפותטי. מחקרים על מערכות ASR המעבדות דוברים חירשים בעלי מובנות דיבור בינונית עד נמוכה מראים בעקביות שיעורי שגיאות מילים שבין 77% ל-78%. לשם השוואה, דוברי אנגלית אמריקאית תקנית מגיעים ל-10–18%. המערכת מעולם לא הייתה עתידה לעבוד עבור D.K. היא תוכננה, מהיסוד, להוציא אותה מהמשחק.
מדוע לכל כלי גיוס מבוסס-AI יש את הבעיה הזאת?
כאן אני צריך להיות כן לגבי התעשייה שבה אני עובד.
הרוב המכריע של "פתרונות הגיוס מבוססי-AI" בשוק כרגע הם מה שאנחנו מכנים מוצרי עטיפה. אלה ממשקים דקים הבנויים מעל מודלי שפה גדולים למטרות כלליות — GPT-4, Claude, Gemini. החברה מוסיפה ממשק משתמש נאה, כמה הנחיות ייעודיות למשאבי אנוש, אולי לוח מחוונים עם תרשימים, ומוכרת אותו כ"מודיעין כישרונות מונע-AI".
ישבתי מול קונים ארגוניים שבאמת לא הצליחו להבחין בין עטיפה למערכת ייעודית. ולמה שיוכלו? השיווק נראה זהה. ההדגמות מלוטשות. חברת העטיפה אומרת "אנחנו משתמשים ב-AI מתקדם" וחברת ה-AI העמוק אומרת "אנחנו משתמשים ב-AI מתקדם", וצוות הרכש בוחר את זה עם תג המחיר הנמוך יותר.
ההבדל מתגלה רק כשמישהי כמו D.K. נכנסת בדלת.
מודלי שפה גדולים למטרות כלליות יורשים כל הטיה שאפויה במערכי הנתונים בקנה מידה של האינטרנט שעליהם אומנו. אם עשורים של נתוני גיוס משקפים העדפה למועמדים שמדברים בצורה מסוימת, נראים בצורה מסוימת, מציגים עצמם בצורה מסוימת, המודל אינו מפקפק בתבנית הזאת — הוא ממטב עבורה. זה אינו פגם בהיגיון של המודל. זה פשוטו כמשמעו מה שהמודל נבנה לעשות: למצוא תבניות ולשכפל אותן.
אני זוכר ויכוח סוער עם אחד המהנדסים שלי — אקרא לו ראבי — לגבי השאלה אם הסרת הטיה יריבותית שווה את התקורה החישובית. עמדתו הייתה פרגמטית: "רוב המועמדים לא יפעילו את מקרי הקצה. אנחנו מוסיפים השהיה עבור תרחיש שמשפיע אולי על 2% מהראיונות." תגובתי הייתה בוטה: "אם המערכת שלך עובדת בצורה מושלמת עבור 98% מהאנשים ומפלה באופן שיטתי את ה-2% האחרים, לא בנית מוצר טוב עם מקרי קצה. בנית הפרה של זכויות אזרח עם שיעור דיוק גבוה."
ראבי השתכנע. אבל אני חושב על השיחה הזאת הרבה, כי אני יודע שהיא מתרחשת בכל חברת AI כרגע, וברובן, הראבים מנצחים.
כיצד בונים בפועל AI שאינו מפלה?
התשובה הטכנית חשובה, אבל אני רוצה להסביר אותה כפי שהייתי מסביר לחבר, לא כפי שהייתי כותב במסמך מפרט.
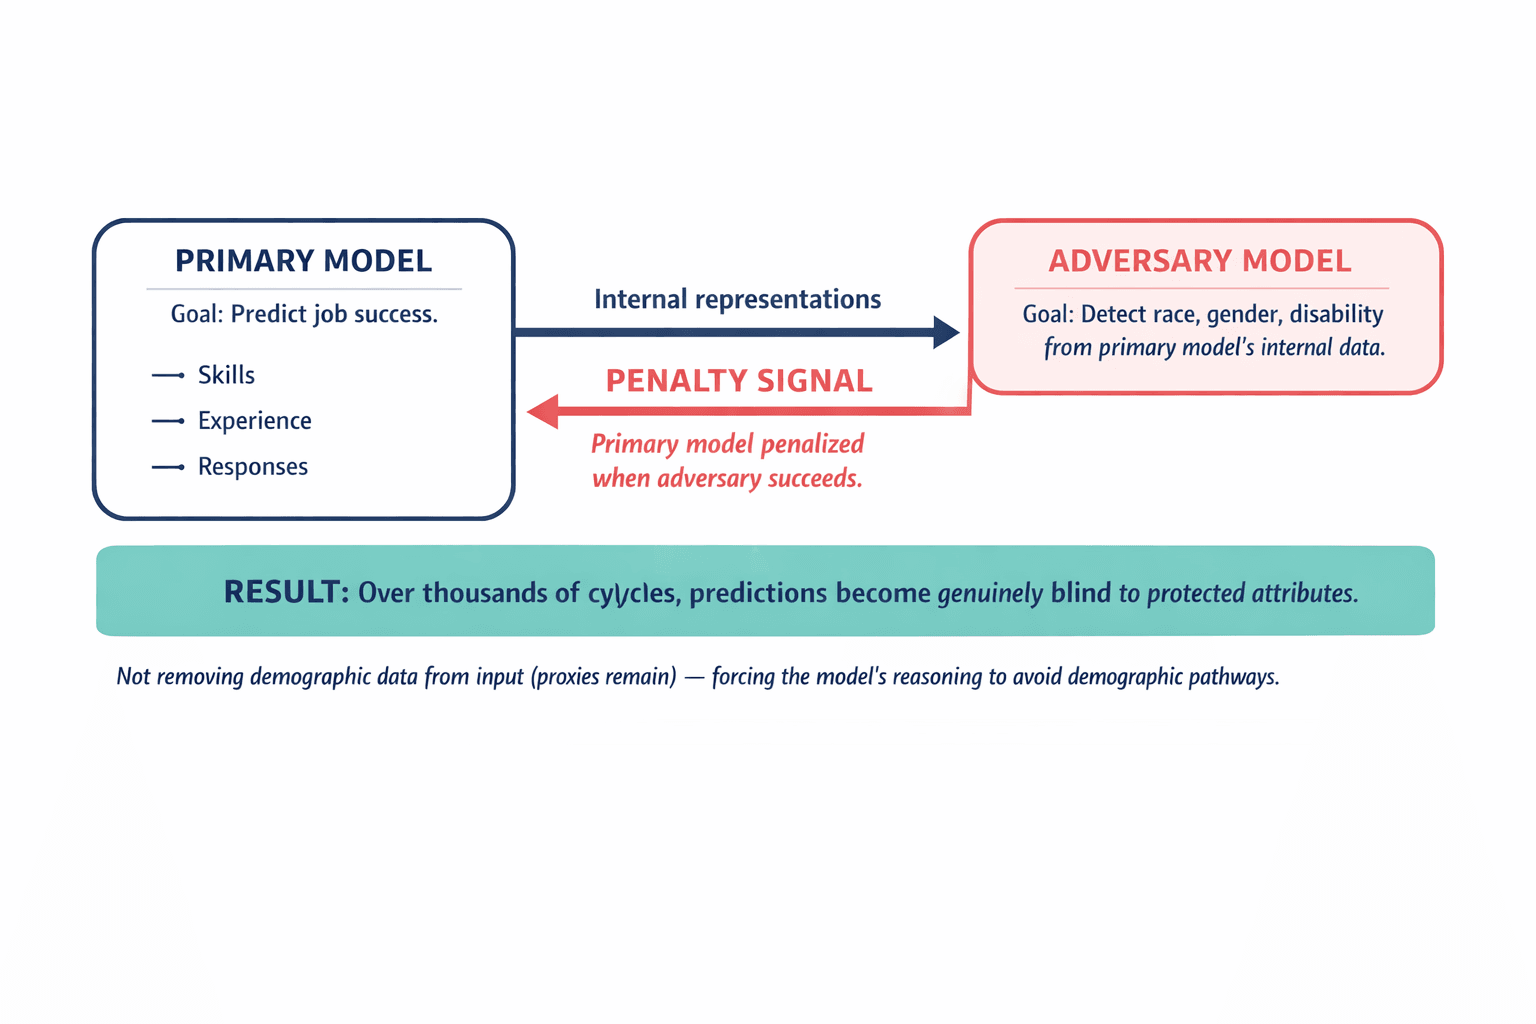
הרעיון המרכזי שמאחורי מה שאנחנו בונים ב-Veriprajna הוא משהו שנקרא הסרת הטיה יריבותית. דמיינו שאתם מאמנים שני מודלי AI בו-זמנית. המודל הראשון — זה שבאמת אכפת לכם ממנו — מנסה לחזות אם מועמד יצליח בתפקיד. המודל השני הוא יריב. תפקידו היחיד הוא להסתכל על הייצוגים הפנימיים של המודל הראשון ולנסות לנחש את הגזע, המגדר, מצב המוגבלות, או כל מאפיין מוגן אחר של המועמד.
ואז אתם מענישים את המודל הראשון בכל פעם שהיריב מצליח.
לאורך אלפי מחזורי אימון, המודל הראשי לומד לבצע חיזויים שהם באמת עיוורים למאפיינים מוגנים — לא משום שהסרתם את נקודות הנתונים הללו מהקלט (זו הגישה הנאיבית, והיא אינה עובדת כי משתנים מתווכים נותרים), אלא משום שההיגיון הפנימי של המודל נאלץ למצוא נתיבים למסקנותיו שאינם עוברים דרך מידע דמוגרפי.
הוגנות נגד-עובדתית פירושה להוכיח שציון של מועמד יישאר זהה אילו המאפיינים המוגנים שלו — גזע, מגדר, מוגבלות — היו שונים. זו אינה שאיפה. זהו מבחן מתמטי.
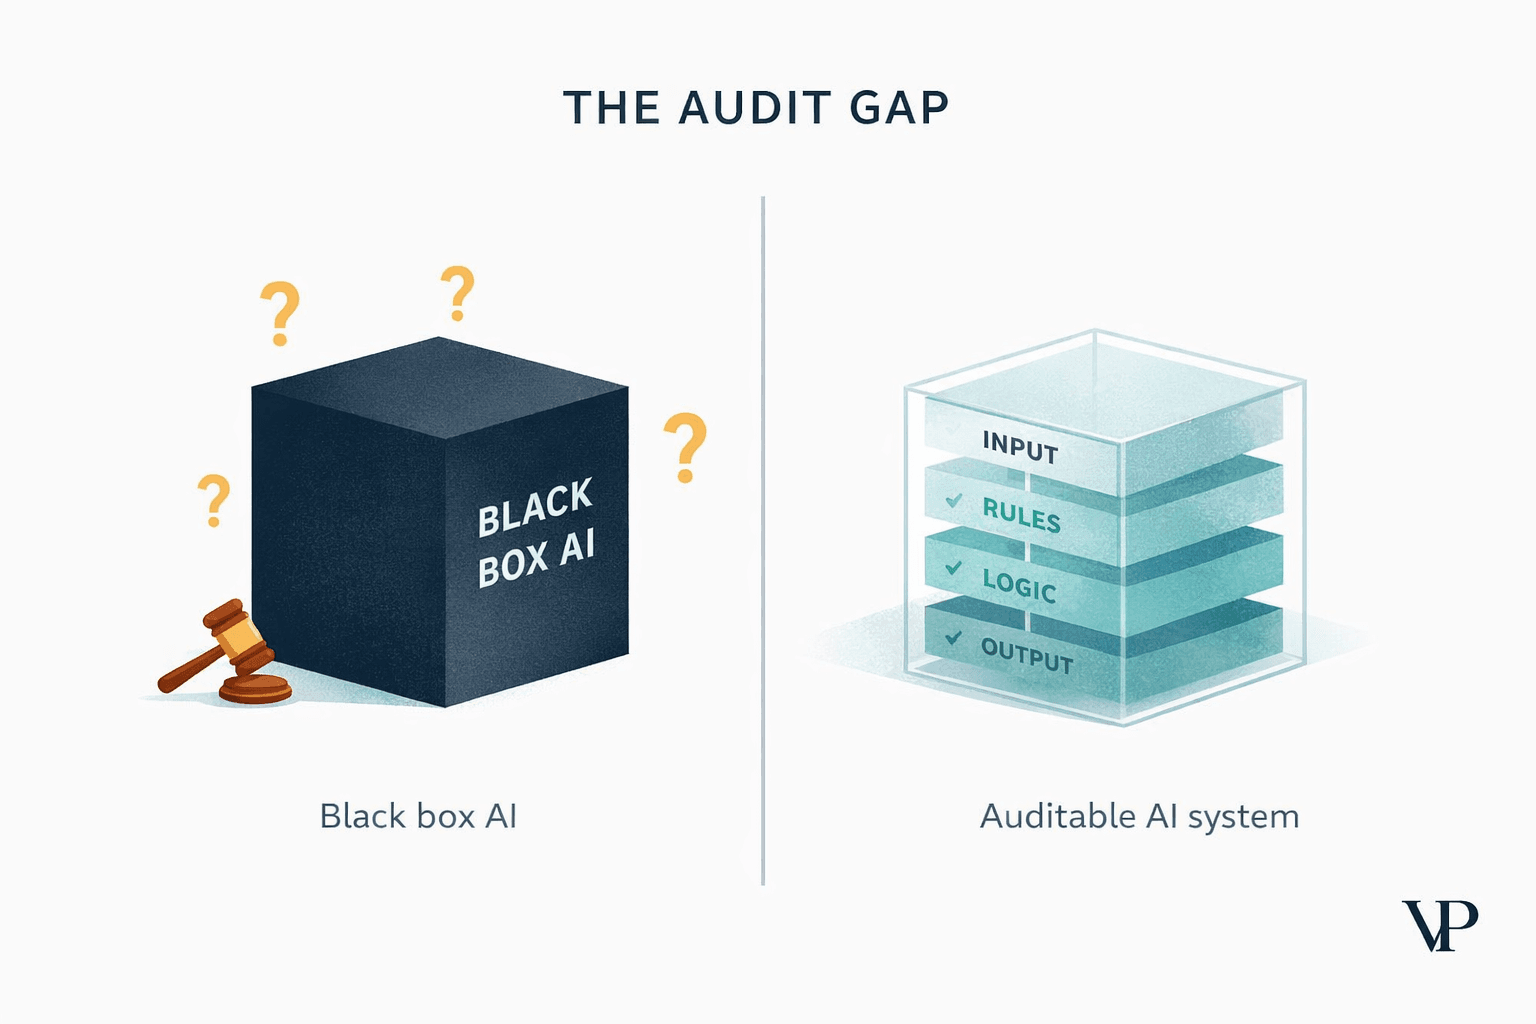
זה שונה מהותית ממה שעטיפה יכולה לעשות. אי אפשר להבריג הסרת הטיה יריבותית על קריאת API של GPT. אי אפשר לבצע ביקורת רטרואקטיבית על הייצוגים הפנימיים של מודל שאינכם שולטים בו. אתם רק שולחים טקסט לקופסה שחורה ומקווים שהפלט אינו מפלה. תקווה אינה אסטרטגיית ציות.
כתבתי על הארכיטקטורה הטכנית המלאה — כולל גישת מיזוג המודאליות המרובה ומדדי ההוגנות הפורמליים — בנייר העמדה האינטראקטיבי שלנו אם אתם רוצים להעמיק.
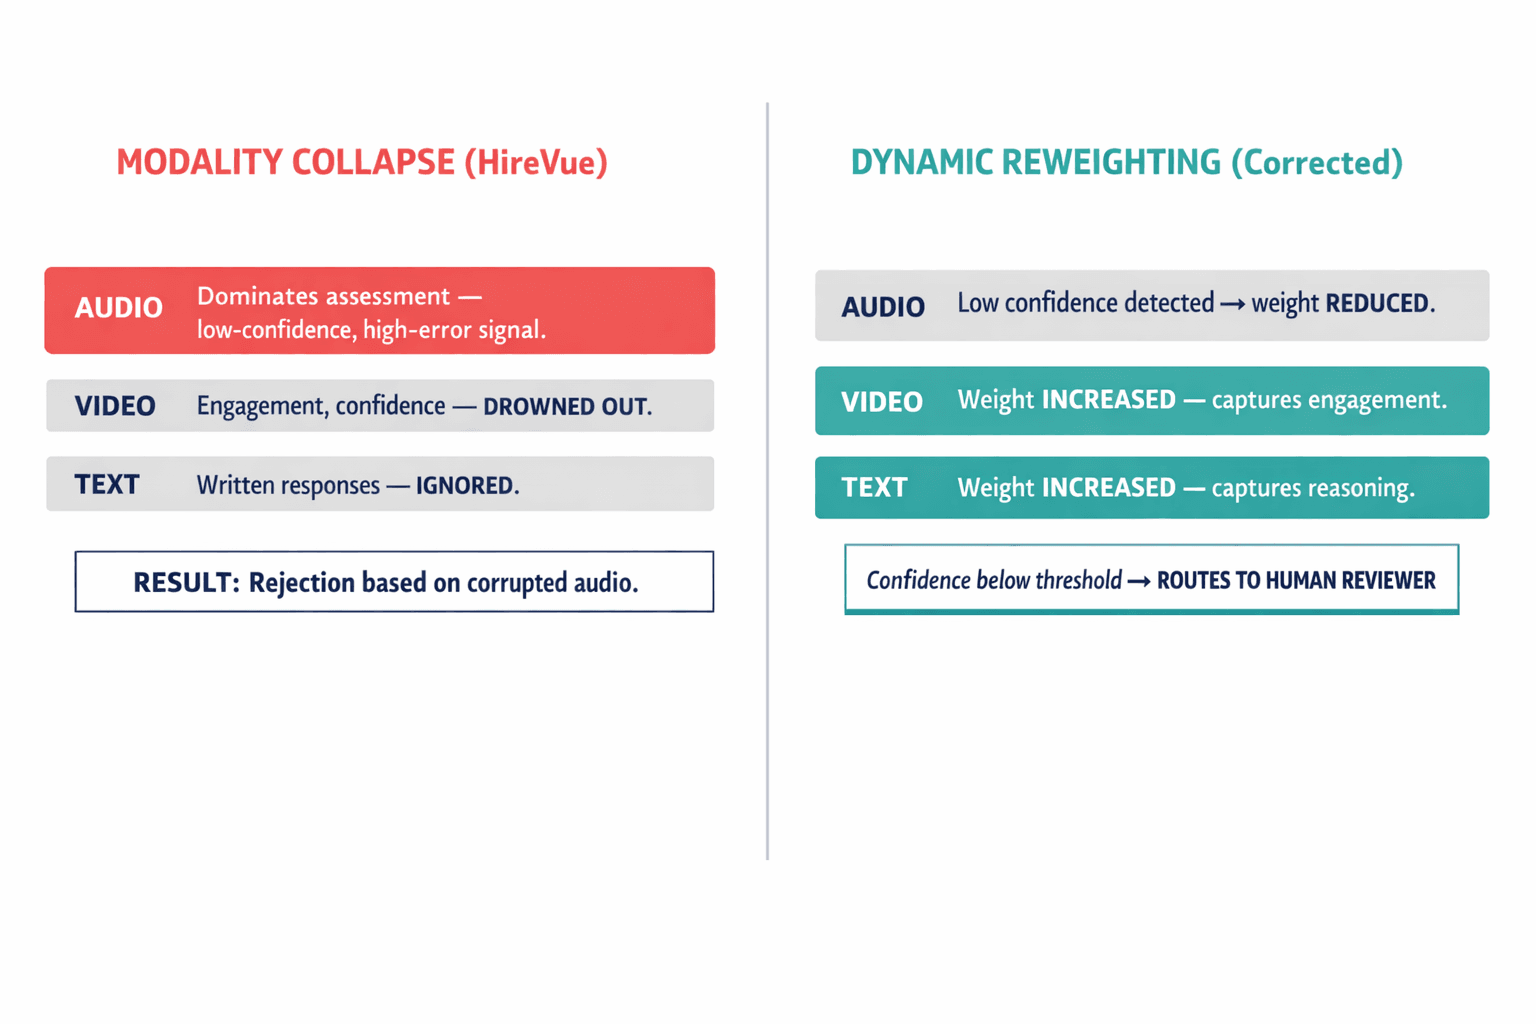
קריסת המודאליות שהטביעה את D.K.
יש כשל טכני ספציפי בפרשת HireVue שלדעתי רוב הסיקור פספס, והוא כזה שמדיר שינה מעיניי.
המערכת סבלה ממה שחוקרים מכנים קריסת מודאליות. במערכת AI רב-מודאלית — כזו שמעבדת וידאו, אודיו וטקסט בו-זמנית — כל ערוץ (או "מודאליות") תורם להערכה הסופית. תיאורטית, זה חסין יותר ממערכת חד-ערוצית. אם האודיו רועש, הווידאו יכול לפצות. אם התמליל מעורבל, הרמזים החזותיים יכולים למלא את החסר.
בפועל, נראה שמערכת HireVue נתנה משקל-יתר לערוץ האודיו. כאשר הדיבור של D.K. לא תאם את התבניות שהמודל ציפה להן, אות האודיו לא רק תרם ציון נמוך — הוא השתלט על כל ההערכה. הערוץ החזותי, שאולי היה קולט את המעורבות שלה, את הביטחון שלה, את ההבעתיות שלה, הוטבע.
אנחנו פותרים זאת באמצעות משהו שאנחנו מכנים מיזוג מודאליות לדה-הטיה שיתופית. כאשר המערכת שלנו מזהה שמודאליות אחת מפיקה פלטים בעלי ביטחון נמוך — נניח, ה-ASR מתקשה עם מבטא לא תקני — היא לא רק מסמנת את הבעיה. היא מגדילה אוטומטית את משקל המודאליות האחרות. לתשובות הכתובות יש יותר השפעה. לרמזים ההתנהגותיים החזותיים יש יותר השפעה. לערוץ האודיו המדורדר יש פחות.
אבל הנה החלק שלדעתי הכי חשוב, והוא בכלל לא טכני: כאשר הביטחון של המערכת שלנו יורד מתחת לסף, היא מנתבת לאדם. לא כמחשבה שנייה. לא כ"נתיב הסלמה" קבור בתפריט הגדרות. אלא כהחלטה ארכיטקטונית מרכזית.
D.K. ביקשה כתבנית אנושית. סירבו לה. במערכת שלנו, היא לא הייתה צריכה לבקש. המערכת הייתה מזהה את מגבלתה שלה ומכניסה אדם באופן אוטומטי.
AI צריך לדעת מתי הוא נכשל. העובדה שמערכת HireVue דירגה בביטחון תמליל בעל שיעור שגיאות של 78% מספרת לכם הכול על האופן שבו הכלים האלה בנויים — ולמען מי הם בנויים.
מה קורה כשהחוק משיג את הפער?
במשך שנים, תעשיית הגיוס מבוססת-ה-AI פעלה בוואקום רגולטורי. חברות יכלו לפרוס כל מה שרצו, לא לבקר דבר, ולהתנער מאחריות בתנאי השירות שלהן. העידן הזה מסתיים, במהירות.
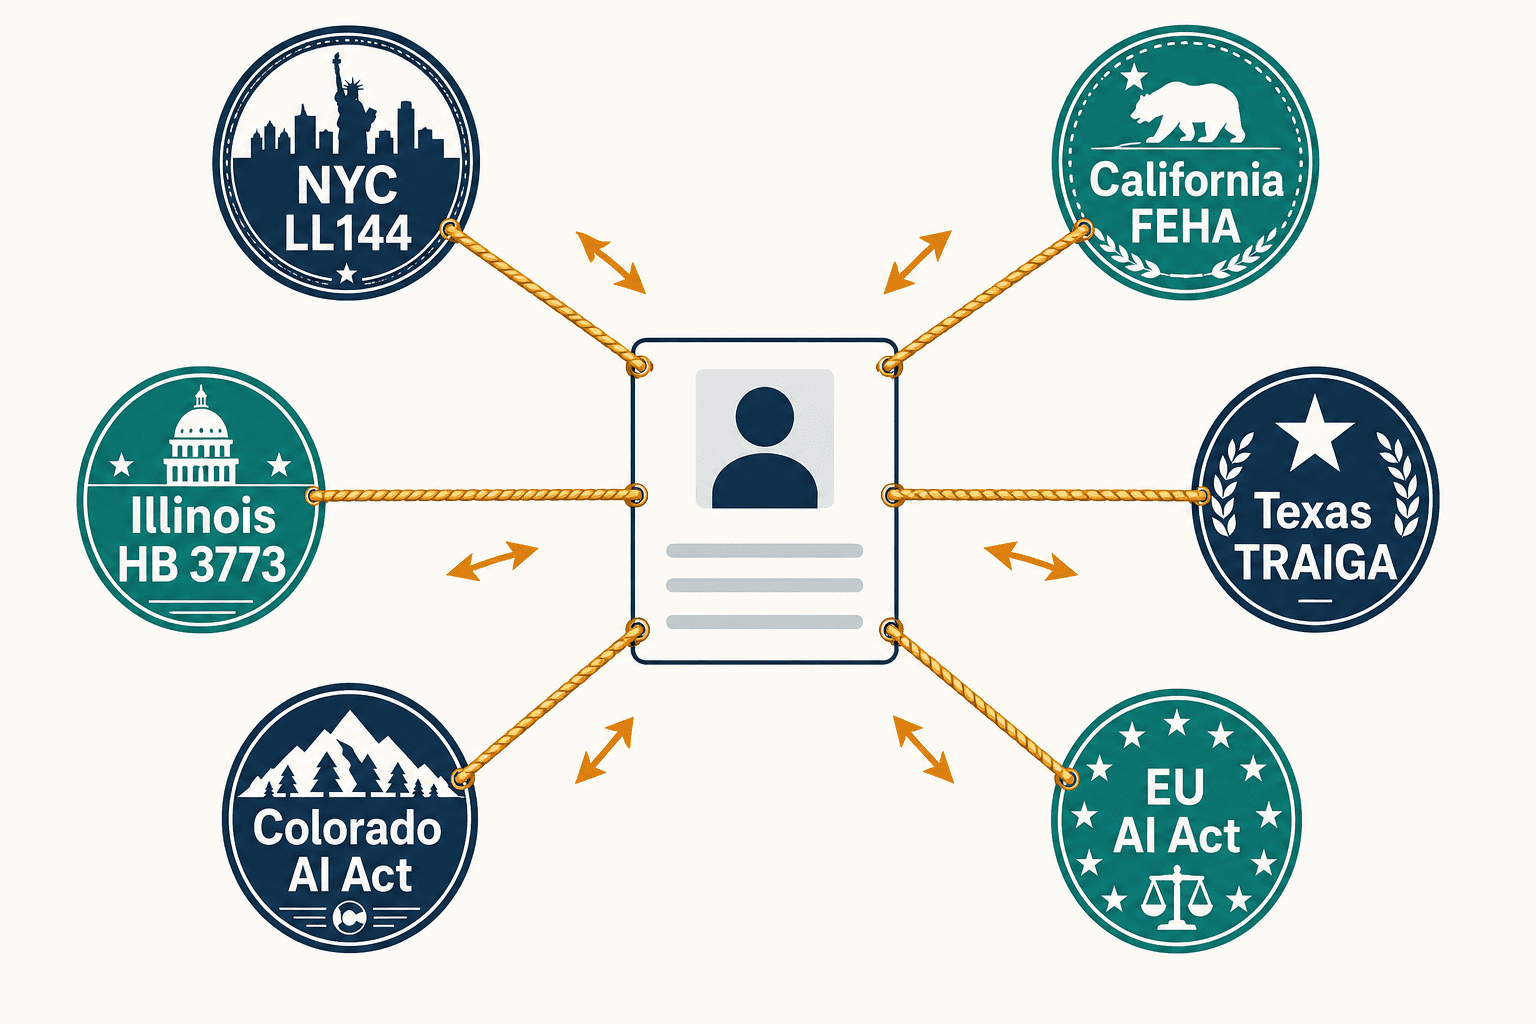
החוק לבינה מלאכותית של קולורדו (SB 24–205), הנכנס לתוקף בתחילת 2026, מכונן משהו חסר תקדים: "חובת זהירות סבירה" משפטית לכל מי שמפתח או פורס מערכות AI בסיכון גבוה. החלטות גיוס וקידום מסווגות במפורש כבעלות סיכון גבוה. החוק מחייב הערכות השפעה שנתיות המסננות לאיתור אפליה אלגוריתמית. לא וולונטרי. לא "נוהג מיטבי". חובה.
החוק המקומי 144 של העיר ניו יורק כבר מחייב ביקורות הטיה עצמאיות עבור כלי החלטות תעסוקה אוטומטיים. חקיקה דומה מתקדמת בקליפורניה ובאילינוי. חוק ה-AI של האיחוד האירופי מסווג AI לגיוס כבעל סיכון גבוה ומטיל דרישות שקיפות ופיקוח אנושי המגובות בקנסות מבוססי-הכנסה.
ואז יש את Mobley נ' Workday, שאולי היא התיק המשמעותי ביותר שרוב האנשים לא שמעו עליו. בית משפט פדרלי אישר תובענה ייצוגית ופסק שספק AI יכול להיחשב "סוכן" או "מעסיק עקיף" כאשר התוכנה שלו מבצעת פונקציות שבאופן מסורתי טופלו בידי מנהל גיוס אנושי. אותה פסיקה בודדת הרסה את חומת האש של האחריות שכל חברת עטיפה מסתמכת עליה — התפיסה שהספק מספק את הכלי אך המעסיק נושא בכל הסיכון.
משקיע פוטנציאלי אמר לי, לפני כשנה, ש-AI ממוקד-ציות הוא "מהלך נישתי". שהשוק רוצה מהירות וקנה מידה, לא יכולת ביקורת. אמרתי לו שהשוק עומד לתבוע את עצמו עד שירצה יכולת ביקורת. אני חושב שהגשת התלונה של ה-ACLU הוכיחה את הטענה.
לניתוח הרגולטורי המפורט ולמסגרת המלאה כיצד ארגונים צריכים להיערך, הצלילה הטכנית לעומק נמצאת כאן.
"אבל המערכת שלנו עברה את ביקורת ההטיה"
אנשים שואלים אותי את זה כל הזמן — אם מערכת עוברת ביקורת הטיה שנתית, האם זה לא מספיק?
לא. והנה למה.
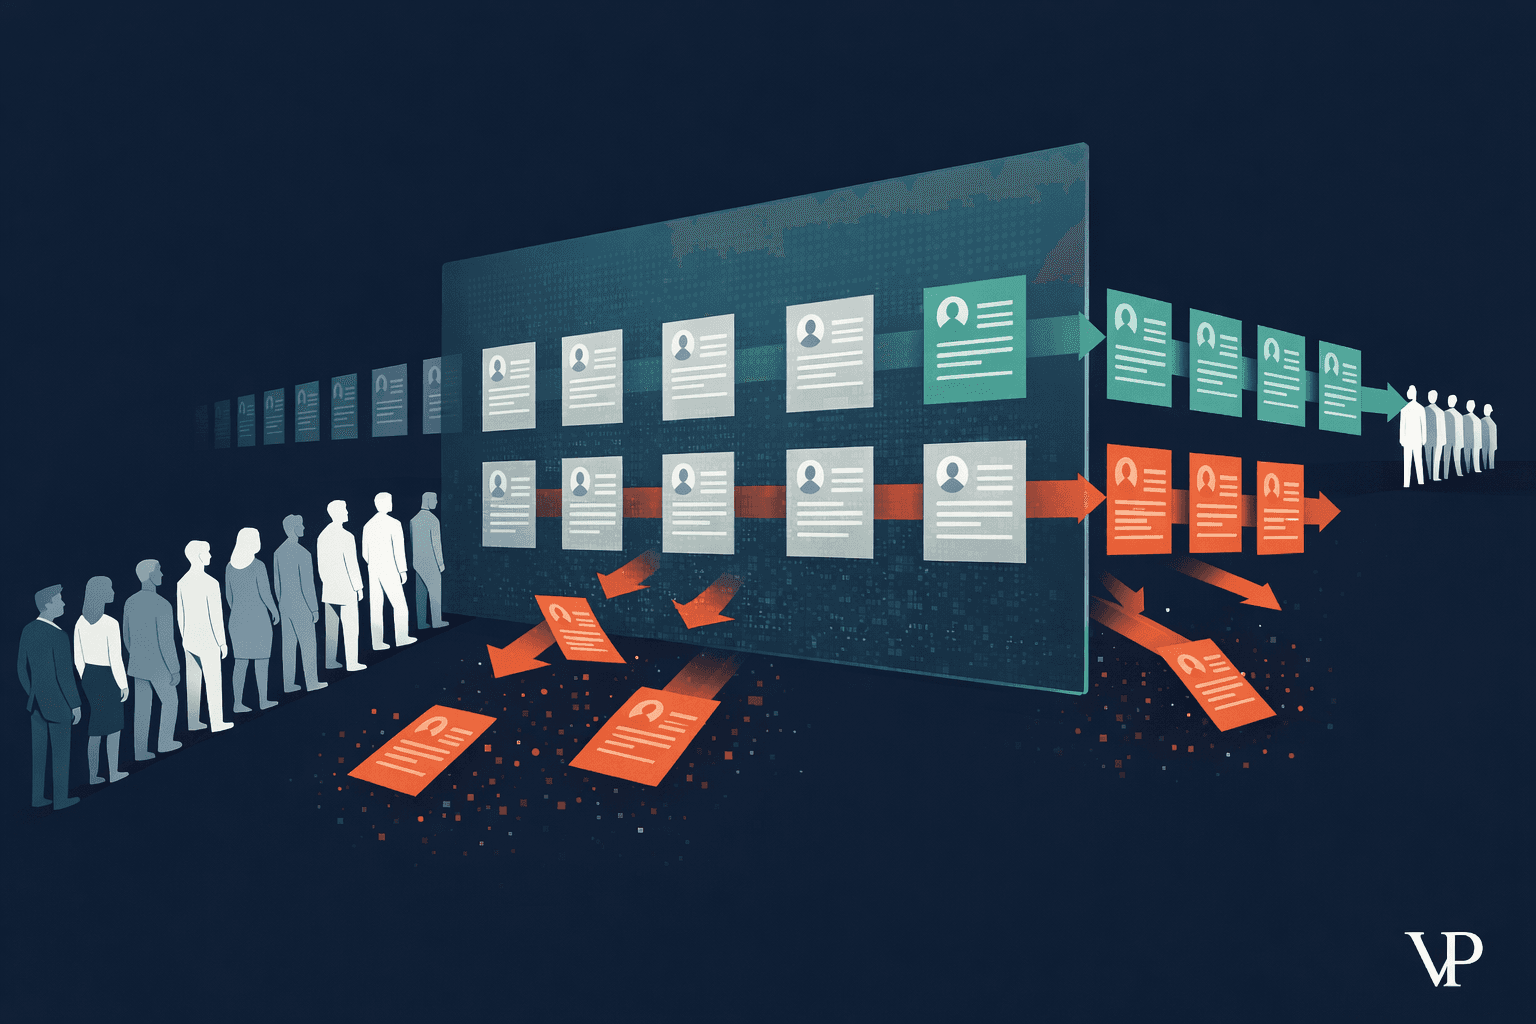
רוב ביקורות ההטיה בודקות השפעה שונה באמצעות כלל ארבע-החמישיות: אם שיעור הבחירה של קבוצה מוגנת יורד מתחת ל-80% מהשיעור של הקבוצה הנבחרת ביותר, יש בעיה. זו רצפה שימושית, אבל זו תקרה נוראית. מערכת יכולה לעבור את כלל ארבע-החמישיות במצטבר תוך כדי כישלון שיטתי כלפי קבוצות אינטרסקציונליות ספציפיות — נניח, נשים חירשות בנות קבוצה ילידית — משום שגודלי המדגם קטנים מכדי להפעיל את הסף הסטטיסטי.
D.K. לא נכשלה בידי מערכת שהייתה מוטה באופן רחב נגד נשים או מוטה באופן רחב נגד בני קבוצות ילידיות. היא נכשלה בידי מערכת שלא הצליחה לעבד את השילוב הספציפי שלה של זהות וסגנון תקשורת. מדדי הוגנות מצטברים לעולם לא היו תופסים זאת.
בגלל זה אנחנו משתמשים בSHAP (SHapley Additive exPlanations) כשכבת ניטור רציפה, לא כתיבת סימון פעם בשנה. SHAP מאפשר לנו לפרק כל החלטה בודדת למאפיינים התורמים לה. אם מועמד מקבל ציון נמוך, אנחנו יכולים לראות בדיוק אילו מאפיינים הניעו את הציון הזה. ואם המאפיינים הללו מתואמים עם מאפיינים מוגנים ולא עם כשירויות רלוונטיות לתפקיד — אם "פרוזודיה" או "קצב דיבור" עושים את העבודה הכבדה במקום "יכולת פתרון בעיות" או "מומחיות תחומית" — המערכת מסמנת את עצמה לתיקון בזמן אמת.
ההבדל בין ביקורת הטיה לבין ניטור הסברתיות רציף הוא ההבדל בין בדיקה גופנית שנתית לבין מוניטור לב. האחת אומרת לך מה כבר השתבש. השני תופס את הבעיה בזמן שעדיין יש זמן לפעול.
המחיר האמיתי של טעות בעניין הזה
אני רוצה לסיים במשהו שאינו עוסק בטכנולוגיה או ברגולציה.
כאשר נשללה מ-D.K. הקידום שלה, החברה לא רק הפרה את זכויותיה. היא איבדה עובדת בעלת ביצועים גבוהים שזכתה בבונוסים ובהערכות חיוביות — מישהי שלפי כל מדד אנושי, הייתה מוכנה לתפקיד. ה-AI לא הגן על החברה מפני גיוס גרוע. הוא הגן על החברה מפני גיוס מצוין.
בכל פעם שמערכת מוטה מסננת החוצה מועמד כשיר — בגלל מבטא, מוגבלות, שם, דפוס דיבור שאינו תואם את נתוני האימון — החברה לא רק ניצבת בפני סיכון משפטי. היא מאבדת את האדם. היא מאבדת את נקודת המבט, את גישת פתרון הבעיות, את הניסיון החי שאף אופטימיזציה של "התאמה תרבותית" אינה יכולה לשכפל.
בניתי את Veriprajna על אמונה שאני מחזיק בה כעת בתוקף רב יותר מאשר כשהתחלתי: החברות שישלטו בעשור הבא הן אלה שיבינו כיצד להשתמש ב-AI כגשר אל כישרון שאחרת היו מפספסות, לא כמסנן שמסנן אותו החוצה. עידן העטיפה קורס תחת משקל התביעות של עצמו. עידן הקופסה השחורה נמחק מהקיום בחקיקה.
מה שיחליף אותו חייב להיות שונה במהות, לא במידה. לא עטיפה טובה יותר. לא קריאת GPT מונחית בקפידה יותר. ארכיטקטורה שונה מהיסוד — כזו שיודעת מתי היא טועה, מסבירה מדוע היא צודקת, ומכניסה אדם כאשר אף אחד מהם אינו ודאי.
AI צריך להיות גשר אל כישרון, לא מחסום בפניו. כל מערכת שאינה יכולה להבחין בין מוגבלות לבין לקות אינה ראויה לקבל החלטות לגבי הקריירות של אנשים.
עידן ה"פרוס והתנער" נגמר. מה שבא אחריו קשה יותר, איטי יותר, יקר יותר לבנייה, והדבר היחיד שבאמת יעבוד.