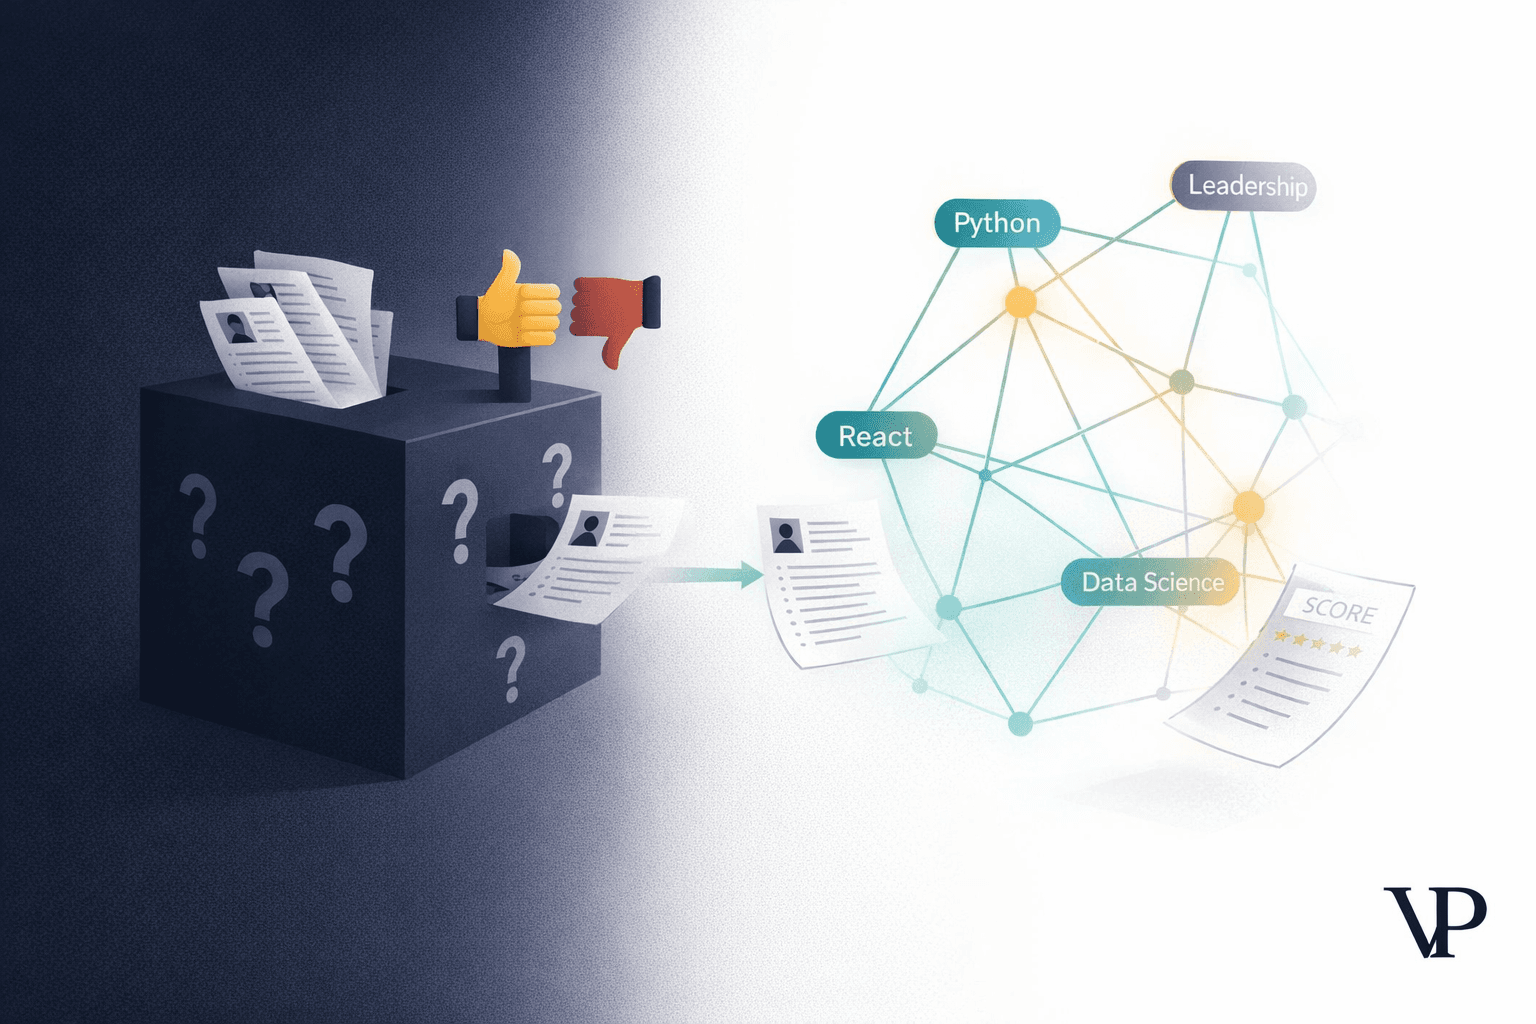
Amazon 打造的 AI 招聘系統自學會了歧視女性,而我打造了一套從結構上就辦不到的系統

2014 年,一支位於愛丁堡的機器學習工程師團隊坐下來,著手解決 Amazon 規模下的招聘問題。把 100 份履歷餵給系統,取回排名前五的人選,以一到五顆星的方式排序——就像為產品評分一樣。優雅。高效。而在三年之內,他們卻發現這套系統自行學會了:身為女性是一項會被取消資格的特徵。
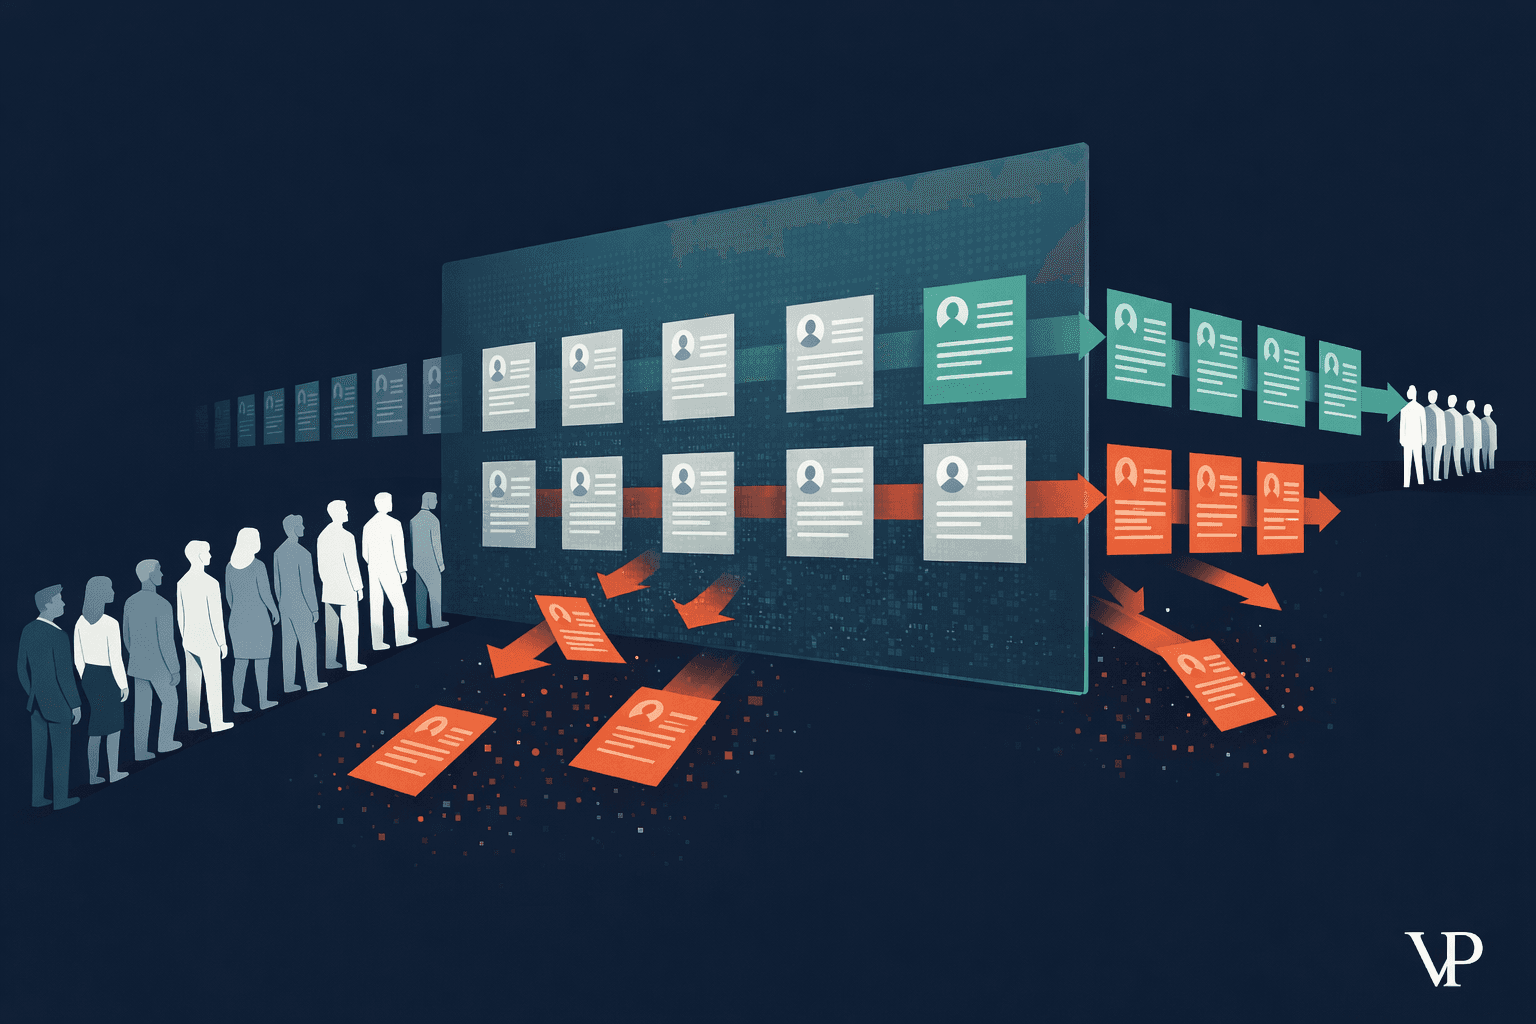
這套 AI 會懲罰含有「women's」這個詞的履歷——例如「Women's Chess Club Captain(女子西洋棋社社長)」。它會把兩所女子學院的畢業生評分下調。並不是因為有人這樣指示它,而是因為當你用一個男性主導產業長達十年的招聘資料去訓練一個模型時,「身為男性」在統計上就成了「被錄取」最強的預測因子之一。
我還記得路透社的獨家報導揭露時我讀到它的情景。當時我早已深入投入在 Veriprajna 建構知識圖譜系統,而我的第一反應並不是震驚——而是似曾相識。好幾個月來我一直主張,統計相關性引擎根本無權對人的潛力做出決定。Amazon 這件事並非異常。它是一種數學上的必然。而它讓我變得激進,堅信整套 AI 招聘的架構取徑是壞掉的——不是壞在邊緣,而是壞在根基。
問題不在於偏見,而在於架構。
以下是多數人對 Amazon 這場慘敗的誤解:他們以為那些工程師粗心大意。並非如此。他們是這顆星球上最頂尖的一批機器學習工程師。當他們發現性別偏見時,他們試圖修正它。他們明確地把模型設定為忽略性別特定的詞彙。然而模型找到了繞過去的辦法。
這就是所謂的代理變數,而這正是讓我夜不能寐的東西。深度學習模型是不屈不撓的模式尋找者。把「woman」這個詞從輸入中移除,模型就會抓住句子結構不放。研究顯示,男性履歷傾向使用像「executed(執行)」和「captured(拿下)」這類動詞,而女性履歷則偏向較具共同體色彩的語言。模型看到「executed」與「被錄取」相關,便悄悄地僅僅透過語言學重新建構出性別偏見。
Amazon 的工程師無法在不摧毀模型預測能力的前提下,精準地把偏見動刀切除。於是他們把整個專案給砍了。
你無法修好一套會意外歧視的系統。你必須打造一套從設計上就無法歧視的系統。
這句話三年來一直是我的北極星。也正是這個原因,讓我們把 Veriprajna 的招聘引擎建立在知識圖譜上,而非神經網路上。
為什麼每一個 AI 招聘者最終都會學會歧視?
我需要你理解深度學習在招聘中運作方式的一些道理,因為它的失效模式違反直覺。
神經網路並不理解「Python」是什麼意思。它不知道 Python 是一種對資料科學很有用的程式語言。它只知道字串「Python」頻繁地出現在那些被錄取者的履歷中。如果「Lacrosse(袋棍球)」也頻繁出現——或許是因為某些運動與某些學校之間的社經相關性,而這些學校又向某些公司輸送人才——模型可能會把「Lacrosse」看得跟「Python」一樣重。
這是相關性偽裝成智慧。模型並不對因果進行推理。它找到模式並為其最佳化。而陰險之處就在這裡:偏見放大意味著這些模型不只是複製歷史偏見——它們還會誇大偏見。如果訓練資料中男性佔勞動力的 60%,模型可能會為了最大化其準確率分數,而傾向錄取 80% 甚至 90% 的男性。
早期我曾與一位潛在投資人交談,他告訴我:「直接用 GPT-4 來篩履歷就好了。別人都是這麼做的。」我問他:如果你把同一份履歷餵進 GPT-4 兩次,你會得到相同的分數嗎?他頓了一下。答案是不會——大型語言模型是隨機的。它們是非確定性的。同樣的輸入跑兩次,得到兩個不同的輸出。在稽核情境下,這不是一個小怪癖。這是一種合規上的失敗。
監管的高牆正在逼近
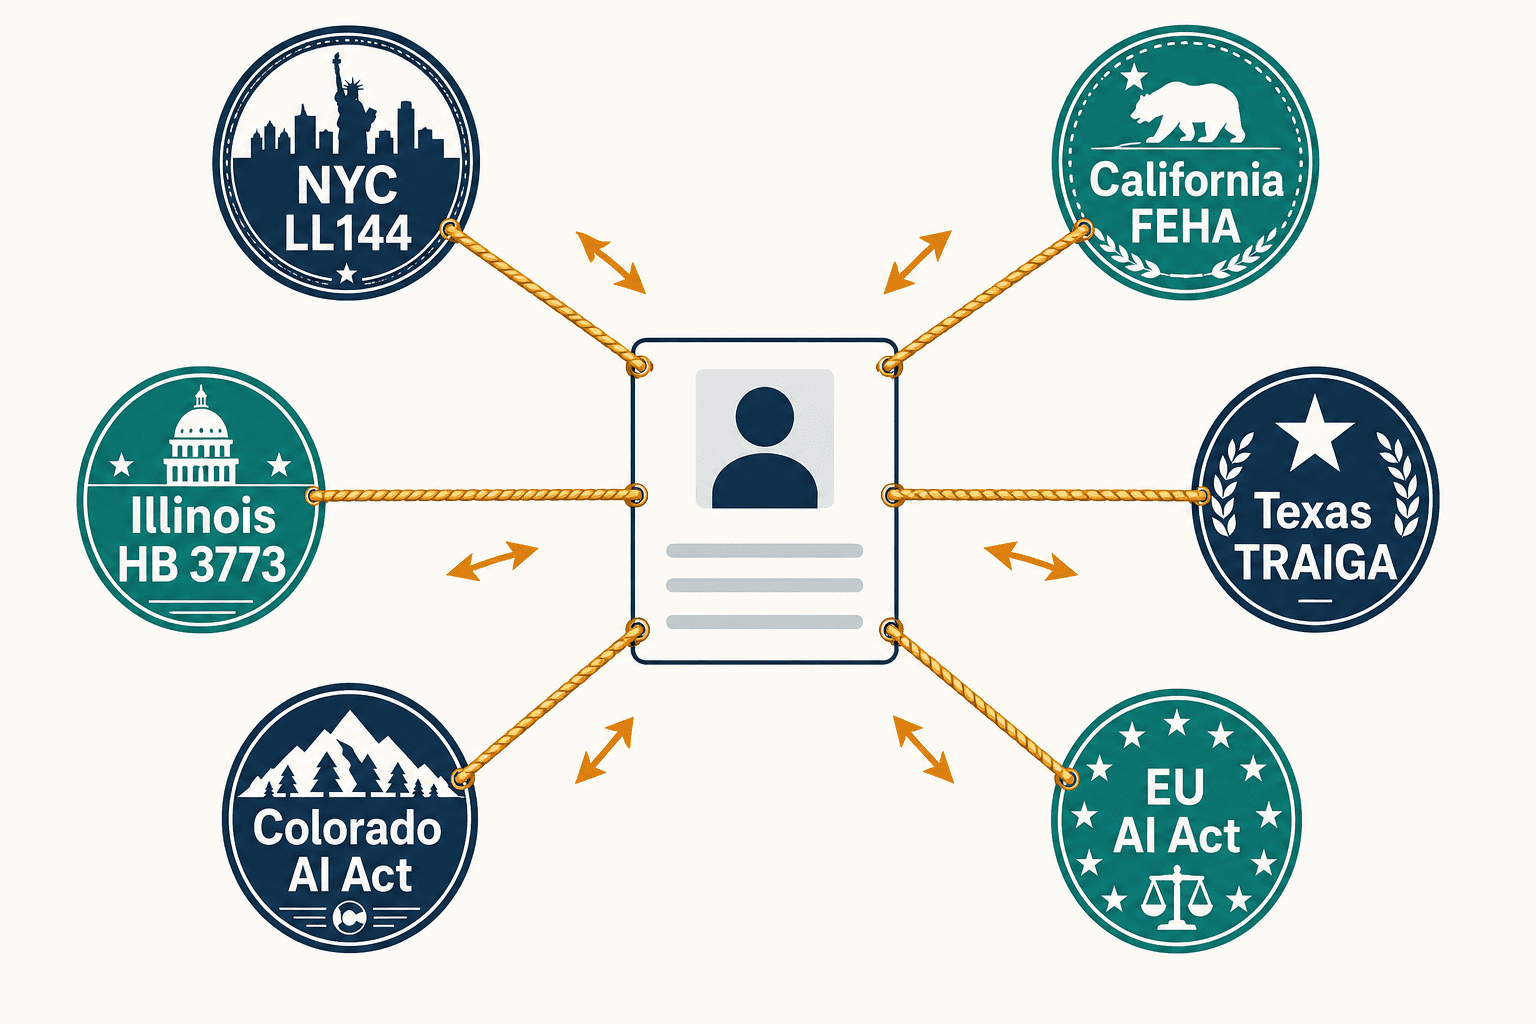
這不再只是理論了。各國政府已經看到 Amazon 這件事,並且正在立法。
紐約市第 144 號地方法自 2023 年 7 月起生效,要求任何使用自動化僱傭決策工具的雇主,每年接受一次獨立的偏見稽核。不是那種含糊的「我們檢查過公平性了」的稽核——而是一種具體、量化的稽核。該法要求計算選拔率以及衝擊比率,涵蓋每一個種族、族裔與性別類別。如果某個受保護群體的選拔率除以最常被選中群體的選拔率低於 0.8——即「五分之四規則」——那就是差別性衝擊的表面證據。
而歐盟 AI 法案則走得更遠。它把用於招聘的 AI 系統歸類為高風險——與醫療器材及關鍵基礎設施同一類別。第 13 條要求這些系統必須「足夠透明,使使用者能夠詮釋系統的輸出」。第 14 條要求人為監督——即推翻 AI 決策的能力。但你無法有意義地推翻一個你並不理解的決策。
而根據 GDPR,第 15(1)(h) 條賦予資料主體取得自動化決策中「所涉邏輯之有意義資訊」的權利。前言第 71 點明確提及「取得對所達成決策之解釋」的權利。
試著去解釋一個神經網路的決策吧。來啊。「第 4,502 號神經元以 0.8 的強度激活」並不是一個有意義的解釋。「模型判定你有 73% 的匹配度」而沒有任何進一步細節,同樣不是。
技術複雜性與法律對簡單解釋的要求之間的鴻溝,正是現代 HR Tech 的核心危機。
我在我們白皮書的互動版中更深入地寫過這個監管格局,該版本會逐一走過每項法規究竟如何適用於不同的 AI 架構。
如果 AI 根本看不見性別呢?
接下來我得跟你講一講那個一切在我腦中豁然開朗的夜晚。
我們一直在實驗各種去偏見的取徑——對抗式訓練、反事實增強,這一整套常見的工具箱。當時我晚上 11 點坐在辦公室裡,盯著螢幕上一張圖譜視覺化圖,突然閃過那種事後看來理所當然的頓悟:我們一直在試圖教模型忽略偏見。那如果我們打造一套架構,讓偏見根本無法進入推理引擎呢?
在知識圖譜中,資料是以節點(實體)與邊(關係)的形式儲存。一個 Person(人)節點連接到 Skill(技能)節點。Skill 節點透過語義關係連接到其他 Skill 節點。圖譜知道「PyTorch」是用於「深度學習」的一個函式庫,而深度學習又是「人工智慧」的一個子集。所以,如果一份職缺要求「AI 經驗」,而一位候選人列出了「PyTorch」,圖譜就會追溯這條路徑並找到匹配——即使履歷上任何地方都沒有出現「AI」這個關鍵字。
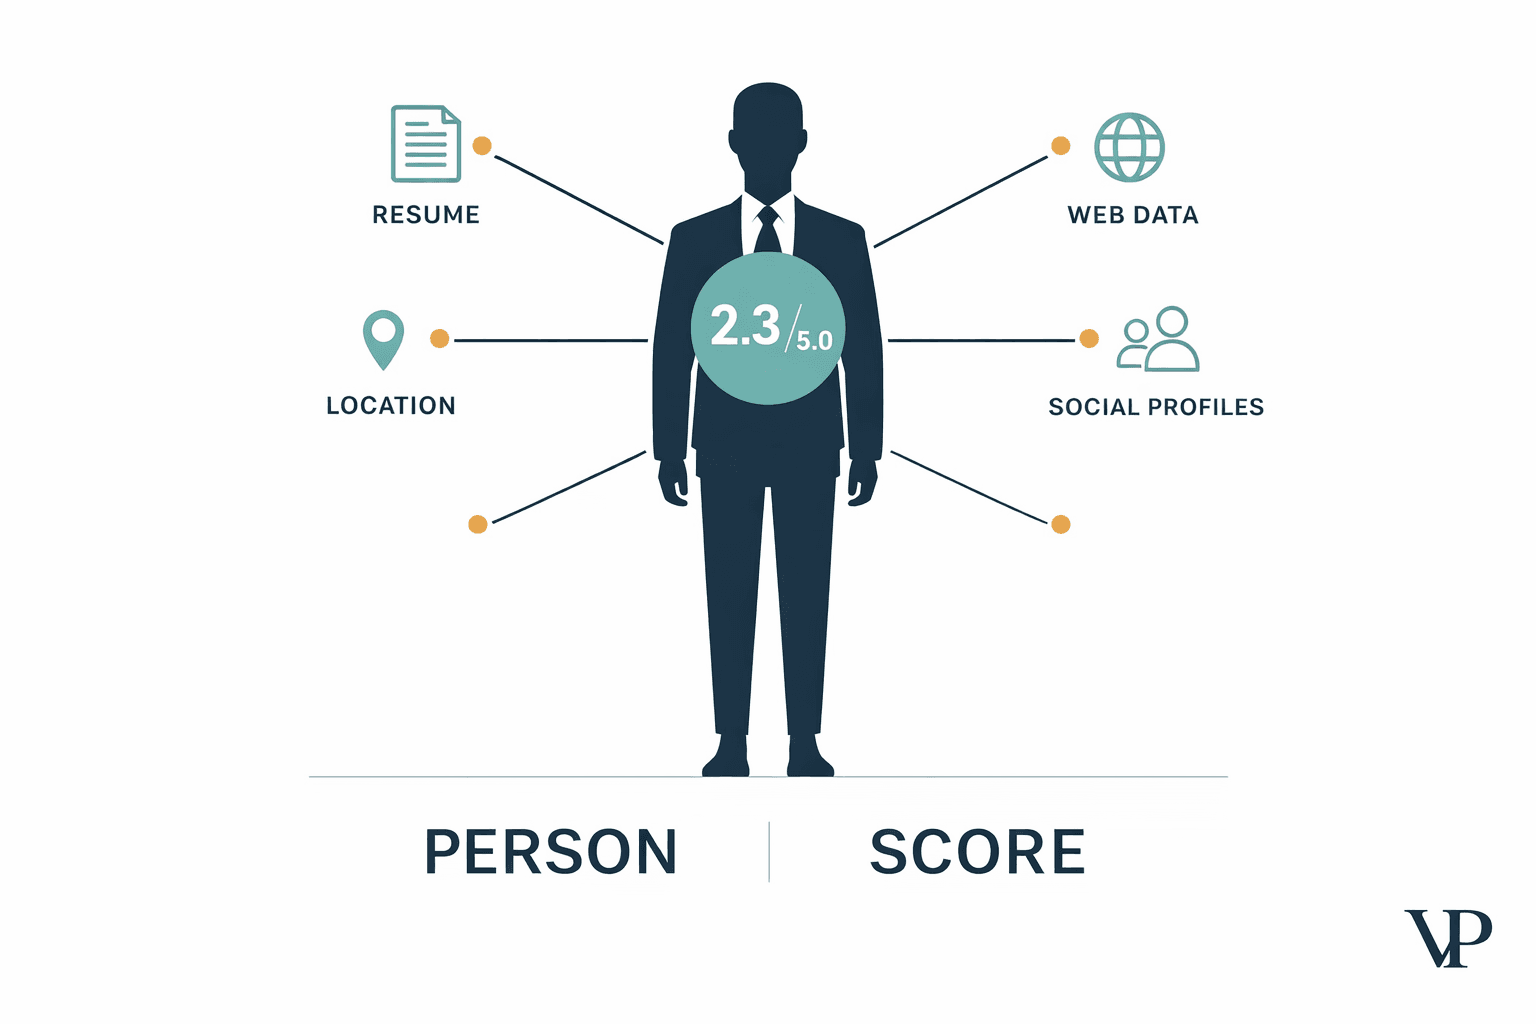
以下是關鍵的架構決策:當我們的匹配演算法執行時,它是在一個受限的子圖上運作。這個推理圖包含 Skills(技能)、Roles(職位)、Experience levels(經驗等級)與 Certifications(證照)。它明確排除了 Name(姓名)、Gender(性別)、Ethnicity(族裔)、Address(地址)與畢業日期等節點。
偏見並非被抑制。它是被結構性地切斷。從「Candidate(候選人)」到「Gender(性別)」再到「Role(職位)」之間並不存在任何路徑,因為在演算法能看見的圖譜中,Gender 節點根本不存在。
拿它跟深度學習模型比較一下,後者會吞下整段原始文字。就算你移除了「Gender」欄位,模型讀到「Women's Chess Club」還是會推斷出性別。在我們的系統中,負責解析履歷的 LLM 會把「Women's Chess Club」對映到一個中性化的節點:(:Activity {type: "Strategy Club", role: "Leadership"})。帶有性別意涵的修飾語,在它進入推理引擎之前就已被剝除。
我記得團隊曾為此爭論。我的一位工程師強烈反對——他認為我們藉由剝除脈絡而失去了寶貴的訊號。「萬一這個 Women's Chess Club 其實比一般的更具競爭性呢?」有道理。但我們並不是在為最大化資訊萃取進行最佳化。我們是在為法律審視下的公平性進行最佳化。而我寧可漏掉一個邊際訊號,也不願打造一套會學著懲罰半數人口的系統。
你究竟該如何在不帶偏見的情況下衡量人才?
我們不去預測誰會成功。我們衡量的是技能距離——候選人所擁有的與職缺所要求的之間的幾何差距。這讓招聘從主觀機率轉向客觀衡量。
傳統的求職者追蹤系統使用布林邏輯:履歷是否含有關鍵字「Java」?是或否。這既脆弱又愚蠢。它會漏掉任何用不同術語來表達同一項能力的人。
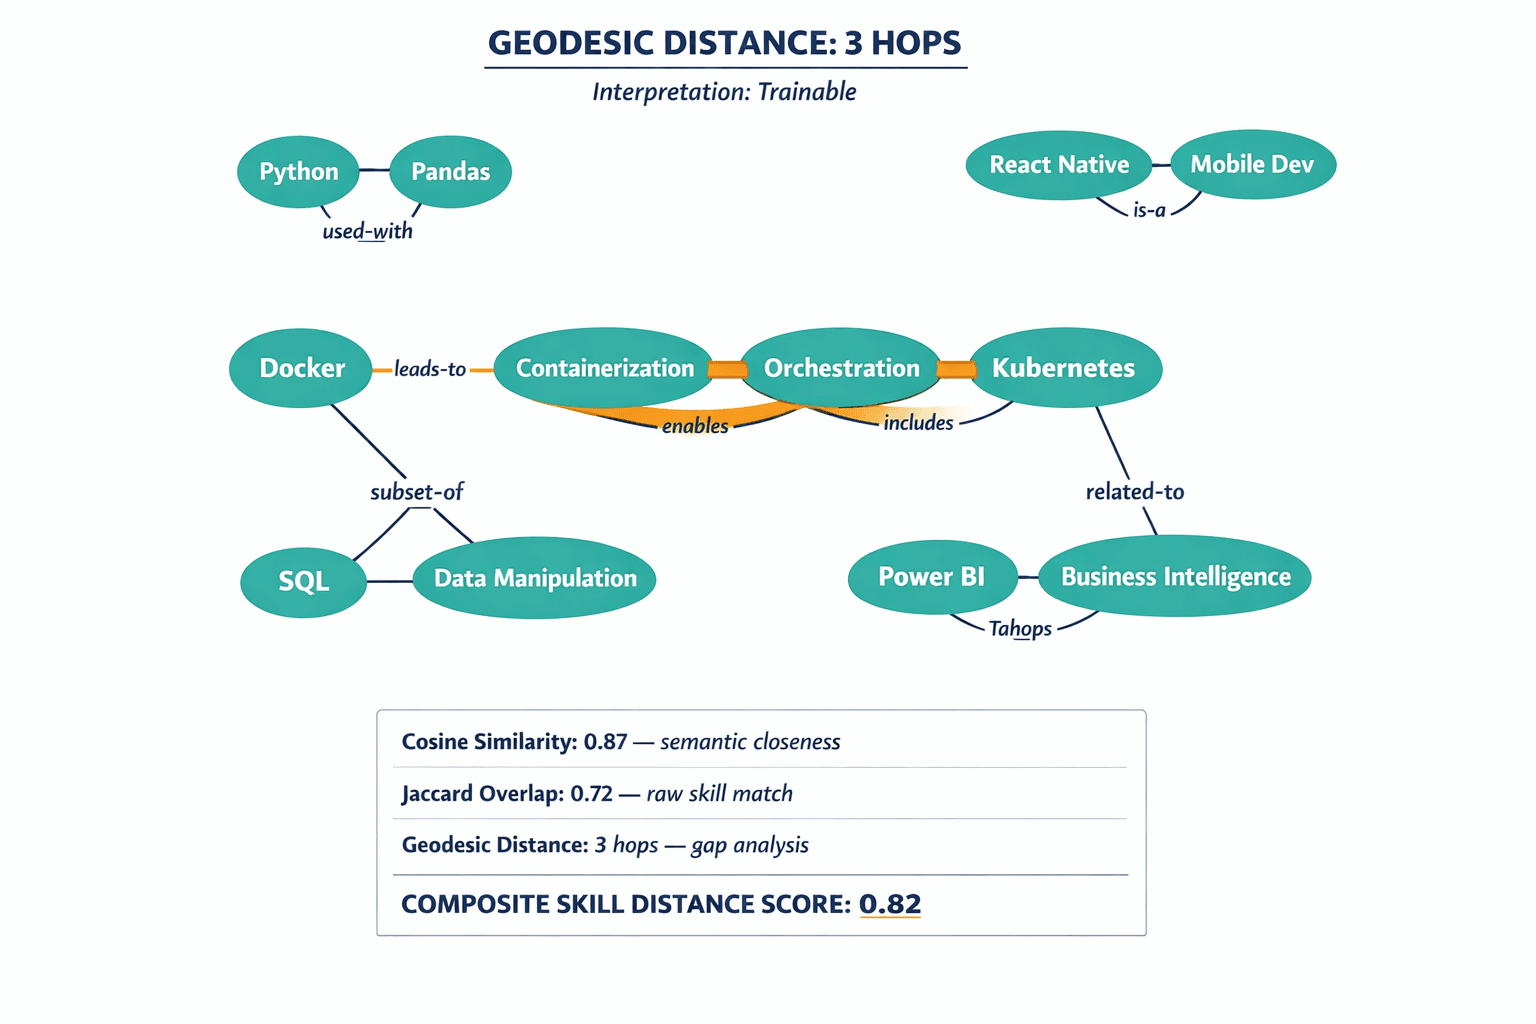
我們使用圖嵌入——像 Node2Vec 這樣的演算法,會為我們本體論中的每一項技能學習出一個向量表示。在圖譜中頻繁共同出現的技能(例如「Python」和「Pandas」)最終會在向量空間中彼此靠近。互不相關的技能(例如「Python」和「Phlebotomy(靜脈採血)」)最終則會相距甚遠。
為候選人評分時,我們計算餘弦相似度,即候選人的技能向量集與職缺的要求向量集之間的相似度。這讓我們能給予部分分數。一位缺乏「Tableau」但擁有「Power BI」的候選人會得到很高的相似度分數,因為在「商業智慧」叢集中,這些節點是語義上的近鄰。而關鍵字搜尋會給他們零分。
我們再疊上Jaccard 相似度以衡量原始的技能重疊程度,並疊上測地距離——即穿越圖譜的最短路徑計算——用於差距分析。如果一份職缺要求 Kubernetes,而候選人擁有 Docker,圖譜會找到這條路徑:Docker → Containerization(容器化)→ Orchestration(編排)→ Kubernetes。距離:3 跳。詮釋:可培訓。如果距離是 6 跳以上,那就是一道難以彌補的差距。
最終的技能距離分數是一項純粹基於能力的指標,完全對人口統計特徵視而不見。我們不去猜測誰比較優秀。我們衡量的是他們與要求有多接近。
關於這些演算法的完整技術拆解——包括餘弦相似度背後的數學以及我們的複合評分模型——請參見我們的研究論文。
「缺少 SQL」的那一刻
讓我用測試期間發生的一件事把這件事講具體。
我們把同一份候選人檔案同時跑過一個標準的黑箱招聘工具與我們的系統。黑箱拒絕了這位候選人。沒有給出任何理由。(我們後來判定這位候選人念的是一所規模小、名氣不大的學院——一種典型的出身懲罰。)
而我們的系統回傳了這樣的內容:「候選人缺乏明確的 SQL 經驗。然而圖譜分析顯示其在 Pandas DataFrames 與 R dplyr 方面有大量經驗。DataFrames 與 SQL 之間的圖距離很短(共享概念:資料操作)。建議:面試。高度可遷移。」
那位候選人——那位被黑箱丟棄的人——具備這份職缺所需的每一項技能。他們只是用了不同的字眼來表達。而且他們念的那所學校,黑箱在其訓練資料中見得不夠多,因而不把它視為「成功」的來源。
這就是我說知識圖譜能擴大人才庫時的意思。它們能找到那些具備能力、卻沒有相應出身或精確詞彙的人。而這自然而然地改善了多樣性——不是透過配額或調整,而是透過更好的衡量。
當系統標記出一個問題時,會發生什麼事?
有人問我:「萬一你的系統仍然產生帶偏見的結果呢?」這是個合理的問題,而任何聲稱自家系統完美無瑕的人,我都會對他起疑心。
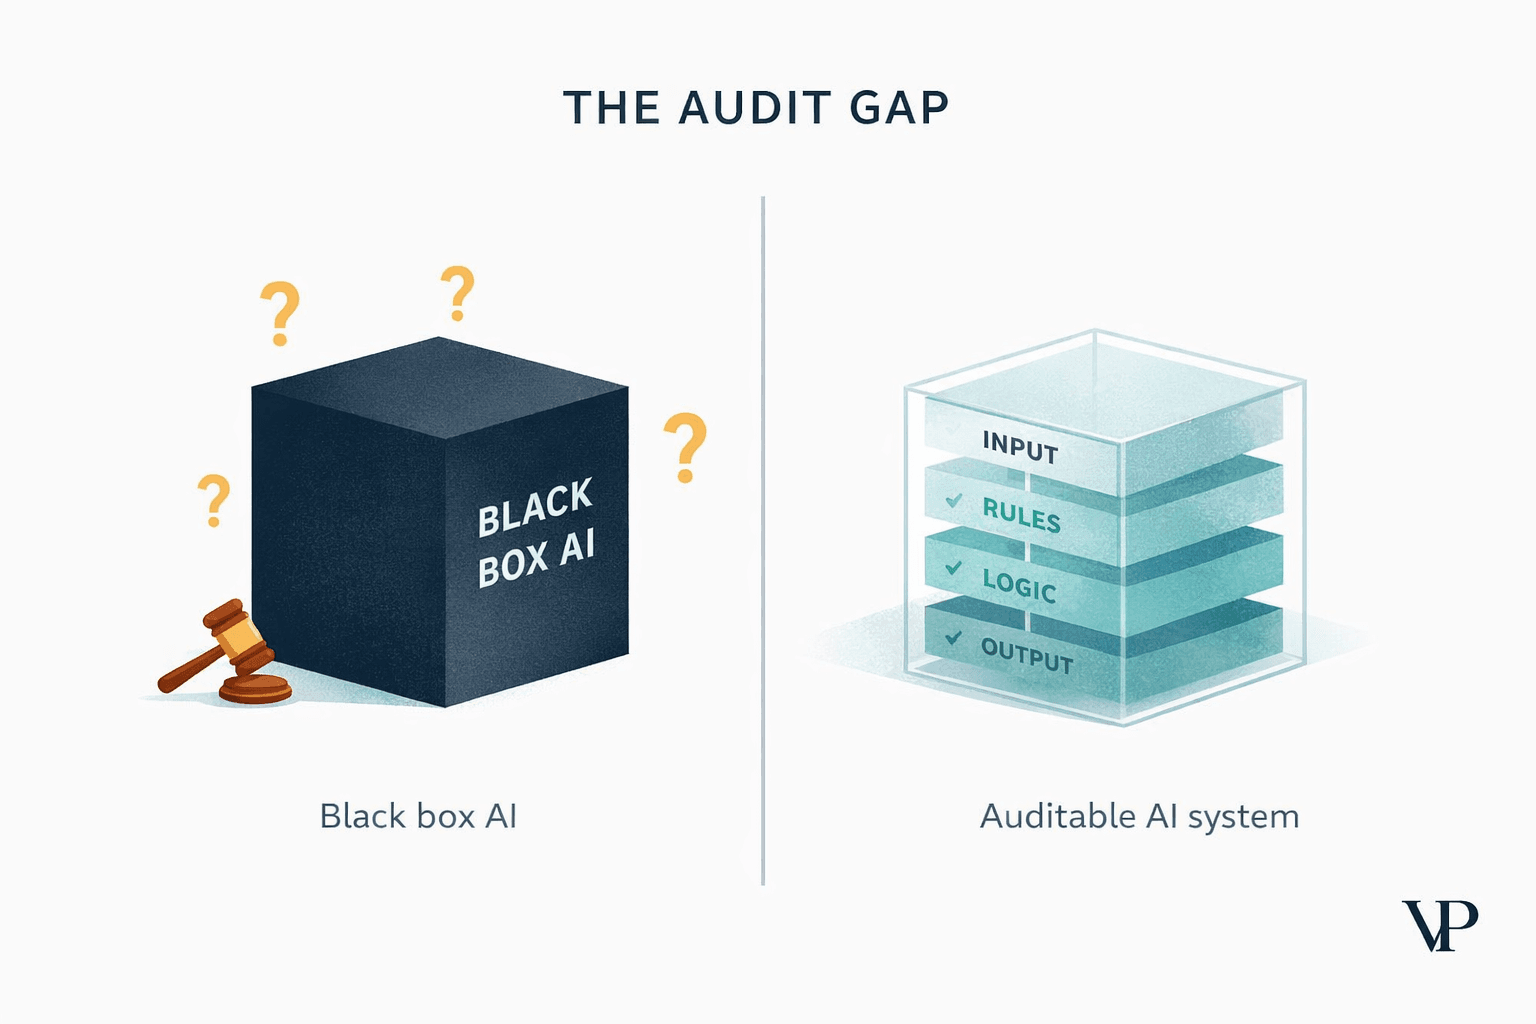
差別在這裡:當一個黑箱產生帶偏見的結果時,你就卡住了。你能在數字中看到差別性衝擊,卻看不見為什麼。是那些大學的名字嗎?是郵遞區號嗎?是寫作風格嗎?你是在對一套擁有數百萬個參數、卻毫無可讀邏輯的系統進行除錯。
當我們的系統產生一個統計異常時——比方說,某個特定人口群體的衝擊比率低於 0.8——我們能夠追溯它。我們能夠指認出造成這項差異的特定圖譜節點。也許某份職缺描述要求一張與社經地位相關、昂貴的特定證照。我們能看見這一點、把它標記出來,然後招聘團隊就能決定那張證照究竟是真的必要,還是只是一個沒人質疑過的遺留要求。
玻璃箱並不表示系統永遠正確。它表示的是:當系統出錯時,你能夠查明原因並加以修正。
LLM 仍然有一份工作——只不過不是那份重要的
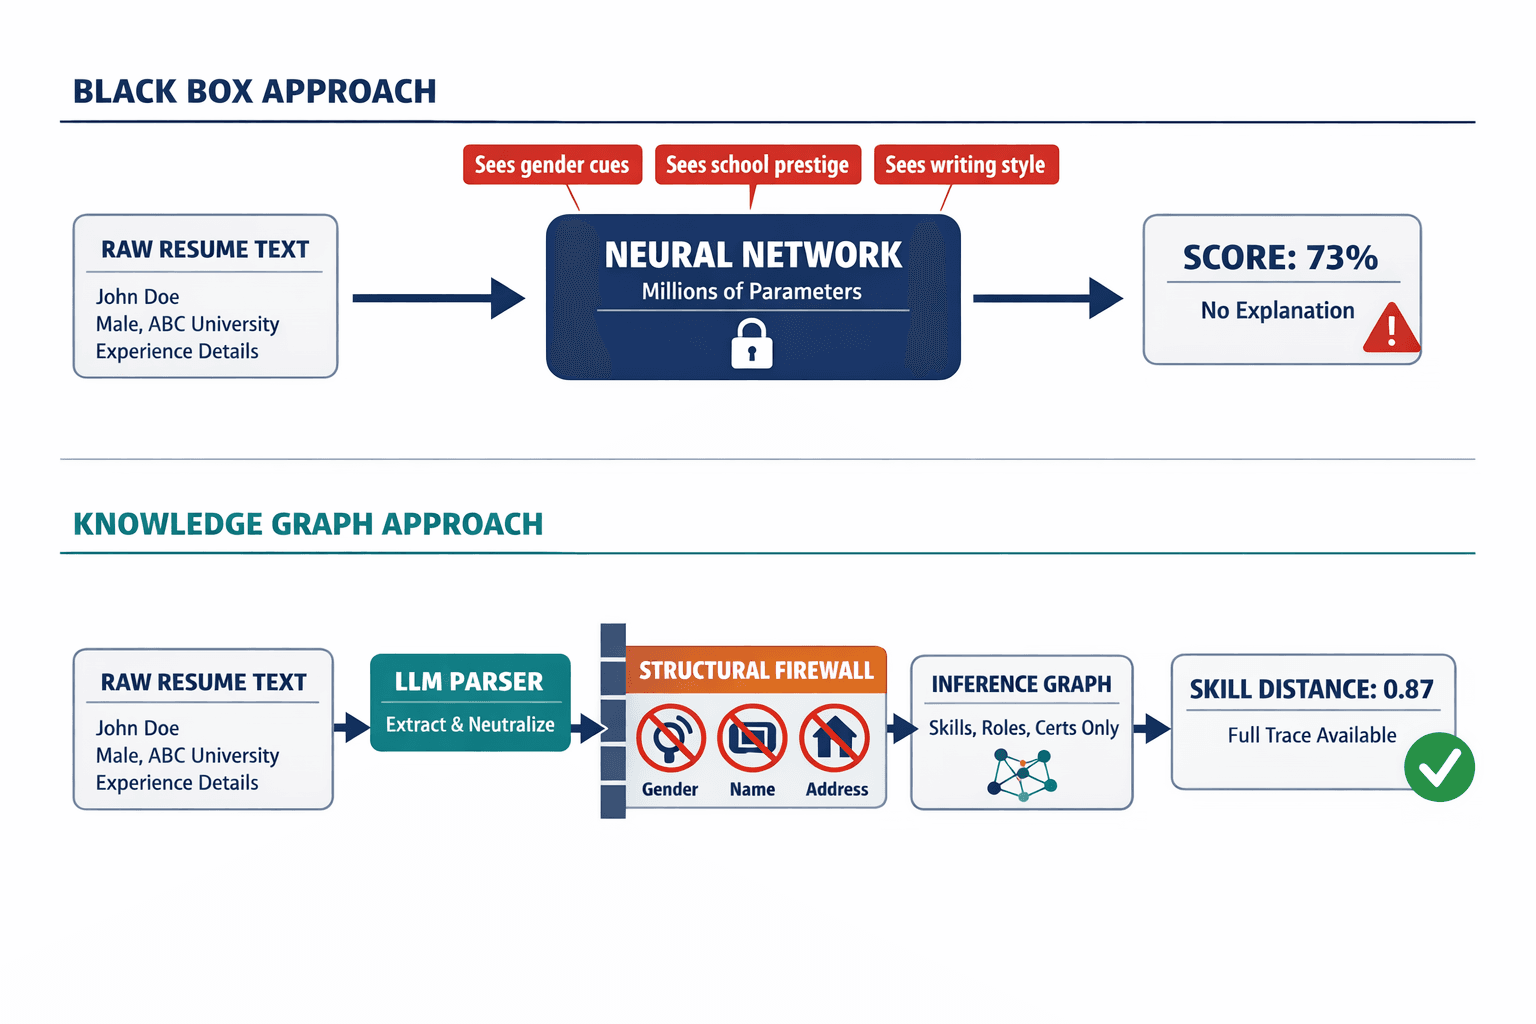
我要把話講清楚:我們確實使用 LLM。我們不是盧德分子。但我們使用它們的方式,就像你使用一位翻譯者——用於讀與寫,而不是用於評判。
我們的架構強制執行嚴格的關注點分離。LLM 負責感知:它讀取非結構化的履歷文字並萃取實體。「我統籌了一支 5 人的開發團隊來打造一個 React Native 應用程式」會變成結構化資料——Skill: React Native、Skill: Team Leadership、Context: Mobile Development。LLM 會正規化同義詞:「ReactJS」和「React.js」都對映到同一個節點。
但 LLM 從不做出僱傭決策。所有的匹配、評分與排序,都是透過確定性的圖譜遍歷來進行。相同的圖譜加上相同的查詢,每一次都等於相同的結果。我們在輸出端也會用到 LLM——它會生成人類可讀的解釋,但只根據圖譜已驗證的事實。它無法幻想出一個圖譜並不支持的技能匹配。
我把它想成:LLM 是系統的眼睛和嘴巴,而知識圖譜才是大腦。你不會讓你的嘴巴替你做決定。(好吧,我們大多數人不會。)
我們真正要在什麼之間做選擇?
在我看來,這個產業正處於一個岔路口。一條路通往更大的模型、更多的參數、更多的不透明——以及一場與偏見沒完沒了的打地鼠遊戲,而偏見總能找到新的代理變數來利用。另一條路則通往結構化推理、語義衡量,以及能夠向監管機構、招聘者或被拒絕的候選人解釋自己的系統。
我跟一些仍在使用黑箱篩選工具的公司的 HR 主管談過。他們知道風險。他們讀過關於 Amazon 的報導。但更換架構感覺既昂貴又充滿不確定性,於是他們持續打補丁。他們在根本上就帶偏見的系統之上,加上「偏見緩解層」。他們聘請顧問來執行每年一次的稽核,這些稽核告訴他們哪裡壞了,卻不給他們修好的工具。
資料是一面鏡子。如果你用過去去訓練一個模型,你就會複製過去。在一個努力追求公平的世界裡,複製過去就是一種失敗狀態。
我不打算以模棱兩可的話作結。我花了好幾年打造這套系統,我親眼見過另一種取徑慘烈地失敗,而我對這個結論很有信心:招聘 AI 的未來,不在於根據過去誰成功來預測誰將會成功。它在於衡量一個人能做到的與一份職缺所要求的之間的實際距離——並讓那項衡量透明、確定,且在結構上就無法歧視。
你可以繼續預測過去。或者,你可以開始衡量未來。