我親眼看著一部 55 年前的法律撼動整個 AI 招聘產業——而這早該發生

2026 年 1 月 Eightfold AI 訴訟案的消息傳出時,我正與一位潛在客戶通話——一家中型金融服務公司。人力資源主管話說到一半,正在解釋他們如何使用某家 AI 供應商的「人才智慧」平台,每季篩選數千名求職者。她停頓了下來。她的法律顧問一直默默地從 Zoom 網格的角落觀察,此時取消了靜音:「你能把你手上關於那件 Eightfold 案子的所有資料都寄給我嗎?」
通話提早十五分鐘結束了。
那一刻讓我多年來在 Veriprajna 一直主張的某件事變得清晰起來:企業 AI 招聘市場建立在令人瞠目結舌的架構疏失基礎之上,有人被告只是遲早的事——被告的原因並非帶有偏見的結果——那場仗早已在打——而是某種更根本的東西。是因為那種暗中側寫他人、再利用這些側寫來決定他人經濟前途的行為。
Eightfold AI 集體訴訟案,即Kistler 訴 Eightfold AI 案,正是這樣一件訴訟。而它援引的並非什麼尖端的 AI 法規。它回溯到了 1970 年——回到《公平信用報告法》——並主張一家對 15 億人生成隱藏「匹配分數」的 AI 公司,從法律角度來說,與 Equifax 並無二致。
我認為原告是對的。而且我認為其影響遠遠超出一家公司的範圍。
Eightfold 究竟發生了什麼事?
以下是簡短版本,因為細節很重要。
兩位經驗豐富的專業人士——Erin Kistler,一位擁有近二十年經驗的產品經理,以及 Sruti Bhaumik,一位有十餘年資歷的專案經理——分別應徵了 PayPal 和 Microsoft 的職位。兩人都迅速收到了自動化的拒絕通知。沒有人被告知有一套 AI 系統對他們生成了一個秘密分數。沒有人被展示是哪些資料餵養了那個分數。也沒有人被賦予提出異議的途徑。
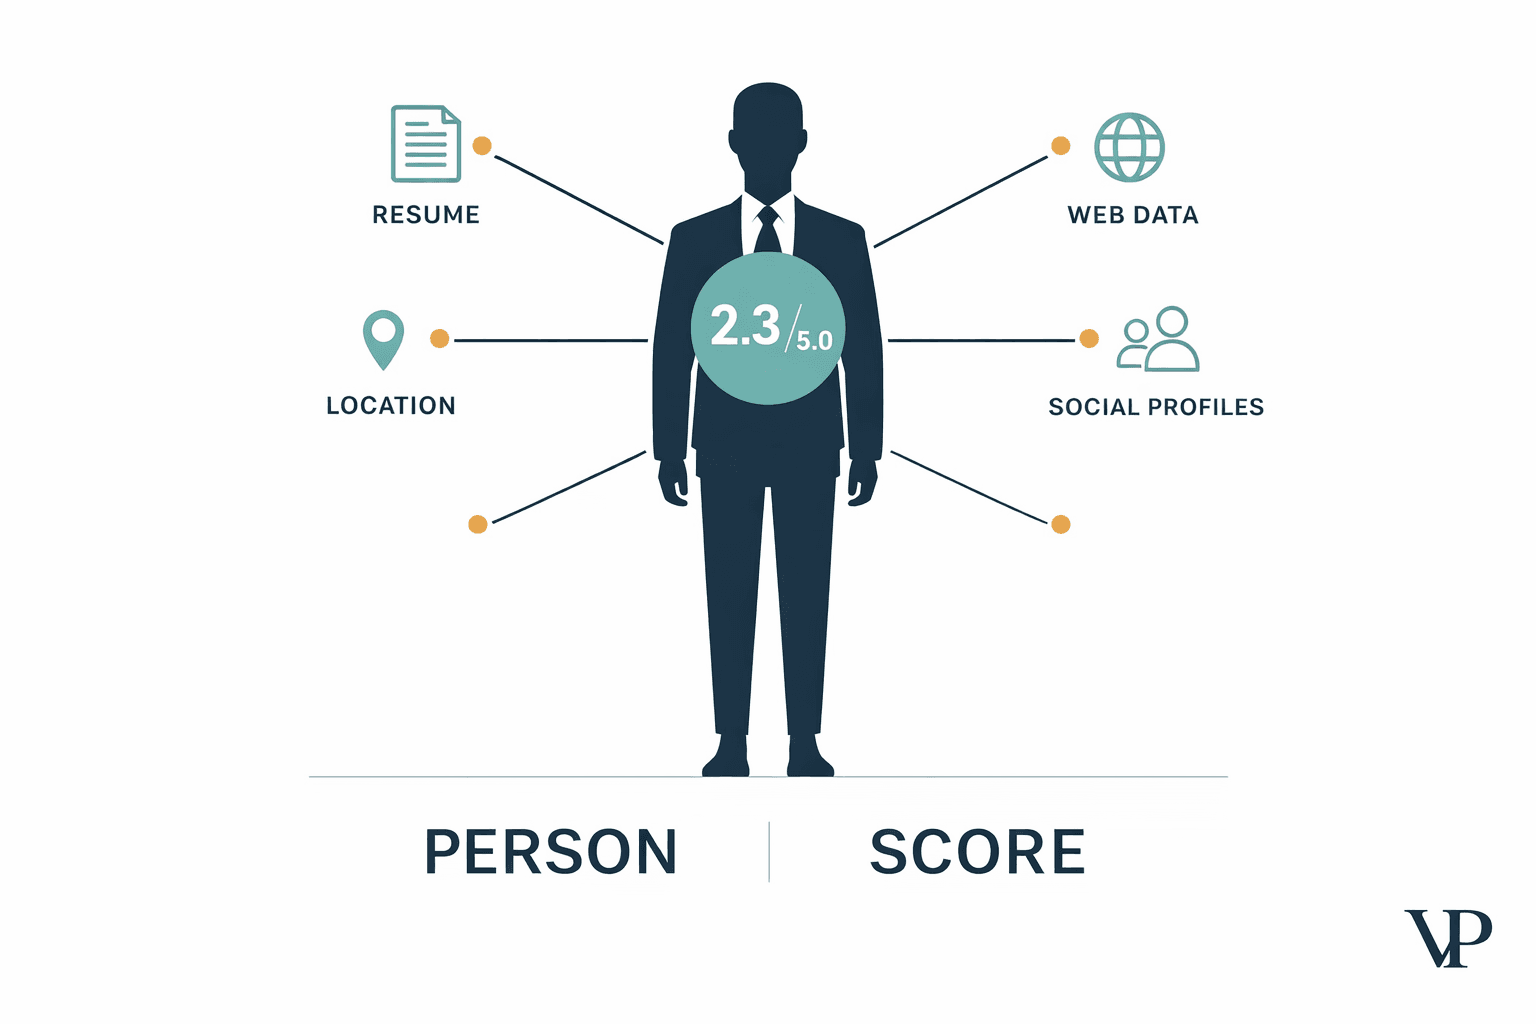
訴訟指控 Eightfold 的平台不只是分析你提交的履歷。它據稱還從 LinkedIn、GitHub、Crunchbase 及其他公開來源收集資料——建立起訴狀所稱的「秘密檔案」——然後運用深度學習生成一個 0 到 5 的「匹配分數」,來預測你的「成功可能性」。像 Morgan Stanley、Starbucks、BNY 和 PayPal 這樣的公司,在真人招聘人員看過任何一份申請之前,就用這些分數來篩選候選人。
Eightfold 否認了這些指控,聲稱其平台完全只依據候選人提交或客戶提供的資料運作。但起訴狀描繪出一幅不同的圖景:在這幅圖景中,你的數位足跡——你的瀏覽行為、你的位置資料、你的網路活動——被吸取上來,轉化成一份對你就業能力的機率性裁決。
當一套 AI 系統生成一個決定你能否獲得工作面試的分數,而你卻從不知道這個分數存在時,那不是「人才智慧」。那是帶有經濟後果的監控。
我想精確說明為什麼這件案子比以往的 AI 招聘訴訟更重要。Mobley 訴 Workday 案聚焦於演算法歧視——即 AI 產生帶有偏見的結果。那是第一道問責缺口。而 Eightfold 案針對的是更深層的東西:第二道問責缺口,這關乎資料收集、評分機制與候選人自主權方面的透明度。它問的不只是「這個分數公平嗎?」它問的是「你到底有沒有權利對我評分?」
為什麼原告要搬出一部有 55 年歷史的法律?
這正是身為工程師的我最著迷的部分。
FCRA——《公平信用報告法》——於 1970 年制定,用以規範信用機構。它的核心意思是:如果你是第三方,生成關於他人的報告,而這些報告被用來對他們的就業、信用或住房做出決定,那麼這些人就享有權利。有權知道報告的存在。有權查看它。有權對錯誤提出異議。
在Kistler 訴 Eightfold 案中的法律論理十分精妙:如果 Eightfold 基於收集來的資料生成匹配分數,而這些分數被雇主用來篩選候選人,那麼 Eightfold 就是在充當一家消費者報告機構。就是這樣。而它評過分的每一位候選人,本都有權獲得揭露、查閱及提出異議的權利,卻從未得到過。
我記得讀完完整起訴狀後,某天深夜我和我的共同創辦人坐在一起,他說了一句讓我一直記著的話:「他們不需要一部新法律。舊法律早已被這種新行為打破了。」
正是如此。FCRA 並非為 AI 而設計。但它當初旨在規範的行為——第三方暗中彙編出決定你經濟機會的側寫檔案——正是起訴狀指控 Eightfold 大規模所為之事。技術變了,傷害沒變。
如果法院認同這套論理,那麼每一家對候選人評分的 AI 供應商,都將面臨與傳統背景調查公司相同的合規義務。而使用這些工具的企業呢?它們無法躲在供應商背後。責任會向上流動。
我們是怎麼走到這一步的?那個沒人願意談論的架構問題
過去這幾年,我一直在 Veriprajna 打造我們所謂的「深度 AI 解決方案」,而我這份工作最令人沮喪的部分,就是要解釋為什麼主流的企業 AI 做法在結構上根本無法通過法律的審視。並非因為模型不好。而是因為架構是疏失的。
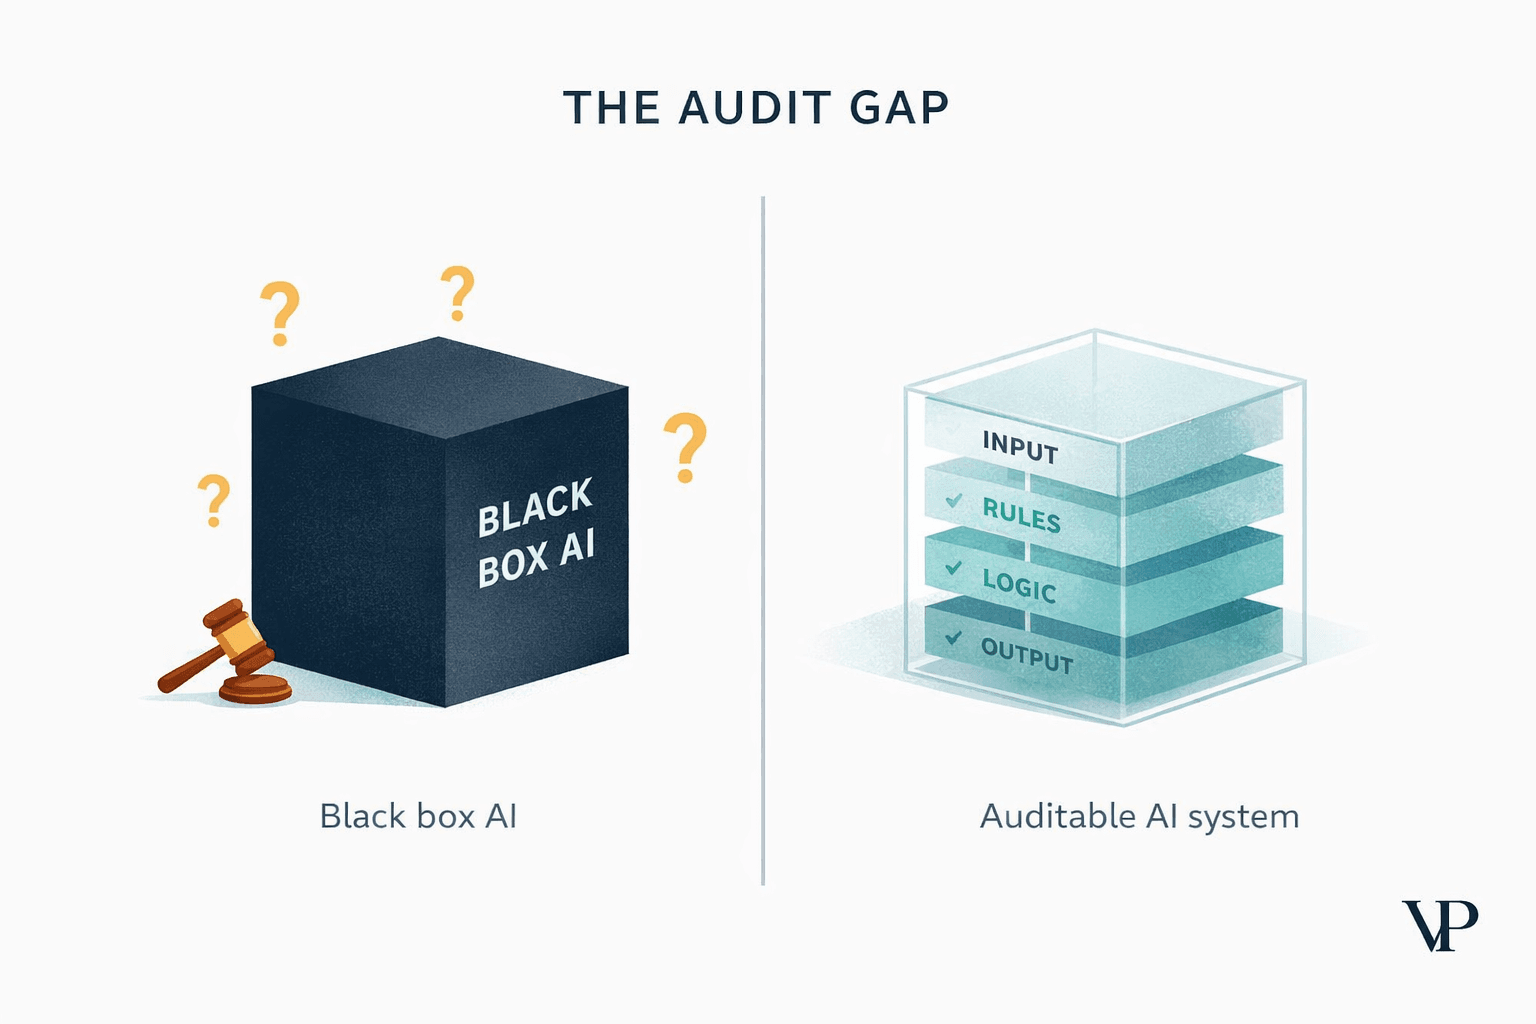
大多數 AI 招聘工具——我在這裡並不是單指 Eightfold,這是整個產業的通病——都建立在我所稱的「巨型提示」模式之上。你拿一份履歷、一份職位描述,或許再加上一些爬取來的 LinkedIn 資料,把這一切全部塞進一個龐大的提示裡,發送給 GPT-4 或類似的模型,然後期望輸出是合理的。這套系統「期望」——我刻意使用這個詞——模型能在一次處理中完成篩選、排序並為其決定辯護。
我在我們的互動式白皮書中深入寫過這場架構危機,但核心問題很簡單:巨型提示無法證明它為什麼做出了它所做的事。
當一位候選人問「我為什麼被拒絕?」時,系統無法回答。並非因為它在隱瞞什麼,而是因為它確實不知道。其推理過程是非確定性的。把同一個提示跑兩次,你可能得到不同的結果。改動職位描述裡的一個字,排名就會重新洗牌。沒有稽核軌跡,沒有逐步日誌,也無法驗證某個被禁止使用的資料點——比如候選人的郵遞區號充當種族的代理變數——是否影響了結果。
招聘中黑箱 AI 的問題並不在於它可能帶有偏見。而在於你永遠無法證明它沒有。
2025 年初,我曾就此與一位投資人激烈爭論。他看過我們的架構圖——多代理協調、合規代理、來源追蹤——然後說:「這過度工程化了。就用 GPT 配一個好提示。快點出貨。」我告訴他,更快出貨衝進一場訴訟裡並不是一種商業策略。他沒有投資。我不後悔那次對話。
2026 年的監管格局實際上是什麼樣子?
Eightfold 訴訟案並非孤立地發生。它是一波自 2023 年以來不斷積聚的監管浪潮中最鋒利的一刃,而如果你在招聘中部署 AI——在美國的任何地方——你現在就得在一片州級法律的拼布中穿行,這些法律共同終結了「快速行動、打破陳規」的時代。
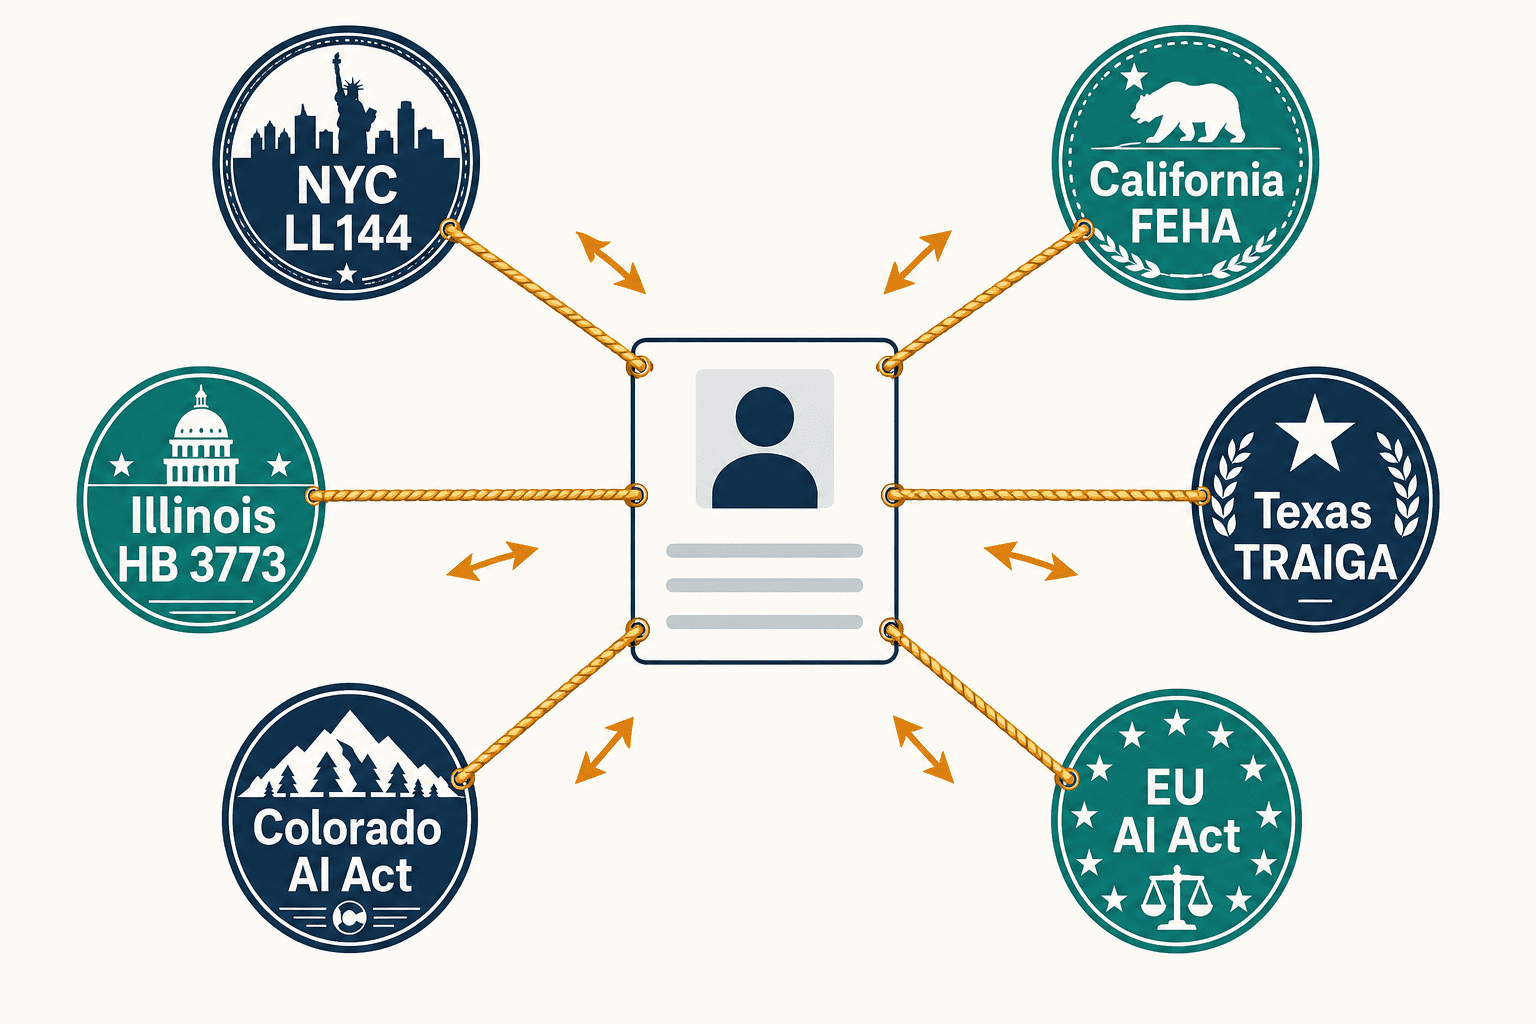
自 2023 年起,紐約市的《地方法第 144 號》就要求對自動化就業決策工具進行年度獨立偏見稽核。伊利諾伊州的 HB 3773 法案於 2026 年 1 月生效,禁止「具有」歧視「效果」的 AI——請注意其用詞,是效果,而非意圖——並要求向申請人發出「易於理解」的告知。加州的新法規對差別性影響課以責任,無論意圖為何,並要求保存四年的記錄。科羅拉多州的《AI 法案》將於 2026 年 6 月生效,設立了防範演算法歧視的法定「注意義務」。
實務上的結果是:如果你是一家跨多州招聘的《財星》500 大企業,你就需要你的 AI 系統依候選人所在地的不同而有不同的行為。位於伊利諾伊州的申請人觸發的揭露要求,與位於德州的申請人不同。在紐約市的一次拒絕,需要一份在佛羅里達州不會被要求的書面文件。
沒有任何巨型提示能處理這一切。你需要架構。
「深度 AI」對招聘究竟意味著什麼?
當我和我的團隊談論深度 AI 解決方案時——相對於那種「外殼包裝」的做法——我們所描述的,是一種根本不同的、用來建構那些對人們生活做出重大決定的系統的方式。
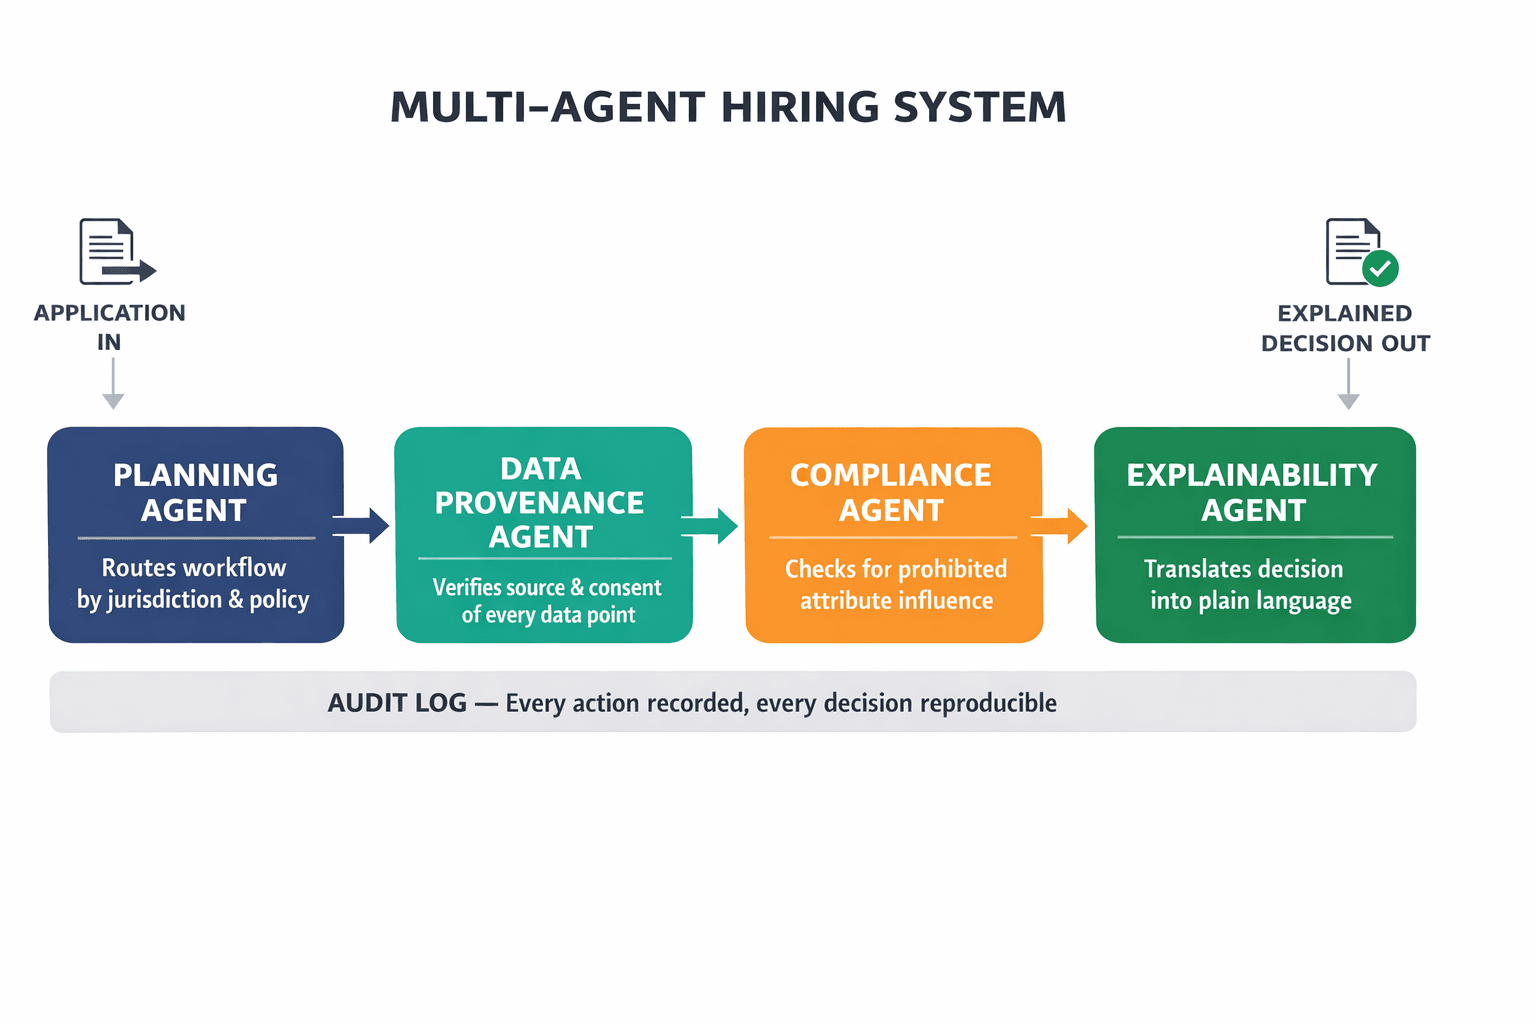
我們不用一個包辦一切的單體模型,而是採用所謂的專門化多代理系統。與其把它想成一位天才在做決定,不如把它想成一支由專家組成的團隊,每位專家都有明確界定的角色和一份書面記錄。
有一個規劃代理,它接收申請並根據現行法律和公司政策確定所需的工作流程。如果申請人位於伊利諾伊州,它會確保強制性的揭露步驟在任何篩選開始之前執行。有一個資料來源代理,它驗證每個資料點的來歷——它區分候選人提交的資料與從外部來源推斷出的資料,並標記後者,使其永遠無法悄悄影響最終排名。有一個合規代理,它在任何分數敲定之前審查流程日誌,檢查是否有被禁止的屬性影響了結果。還有一個可解釋性代理,它把技術性的決定翻譯成招聘人員和候選人雙方都能懂的白話。
每個代理都記錄每一個動作。每一個決定都可重現。這套系統能在數月之後,準確地告訴你為什麼候選人 A 的排名高於候選人 B,哪些資料點起了作用,以及是否有真人審查者確認或推翻了該建議。
我記得我們第一次在一個真實的招聘情境上對這套架構進行完整的端到端測試時——200 名合成候選人、三個司法管轄區、兩類職位。我們花了四十五分鐘才走完單一候選人的稽核軌跡。我的首席工程師看著我說:「這太瘋狂了。沒有人會想要這種程度的細節。」我說:「法官會。」
為什麼不能直接為現有的黑箱加上可解釋性?
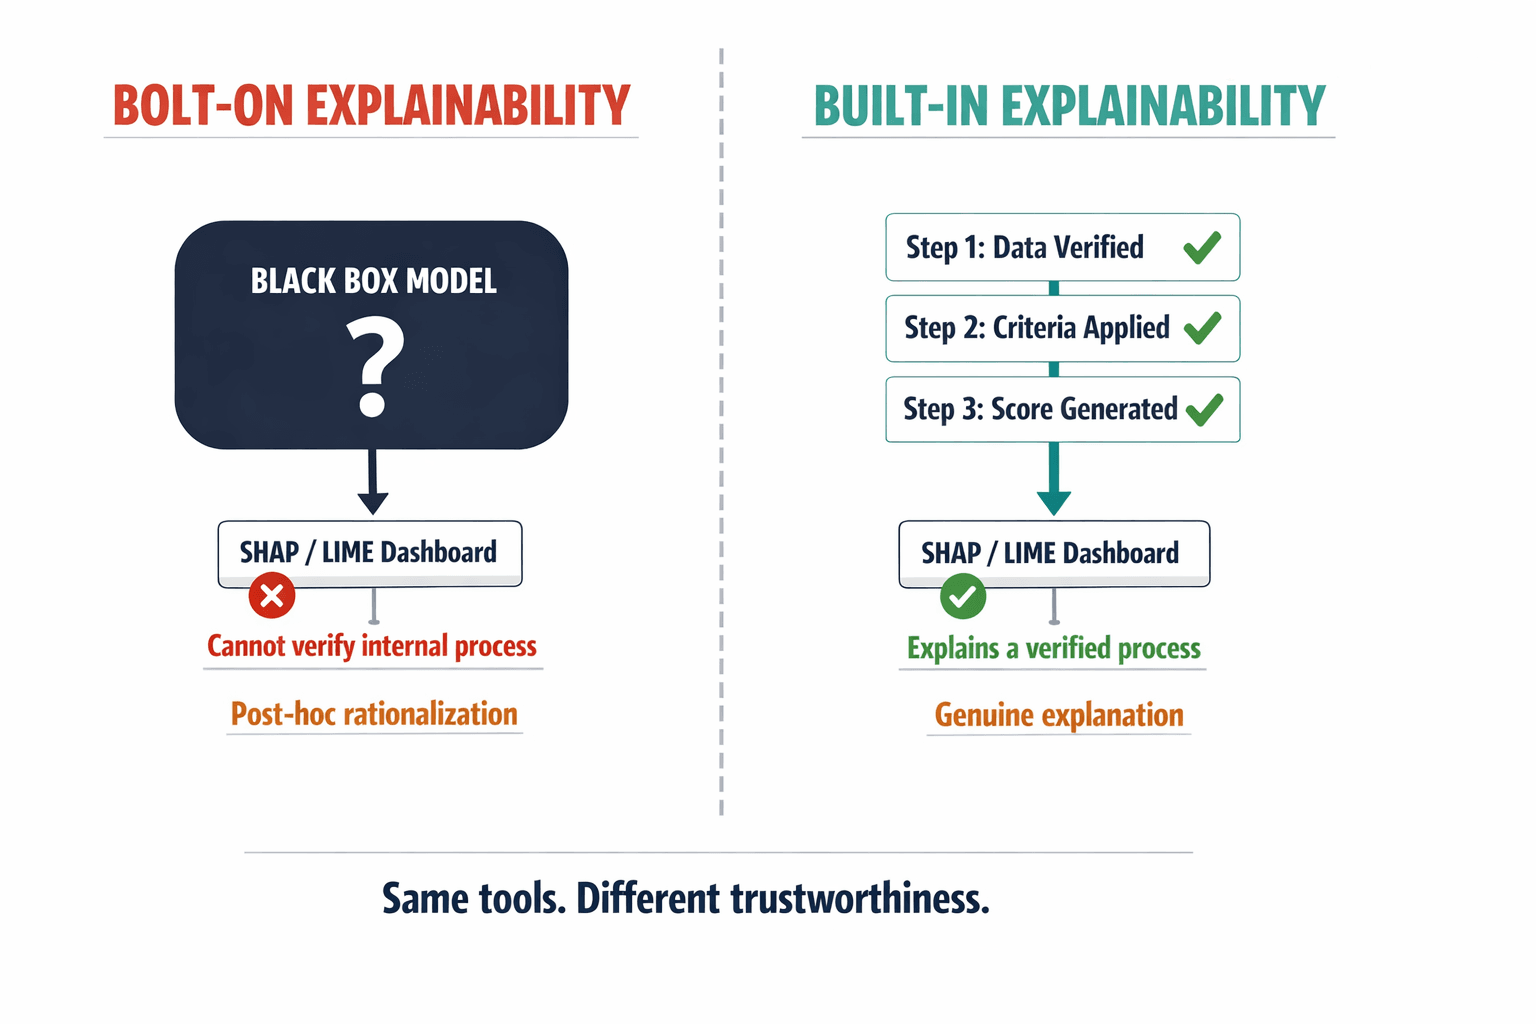
這是我最常被問到的問題,而它揭示了一個常見的誤解。人們以為可解釋性是一項事後可以外掛上去的功能——就像給現有系統加上一個儀表板。它不是。或者說,它可以是,但你得到的會是一種事後合理化,而非真正的解釋。
像 SHAP(Shapley 加法解釋)和 LIME(局部可解釋、與模型無關的解釋)這樣的技術是強大的工具。SHAP 植根於合作賽局理論,能以數學方式告訴你每個特徵——工作年資、特定證照、程式語言——對候選人分數貢獻了多少。LIME 能在單一候選人周圍局部近似模型的行為,以解釋某次特定的拒絕。反事實解釋能告訴候選人:「如果你有證照 X,你的分數本會提高這麼多。」
我們把這些全都整合進了我們的生產流程。但這裡有一個關鍵的區別:唯有當底層架構可稽核時,這些技術才是值得信賴的。如果模型的推理過程是非確定性的——如果它可能把候選人的所在地當作某種其他因素的代理變數,而你無法證明它沒有——那麼你的 SHAP 值所解釋的,就是一個你並未完全掌控的過程。
缺乏架構完整性的可解釋性,只不過是一種更精緻地說「相信我」的方式。
Eightfold 訴訟案讓這一點變得具體。即使 Eightfold 能夠回溯性地為每一個匹配分數生成 SHAP 值,起訴狀依然成立——因為根本問題在於,候選人從未被告知這些分數存在,從未被展示餵養它們的資料,也從未被賦予對錯誤提出異議的機制。可解釋性是必要的,但並不充分。你需要架構從根本上支持揭露、查閱和異議。
關於這些可解釋性技術如何與多代理治理架構整合的完整技術剖析,請參閱我們的研究論文。
那個沒人想解決的資料來源問題
Eightfold 起訴狀中有一部分,我一直反覆回想。那項指控稱該平台從 LinkedIn、GitHub 及其他來源收集資料,以建立關於那些從未同意被側寫者的檔案。
無論那項具體指控在法庭上是否被證實為真,它都指向一個真實而普遍的問題:大多數企業 AI 系統對其訓練和推論資料並沒有嚴謹的保管鏈。它們無法告訴你某個資料點來自何處、何時被收集、當事人是否同意,或它自被納入以來是否被修改過。
在 Veriprajna,我們把資料來源——也就是資料起源、流動與轉換的書面記錄軌跡——視為一項不容妥協的基礎設施要求。每一個進入我們系統的資料點,都會被標記其來源、收集方法及同意狀態。候選人提交的資料,與從外部來源推斷出的資料,會被區別對待。密碼學雜湊確保一旦履歷被納入,任何未經授權的修改都可被偵測到。
這聽起來像是最基本的門檻。它本應如此。但我和數十家企業 AI 供應商談過,他們大多數的誠實答案是,他們無法確切地將某個特定資料點追溯回其源頭。他們是為速度和規模而打造的。來源追蹤是事後才想到的——如果有想到的話。
2026 年的監管環境讓這一點變得難以為繼。加州的新法規要求平台偵測並揭露內容是否曾被生成式 AI 大幅更改。科羅拉多州的《AI 法案》要求提供書面的風險評估。而 FCRA,若適用於 AI 評分平台,則要求當事人能夠查看並對用於他們身上的資料提出異議。如果你不知道你的資料從何而來,你就無法遵守其中的任何一項。
企業現在該做什麼?
人們總是問我,他們是否該為自己目前的 AI 招聘工具感到恐慌。我不認為恐慌有什麼建設性,但我確實認為緊迫感是有必要的。以下是我告訴他們的話。
首先,弄清楚你實際上在用什麼。對你招聘流程中的每一項 AI 工具進行徹底的盤點。不要因為供應商把某個工具行銷為「人才智慧」或「預測分析」,就假設它不是「AI」。如果它生成影響招聘決定的分數、排名或建議,那它就是一項自動化就業決策工具,並受制於正在興起的監管框架。
其次,盤問你的供應商。問他們:你們使用哪些資料來源?你們是否從候選人的申請之外抓取資訊?你們是否生成分數或排名?你們能否為某位特定候選人的評估提供一份稽核軌跡?你們能否對某位候選人為何被評成那樣,提供一份白話的解釋?如果他們無法清楚地回答這些問題,那就是你的答案了。
第三——而這是需要真正投入的一項——開始把 AI 的建議當作輸入,而非裁決。2026 年在法律上最站得住腳的立場,是這樣一種:由一位真人審查者看到 AI 的建議,將其與其他因素一併考量,並為最終決定書面記錄下自己的理由。這不只是良好的做法。在紐約市和伊利諾伊州這樣的司法管轄區,它可能很快就會成為一項法律要求。
不過,長遠之計在於架構。你需要那種從根本上為透明度、可稽核性和候選人自主權而打造的系統。而不是外掛了可解釋性儀表板的外殼包裝。也不是附加了合規檢查清單的巨型提示。而是每一個決定都能被追溯、解釋和提出異議的系統。
關於「AI 驅動招聘」那個令人不安的真相
我想以自那次與那家金融服務公司通話以來一直縈繞在我心頭的一件事作結。
AI 招聘產業兜售了一個誘人的故事:把你的求職者交給我們,我們會更快、更省、且比人類更少偏見地找出最優秀的那些人。而這個故事的某些部分是真的——AI 能處理任何人類團隊都無法匹敵的量,而設計良好的系統能發掘出那些原本可能被忽略的候選人。
但這個產業把那種能力建立在一條捷徑之上。它沒有去打造能夠解釋並捍衛其決定的系統,反而建造了產出便利數字的黑箱。它沒有尊重候選人的自主權,反而把求職者當成可被收集和評分的資料點。它沒有投入於合規與透明那種艱難的架構工作,反而出貨外殼包裝,並寄望沒有人會問出尖銳的問題。
有人問了尖銳的問題。其實是兩個人——Erin Kistler 和 Sruti Bhaumik——他們具備當事人資格與堅持不懈的毅力,提起了一場可能重塑整個產業的訴訟。
招聘中那個 AI 實驗毫無後果的時代已經結束。取而代之的將是什麼,取決於我們是選擇架構性的問責,還是只選擇更好的公關。
在 Veriprajna,我們以梵文詞「Prajna」——超越性的智慧——為公司命名。這是一個刻意的選擇。智慧不只是知道答案。而是知道你如何抵達那個答案,能夠展示你的推演過程,並願意就此接受質疑。這正是企業 AI 虧欠於它所評估的每一個人的東西。
理解這一點的公司,將打造出不僅更站得住腳、也更值得信賴、更有效、且——以一種重要的方式——更有人性的系統。而不理解這一點的公司,將繼續寄望沒有人要求查看那個分數。
總會有人要求的。