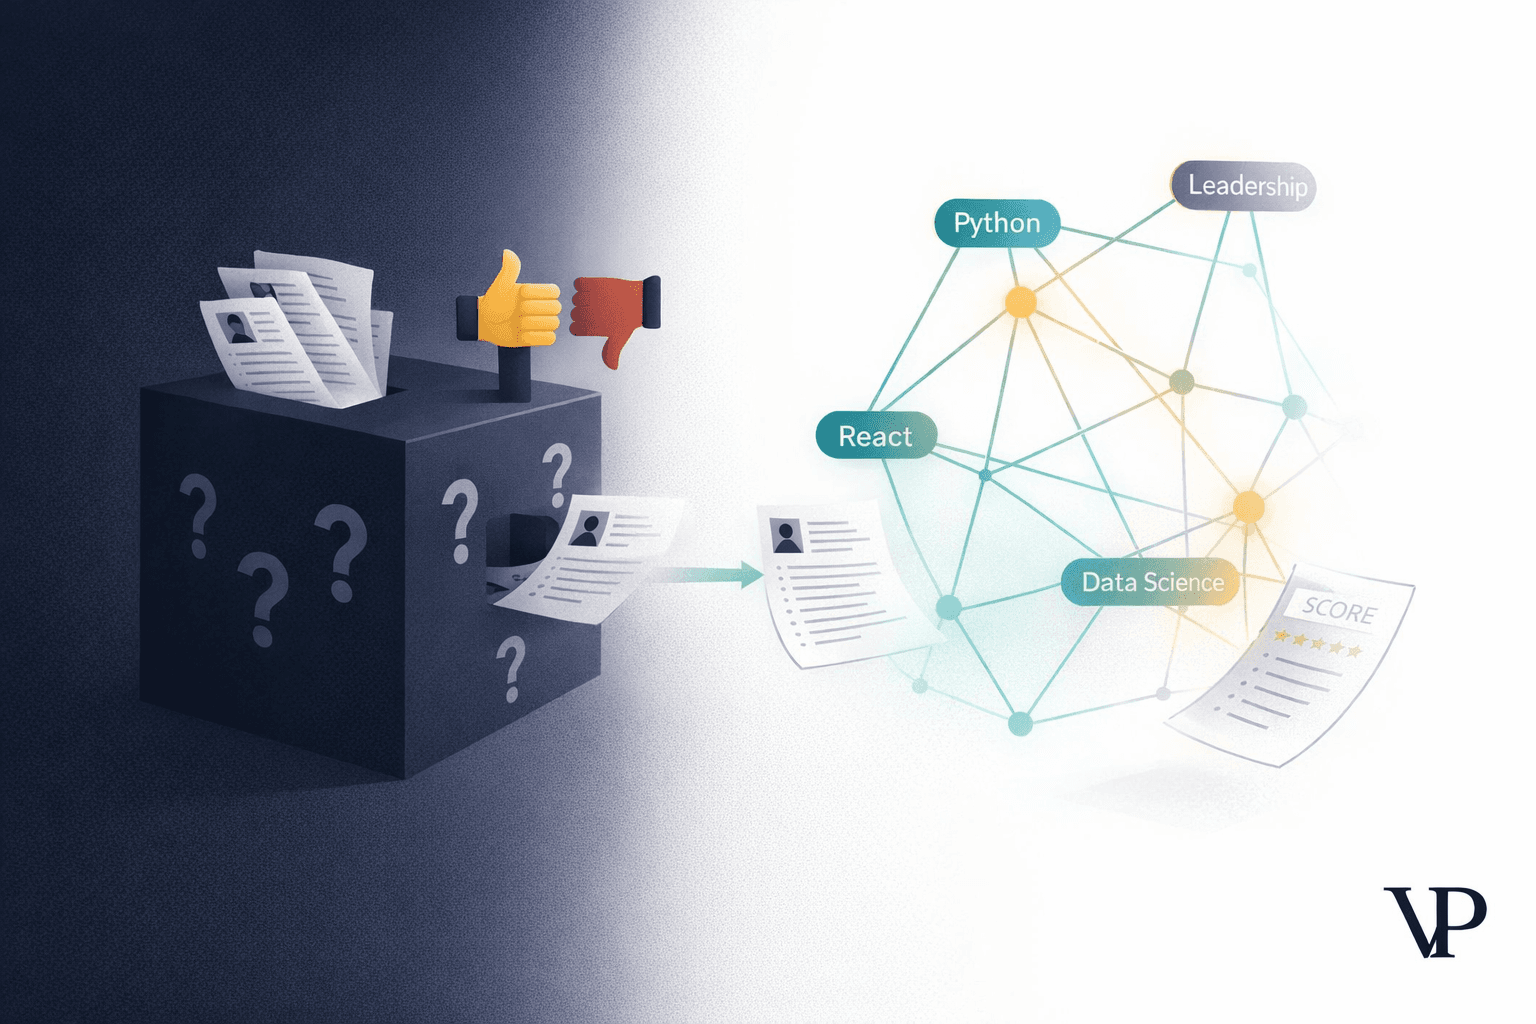
法院剛剛告訴數百萬求職者:你可能被軟體歧視了

去年,我坐在班加羅爾一家飯店的大廳裡,等一場遲遲未開始的會議,用手機滑著法律訴狀——就像一般人滑 Instagram 那樣——這時我讀到一段文字,讓我放下了手中的咖啡。
加州一位聯邦法官剛剛裁定,市值 700 億美元的人力資源軟體巨頭 Workday,可以作為一個代理人,在聯邦反歧視法下被追究責任。不是工具。不是中立的平台。而是一個代理人——與根據某人的年齡或種族淘汰履歷的人類招聘人員屬於同一法律類別。
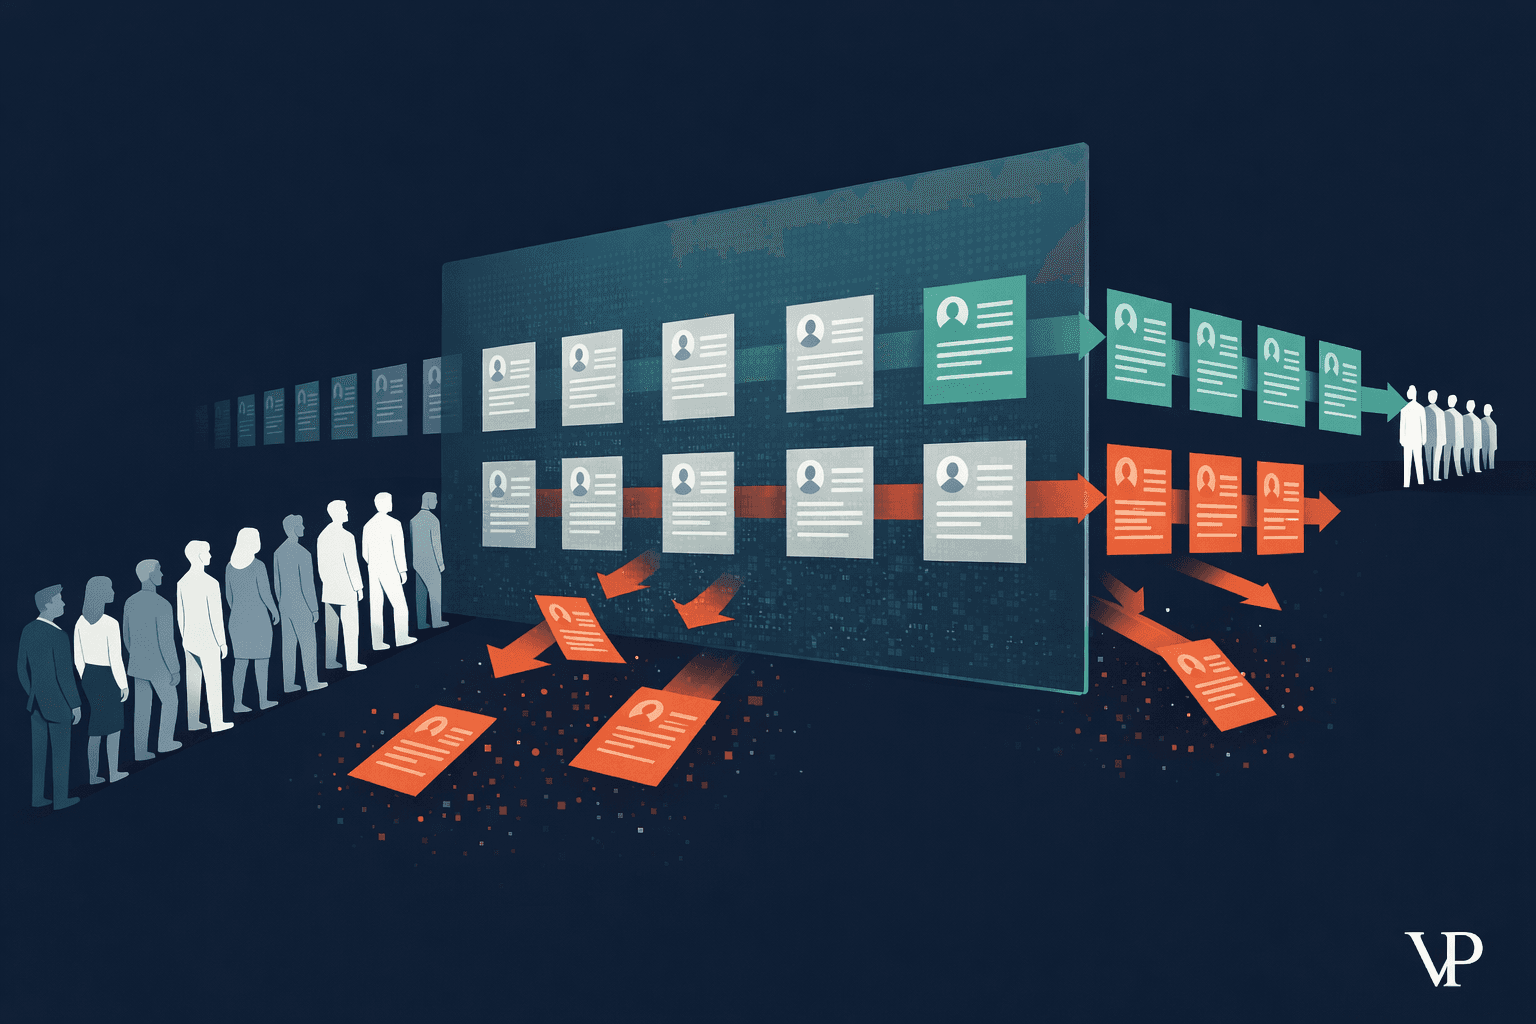
原告 Derek Mobley 是一名年過 40、患有殘疾的非裔美國男性,曾被 100 多份工作拒絕。其中許多拒絕在他投遞後幾分鐘內就發出,而且往往在下班時間之外。沒有任何人看過他的履歷。是軟體判定他不值得被考慮,而且一次又一次以演算法般的一致性做出這個判定。
我打造 AI 系統。我的公司 Veriprajna 為企業設計認知架構——那種深度、確定性的 AI,理應取代業界大多數人正在兜售的草率、機率性的捷徑。而當我讀到那項裁決時,我的第一個念頭並不是「這對 Workday 是壞消息」。而是:大多數 AI 招聘產業都建立在同樣腐朽的基礎之上,而幾乎沒有人在談論這件事。
11 億次拒絕,與一位注意到它的法官
讓我告訴你一個數字,當我把它分享給我的工程團隊時,讓整個房間都安靜了下來。
在 Workday 一案的相關期間,約有 11 億份求職申請被拒絕,都是透過 Workday 的軟體發生的。這不是打錯字。是十億等級——是 Billion(十億),不是 Million(百萬)。
2025 年 5 月,一家聯邦法院初步核准了一項全國性的集體訴訟,依據《就業年齡歧視法》(ADEA,Age Discrimination in Employment Act)主張年齡歧視。這意味著自 2020 年 9 月以來,每一位年過 40、透過 Workday 平台被拒絕就業推薦的人,都可能收到通知並加入本案。到了 2025 年 7 月,法院擴大了範圍,將透過 HiredScore(Workday 收購的一款 AI 招聘工具)處理的申請者也納入其中。
當軟體拒絕了十億份申請,而法院表示「那套軟體在法律上是你的代理人」時,整個人力資源科技產業面對的就是結構性問題,而非公關問題。
我記得我們內部就此爭論過。我的一位工程師——很聰明的傢伙,有深厚的機器學習背景——說:「可是 Workday 只是在跑一個推薦引擎。這就像因為 Google 顯示了糟糕的搜尋結果就怪罪 Google 一樣。」而我說:「不。這就像你雇了一家人力仲介來篩選候選人,而那家仲介把所有 1995 年以前畢業的人的履歷全丟掉了,然後你去怪罪這家仲介。」
法院正是劃出了這條界線。法官 Rita Lin 將「簡單工具」——試算表、電子郵件——與那些會主動為候選人評分、排名並提出推薦的系統區分開來。Workday 的 AI 並不是在為人類整理資料以供審閱。它執行的是傳統上由雇主承擔的職能:決定誰能晉級、誰不能。那就是代理關係。那就是責任。
演算法是如何學會年齡歧視的?
這是讓我夜不能寐的部分,因為其機制是如此平淡無奇。
Workday 裡沒有任何人——我是真心相信這一點——會坐下來寫出這樣的程式碼:if age > 40: reject()。那將是荒謬到極點的違法行為,而且極易被偵測到。真正的問題更為微妙,而且老實說,更難修復。
當你用一家公司的歷史招聘資料——他們的「成功員工」——去訓練一個機器學習模型時,你等於是把那些過往招聘主管所有的偏見全都餵給了它。如果這家公司過去在工程職位上習慣招聘較年輕的員工,模型就會學到與年輕相關的訊號能預測「成功」。不是直接看年齡。而是代理特徵。
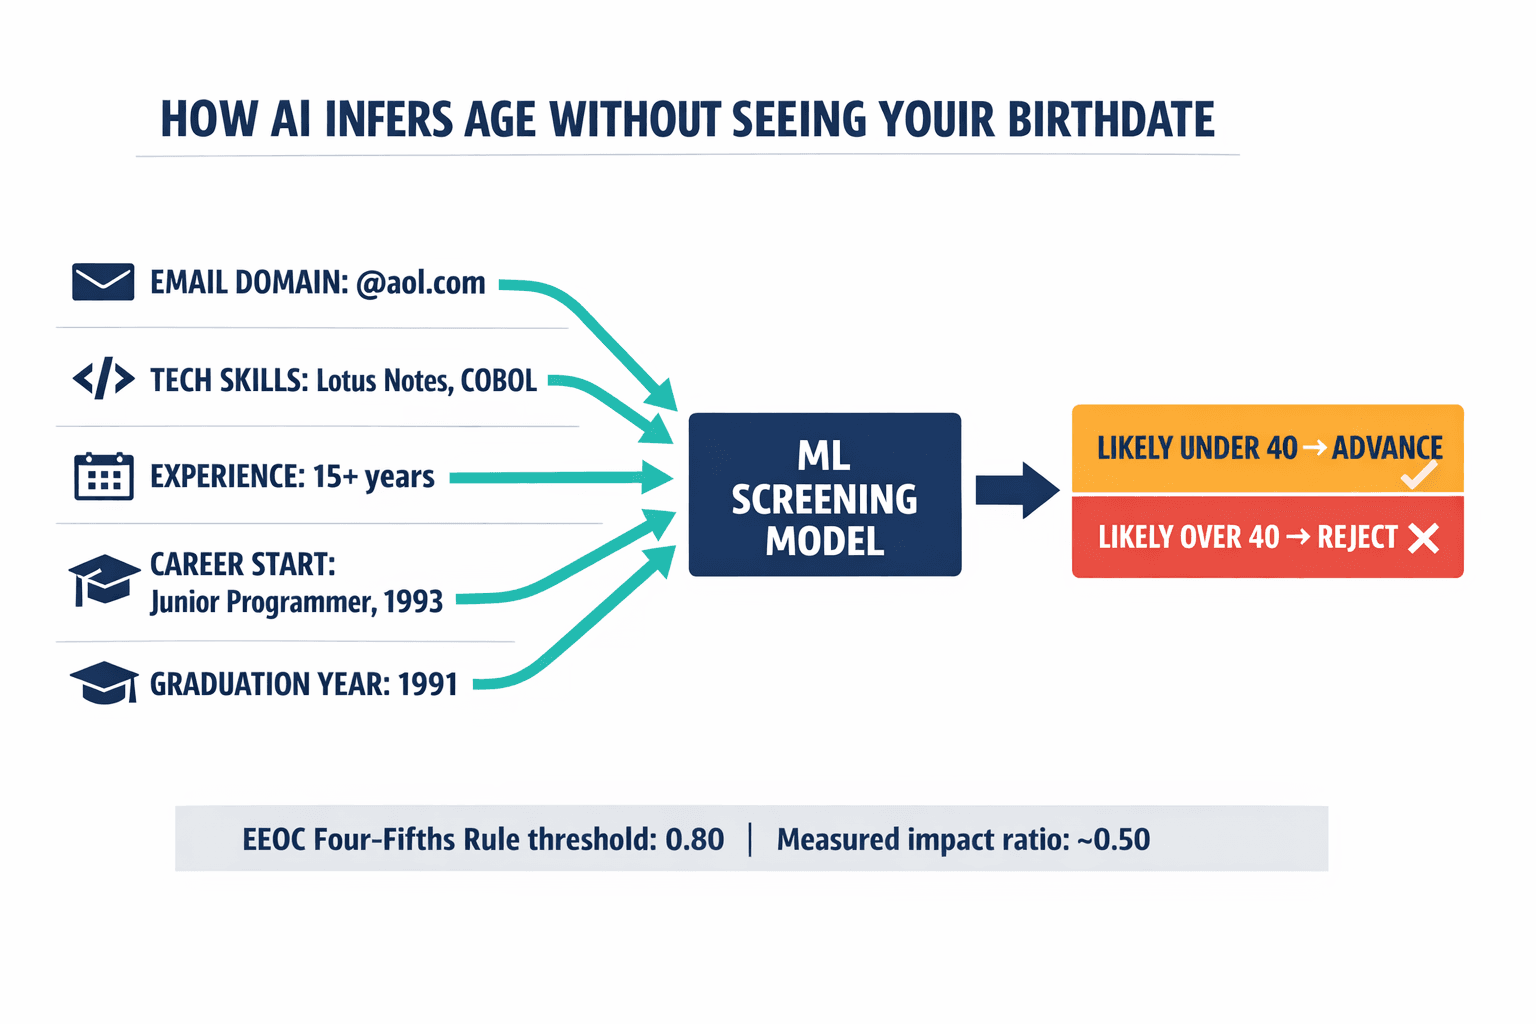
以下是 AI 篩選系統在從未看過你出生日期的情況下,能推斷出你年齡的方式:
你的電子郵件網域。@aol.com 或 @hotmail.com 的位址與較年長的使用者族群相關。你引用的技術——列出 Lotus Notes 或 COBOL 專長,會把你定位到某個特定年代。總年資,其中「15 年以上」會成為一個時間錨點。甚至是職涯發展的標記:一個來自 1990 年代初期的「初級程式設計師」職稱,就能明確告訴模型你是何時進入職場的。
我用自己的團隊測試過這件事。我們建立了一個合成資料集——包含受控變數的假履歷——並讓它們通過一條標準的、基於 transformer 的篩選管線。這個模型從未被告知任何關於年齡的資訊。但當我們用 EEOC 的「五分之四規則」(Four-Fifths Rule)——當某個受保護群體的錄取率低於最高群體錄取率的 80% 時,該規則會標示為存在不利影響——來衡量錄取率時,年過 40 的申請者的結果慘不忍睹。錄取率只有較年輕申請者的一半。影響比率約為 0.50,遠低於 0.80 的門檻。
演算法不需要知道你的年齡。它只需要你的電子郵件供應商、你的用詞,以及你的職涯時間軸。剩下的就交給數學去完成。
沒有人刻意編寫歧視。訓練資料就是歧視本身,被固化為權重與參數,再以規模化的方式回饋出來。
為什麼「直接用 GPT 就好」是錯誤的答案
我一直不斷聽到這種說法。從投資人、從潛在客戶、從那些讀了三篇關於 AI 轉型的部落格文章、一片好意的技術長口中。「你何不直接包裝 GPT-4 就好?它已經夠好了。」
曾有一位投資人在一場募資簡報中當面對我這麼說。他往後一靠,雙臂交叉,說道:「Ashutosh,OpenAI 已經在這上面砸了數十億美元。你是在告訴我,你那家 40 人的公司要打造出更好的東西?」
我告訴他,他問錯了問題。問題不在於 GPT-4 是否「更擅長」生成文字。它當然更擅長。問題在於,一個機率性的文字生成引擎,是否應該去做那些決定一位 52 歲軟體工程師能否養活家人的決策。
市場上充斥著我所謂的LLM 包裝器——那是一層薄薄的應用層,把 GPT-4 或 Claude 這類基礎模型的輸出重新包裝,再當作「AI 招聘解決方案」來販售。它們在示範時看起來令人印象深刻。它們在正式環境中則會災難性地失敗,原因如下。
LLM 預測的是最有可能出現的下一個 token。就這樣。它是一個精密的自動完成引擎。它並不會推理候選人是否符合職缺要求。它生成的文字看起來像是在推理。而在招聘領域,「看起來像推理」與「真正在推理」之間的差距,就是合規與集體訴訟之間的差距。
有一個已被充分記錄的現象,稱為「中間迷失」症候群(lost-in-the-middle syndrome):標準的 transformer 架構在處理其上下文視窗開頭與結尾的資訊時,會展現出很高的準確度,但在中間部分,注意力會顯著下降。在一份 10 頁的履歷中,那些被埋在中間段落的關鍵證照或近期成就,在統計上更有可能被忽略。並不是因為模型判定它們不重要——而是因為這個架構在本質上就無法對所有內容給予同等的注意力。
我在我們研究的互動版本中,寫過這項架構限制以及我們解決它的方法。
然後還有經濟層面的問題。LLM 包裝器面臨我所謂的護城河吸收(moat absorption)——隨著基礎模型供應商推出能力更強的基礎模型,他們必然會把包裝器賴以作為價值主張的功能整合進去。履歷解析、情感分析、基本比對——OpenAI 和 Google 終究會原生提供這些功能。一家僅僅是包裝 API 的公司,會在每一次客戶互動中,親手訓練掉自己的競爭優勢。
我們親手打破自己系統的那個夜晚
我想跟你說說大約八個月前的某個星期四晚上,因為它改變了我對我們所打造一切的看法。
我們當時正拿一個招聘篩選模組的原型——也就是我們的神經符號架構,我稍後會解釋——去對照一個基準資料集進行測試。這套系統在準確度指標上表現得非常出色。精確率很高。召回率也很扎實。我的首席機器學習工程師為此連續多天工作 14 小時,此刻幾乎是容光煥發。
接著,我們的合規分析師執行了公平性稽核。
這套系統在殘疾狀態上出現了人口統計均等性的違反。不是很嚴重的那種——影響比率約為 0.78,只是勉強低於 0.80 的門檻。但它確實存在。我一直告訴所有人「在設計上就能抵禦偏見」的那套我們自己的系統,正在產出帶有歧視的結果。
全場鴉雀無聲。我感到一陣噁心。
接下來的三天,我們把整條管線拆解開來。罪魁禍首原來是訓練資料中一個我們原本以為中立的特徵:就業空窗期的長度。患有殘疾的候選人在統計上更有可能出現就業空窗——因為醫療假、因為與無障礙相關的工作轉換、因為復原期。我們的模型學到了空窗期能預測較低的「成功」,於是它透過代理特徵懲罰了殘疾。
我們之所以抓到這個偏見,是因為我們在尋找它。大多數使用現成 AI 招聘工具的公司並沒有在找。他們甚至不知道自己應該去找。
我們用對抗式去偏(adversarial debiasing)修正了它——訓練一個次要的「對抗」模型,讓它試圖從我們預測模型的輸出中預測受保護特徵,然後每當對抗模型成功時,就懲罰預測模型。這是一種處理過程中(in-processing)的技術,它迫使系統去卸除歧視性的模式,而不只是在後處理階段將其掩蓋起來。
但這個教訓不是技術層面的。這個教訓是:如果連我們這樣一家執著於公平與驗證的公司,都差點推出一個帶有偏見的系統,那麼其他所有人正在推出的又是什麼?
「深度 AI」對招聘究竟意味著什麼?
當我說我們打造的是「深度 AI」而非 LLM 包裝器時,我指的不是我們使用了更深的神經網路。我指的是我們對問題的鑽研更深。
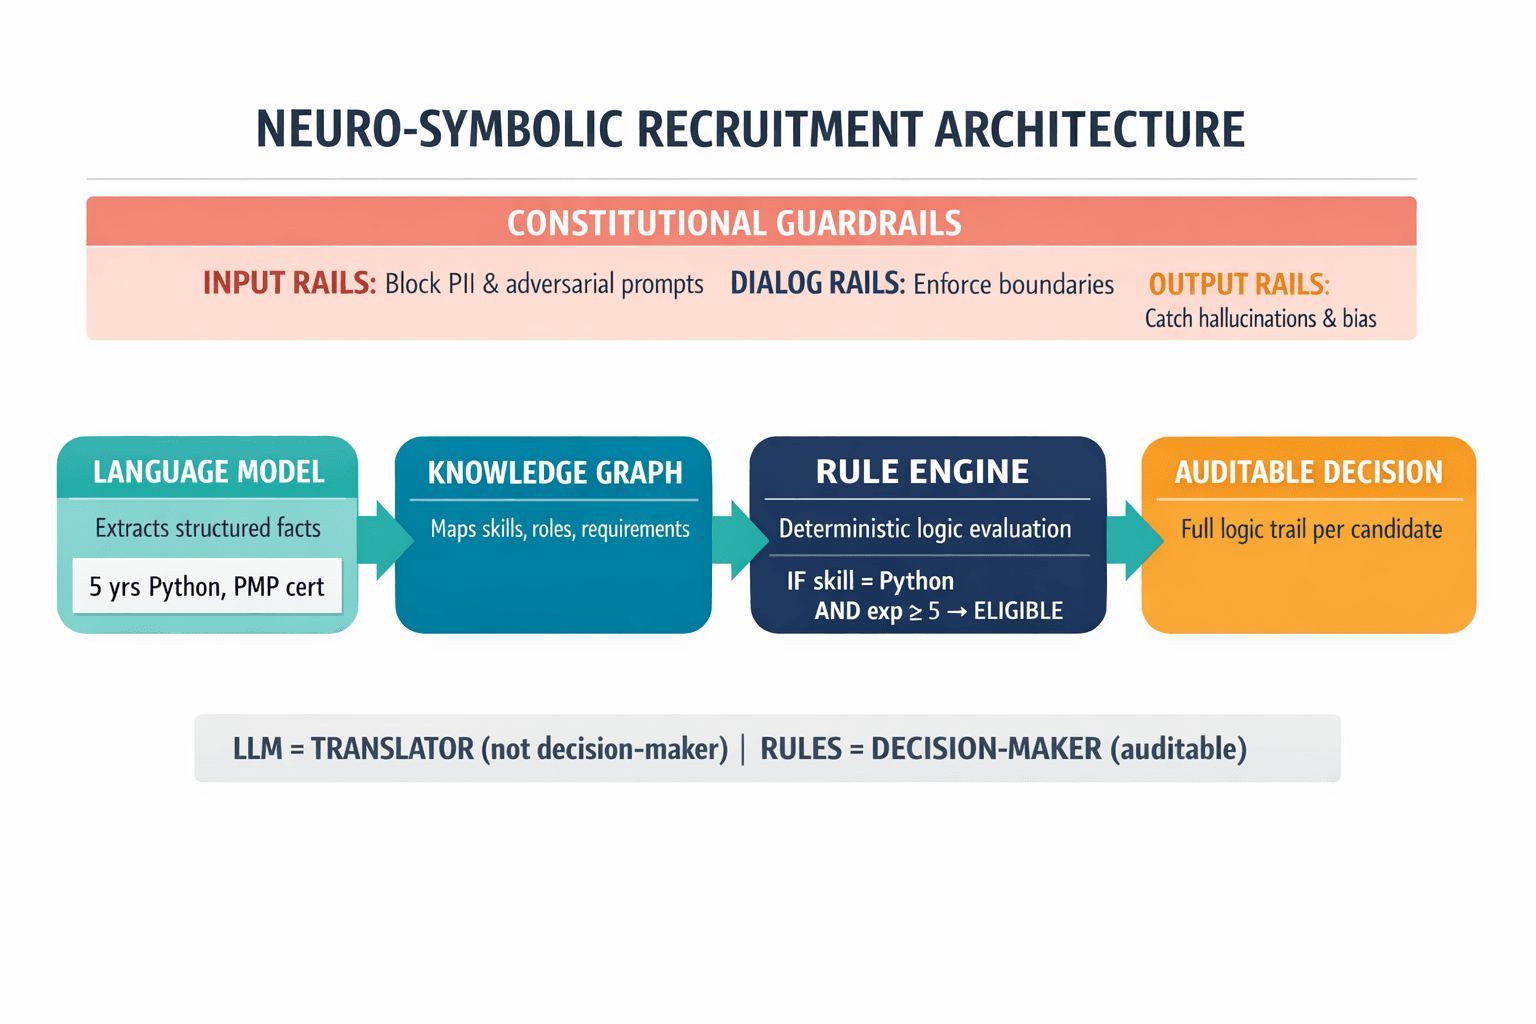
我們的架構是神經符號式的(neuro-symbolic)——它結合了神經網路的語言能力與符號推理的邏輯嚴謹性。在實務上,這意味著我們系統中的 LLM 並不是決策者。它是翻譯者。
以下說明它是如何運作的,不用術語:
當一份履歷進入我們的系統時,一個專門的語言模型會擷取出結構化的事實——「這個人有 5 年的 Python 經驗」、「這個人持有 PMP 證照」、「這個人在 2018 年到 2022 年間任職於 X 公司」。這些不是詮釋。它們是實體擷取,並對應到一個知識圖譜上,該圖譜定義了技能、職位與組織需求之間的關係。
然後——這是關鍵的部分——一個確定性規則引擎(deterministic rule engine)會將那些擷取出的事實與職缺要求進行比對。不是神經網路。不是機率分佈。而是真正的邏輯:IF experience >= 5 AND skill == Python THEN eligible = TRUE。LLM 無法對政策產生幻覺,因為政策存在於程式碼中,而不是存在於權重裡。
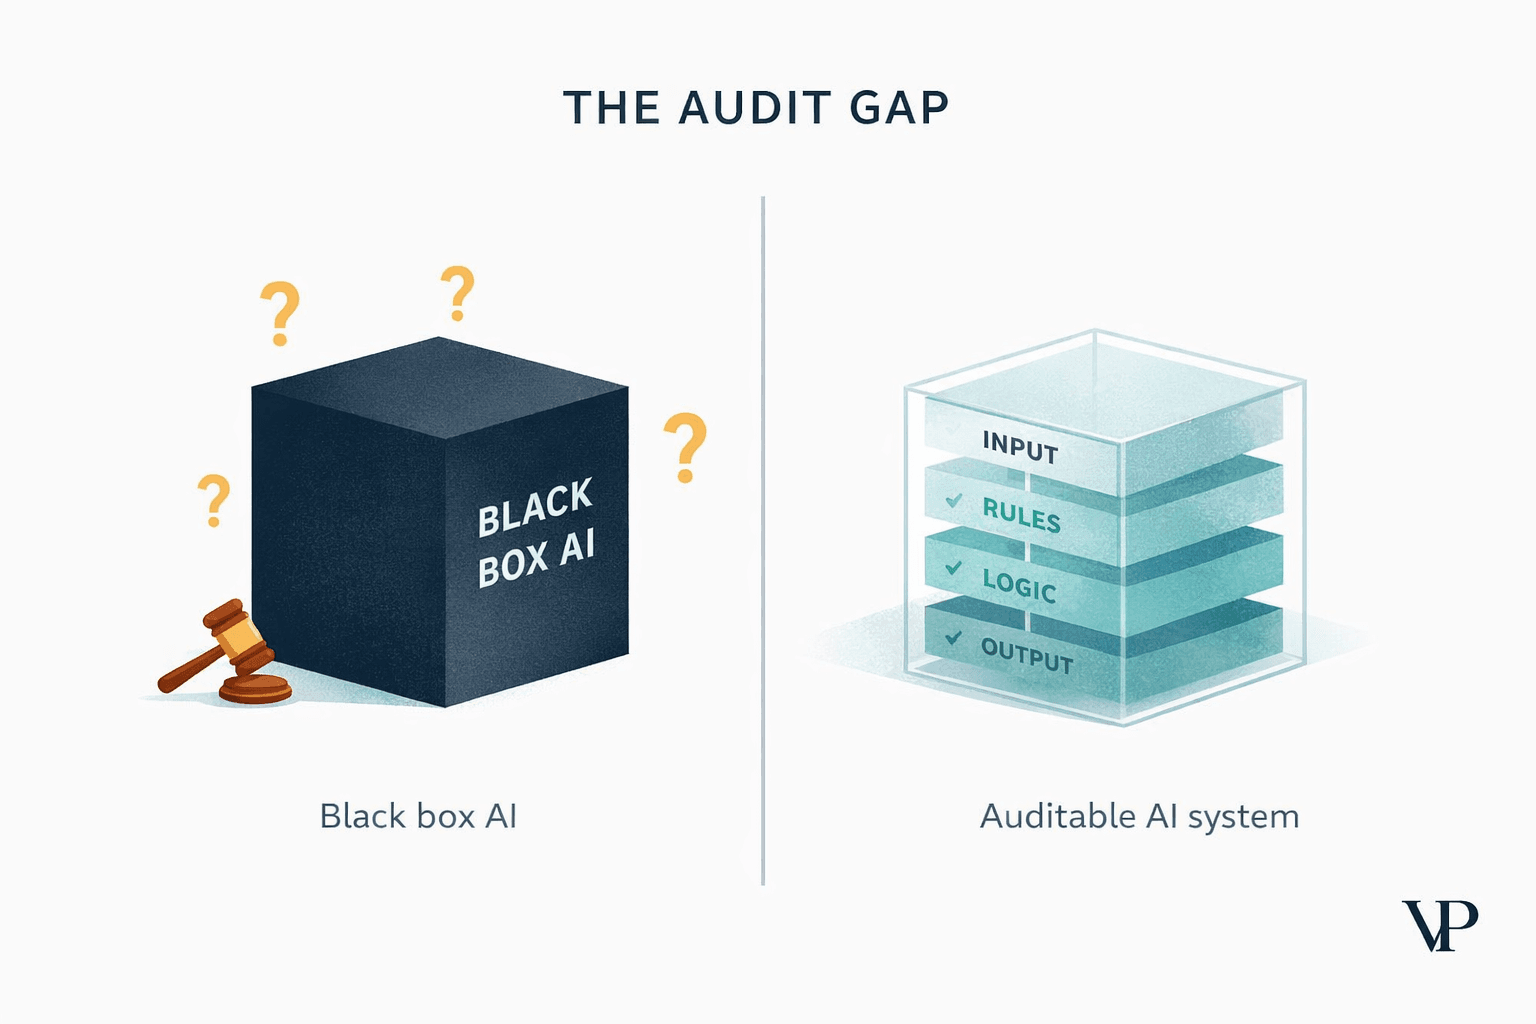
每一項推薦都會產生一條可供稽核的邏輯軌跡。你可以精確追溯到是哪一條規則被觸發、由哪一個資料點觸發、在候選人檔案的哪一個段落中觸發。當監管機構或原告律師問「這個人為什麼被拒絕?」時——你能給出一個不是「模型覺得如此」的答案。
我們以我所謂的憲章式防護欄(constitutional guardrails)來確保這一點——三層保護,在每一次互動之前、之中與之後運行。輸入防護欄會在對抗式提示與個資(PII)外洩觸及核心邏輯之前將其攔截。對話防護欄會強制執行對話的邊界。輸出防護欄則會掃描每一項結果,在任何內容送達人類招聘人員之前,檢查是否有幻覺、毒性或違反政策之處。
這並非理論。若想了解我們架構的完整技術剖析,以及背後推動它的法律框架,請參閱我們的研究論文。
你真的能讓 AI 招聘變得公平嗎?
人們一直問我這個問題,通常帶著一種懷疑的語氣,暗示他們認為答案是不能。
我的誠實回答是:你無法讓它變得完全公平。招聘中的公平涉及固有的取捨——是數學上的取捨,而不只是哲學上的取捨。針對人口統計均等性(各群體錄取率相等)進行最佳化,可能會與勝算均等(真陽性率與偽陽性率相等)產生衝突。針對預測均等(確保高分對每個群體都代表相同的意義)進行最佳化,則可能與前兩者都產生衝突。
但你可以讓它遠比現狀更公平——現狀不是帶有偏見的人類,就是假裝中立、實則帶有偏見的演算法。而且你可以讓它可供稽核,而這正是法律真正要求的。
我們使用 SHAP——SHapley Additive exPlanations(夏普利加法解釋)——為每一項決策中的每一個特徵指派一個貢獻值。「技能 X 為這位候選人的分數貢獻了 +15。就業空窗期貢獻了 -3。」我們使用 LIME——Local Interpretable Model-agnostic Explanations(局部可解釋、與模型無關的解釋)——來測試微小的改動是否會翻轉一項決策。如果改變候選人的郵遞區號就會改變結果,那麼一定有什麼地方出了問題。
我們會生成反事實解釋:「這位候選人未被選中,是因為他缺少 Y 證照。如果他擁有 Y 證照,分數就會超過門檻。」那不是黑盒子。那是一個玻璃盒子,而這正是 EEOC 在 2023 年 5 月的指引所要求的。
大多數公司所沒有的「三道防線」模型
有件事在我開始與企業人力資源團隊談論他們的 AI 工具時令我震驚:他們大多不知道自己正在跑的是什麼模型。
我是照字面意思這麼說的。我曾與一家財星 500 大企業的人資長(CHRO)——一個每年要為影響數萬人的招聘決策負責的人——一起開會,並問道:「你能告訴我你們 AI 篩選工具依人口統計群體劃分的錄取率嗎?」一臉茫然。「你能告訴我它用的是什麼模型嗎?」更久的茫然。「你能告訴我是誰驗證過它有無偏見的嗎?」她說:「我想那是供應商在處理的。」
供應商「在處理」。而根據 Workday 判例,正是這同一家供應商,如今有可能作為你的代理人而須負責。也正是這同一家供應商,幾乎可以肯定在合約裡有一條條款,聲明對歧視性結果不負責任。
招聘領域的企業級 AI,需要風險管理專業人士所稱的三道防線模型:
第一道防線:建構與部署 AI 的業務單位。他們負責訓練資料的選擇、將姓名與畢業年份匿名化的盲選招聘技術,以及日常監控。
第二道防線:風險與合規監督。模型登錄——一份集中式的清冊,記錄每一個 AI 模型、其用途、其資料來源、其風險等級。持續監控錄取率與影響比率。供應商審查則要求提供偏見測試的文件,而不只是行銷簡報。
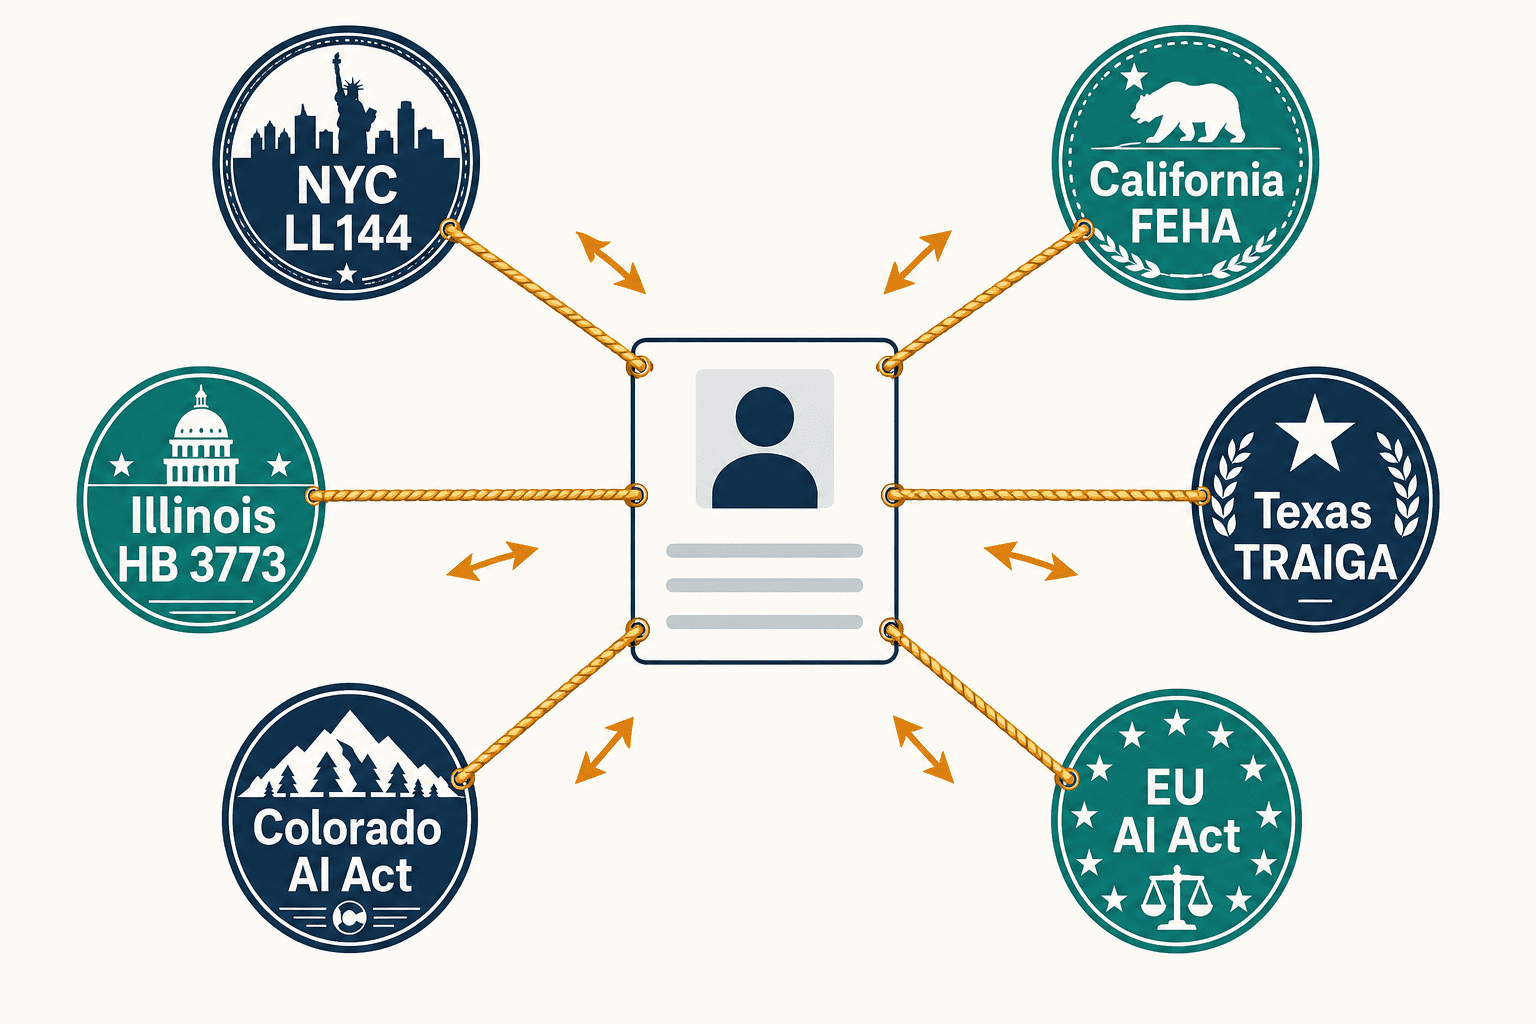
第三道防線:獨立稽核。紐約市的《144 號地方法》(Local Law 144)已經強制規定,自動化就業決策工具必須每年由獨立的第三方進行偏見稽核。罰則從第一次違規的 500 美元起跳,並攀升至每項違規每日 1,500 美元。但真正的代價不是罰款——而是當法院下令將你公司的名字寄送給數以百萬計可能受害的申請者時所發生的一切,而這正是 Workday 集體訴訟認證所促成的結果。
為什麼「主權 AI」是企業招聘的未來
Workday 一案正在加速一個我已觀察兩年的轉變:轉向我所謂的主權 AI(sovereign AI)在企業招聘中的應用。
各家公司正逐漸清醒過來,意識到把自己專有的招聘資料送往第三方 API,意味著這些資料可能被用來訓練別人下一代的模型。他們正意識到,當一個公開 API 更新時——這種更新往往毫無預警地發生——他們精心驗證過的篩選管線可能在一夜之間漂移,對同樣的候選人產出不同的結果。他們也正逐漸明白,通用型的 LLM 缺乏準確進行專業評估所需的領域專屬知識圖譜。
我接觸的企業越來越希望擁有自己的模型。在他們自己的虛擬私有雲中運行這些模型。掌控模型更新的時間與方式。維護不依賴供應商善意的完整稽核軌跡。
這正是我們 Veriprajna 的前進方向。我們不販售 API 存取權。我們打造的是認知架構,將機構知識、合規規則與確定性邏輯編織進系統之中,讓這些系統把 AI 當作一個強大的介面——而不是一個憑統計「感覺」就做出足以改變人生決策的、會出錯的神諭。
我無法擺脫的那個念頭
我一再回想起 Derek Mobley。100 多份申請。被軟體拒絕,往往在幾分鐘之內,在深夜裡。從來沒有人真正看過他的資歷。從來沒有人告訴過他為什麼。
而他並不特殊。他只是那個提告的人而已。
有數以百萬計的人——有資格、有經驗、有能力的人——被那些以歷史偏見訓練、未經充分測試就部署、且在缺乏有意義監督下運作的演算法,篩除在工作機會之外。他們沒有收到一封拒絕信,向他們解釋他們的 @hotmail.com 電子郵件位址,與模型已學會懲罰的某個年齡層相關。他們得到的只是沉默,或一封制式郵件,然後就繼續投下一份申請了。
Workday 的裁決並未解決這個問題。但它做到了一件幾乎同樣重要的事:它讓這個問題變得昂貴。而在企業軟體領域,昂貴的問題會被解決。
問題不再是 AI 是否應該被用於招聘。問題是,你正在使用的 AI,能否撐過一場證詞取證(deposition)。
我以打造 AI 為業,而且我深深相信它有讓招聘變得更公平、更有效率、更有人性的潛力。但前提是,我們必須停止把招聘 AI 當成一項消費性產品,並開始把它當作它真正的樣子:一套高風險的決策系統,它決定著人們的生計,並運作於美國法律中監管最為嚴格的領域之一。
黑盒子的時代已經結束。請據此打造你的系統。